
Solrのシステム開発は、検索対象と必要な機能、データ連携、運用体制を整理し、検索基盤と業務画面を組み合わせて構築します。
システムの種類と機能、開発手順、費用、委託先の選び方、運用上の注意点を見出しごとに取り上げます。各テーマの詳しい内容は、関連記事でも確認できます。
▼関連記事一覧
・Solrのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Solrのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Solrのシステム開発の見積相場や費用/コスト/値段について
・Solrのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Solrのシステムの概要
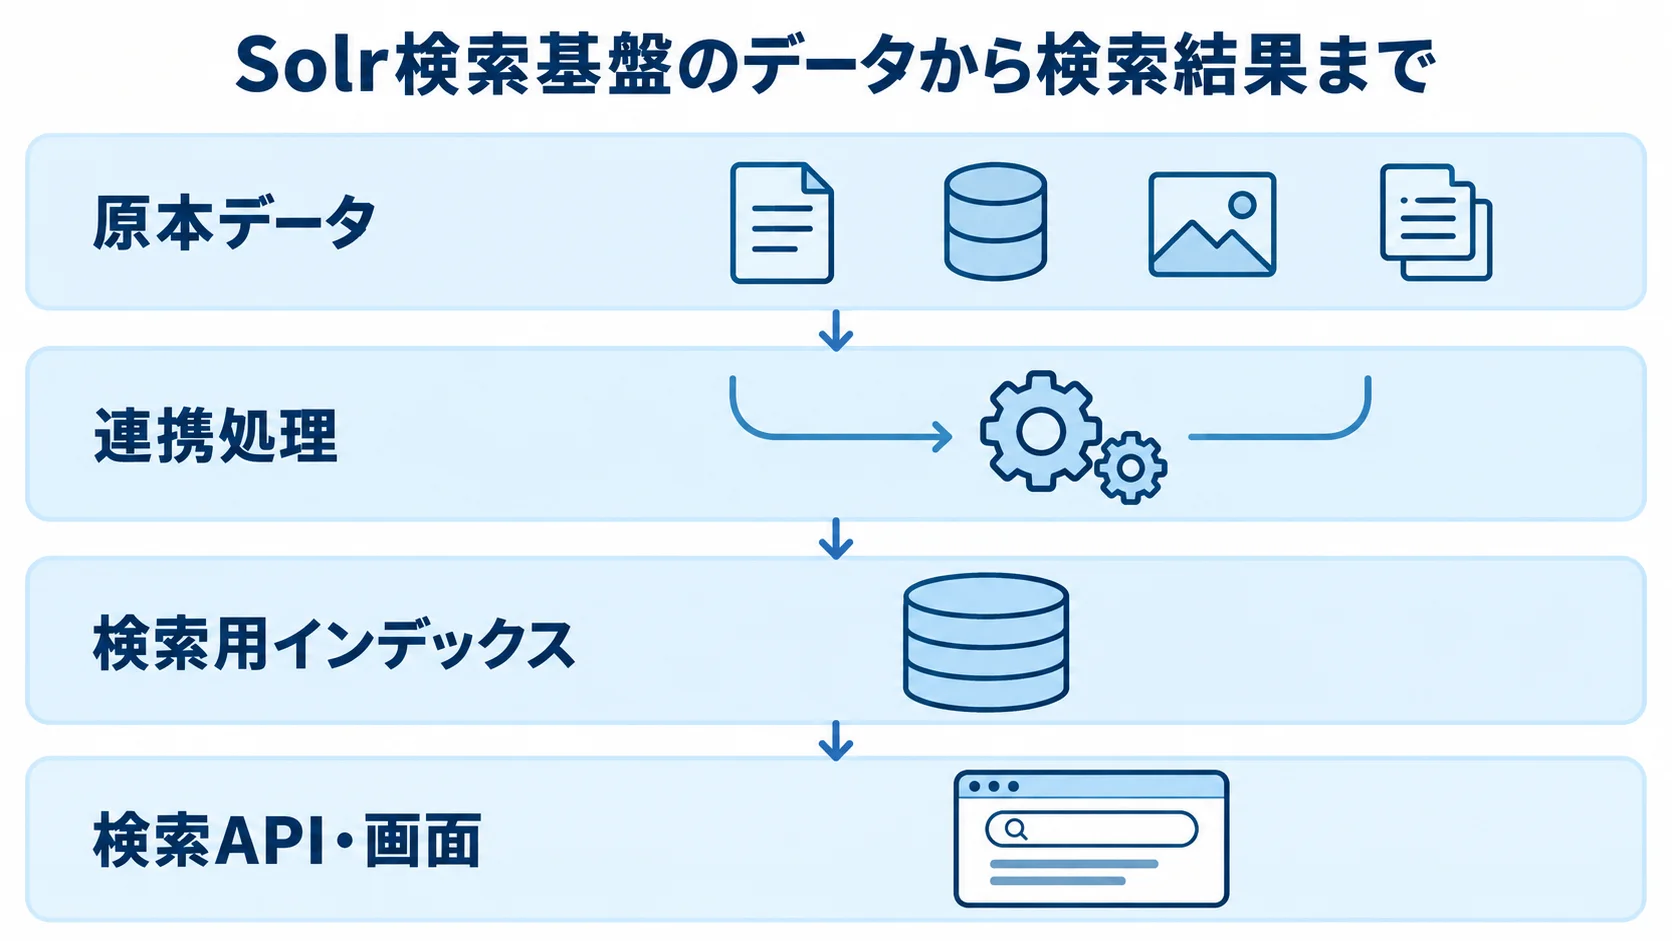
Solrは、Apache Luceneを基盤にしたオープンソースの検索プラットフォームです。原本データそのものは持たず、検索用インデックスを保持して、検索要求に高速で結果を返します。
業務システムでは、原本データと連携処理、検索APIを組み合わせます。画面や権限、監視、保守まで含めて、ようやく業務で使える形になります。そのため、Solr単体を導入した時点では、業務で使える検索基盤になっていません。
検索用インデックスを管理する基盤としてのSolr
検索結果は、原本データをSolrへ送る連携経路と、入力語を処理して並べる検索処理の二つで作られます。
- 連携経路:業務DB、商品マスタ、CMS、ファイルサーバーのデータを、ETLなどでSolrへ送ります。
- 検索処理:入力語を解析して正規化し、同義語や対象フィールドを指定したうえで、該当度の高い順に並べます。
検索用インデックスは、原本データの代わりにはなりません。原本との連携が途切れると、原本更新後に検索結果が古くなる、削除済みデータが残る、連携失敗で欠けるといった問題が起きます。
そのため、初回投入のほか、差分更新や削除、再送の設計、件数照合、再作成の手順を、開発会社と発注側で決めておきます。検索結果を正しく保つことは、Solrの機能だけでなく、連携処理と運用にもかかっています。
EC・求人・文書・FAQなどでの検索利用
検索対象によって、絞り込みの条件や回答への導き方は異なります。利用しやすさを保つには、原本のデータ品質と業務ルールを文章に残しておくことが欠かせません。
- EC・求人:商品や型番、職種や勤務地などが検索条件になります。
- 文書・FAQ:属性や公開範囲を検索条件にし、表記ゆれや似た質問も吸収します。
ECではカテゴリや価格、ブランド、在庫、サイズが条件になります。求人では雇用形態や給与、公開日も、検索の条件にします。
社内文書では、タイトルや本文を検索するほか、作成者、部署、公開範囲でも絞り込みます。FAQや問い合わせ履歴は、利用者が問い合わせる前に答えへ導く役割を持ちます。
検索対象が増えるほど、画面より先にデータの設計が必要になります。開発会社と発注側で、商品コードの形式、部署名や住所の表記、公開終了データを除外する時期を、事前に決めておきます。
Solrのシステムの種類と構成
構成は、検索対象の件数や同時利用者数、更新頻度を踏まえて選びます。許容停止時間や運用人材も、判断に欠かせません。小規模なら単一ノードが、可用性や拡張性が必要なら複数ノードが候補になります。
将来の増加を見込んだ移行経路と障害時の復旧方法も含めて判断します。最大構成を最初から選ぶかどうかも、この判断の中で決めます。
小規模な検索を始めやすい単一ノード構成
単一ノード構成は、1台のサーバーにSolrを配置する方式です。検索対象が限られ、停止を伴うメンテナンスを許容でき、担当者が構成を理解しやすい場合に向いています。
技術検証や小規模なサイトでは、データ投入と検索品質を短期間で確かめられます。一方で、サーバー障害は検索の停止に直結し、データ量や検索量が増えると拡張の余地も限られます。
発注側は、バックアップからの復旧時間、再インデックスに必要な時間、メンテナンス中の代替画面を確認し、許容できるリスクかどうかを判断します。
シャードとレプリカで可用性を高めるSolrCloud構成
SolrCloudは、コレクションをシャードに分け、各シャードにレプリカを配置する分散構成です。Apache Solr公式ガイドでも、1台に収まらないコレクションを複数のシャードに分け、レプリカで冗長性を確保する考え方が示されています。
ZooKeeperは、クラスタの状態や構成を管理し、障害時のリーダー選出やリクエストの振り分けを支えます。高可用性や大規模データに向く一方で、運用は難しくなります。
シャード数やレプリカの種類、ノードの配置を決めます。ZooKeeperやバックアップ、ローリングアップグレードの扱いも検討します。レプリカを増やせば安全になるとは限らないため、この検討は欠かせません。
- 障害条件:障害時にも検索を続ける条件と、許容する更新の遅れを決めます。
- 復旧条件:再同期にかかる時間を、負荷試験で確認します。
運用体制から見たマネージド・クラウド・オンプレミスの比較
マネージドサービスでは、監視やバックアップ、障害対応の一部を外部に任せられます。バージョンアップの支援も受けられます。
専門人材を確保しにくい場合には有効です。そのうえで、データの所在地や契約終了時の返却、サポート時間、どこまでを誰が受け持つか、追加料金を確認します。
クラウド上のセルフホストは柔軟ですが、OSからSolr、ZooKeeperまでの運用が自社に残ります。機密文書や既存設備との接続制約が大きい場合は、オンプレミスも候補になります。
方式の名前より大切なのは、担当者や連絡先まで具体的に決めることです。
- ハイブリッド:データは拠点に残したまま、検索基盤だけを外部に置けます。
- 運用分担:障害対応の担当、夜間の連絡先、パッチ適用者、訓練の頻度を決めます。
Solrのシステムで実現できる主な機能
機能を決めるときは、画面に表示する項目だけでなく、データの種類と更新頻度、検索品質の測り方も決めておきます。高度な機能ほど、スキーマや辞書、ランキングの設計が欠かせず、テストデータやログ分析の設計も必要になります。
全文検索とフィールド検索の組み合わせ
全文検索は、商品説明や文書本文、FAQ、求人概要などから、キーワードに当てはまるデータを探します。フィールド検索は、カテゴリや価格、日付などを条件にします。部署や勤務地、公開状態も、同じ仕組みで絞り込めます。
両者を組み合わせると、たとえば「ノートパソコン」を本文に含み、価格が一定の範囲にあって、在庫があり、特定のカテゴリに属する商品を探せます。
型番や商品コードに文章と同じ解析を当てると、ハイフンや大文字・小文字の違いに加え、数字の桁や全角・半角の差で検索漏れが起きます。そのため、項目ごとに文字列や数値、日付、真偽値などの型を決めておきます。
- 検索一致:完全一致と部分一致を使い分けます。
- 条件設計:利用者が選びやすいように項目を分けると、検索の品質が上がります。
ファセット・サジェスト・ランキングによる探しやすさの向上
ファセット検索は、結果をカテゴリや価格帯、勤務地、公開年などで集計し、件数付きの絞り込み候補を表示する仕組みです。検索語が思いつかない場合でも、利用者は結果を見てから条件を追加できます。
分類マスタがそろっていないと、同じ意味のカテゴリが分かれてしまいます。そのため、集計の前にデータを整えておきます。
サジェストは入力途中の候補を表示し、スペル補正は誤字や表記ゆれを補います。同義語辞書や読み仮名を整えると、略称や旧名称を含めて、日本語の検索が使いやすくなります。
- 順位要因:一致数、販売状態、更新日、人気度、業務上の優先度を、並び順の材料にします。
- 固定表示:上位に固定する理由と、変更の手順を残しておきます。
日本語検索の速度と正解率の評価
日本語では、形態素解析の分割結果によって、検索漏れやノイズが変わります。そのため、複合語を一語で扱うか複数語に分けるか、社内用語や商品名を辞書に登録するかは、実際の検索語で検証して決めます。
評価クエリには、誤字や同義語、略称、型番を含めます。加えて、ひらがな・カタカナや全角・半角の表記、数字も入れます。
こうすると、改善点を説明しやすくなります。速度に加えて品質も見る必要があることが、そこから分かります。
- 速度:P95レイテンシなどの応答時間。
- 品質:0件率、上位10件の正解率、到達操作数、更新反映遅延を測ります。
ログを保存する場合は、個人情報や機密情報をマスキングするかどうかと、保存期間を決めます。
Solrのシステム開発の進め方
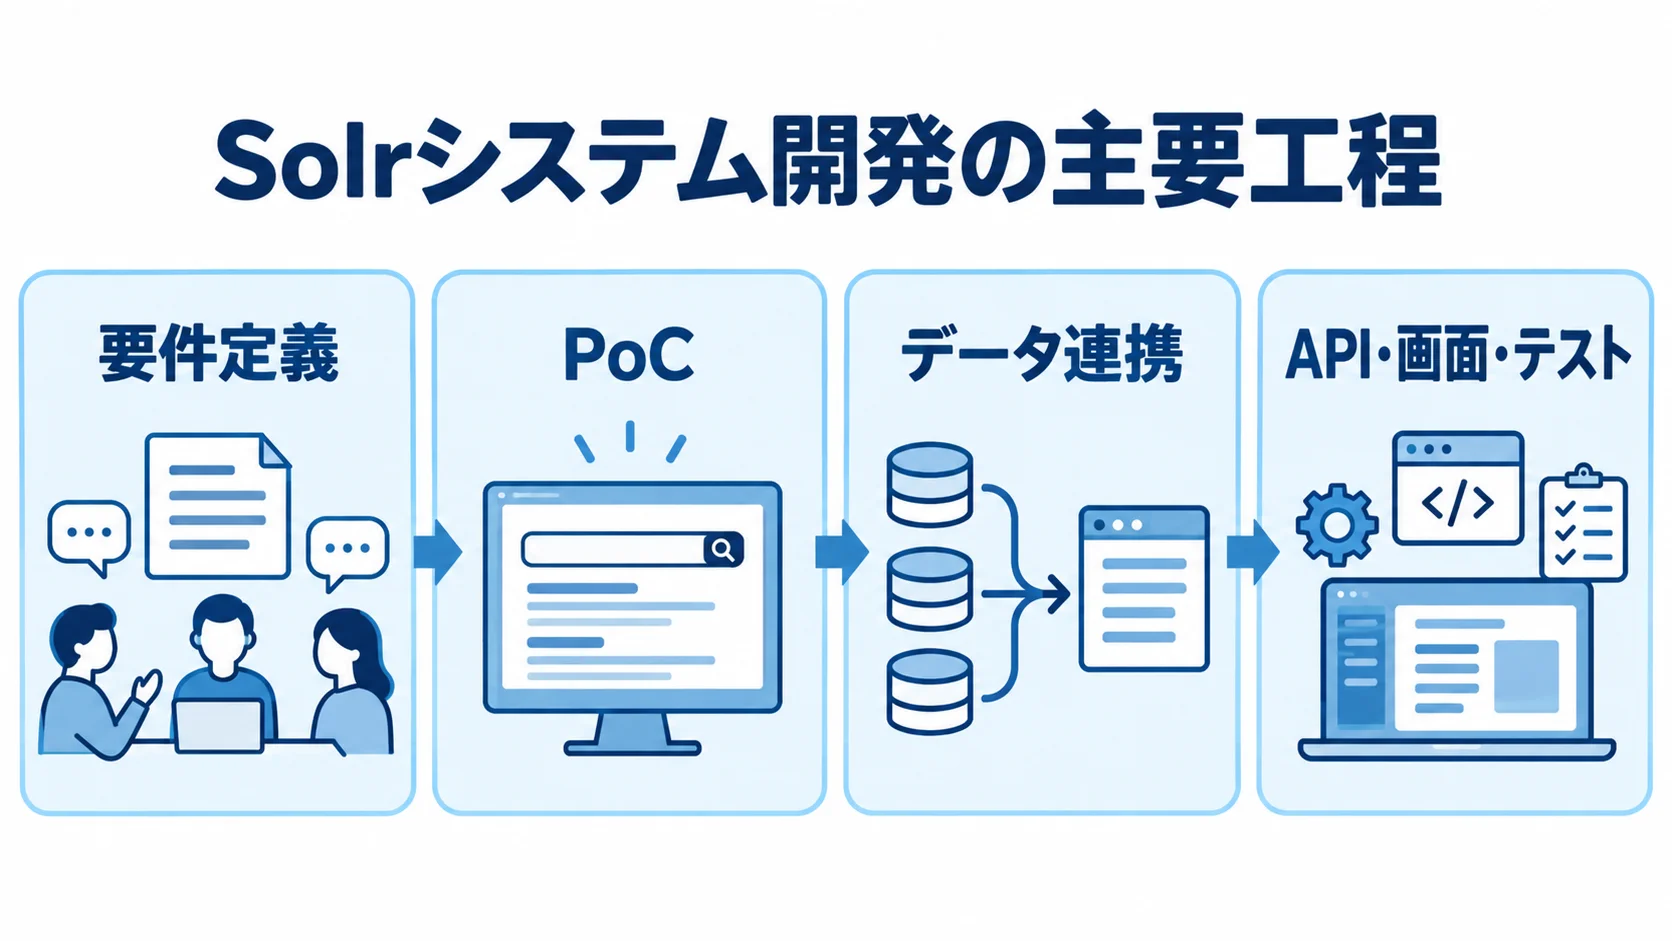
開発では、画面や検索APIを作る前に、検索の目的と評価方法を決めておきます。一般的には、現状整理や要件定義から始め、PoC、スキーマや辞書の設計、データ連携へと進みます。その後、API・画面の開発、性能・障害試験、移行を経て、運用の改善に入ります。
工程を短くする場合でも、データ削除の反映と復旧手順は省きません。
1. 要件定義での検索対象と成功条件の明文化
誰が何を探すのかを、業務シナリオに沿って整理します。そのうえで、検索対象の件数や増加量、データソースを洗い出します。さらに、更新頻度や同時利用者数、検索できる時間帯も確かめます。
許容する更新の遅れや、障害時のRTOとRPOを一覧にします。個人情報の有無と閲覧権限も、一覧に加えます。「高速に検索したい」といった表現では測れないため、速さの条件は、通常時のP95レイテンシや結果を返すまでの秒数で決めます。
検索品質の正解データも、この段階で準備しておきます。要件定義が足りないと、辞書やランキングを改善すべきかどうかを判断できません。
- 評価データ:現場の検索語と、期待・許容・非表示の結果を集めます。
- 合意形成:利用部門、情報システム、セキュリティ、データ管理の担当者で、優先順位をすり合わせます。
2. PoCでの日本語解析と検索品質の実データ検証
PoCでは代表データを投入し、形態素解析や同義語、型番検索を中心に確かめます。サジェストやファセット、結果の並び順も、同じデータで見ておきます。
データを少数に絞りすぎると、重複や長文、欠損、表記ゆれといった問題が見えません。業務を代表するデータと失敗しやすいデータの両方を使い、同じ評価クエリを繰り返します。
合格条件は、検索速度だけに限りません。ゼロ件率や上位結果の妥当性、更新反映時間、再インデックスの所要時間も含めて設定します。
- 検証例:100個の評価クエリのうち、目的の結果が上位10件に入る割合を見ます。
- 修正記録:解析器や辞書、フィールド、順位のうち、どこを直したかを残します。
PoCを本番開発の前段階として扱うと、構成の過剰設計や見積もりの抜けを抑えられます。
3. データ連携での初回投入・差分更新・削除の設計
原本からSolrへ、何を、いつ、どの方式で送るかを決めます。更新頻度が低いデータなら夜間バッチ、高頻度のデータなら更新APIやメッセージ処理による差分連携を使う場合があります。
どの方式でも、初回フルロードや更新、削除の扱いを設計書に残しておきます。連携失敗や重複送信、順序逆転への備えと、再送や件数照合の手順も含めます。
スキーマや辞書を変えると、再インデックスが必要になる場合があります。そこで、本番の検索を止めずに新しいインデックスを作り、検証してから切り替える世代管理を使います。世代管理があると、作成途中の結果が利用者に見えにくくなります。
- 世代管理:新しいインデックスを検証してから切り替え、作成途中の結果が出ないようにします。
- 削除確認:原本とSolrの件数を照合し、削除済みのデータが検索に出ないかを試します。
4. API・画面・テストの接続と段階的なリリース
検索APIでは、検索語や絞り込み、ソートとページングの仕方を定義します。ハイライトやファセット、権限条件、エラー時の応答も決めます。画面だけで権限を制御すると、APIを直接呼び出された場合に情報が漏れるおそれがあります。
APIとSolrの両方で公開範囲を検証します。検索には使うものの、画面には返さない項目も、あらかじめ分けておきます。
テストは、単体と連携から始め、業務シナリオ、権限、負荷へと重ねます。さらに、障害復旧とバックアップの復元、受入を順に行います。
更新や削除の直後といった例外の場面も、必ず再現します。例外の場面では、通常の操作では見つかりにくい不具合が表に出ます。
- 例外試験:更新・削除直後、辞書変更、ノード停止、連携失敗、空語、0件を再現します。
- 限定公開:ログを使い、利用者が入力する語とシステムの検索語のずれを確かめます。
Solrのシステム開発の費用相場と期間
開発費用は、ライセンス料よりも、検索品質や連携、運用設計によって大きく変わります。ここに示す金額は、検索品質や連携、運用設計を含めた、2025〜2026年時点の企画用の推定です。
費用は、データ量や連携本数、可用性によって変わります。検索品質や移行量、保守時間帯も影響するため、公開統計の一律価格をそのまま当てはめることはできません。
▶ 詳細はこちら:Solrのシステム開発の見積相場や費用/コスト/値段について
PoCから本番基盤までの費用の目安
費用と期間は、検証の規模や本番の機能によって変わります。データ連携や運用の範囲も、大きく影響します。
- PoC:100万〜300万円、1〜2か月が目安です。
- 小規模:300万〜1,000万円、3〜6か月程度です。
- 本番基盤:800万〜3,000万円、4〜9か月程度です。
- SolrCloud等:1,500万〜5,000万円、6〜12か月の場合があります。
- 大規模横断:3,000万円〜1億円超、9〜24か月の場合もあります。
PoCでは、代表データを使って検索項目や解析、同義語、性能を確かめます。小規模では、1〜3のデータ元とAPI、基本画面を対象にします。更新バッチやテストも含みます。
本番基盤では、複数条件の検索やファセット、権限、品質調整を含みます。監視や既存画面との連携も対象です。SolrCloudの場合は、複数環境や24時間運用も対象になります。
大規模な案件では、複数のDBやファイルを横断し、SSOや監査、段階的な移行にも対応します。
費用の目安は、要件定義やデータ整備、API、画面に加え、試験や移行、運用設計を含みます。Solr本体を無償でダウンロードできても、業務で安全に使うシステムの価格は別です。
検索品質・連携・非機能要件による費用の増減
見積もりは、検索対象の件数や種類、データソース数、更新頻度で変わります。さらに、日本語辞書やランキング調整のほか、API数や画面、個人情報の権限制御も関わります。
同時検索数や許容レイテンシ、稼働時間も要因です。バックアップや障害復旧、移行データの品質も、費用に影響します。
連携元が増えるほど、項目の対応やエラー処理、どこまでを誰が受け持つかの整理、データ照合に工数がかかります。同じ商品検索でも、扱う情報の広さによって工数は変わります。
- 商品検索:商品名だけの場合と、説明、型番、カテゴリ、在庫、価格、画像、販売状態、会員区分まで扱う場合とで、工数が違います。
- SolrCloud:分散設計やノードの増減、監視、バックアップ、障害試験が、さらに加わります。
金額を一つにまとめず、工程ごとの内訳で比べます。
インフラ・監視・保守を含む運用費
自社で運用する場合、ライセンス料がかからなくても、インフラや監視、保守の費用は発生します。
- 基盤:サーバー・クラウド、ストレージ、通信、監視、ログ、バックアップ、障害対応を含みます。
- 保守:辞書更新、性能調整、脆弱性パッチ、バージョンアップを見込みます。
公開されている例では、クラスタが月367米ドル、ノードが月53米ドルからで、上位は月1,067米ドル、月1,934米ドルからです(出典:マネージド検索サービス公開料金、2026年確認)。
円換算や利用量、導入支援費は別に見る必要があります。公開価格を、そのまま国内の見積もりに当てはめないよう注意してください。
初期費用3,000万円に、業務システムの一般的な保守比率15〜20%を企画上の枠として置いた例では、年間で450万〜600万円、月額で37.5万〜50万円になります(出典:社内リサーチノート「業務システム全般」、2026年)。
この数字は企画の枠組みで、Solr固有の相場ではありません。24時間監視や休日対応は、別途見積もります。
Solrの開発会社・ベンダー・サービスの選び方
開発先を選ぶときは、Solrの知識に加えて、業務理解やデータ連携、運用までを一つの責任範囲で任せられるかを見ます。
画面のデモがよくできていても、削除の反映や復旧の説明が曖昧なら、本番後に問題が残ります。実績の件数だけでなく、各工程を誰が担当したかも確かめます。
SolrCloud・日本語解析・性能試験の実績
単一ノードの経験だけでなく、SolrCloudの本番運用の経験があるかを確かめます。シャードやレプリカ、ZooKeeperの扱い、バックアップや障害復旧、ローリングアップグレードの経験も、合わせて見ます。
日本語の形態素解析や同義語、型番の扱いを、評価クエリを使って説明できるかが大切です。計測条件やデータ件数、同時検索数、P95やP99を示せる提案先は、比べられます。
連携元のDBやETLから、API、認証、ネットワークまでを一社で見られる体制が整っているかを確かめます。インデックスを設計する人と、運用監視・障害対応の担当者が別なら、引き継ぎ方法とどこまでを誰が受け持つかも確かめます。
- 運用経験:SolrCloudの運用、分散構成、バックアップ、復旧、ローリング更新の経験です。
- 検索・性能:日本語解析や順位改善、計測条件、件数、同時検索数、P95・P99の示し方。
- 提案反映:PoCで出た課題を、本番の見積もりに反映する手順を明確にします。
開発後の保守・監視・脆弱性対応
内製で運用する場合でも、初期の手順書と訓練は納品の範囲に含めます。
2026年3月公開のSolr 10.0.0では、メジャーバージョン変更に伴う破壊的変更と、サーバー側の最低Java 21という要件が示されています(出典:Apache Solr「Solr 10.0.0 available」「Major Changes in Solr 10」、2026年)。
- 保守契約:辞書追加、順位調整、項目追加、ログ分析、再作成、版更新の範囲。
- 対応条件:平日日中か夜間・休日も含むか、一次切り分け、復旧目標、報告、再発防止、定期レビューを決めます。
採用する版やJavaの版、コンテナは、検証環境で確かめます。連携や設定、更新の手順も、同じ環境で見ておきます。古い構成を長く運用する提案には、保守期限と移行計画を質問します。
見積もりと契約での成果物・担当範囲・移行条件の切り分け
相見積もりでは、要件定義やPoC、データ連携などを工程ごとに分けて、金額を出してもらいます。細かな内訳は、下の見積比較の項目で確かめます。
品質調整やデータ整備が別途扱いだと、総額は安く見えても、後から費用が増えやすくなります。そのため、人日や単価、前提となる件数を確かめます。連携本数やテストケース数、除外範囲も、見積もりの前提に含まれているかを見ます。
納品物には、要件定義書や構成図、スキーマ、辞書が含まれます。ランキング設定や連携・API仕様、テスト結果も、そこに加わります。
監視項目や復旧手順、操作マニュアルも、納品物として求めます。ソースコードや設定ファイルも対象です。
- 見積比較:要件、PoC、設計、連携、API、画面、試験、移行、研修、保守の区分で比べます。
- 前提条件:品質調整やデータ整備の別料金、人日と単価、件数、連携数、試験数、除外範囲。
- 納品・所有権:委託先を変える場合に備えて、管理者権限やリポジトリ、クラウド契約、出力形式、設定の所有権を確かめます。
インデックスを作り直せるよう、原本と生成手順は自社で管理しておきます。
▶ 詳細はこちら:Solrのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Solrのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:Solrのシステム開発の発注/外注/依頼/委託方法について
Solrのセキュリティと運用で注意すべき点
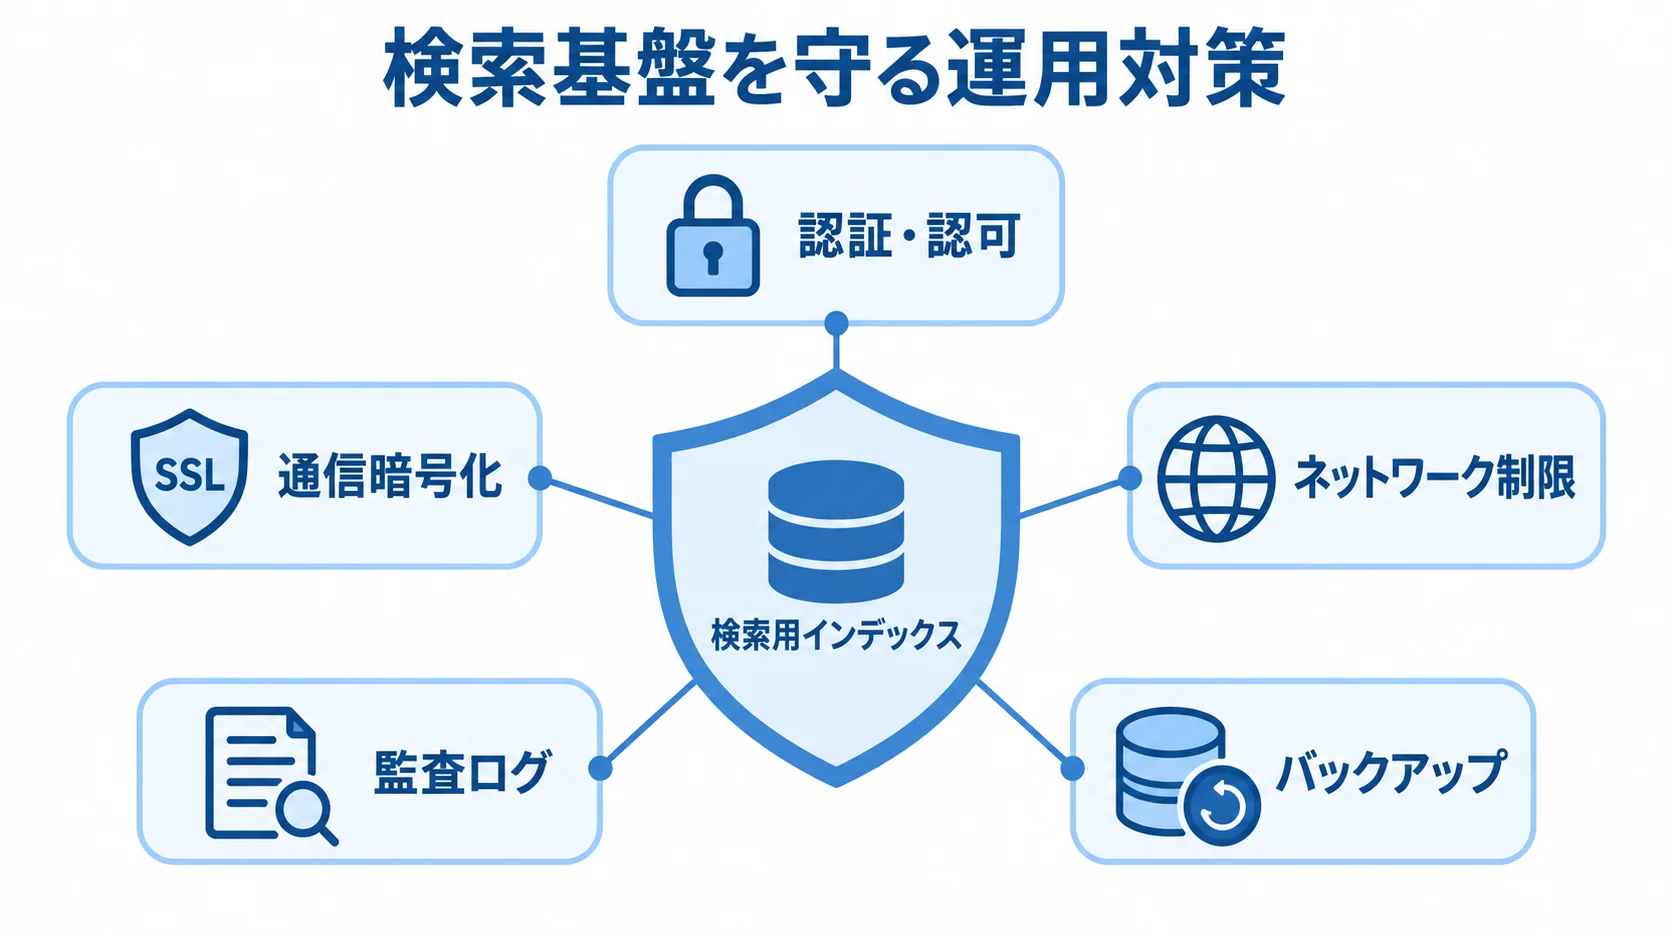
検索インデックスには、個人情報や社内機密、取引先情報が複製されることがあります。画面に出さない項目でも、APIや管理画面から参照できれば、漏えいにつながります。
アクセス制御や通信の暗号化を含め、監査ログとバックアップも、検索基盤の要件として扱います。
認証・認可・TLS・管理APIの制限
Solr公式ガイドでは、認証・認可、TLS、監査ログが挙げられています。IP制御やZooKeeper保護、ネットワーク設定も、同じガイドで示されています(出典:Apache Solr「Securing Solr」、2026年確認)。
認証・認可、TLS、IP制御やネットワーク設定は、組み合わせて使います。
- 接続制限:管理画面やAPIを外部に直接公開せず、FWやネットワーク分離で絞ります。
- 認証:資格情報を安全に保管し、できれば組織の認証基盤と連携します。
- 権限と監査:閲覧範囲と設定変更者を管理し、ログは安全な場所に保存します。
権限は、コレクションやフィールド、検索条件の単位で分けます。管理操作やデータ投入、バックアップ、設定変更も、役割ごとに分けます。所属や契約状態によって結果を出し分ける場合は、画面だけでなくAPIとSolrでも検証します。
SolrCloudでは、security.jsonやZooKeeper内で設定を変えられる人を制御し、監査ログは改ざんされにくい場所に保存します。
監視・バックアップ・復旧訓練の定期実施
監視の対象は、基盤と、検索・連携の状態に分けて整理します。
- 基盤:ノードやCPU、メモリ、ディスク、JVMのガベージコレクションを監視します。
- 検索・連携:レイテンシやエラー率、更新キュー、レプリカ、ZooKeeper、件数、バックアップの状態。
検索結果が返るかどうかだけでなく、原本更新の遅れや、特定のシャードへの負荷の集中も見ておきます。
バックアップは、別の環境へ復元して、検索できるかを確かめます。障害や誤削除、設定の破損、認証の誤りを想定して、RTO・RPOを満たせるかを訓練します。
脆弱性の情報を確かめ、パッチの適用や影響調査、ロールバック、報告を手順にします。2026年の認証設定に関する告知も踏まえ、拒否する設定を明示します。
検索ログによる辞書とランキングの改善
本稼働後は、検索ログから利用状況や検索品質を評価し、改善に生かします。
- ログ分析:検索語や0件語、クリック、再検索、絞り込み、問い合わせへの移行を見ます。
- 情報管理:収集の目的、アクセスの範囲、マスキング、保存期間、削除の方法を決めます。
- 改善評価:同義語や表記を追加し、評価クエリで変更を確かめます。
ランキングの変更は、利用者によって、改善にも改悪にもなり得ます。
上位結果やクリック率、0件率、業務上の正解率を比べ、設定を元に戻せるように管理します。商品などの情報や業務ルールが変わったときは、品質を調整します。
Solrのシステムに関するよくある質問
導入の前によく出る疑問に答えます。機能だけでなく、費用やデータ、運用の責任の分け方も確かめておくと、自社に合う構成を判断しやすくなります。
Solrは無料で使えますか?
Solr本体はオープンソースとして使えます。ただし、業務システム全体が無料になるわけではありません。
開発の段階では、要件定義や連携、スキーマ・辞書設計、API・画面に費用がかかります。運用の段階では、インフラや監視、保守に加え、セキュリティやアップグレードにも費用がかかります。ライセンス料と開発費、インフラ費と運用費を、分けて見積もります。
Solrはデータベースの代わりになりますか?
原則として、Solrは原本を保存するデータベースの代わりにはならず、検索用インデックスを提供する役割です。業務上の正確な更新やトランザクション、マスタ管理は、原本側で行います。
Solrには、検索に向いた形でデータを複製します。インデックスが壊れたり削除されたりしても、原本から作り直せる設計にしておきます。
Solrは日本語検索に対応できますか?
日本語検索には対応できます。ただし、導入しただけで検索品質が決まるわけではありません。形態素解析器やユーザー辞書、同義語を、実データで検証します。表記ゆれや誤字、型番、複合語も、検証の対象に含めます。
評価クエリで結果を確かめ、速度と上位結果の正解率、0件率を、それぞれ別々に測ります。運用後も、検索ログをもとに辞書を改善します。
SolrCloudは必ず導入すべきですか?
必ずしも必要とは限りません。導入の判断は、検索量や同時利用者数、許容停止時間などを見て行います。更新量や障害時の業務への影響、運用人材も、判断材料になります。
単一ノードで許容できるなら、小さく始める選択肢があります。複数ノードの可用性や拡張が必要な場合は、SolrCloudを検討します。その場合は、シャードやレプリカ、ZooKeeper、バックアップ、復旧試験まで設計します。
Solrのシステム開発にはどのくらいかかりますか?
PoCは1〜2か月、小規模な検索システムは3〜6か月、本番SolrCloudや複数の業務データを横断する場合は6〜12か月程度が目安です。
検索品質の調整やデータ移行を含めるほど、期間は延びます。権限設計や既存画面との連携、負荷・障害試験、利用者研修も、期間に響きます。本稼働日だけでなく、評価データの準備や移行リハーサル、受入テストの期間も、あらかじめ確保します。
Solrのシステム開発を成功させるためのまとめ
Solrのシステム開発では、原本データを正しく連携させ、日本語や型番を含む検索品質を評価します。検索エンジンを入れることは、その中の一工程です。
APIや画面、権限の設計に加えて、監視やバックアップ、復旧まで、一つの業務基盤として設計します。
導入前に押さえる五つのポイント
検索基盤を導入するときは、要件の優先順位と担当範囲を決め、構成や費用を同じ前提で比べます。
- 要件:対象や利用者、更新頻度、遅延、RTO・RPO、権限を定義します。
- 検索品質:PoCで実データを使い、日本語解析や型番、0件率を評価します。
- 連携:初回投入や差分更新、削除、再インデックスの設計。
- 構成と費用:方式を運用体制と費用で比べます。
- 契約と安全:認証や監視、成果物、所有権を契約に盛り込みます。
検索課題と評価データの一枚整理
まず、検索したいデータソースや代表的な検索語、期待する結果を一枚にまとめます。更新件数や利用者数、公開範囲、困っている検索例も、同じ一枚に書き込みます。
その一枚をもとに、PoCの範囲と合格条件を決めます。開発会社やサービス提供者へは、同じ前提で相談します。利用者が必要な情報に届く状態から逆算すると、機能名を並べるより、構成と費用を判断しやすくなります。
▼関連記事一覧
・Solrのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Solrのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Solrのシステム開発の見積相場や費用/コスト/値段について
・Solrのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。