
音声認識システムの開発・導入費用は、ユースケース、精度目標、データ要件によって100万〜数千万円以上まで変わります。費用を左右するのは、求める精度と、音声データをどれだけ用意できるかです。
仕組みや進め方と合わせると、費用の内訳が見えやすくなります。全体像は下記の関連記事一覧もご覧ください。
▼関連記事一覧
・音声認識システム開発の進め方/やり方/流れや方法/手法/工程/手順
・音声認識システム開発でおすすめの開発会社/ベンダー6選と選び方
・音声認識システム開発の見積相場や費用/コスト/値段について
・音声認識システム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
音声認識システムとは・概要
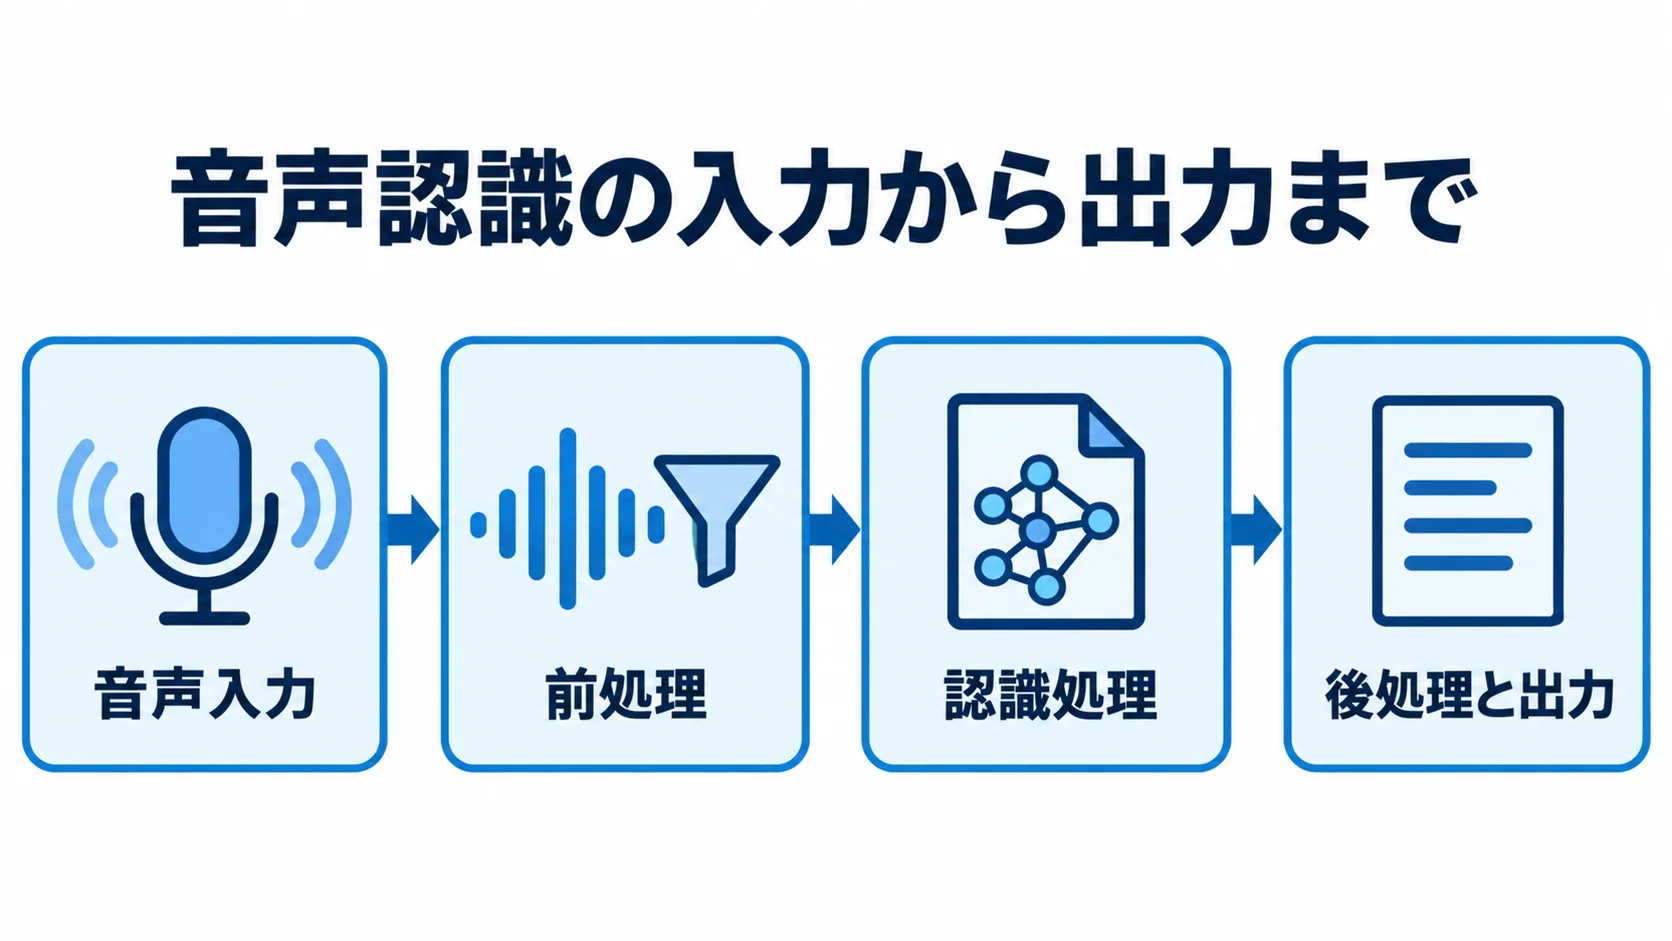
音声認識システムは、人間の音声をテキストやコマンドへ変換します。SpeechToText(STT)技術を中核に、前処理、認識エンジン、後処理で構成されます。たとえば前処理ではノイズを除去し、後処理では校正や整形を行います。
世界市場は2024年に250億ドルを超え、2030年に向けて年率20%以上で成長すると予測されています。
音声認識の仕組みと技術的背景
音声認識では、入力された音声が段階的に処理されます。
- 音声入力:マイクや録音ファイルから音声を受け取ります。
- 前処理:ノイズを除き、音声区間の検出と特徴量の抽出を行います。
- 認識処理:音響モデルと言語モデルを使い、単語列を決めます。
- 後処理と出力:句読点の追加や語形整形、専門用語の補正を経て、テキストやコマンドとして出力されます。
現代のシステムは深層学習(Deep Learning)を活用しています。音響モデルは音響特徴からフォネームを識別し、言語モデルは、フォネームの並びから最も確率の高い単語列を決めます。
従来は音響モデルと言語モデルを組み合わせていましたが、今はエンドツーエンドの深層学習モデルへ移行しています。Transformer系アーキテクチャ(OpenAIのWhisperなど)では、認識精度と多言語対応が向上しました。ただし、専門分野や騒音環境では、カスタマイズが必要な場合もあります。
主要な活用ユースケース
活用先によって、必要な精度、レイテンシ、セキュリティ要件が変わります。
- コールセンター:通話のテキスト化、品質管理
- 医療:医師の音声によるカルテ入力や処方箋作成の支援
- 製造:音声コマンドによる機械操作、品質記録
- 会議・顧客対応:議事録、字幕、チャットボット
- 車載・IoT:音声によるカーナビ操作、スマートホーム制御
コールセンターでは、リアルタイム処理やFAQ自動提示にも活用できます。また、会議・セミナーでは、議事録の自動生成や字幕表示に役立ちます。
カスタマーサポートでは、チャットボットやIVRの音声インターフェースに使います。一方で、医療では誤認識が重大な医療ミスにつながる可能性があります。会議の議事録作成より高い精度と厳格な審査が必要です。
音声認識システム開発の進め方
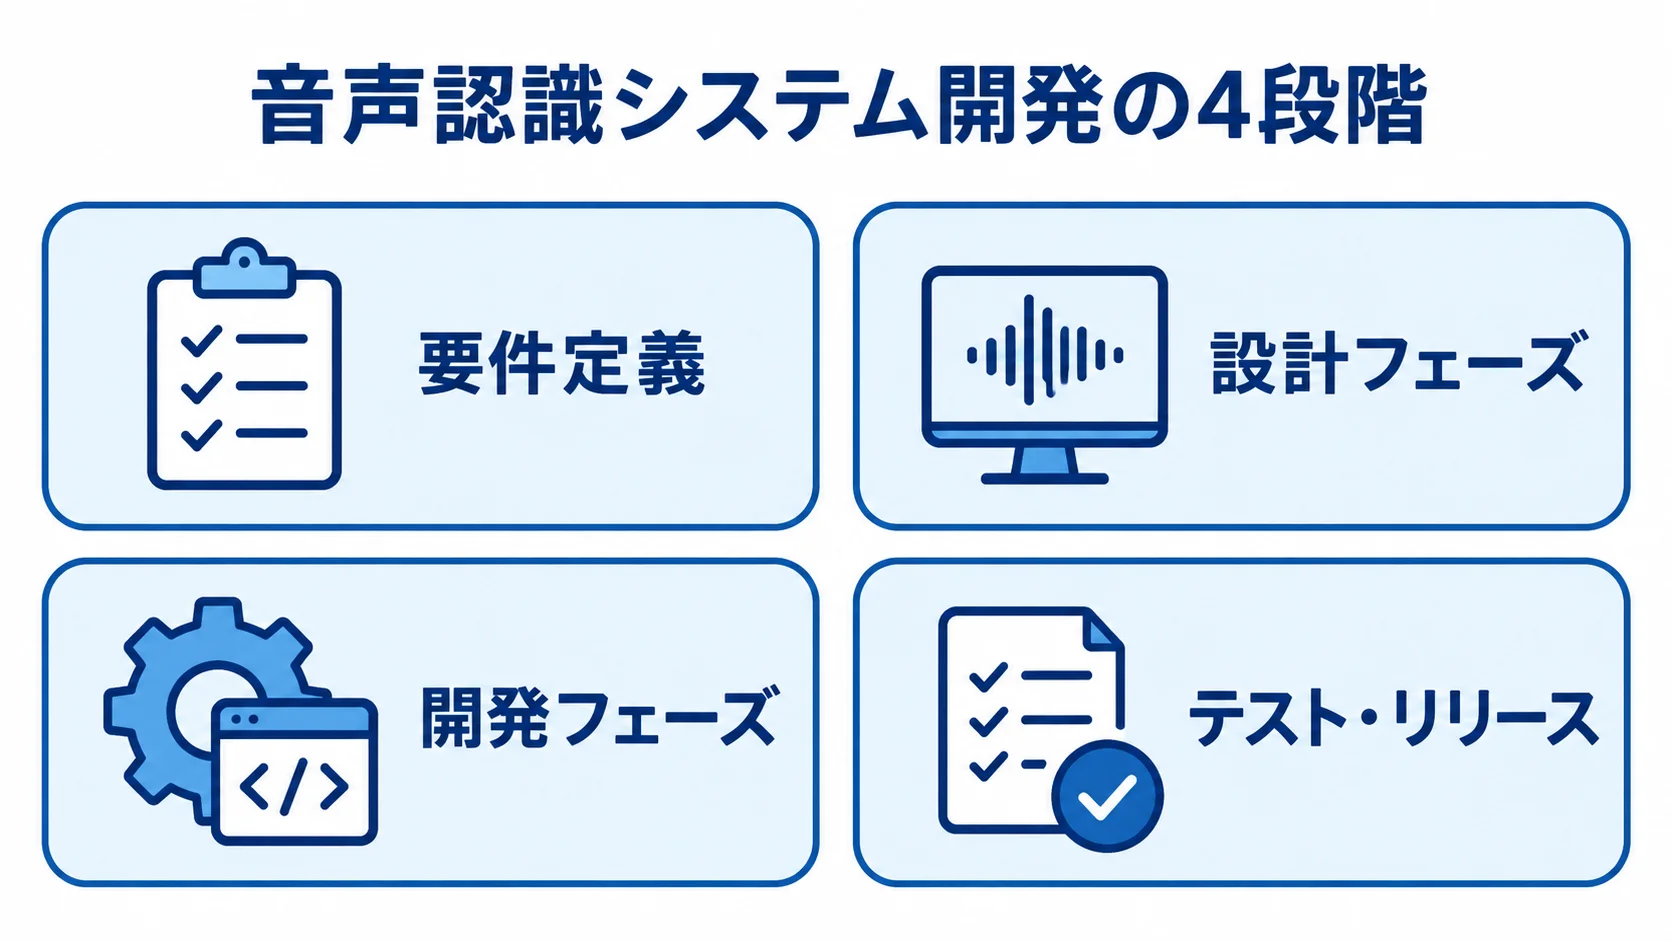
音声認識の開発では、通常のシステム開発とは異なるフェーズ構成が必要になります。特にPoC(概念実証)フェーズは、重要な役割を担います。
要件定義:音声要件と精度目標の明確化
要件定義では、通常の機能要件に加えて音声要件を整理します。
- 音声の条件:言語、話者属性、音声環境を定義します。
- 業務用語:専門用語の種類と量を整理します。
- 発話の特徴:発話スタイルを確認します。
- 精度目標:WER(単語誤り率)やレイテンシを数値で示します。
要件が曖昧なままだと、開発の完了後に期待と違うというトラブルが起きがちです。そこで、精度目標は業務の要件から逆算して決めます。
たとえば、カルテ入力でWER 20%だと、医師が毎回確認と修正を行う必要があります。この状態では効率化につながらないため、業務に必要な最低精度の水準を先に定めておきます。
ユースケースに合った精度目標を定めることが、技術選択とコストの最適化につながります。
設計フェーズ:技術選択とシステムアーキテクチャ設計
設計では、要件定義をもとに技術とシステムアーキテクチャを決めます。
- クラウドAPI活用:APIの選定と連携方式を設計します。
- オープンソースモデル:カスタマイズを前提に構成を検討します。
- 独自エンジン開発:独自の認識エンジンを作ります。
- セキュリティ設計:音声データの取り扱い方針を決めます。
クラウドAPIを使う場合は、後処理のロジックとフォールバックを設計します。カスタムモデルでは、データ収集から評価指標まで設計します。
音声データの保存期間、暗号化、アクセス制御は、設計の段階で決めておきます。加えて、クラウドへの送信の可否、データを処理する場所、個人情報保護法や業界規制への対応方針も確定させます。
後から変えると、アーキテクチャの大きな変更が必要になります。そのため、早い段階で確定させておくことが大切です。
開発フェーズ:実装と精度改善の反復
開発では、認識エンジンと周辺機能を実装しながら精度を改善します。
- 認識機能:音声認識エンジンを組み込みます。
- システム連携:バックエンドAPIと既存システムを連携します。
- 利用画面:フロントエンドUIを開発します。
- 精度改善:実際の音声データで評価し、改善を繰り返します。
開発中は、スプリントごとに精度を測り、目標に届かなければ次のスプリントで改善します。後処理では、句読点の自動挿入、固有名詞の修正、業界用語の補正を実装します。
認識結果を業務で使えるテキストに整形すると、実用的な精度が上がります。後処理のルールには業務担当者の知識が必要になるため、発注側は開発の早い段階から業務担当者を関わらせます。
テスト・リリース:精度評価と段階的展開
テストでは、通常のシステムテストと音声データによる精度評価を行います。
- 独立データ:開発データと別のホールドアウトセットを使います。
- 精度目標:WERとレイテンシの達成状況を確認します。
- エッジケース:雑音が多い環境、早口、方言、複数話者の重複発話を検証します。
- 段階展開:少数ユーザーから全社展開へ進めます。
リリース後は、少数のユーザーと限られた用途でパイロット運用を行います。その期間は1〜3か月です。
精度、操作性、システム安定性を確かめてから、全社展開へ移ります。パイロット運用期間中のユーザーフィードバックをシステムに反映すると、本格展開後のトラブルを減らせます。
費用相場・コスト感
音声認識システムの費用は、技術の選び方によって大きく変わります。投資対効果も相応に見込めるため、費用相場を把握して、自社の要件に合う方式を選ぶことが大切です。
技術アプローチ別の開発費用相場
開発方式ごとに、初期費用と継続費用の水準が異なります。
- クラウドAPI活用型:開発費は100万〜500万円です。
- オープンソースモデルのカスタマイズ型:開発費は500万〜2,000万円です。
- 独自エンジン開発:開発費は1,000万〜数千万円以上です。
クラウドAPI活用型では、Google Speech-to-Text、Amazon Transcribe、Azure Speech Servicesを使えます。なお、API従量課金は月数千円〜数十万円で、開発費とは別に発生します。
カスタマイズ型ではWhisperやWav2Vec2を使い、インフラ費は月10万〜100万円です。また、議事録作成コスト80%、カルテ入力工数50%、品質管理コスト40%の削減効果が報告されています。
投資回収期間は1〜3年のケースが多いため、最初はクラウドAPI型で効果を検証します。規模の拡大に合わせてカスタマイズを加えると、費用対効果の高い進め方になります。
代表的なROI計算事例
ROIは、導入規模と削減できる業務工数をもとに試算します。
- コールセンター:50名で月間10,000件の通話を扱う事例
- 医療機関:医師10名がカルテ音声入力を使う場合
- 製造業:工場100名規模で音声コマンドを使う場合
コールセンターでは、品質管理担当者2名の工数を削減し、年間1,400万円相当の効果が出ました。さらに、応対品質の向上による解約率低下の効果もあり、開発費300万円を8か月で回収しています。
また、医療機関では、医師1人あたり1日30分の入力時間を削減しました。年間300万円相当の時間効果があり、開発費200万円を4か月で回収しています。
このほか、製造業では、記録工数を1件あたり平均2分削減し、年間1,000万円相当の効果が出ました。開発費500万円を6か月で回収した例もあります。
精度目標を達成できないと効果が落ちます。そのため、PoCで事前に確かめておくことが大切です。
コスト削減の主要なポイント
コスト削減では、APIへ送る音声データと契約方法を見直します。
- VADの活用:音声区間だけをAPIへ送信します。
- 録音品質の最適化:処理効率を高める形式を選びます。
- API比較:PoCで費用と精度を比べます。
- 長期契約の検討:大規模利用では割引を交渉します。
たとえば、VAD(Voice Activity Detection:音声区間検出)で音声区間だけをAPIへ送ると、費用を30〜60%削減できる場合があります。適切なサンプリングレート、ビットレート、エンコード形式を選ぶことでも、処理効率が上がります。
また、同じ精度でもAPIによって費用が2〜3倍異なるケースがあります。さらに、3〜5年間のTCO(総保有コスト)で、クラウドAPIとオンプレミス方式を比べることも推奨します。
ランニングコストの考え方と長期計画
ランニングコストは、クラウドAPI方式とオンプレミス方式で内訳が変わります。
- API従量課金:クラウドAPI方式で月数千円〜数十万円です。
- インフラ費:クラウドAPI方式で月1万〜10万円です。
- 保守費:年間10万〜50万円が中心です。
- カスタムモデル費:再学習やサーバー運用の費用が加わります。
長期的なコスト計画では、5年間のTCO(総保有コスト)を試算します。そのうえで、利用量が増えたときのAPI費用、オンプレミスへの切り替え費用、運用費を比べます。この比較から、中長期で最も費用対効果の高い選択を判断できます。
カスタムモデルでは、半年〜1年ごとに数十万〜数百万円の再学習費用も予算に組み込んでおきます。
開発会社の選び方
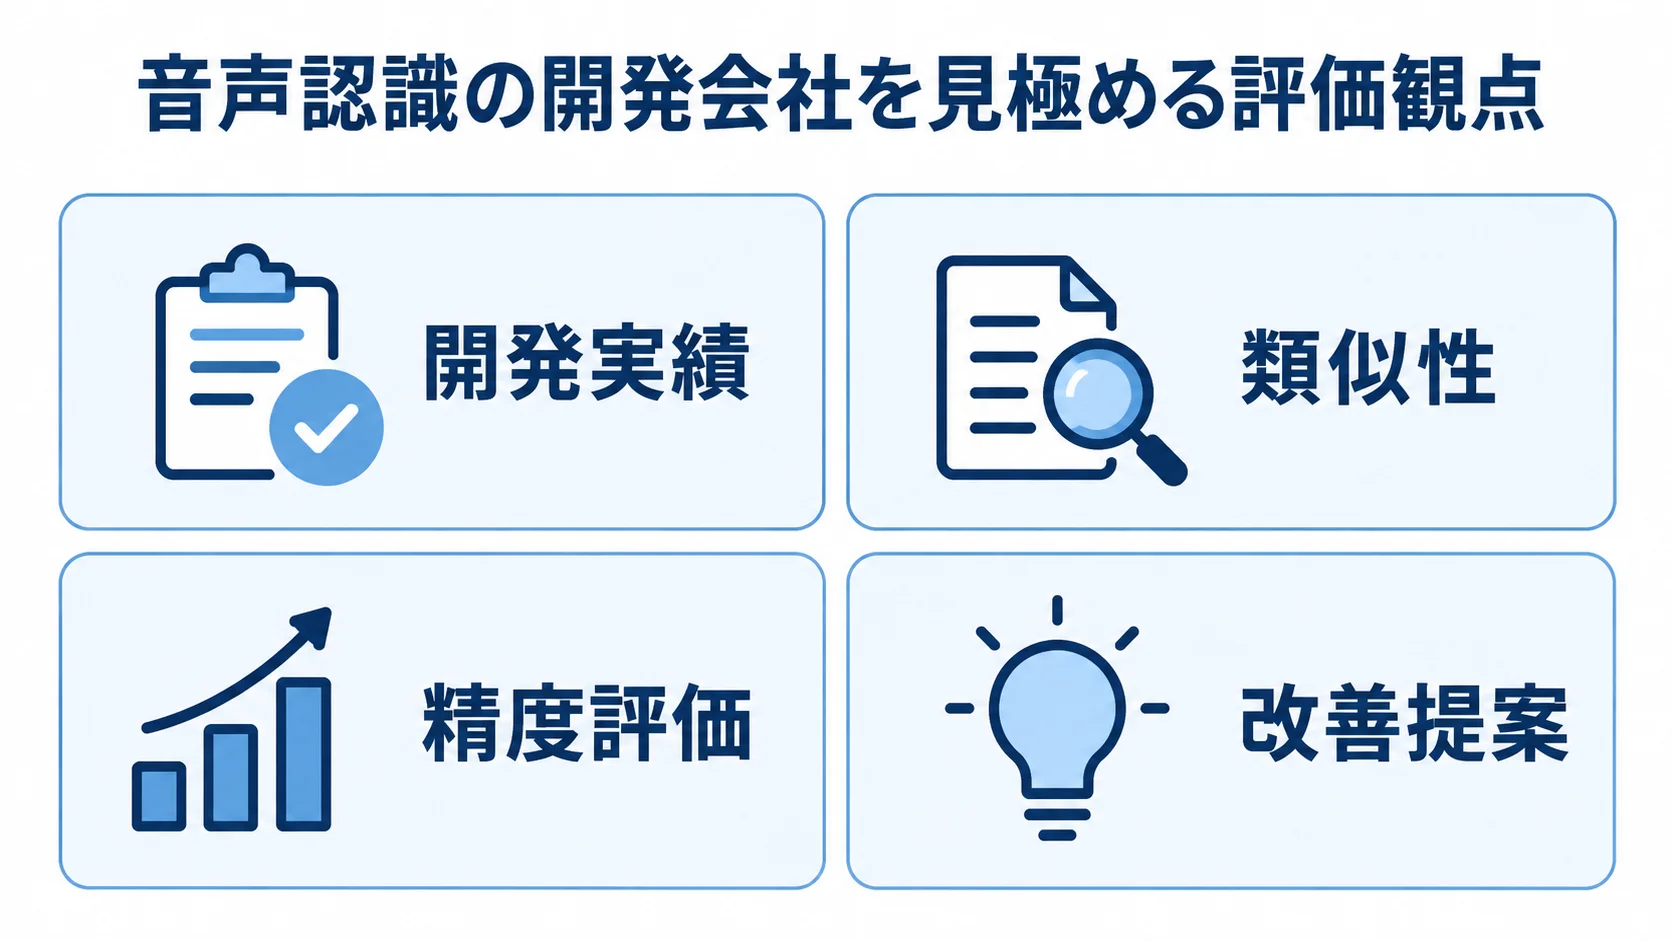
外部に委託する場合は、AI・機械学習の技術力と音声認識の経験を見て会社を選びます。
開発会社選定の重要な評価基準
会社の実績と精度評価の力を見れば、音声認識の専門性を判断できます。
- 開発実績:音声認識を実際に開発・納品した経験を見ます。
- 類似性:近い業界やユースケースの実績を確認します。
- 精度評価:WER計算やテスト設計の説明を求めます。
- 改善提案:精度向上の具体策を比較します。
実績事例では、対象業界、開発した機能、達成した精度、使用技術を具体的に聞きます。「精度は保証できません」と答えるだけでなく、改善の方法も示せる会社を選びます。
提案時に確認すべき具体的事項
提案では、技術とPoCから精度、セキュリティ、運用支援まで、一続きで確認します。
- 技術選定:選定理由と比較検討の内容
- PoC:実施内容、費用、期間
- 精度対応:目標達成の方針と、未達時の対応策
- 運用支援:プライバシー、セキュリティ、改善体制の計画
技術については、クラウドAPI、オープンソースモデル、独自開発のどれを採るかを聞きます。さらに、リリース後の精度を保つ体制と、改善サポートの内容も確認対象になります。
質問に具体的かつ論理的に答えられる会社は、実力があると評価できます。反対に、抽象的な回答にとどまる会社は、経験が足りない可能性があります。提案書の質と質疑応答の内容から、会社の実力を見極めます。
開発会社選定でよくある失敗例
一般的な開発実績だけで会社を決めると、失敗を招きます。
- 専門性の不足:音声認識の経験がない会社への発注
- PoCの省略:精度を確認せず本格開発へ進む
- 追加コスト:要件未達で大幅な費用が発生する
一般的なシステム開発の実績が豊富でも、精度目標の達成が難しい場合があります。音声認識は実際に試さないと精度が分からないため、PoCで確かめる必要があります。
開発会社の言葉だけで判断し、PoCを省く発注は避けます。一方で、PoCを前提にした発注の流れは、失敗リスクを大幅に減らします。
発注・外注方法
発注や導入では、AIや音声認識ならではの進め方を理解しておくことが大切です。
発注フローとRFP作成のポイント
発注は、要件整理からPoC、提案評価、契約、本格開発の順で進めます。
- 音声要件、精度目標、セキュリティ要件を整理します。
- 候補会社へPoCを依頼します。
- PoCで精度を確認します。
- RFPを作成して候補会社へ送付します。
- 提案を評価して最終選定します。
- 契約を締結します。
- 本格開発をキックオフします。
音声要件には、たとえば言語や話者の条件、専門用語の扱いが含まれます。
精度の項目では、WERとレイテンシを記します。データの項目では、クラウド送信の可否と保存期間を記します。
スケーラビリティ要件と継続改善の計画も、RFPに含めます。医療・金融・行政ではオンプレミス処理が必要になる場合があるため、セキュリティ要件を先に確定させます。
契約時のAI開発特有の注意点
契約では、AI開発に特有の責任範囲を、あらかじめ明確にしておきます。
- 精度保証:テストデータと目標値の扱い
- 学習データ:データの権利と利用範囲
- モデルの権利:知的財産権の帰属
- 継続改善:追加学習や辞書更新の責任の所在
WER 5%以下を強く保証するのは難しいため、特定のテストデータセットでの目標として定めます。そのうえで、自社の音声データの権利と、リリース後の精度改善の責任範囲を契約書に明記します。AI特有の事項を事前に合意しておけば、リリース後のトラブルを防げます。
まとめ・プロジェクト成功のチェックリスト
AI技術の成熟により、音声認識の開発・導入は中小企業でも取り組みやすい投資です。成功には、ユースケースに合う技術選択(クラウドAPIとカスタムモデルの比較)が必要です。
PoC、定量的な精度目標、リリース後の継続改善サイクルも欠かせない要素です。
プロジェクト開始前の確認チェックリスト
開始前には、課題から実行体制までを確かめておきます。
- 課題:ユースケースと解決したい課題を明確にします。
- 音声特性:言語、環境、専門用語を整理します。
- 精度目標:WERとレイテンシを設定します。
- データ管理:音声データのセキュリティ要件を確定します。
- 実行体制:PoCの予算・期間と担当者の参加を確保します。
プロジェクトオーナーと業務担当者が、どこまで関わるかも確かめてください。すべて整えてから発注すると、プロジェクト成功の確率が高まります。特に大切なのは、PoCを省かないことと、継続改善を前提に計画することです。
リリース後の継続改善で長期的な価値を創出
音声認識システムは、リリース後の継続改善で長期的な価値を生みます。
- データ収集:実際の使用データを集めます。
- 誤認識分析:認識ミスの傾向を確認します。
- モデル改善:辞書更新や追加学習を行います。
- 業務定着:利用を重ねて精度と効果を高めます。
このフィードバックループを回すと、使うほど精度が向上します。さらに、業務への定着が深まるほど、投資対効果も高まります。
クラウドAPI活用なら、開発費用は100万〜500万円と比較的低コストで始められます。また、投資対効果も高い領域です。
riplaでは、AI・音声認識システムの開発を、PoC支援から本格開発、継続改善まで支援しています。ぜひお気軽にご相談ください。
▼関連記事一覧
・音声認識システム開発の進め方/やり方/流れや方法/手法/工程/手順
・音声認識システム開発でおすすめの開発会社/ベンダー6選と選び方
・音声認識システム開発の見積相場や費用/コスト/値段について
・音声認識システム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。