
テキスト読み上げAIは、文字列を音声波形や音素列へ変換し、自然な発話として出力するAI音声合成技術です。
業務やデータ活用で使うには、入力の範囲、期待する出力、失敗時の扱いまで決めておく必要があります。対象データや更新頻度、利用者の権限によって、設計は変わります。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
テキスト読み上げAIとは?文字を自然な音声へ変換する仕組みと注意点
テキスト読み上げAIは、文字列を音声波形や音素列へ変換し、自然な発話として出力するAI音声合成技術です。用語の意味を覚えるより先に、何を入力として、どの処理を行い、誰にどの結果を返すのかを、境界を付けて定義することが大切です。特に、入力と出力の例を用意しておくと、実装者と利用者の認識をそろえやすくなります。
導入前には、今の手作業や既存システムで困っている点を記録しておきます。テキスト読み上げAIは、画面読み上げやナレーション、対話サービスなどで文章を音声に変える技術ですが、精度だけを追うと、コストや遅延、監査、例外処理が後回しになります。
目的は一つに絞り、成功条件と対象外の条件を先に決めてください。なお、出力が推定や生成である場合は、結果を事実として扱える範囲をあらかじめ示しておきます。そのうえで、人が確認する工程、根拠を保存する工程、誤りを訂正する工程を設計に含めると、試作から本番への移行が安定します。
テキスト読み上げAIが必要になる背景と解決できる課題
従来の方法では、入力の形式が少し変わっただけで処理が止まったり、担当者によって判断がばらついたりします。テキスト読み上げAIは、画面読み上げやナレーション、対話サービスなどで文章を聞ける情報へ変換することで、このばらつきを減らす選択肢になります。
ただし、曖昧な入力を自動的に正解へ変えるものではありません。そこで、対象業務を分解すると、アクセシビリティや動画ナレーションなどの用途の中から適用候補を見つけられます。
まずは、利用者やデータの機密性、処理の頻度を一覧にします。誤りの影響も併せて書き出し、効果が大きく、リスクを管理しやすい範囲から始めます。
人の判断を置き換えるのか、判断材料を増やすのかによって、要件は変わります。判断材料を増やすなら不確実性や根拠を表示します。一方で、人の判断を置き換えるなら、誤操作を止める承認や権限の分離が必要です。
テキスト読み上げAIの基本的な仕組み
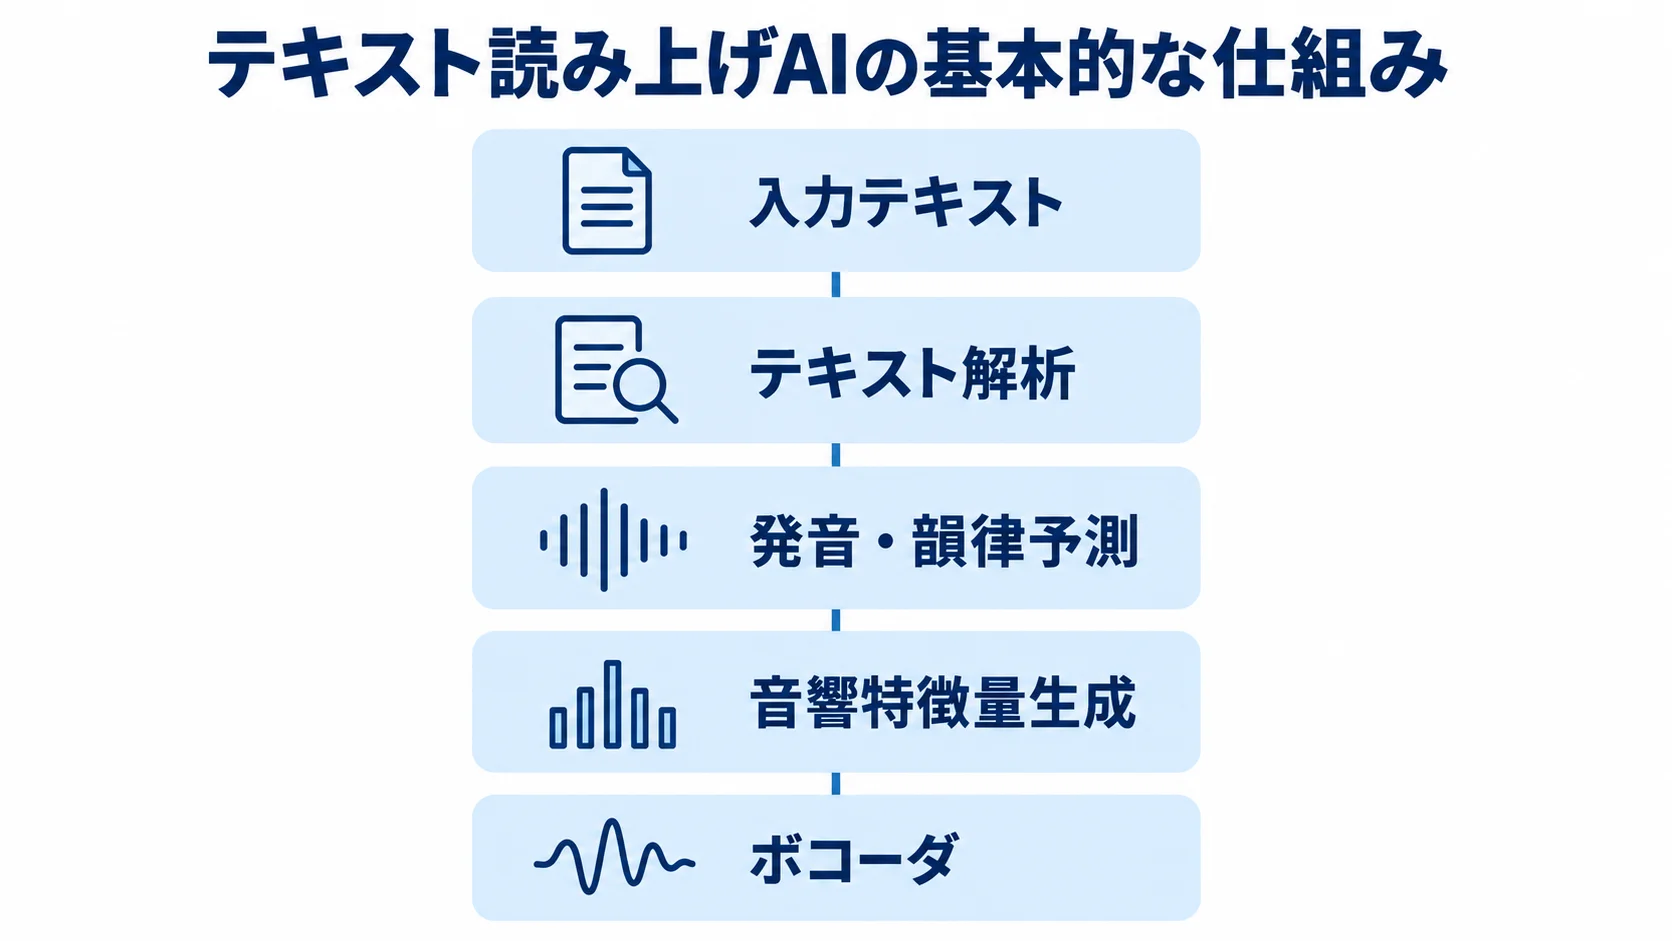
対象範囲と前提の固定
まず、対象データの単位、期間、形式を定義し、欠損や利用できるメタデータも決めておきます。テキスト読み上げAIでは、対象範囲や前処理の違いが結果に直接影響するため、条件とバージョンを記録しておいてください。
入力や観測値が欠けているときは、欠損の理由と扱いを記録します。除外や補正を行うなら、対象条件を明示したうえで、結果が特定のグループに偏っていないかを確かめます。
処理の中心と中間成果物の説明可能性
テキスト解析から発音・韻律予測、音響特徴量生成を経て、ボコーダで音声を合成します。途中の計算結果や抽出項目、判定条件を適切な粒度で保存しておくと、失敗の原因を切り分けやすくなります。
また、データは期限を決めて保存し、個人情報や秘密情報のマスキング方針も定めます。
処理は入力、変換、推論、検証、出力の段階に分け、ひとまとまりのブラックボックスにしないようにします。さらに、各段階にタイムアウトと上限を置けば、想定外のループや急な費用の増加を抑えられます。
出力の検証と人への引き渡し
出力は文字列として表示する前に、スキーマと必須項目、値の範囲、参照元を検査します。検査に失敗したら、補正を無限に繰り返さず、再試行の回数を制限して安全なエラーへ切り替えます。
最終利用者が確認すべき箇所を明示し、承認が済むまでは外部への送信や更新が実行されない仕組みにします。承認者、時刻、入力の識別子、使ったデータや手順を監査ログに残すと、後から判断を再現できます。
関連技術との違い|音声合成、SSML、音素、話者適応、音声クローン
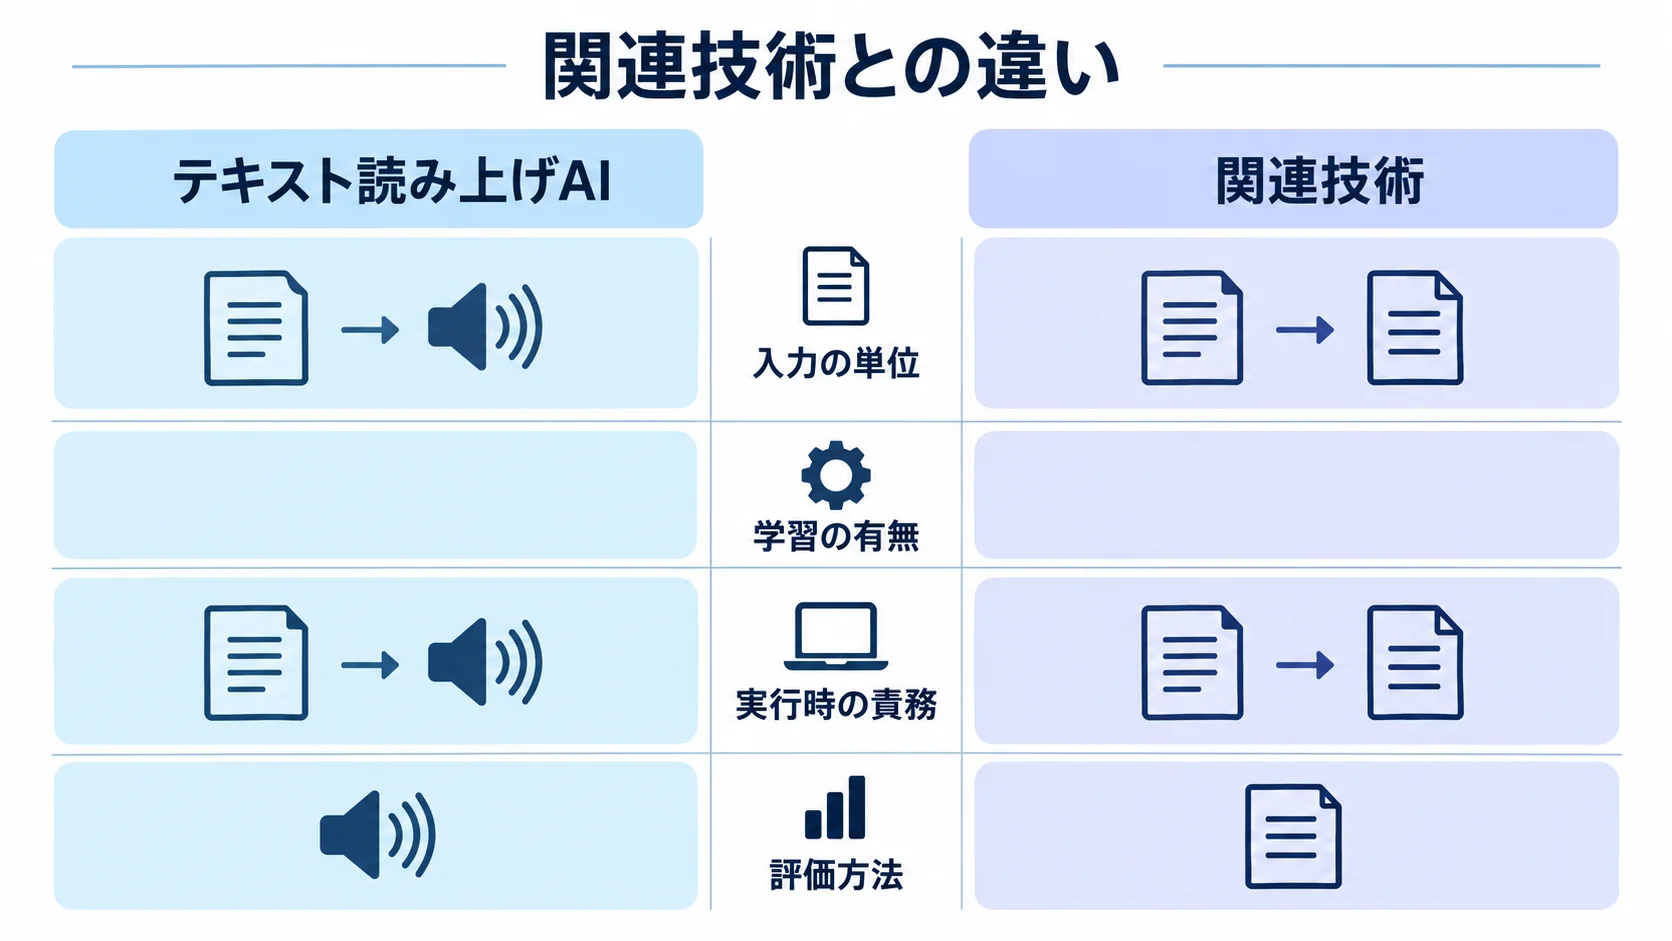
テキスト読み上げAIと混同されやすい技術には、音声合成、SSML、音素、話者適応、音声クローンがあります。似た部分があっても、入力の単位、学習の有無、実行時の責務、評価方法はそれぞれ異なります。
比較表を作り、目的と必要データ、更新方法と失敗時の対応を並べると、選びやすくなります。
新しい名称の技術でも、既存のルールや単純な検索で足りる場合は、複雑な構成を加えないほうが、説明可能性と保守性を保てます。そこで、小さな基準実装を用意し、同じデータで差を測ってから採用を決めます。
境界が重なる場合は併用もできますが、責任の範囲は分けておきます。たとえば、検索は検索器、生成は生成器、アクセス制御はアプリケーションが担い、安全対策をテキスト読み上げAIに丸ごと任せないようにします。
テキスト読み上げAIを導入する手順
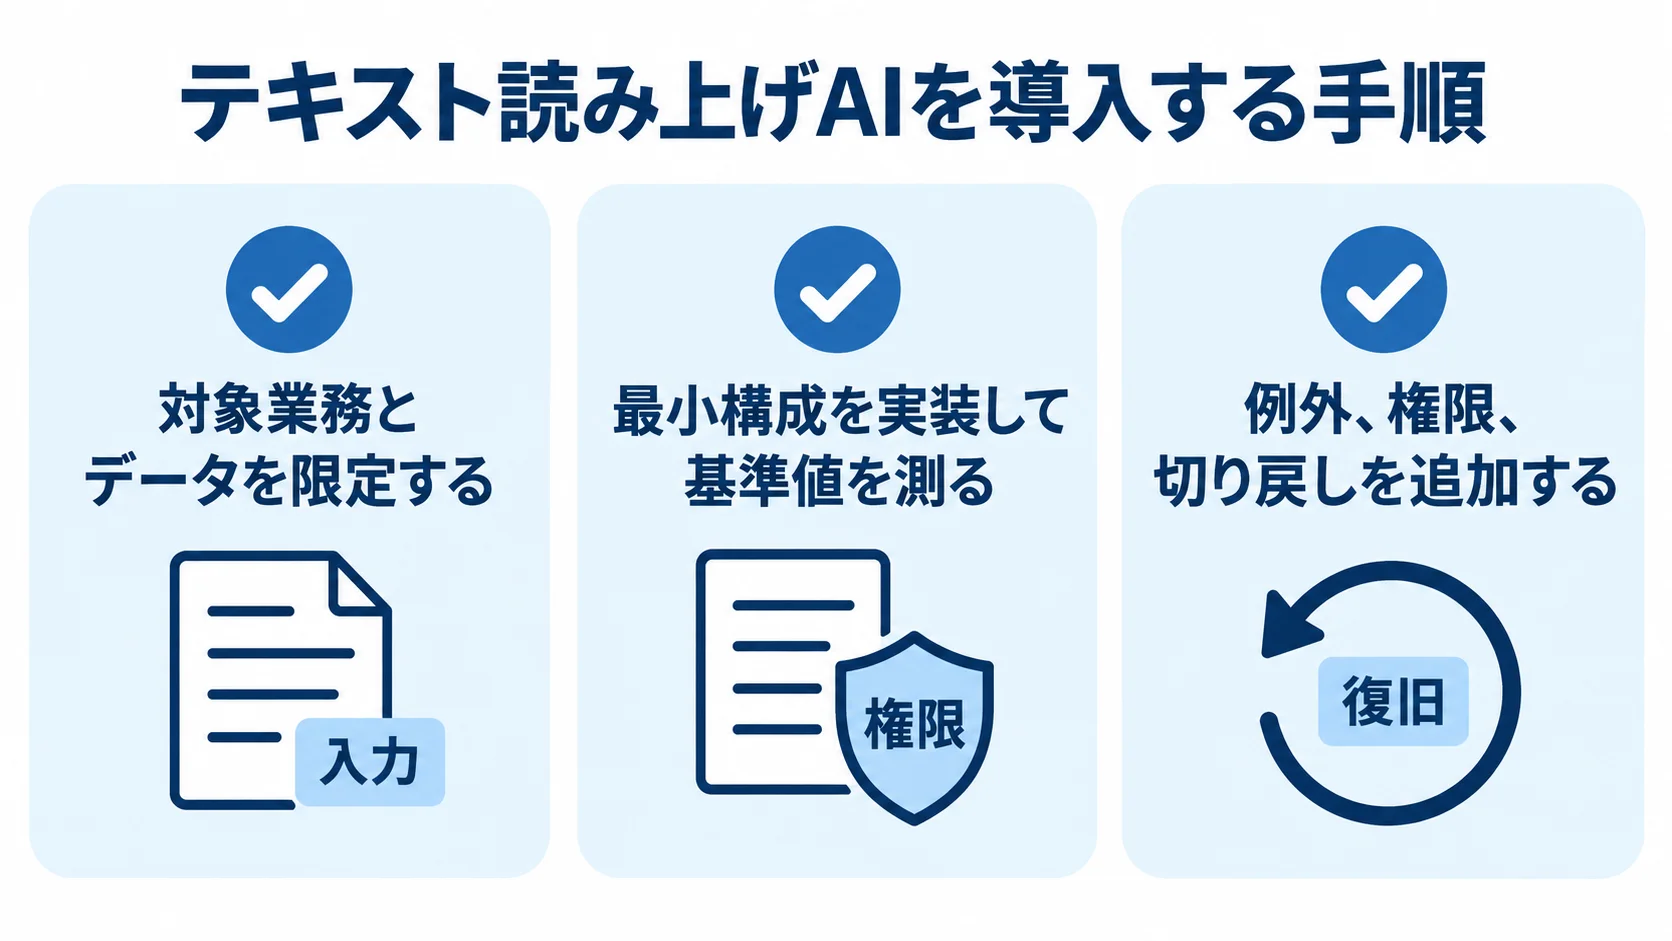
1. 対象業務とデータの限定
最初の検証では、アクセシビリティ、動画ナレーション、IVR、学習教材、音声エージェントのうち一つを選びます。そのうえで、入力件数、更新頻度、許容できる誤りを定義します。
個人情報や秘密情報を含まない代表データを用意し、本番データをそのまま持ち出さないようにします。
データについては、権利と利用目的、保存期間、第三者提供の有無を事前に確かめます。また、評価用データと開発用データは分け、検証結果を見てテストデータを何度も調整しない運用にします。
2. 最小構成の実装と基準値の測定
まずは、入力から出力までの最短経路だけを実装し、必要な機能は後から足します。そのうえで、実行時間、計算資源、失敗の種類をログに残し、改善前の基準値を作っておきます。
出力の正しさを人手で採点する場合は、複数の評価者に同じ基準を渡し、判定の一致度を確認します。一方で、自動指標だけでは、もっともらしい誤りや危険な表現を見逃すことがあります。
3. 例外、権限、切り戻しの追加
固有名詞や専門語の読み誤り、抑揚の不自然さ、声の権利やなりすましリスクは、正常系のテストだけでは見つかりにくい問題です。そこで、リリース前に例外系のテストを、入力、権限、復旧の順に組みます。
- 入力:攻撃的な入力や、機密情報が混ざった入力
- 権限:権限外の要求や、外部への誤った操作
- 復旧:失敗例を加えた再現テスト
このほか、入力が空の場合やデータが古い場合、外部サービスが止まった場合、出力が規定外の場合を試し、処理を止めて人へ渡す条件を決めます。
権限は最小限にとどめ、読み取りと書き込み、参照と送信を分けます。さらに、新しい版は段階的に提供し、問題が出たら前の版へ戻せるよう、データ、手順、設定を一緒にバージョン管理します。
result = component.run(input_data)
validated = validate_schema(result)
if not validated.ok:
    return request_human_review(validated.errors)
return persist_with_audit_log(validated.value)
上の擬似コードは、処理結果をそのまま使わず、検証と人への引き渡しを挟んだ最小パターンです。
実際の実装では、入力と出力のスキーマ、タイムアウト、再試行、認証、監査ログを対象サービスの公式仕様に合わせます。ただし、便利なライブラリを使う場合も、既定の権限や外部通信の動きは確かめてください。
テキスト読み上げAIの評価方法|品質・安全性・コストの同時評価
品質評価では、発音誤り率やMOSを中心に、用途に合った指標を組み合わせます。理解度や遅延、話者同意、生成音声の識別可能性も、用途に応じて選びます。
平均値に加えて、入力の種類や難易度ごとに分け、特定のグループだけ悪化していないかを見ます。また、評価データの作り方と採点基準は、変更履歴を残しておいてください。
安全性は、攻撃的な入力や機密情報の混入を含むテストで確認します。権限外の要求や誤った外部操作も、テストの対象に入れます。そのうえで、失敗した入力は再現テストに加え、修正後は別の機能が壊れていないかを回帰確認します。
コスト評価では、1件あたりの計算量や外部APIの料金、ストレージといった直接の費用に加えて、監視やレビューにかかる人の時間も合わせて見ます。ただし、品質が少し上がっても、遅延や確認作業が増えて業務全体が悪化するなら、構成を見直します。
テキスト読み上げAIで起こりやすい失敗と対策
代表的な失敗は、固有名詞や専門語の読み誤り、抑揚の不自然さ、声の権利やなりすましリスクです。原因は大きく、機能そのものの限界と、データや評価設計の問題、権限や運用の問題に分かれます。そのうえで、どの層で直すかを決めます。
データの欠落やアクセス制御の問題は、出力文の工夫とは別の層で直す必要があります。また、再現できない評価や、テストの数が少なすぎる状態、同じデータを開発と採点に使うことも避けます。変更の前後では条件をそろえ、モデルとデータの版、乱数、プロンプト、検索設定を保存します。
利用者への説明が足りないと、誤りが見つかっても適切に訂正されません。利用者には、自動処理であることや確認が必要な場合を、画面や文書で伝えます。加えて、問い合わせ先とデータの利用目的も明記します。
テキスト読み上げAIを本番運用するチェックポイント
本番では、品質指標に加えて、エラー率、タイムアウト、遅延、資源使用量、入力の分布の変化を監視します。閾値を超えたときは、通知にとどめず、処理を安全側へ切り替えるランブックを用意します。
データやモデルを更新するときは、承認者と変更理由を記録し、段階リリースやサンプル監査を行います。なお、利用者からの訂正を学習やテンプレート改善に反映するなら、個人情報や権利の扱いを改めて確認します。
導入を定着させるには、技術担当者だけでなく、業務担当者も結果を判断できる手順が必要です。そのため、発音誤り率やMOSなどの指標を週次や月次で確認し、継続、縮小、停止の基準を関係者と合意しておきます。
テキスト読み上げAIまとめ|小さく始めて段階的に広げる進め方
要約すると、テキスト読み上げAIは、文字列を音声波形や音素列へ変換し、自然な発話として出力するAI音声合成技術です。
適用の候補には、アクセシビリティ、動画ナレーション、IVR、学習教材、音声エージェントがあります。そのうえで、用途に合わせて目的を定めます。
実装では、入力を検証し、処理を段階に分けて、出力をスキーマと業務ルールで確認します。さらに、固有名詞や専門語の読み誤り、抑揚の不自然さ、声の権利やなりすましリスクを前提に、権限、監査、切り戻しを最初の試作から組み込んでください。
最終的には、発音誤り率やMOSなどの指標を定期的に測り、品質、コスト、安全性のバランスを見ながら改善していきます。
小さな対象で得た失敗の知見を文書にまとめてから、データ量や利用者を段階的に増やすと、長く使える仕組みになります。
よくある質問(FAQ)
Q. テキスト読み上げAIとは何ですか?
テキスト読み上げAIとは、文字列を音声波形や音素列へ変換し、自然な発話として出力するAI音声合成技術です。導入では、入力、処理、出力、失敗時の扱いを定めたうえで、用途に合う評価指標で効果を確かめます。
Q. テキスト読み上げAIは何に使えますか?
代表例は、アクセシビリティや動画ナレーション、IVR、学習教材、音声エージェントです。そのうえで、対象業務で誤りが起きたときの影響、データの権利、確認の工程を整理し、小さな範囲から検証します。
Q. テキスト読み上げAIを導入するときの注意点は何ですか?
固有名詞や専門語の読み誤り、抑揚の不自然さ、声の権利やなりすましリスクに注意が必要です。そのため、入力の検証や最小権限、出力のチェック、監査ログ、切り戻しを設け、失敗例を回帰テストに加えます。
Q. テキスト読み上げAIの効果はどの指標で評価しますか?
発音誤り率やMOSは、用途に合った指標の中心になります。理解度や遅延、話者同意、生成音声の識別可能性も、用途に応じて測ります。平均値に加えて、難易度や利用者層ごとの結果、遅延、コスト、安全性も併記します。
Q. テキスト読み上げAIと関連技術はどう使い分けますか?
関連技術には、音声合成やSSML、音素、話者適応、音声クローンなどがあります。目的と必要データ、更新頻度、権限、失敗時の責任範囲を比べ、最小構成で差を測ってから選びます。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
参考資料
参考資料は、W3Cの「Speech Synthesis Markup Language」です。Google Cloud Text-to-Speechの公式資料も、www.w3.orgで確認できます。
各サービスやライブラリの公式ドキュメントでは、利用時点の仕様と料金を確認してください。
一次資料の更新履歴とセキュリティ告知は、導入前に最新版を確認してください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。