
TimescaleDBのシステム開発は、要件整理、構成選定、段階導入の順に進めると、現場で使える仕組みに育てられます。実際の開発は、要件整理から定着までの6フェーズに分けて進めます。
システムの全体像は、TimescaleDBのシステム開発の完全ガイドで先に確認できます。
▼全体ガイドの記事
・TimescaleDBのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
TimescaleDBのシステム開発の全体像
TimescaleDBはPostgreSQLを拡張したデータベースで、時系列データの書き込みや期間集計を扱いやすくします。ただし、業務システムを自動で完成させる製品ではありません。
PostgreSQLとの違いと適用範囲
通常のPostgreSQLでも、履歴を少量保存して検索するだけなら十分な場合があります。
センサー値を秒・分単位で継続的に取り込み、設備やラインごとに期間集計して、マスタやロット情報と結合する場合は、TimescaleDBが候補になります。
採用の判断は、「時系列だから」という理由だけでは決めません。書き込み件数や応答目標、保持期間などを並べて、PostgreSQLで足りるかを比べます。
- 時系列機能:継続データであれば、Hypertable、time_bucket、Continuous Aggregateが候補
- 書き込み件数:1秒あたりに必要な処理量
- 応答目標:代表クエリに求める応答の目標
- 同時利用者数:想定する利用規模
- 保持期間:必要なデータを残す期間
基本構成は、PLCやセンサーからエッジゲートウェイへ接続し、MQTTまたはOPC UAブローカー、取り込みAPIやストリーム処理を経て、TimescaleDB、API・ダッシュボード、MES・ERPへつなぎます。
DBへ直接送ると、通信断や再送、重複を扱いにくくなります。さらに、認証や異常値の検知も難しくなります。そのため、収集層とDBの間に責任範囲を置きます。
現場で使えるデータモデルの設計
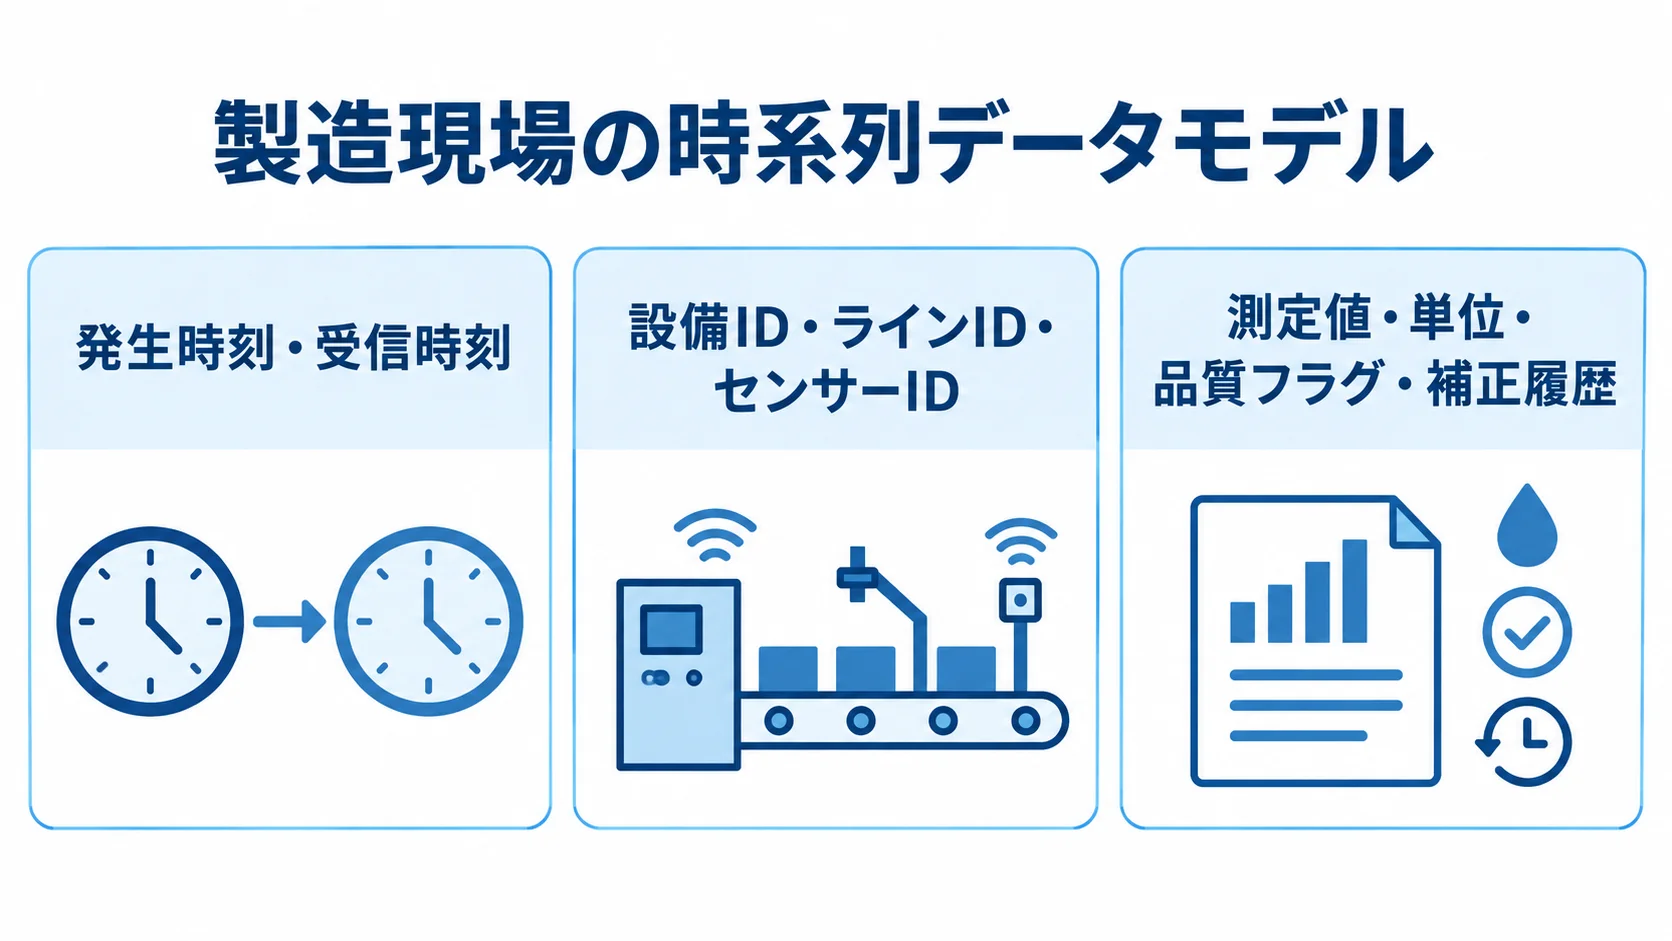
製造業では、測定値だけでは後から原因を追えません。そのため、いつ、どの設備の、どのロットの値なのかを、測定値と一緒に残す設計にします。
- 時刻:発生時刻の
event_timeと受信時刻のingest_time - 識別情報:設備ID、ラインID、センサーID、ロットまたはシリアル
- 測定と状態:測定値、単位、品質フラグ、補正履歴、アラート状態
遅延データを発生時刻と受信時刻のどちらで集計・監視するかを決めておくと、画面と現場の認識がそろいやすくなります。
Hypertableは時刻を基準にデータをチャンクへ分けます。
チャンクの期間は、細かすぎるとクエリ計画に負荷がかかります。一方で、粗すぎると保守や削除の単位が大きくなります。
そこで、設備数やサンプリング周期、1日のデータ量を基に、代表的な検索期間も含めてPoCで書き込みと検索を実測します。その結果から設定値を決める流れが安全です。
出典はTimescale公式ドキュメント「Hypertables」(2026年参照)です。
TimescaleDBのシステム開発の進め方
開発は、現場の判断と運用を先に固めてからDBを構築する流れで、6フェーズに分けて進めます。
各フェーズで出すものと合格条件を確かめてから、次へ進みます。
フェーズ1:要件整理における目的とデータの洗い出し
まず、どの業務判断を速くするかを決めます。そのうえで、導入の前後で測れるKPIを設定します。
- 業務指標:停止時間、異常検知から通知までの時間、OEE
- 生産・電力:電力原単位、ロットの追跡調査時間
- データ条件:設備、PLC・センサー、周期、単位、時刻同期、保存年数
欠損や訂正、ロットとの紐付け、利用者権限も一覧にします。
正常値と異常値の例も用意します。
通信断から何分遡って再送するか、重複の判定方法、未受信データの確認者を決めます。
1設備または1ラインの検証には、通信断、遅延、再送、訂正の4ケースを含めます。そうすると、後工程の手戻りを減らせます。
フェーズ2:選定におけるクラウド・自社運用・構成の比較
運用方式は、サービスに任せる範囲と自社の運用負荷を合わせて比べます。
- Timescale Cloud:バックアップ、可用性、サイズ変更、監視を任せやすい
- AWS:EC2・EKSを使った構成
- Azure:Azure Database for PostgreSQL Flexible Serverを使った構成
AWSやAzureで運用する場合は、バックアップやレプリケーション、障害対応を自社または委託先が担います。
ネットワーク分離や拡張の許可、アップグレードも、どちらが担うかを確かめておきます。
利用料だけでなく、夜間対応や、どこまでを誰が受け持つかを含めた総保有コストで比べます。
Azureでは、TimescaleDBのApache-2 edition対応とPostgreSQLのバージョンを確認します。
Microsoft Learnの2026年更新資料では、TimescaleDBを使うメジャー移行に対応する組み合わせは限定されると説明されています。
条件外では、サイドバイサイド移行など別方式が必要と説明されています。
現行版と更新時期、停止時間や復旧手順をRFPに記載します。
出典はMicrosoft Learnの資料です。資料名は「Major Version Upgrades – Azure Database for PostgreSQL」です(2026年更新)。
フェーズ3:設計・開発における取り込みから画面までの接続
設計では、時系列テーブルと設備・製品・拠点・ロットのマスタを分けます。そのうえで、代表クエリで必要なJOINを定義します。
- 生データ:秒単位のテーブルで記録する
- 短期集計:分単位のContinuous Aggregateを用いる
- 長期集計:日単位の集計を用いる
この分け方は、リアルタイム監視と長期分析に役立ちます。特に、Continuous Aggregateは差分更新されるため、通常のマテリアライズドビューのように全体を毎回作り直す負担を抑えます。
出典はTimescale公式ドキュメント「About continuous aggregates」(2026年参照)です。
取り込み層には、認証やスキーマ検証、単位変換を持たせます。
バッファと再送、重複排除も備えます。
業務連携には、API、CDC、バッチを使い分けます。
遅延データの集計先と、訂正履歴の扱いも決めておきます。
アラートの通知先と通知までの時間も確認します。
HypercoreやColumnstoreでは、更新中のデータを圧縮対象から外します。
頻繁に絞り込む列は、segmentbyの候補になります。この点は、設計レビューでまとめて検討します。
フェーズ4:テストにおける性能・欠損・復旧の検証
画面が表示されるだけでは、本番の負荷や障害時の動きは確かめられません。そこで、ピーク時の処理や通知の速さ、異常時の振る舞いまで検証の対象に含めます。
- 性能:ピーク書き込み、期間検索、設備・ライン・ロット間のJOIN
- 集計・通知:集計更新の遅延とアラート通知までの時間
- 異常系:異常値、未来時刻、遅延、重複、欠損、通信断、DB再起動
通信断からの再送も組み合わせて、期待結果をテストケースにします。そのうえで、負荷条件を変えて計測します。
バックアップは別環境へ復元して、業務を再開できるかを確認します。あわせて、復旧時間と許容データ損失をRTO・RPOで定義します。
Timescale公式資料は、原データの削除と集計更新の期間が重なると、集計側の過去データも失う可能性を示しています。
生データ30日、分集計2年、日集計5年といった案も、更新期間と復元手順を試したうえで決めます。
フェーズ5:稼働における段階導入と切り戻しの準備
最初は1ラインまたは1設備で並行稼働します。そのうえで、切り替え時の判断条件を決め、稼働後の監視と旧環境への復帰に備えます。
- 監視:監視項目とデータ遅延の許容値
- 連絡:通知先と障害時の連絡網
- 切り戻し:旧システムへ戻す条件
停止を避けるため、エッジ側に一時保存領域を設けます。DBやネットワークが復旧したあとに、データを再送します。
本番初日は、CPU、メモリ、ディスクを確認します。
取り込み遅延や未処理キュー、重複率、欠損率も見ます。
Continuous Aggregateの更新遅延も見ておきます。
現場責任者が異常の発見から対応の記録まで行えるようになれば、業務稼働は達成です。
フェーズ6:定着における運用ルールと改善サイクル
運用担当と確認手順を決めます。そのうえで、現場と管理者の役割を分けます。
- 現場:データ品質とアラートを確認し、点検・停止・記録を行う
- 管理者:権限、監査ログ、バックアップ、パッチ、容量、遅延を確認する
通知先があっても担当者が決まっていない状態では、システムは業務に定着しません。
月次または四半期ごとに、欠損率と再送成功率を見直します。さらに、アラート的中率と応答時間も確認します。
ストレージ増加量と現場の利用状況も見ておきます。
新しいラインを追加する前に、既存ラインのデータモデルとテストケースをテンプレート化しておくと、設計をやり直さずに済みます。
TimescaleDBのシステム開発にかかる費用相場
国内のTimescaleDB受託開発の価格は、公開された例が限られています。
以下の金額は、製造・IoT構成と一般的な開発人月をもとにした目安です。
金額は、設備数やデータ点数、頻度で変わります。さらに、保持期間や拠点数、連携先によっても違いが出ます。また、可用性や移行の範囲、テストや保守の扱いも費用に響きます。
金額は税別の概算です。
同じ条件を複数社に提示し、正式見積で精査します。
規模別の開発費と期間の目安
開発費の幅は、規模と実装範囲によって次のとおりです。期間も合わせて確認します。
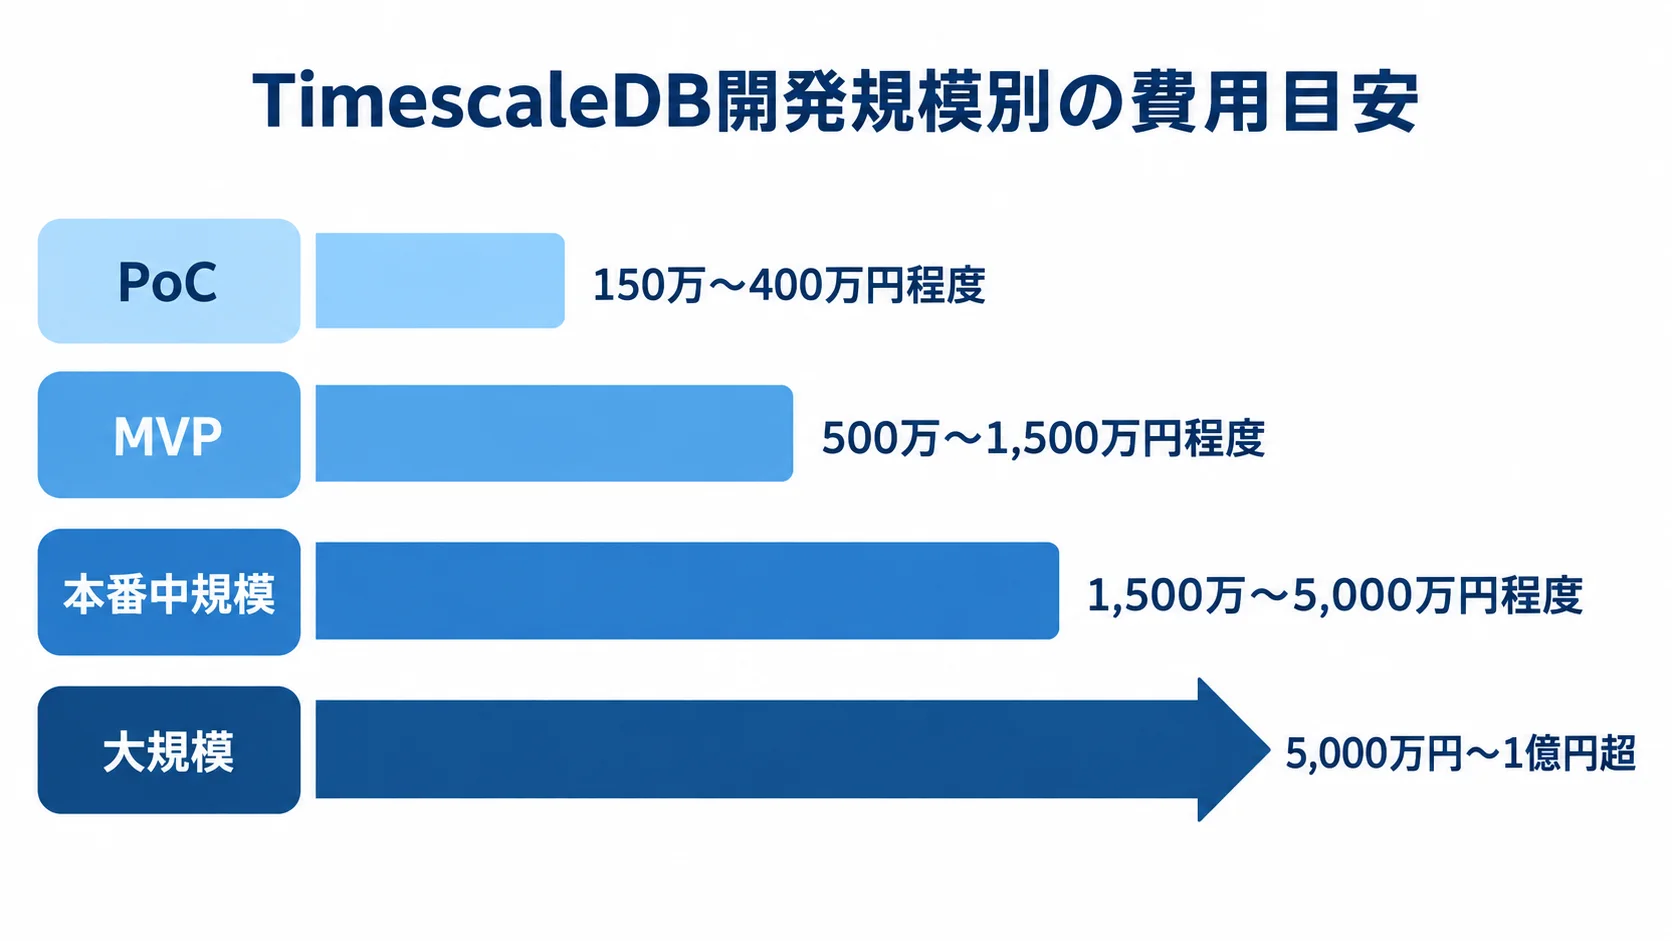
- PoC:1設備または1ライン、センサー数十〜数百、簡易ダッシュボードと通信断検証で150万〜400万円程度、期間は1〜2か月が目安
- MVP:複数設備、MQTTまたはAPI、アラート、分・日次集計、権限で500万〜1,500万円程度、2〜4か月程度が目安
- 本番中規模:MES・ERP・WMS連携、複数ライン、HA、監査ログ、移行、総合テストで1,500万〜5,000万円程度、6〜12か月程度が目安
- 大規模:複数工場、24時間運用、災害対策、全社分析、段階移行で5,000万円〜1億円超、12〜24か月以上になる可能性があります
いずれも、製造・生産システムの一般的な構成から推定したレンジです。
TimescaleDB固有の定価ではありません。また、工場数に加えて、夜間対応や停止できない設備の切り替え条件も費用を左右します。
クラウド利用料と運用保守費の切り分け
Timescale Cloudの2026年料金例は、Performanceがコンピュート月30ドルから、Scaleが月36ドルからです。
ストレージはプランにより、1GB・月あたり0.177ドルまたは0.212ドルです。
1ドル150円で単純換算すると、最低コンピュートは月約4,500〜5,400円です。これはDBサービスの最低ラインです。
HAやI/O、バックアップは別途です。さらに、ネットワークとアプリ、監視と保守の費用も含まれていません。
これは、Timescale公式料金ページの2026年掲載例に基づく参考値です。
月額のクラウド利用料は規模で変わります。次の目安は、負荷と容量に加えて、レプリカや保持期間も踏まえた推定です。
- 小規模PoC:月0.5万〜5万円程度
- 中規模本番:月5万〜50万円程度
- 大規模・高可用性:月50万円〜数百万円になる可能性
これらは実測前に断定できません。一方で、自社運用ではソフト費を抑えられる場合があります。
更新やバックアップ、監視の費用と、障害対応の費用は、人員または委託費として計上します。一般的な業務システムでは、運用保守は初期開発費の年15〜25%程度が目安です。
対応時間と作業範囲は、見積書で分けて示してもらいます。
TimescaleDBの見積もりを取る際のポイント
接続方式やデータ品質を見積もりに含めるかどうかで、金額は変わります。そこで、条件をそろえたRFPを示し、同じ粒度の提案を受けます。
RFPには、データ量や障害ケース、性能目標を記載します。加えて、運用体制と納品後の責任範囲も書きます。
要件定義書に入れる数字と例外ケース
見積もり条件には、設備規模やデータ量、検索要件を記載します。さらに、品質ルールも書いておきます。
- 規模と性能:設備・センサー数、点のサイズ、周期、ピーク点数、同時接続数
- 容量と検索:1日・1年のデータ量、保持年数、検索期間、許容応答時間
- 品質と運用:時刻、単位、欠損・重複・遅延・訂正、権限、監査、復旧、RTO・RPO
ロット・シリアルとの紐付けと、集計粒度も明記します。さらに、event_timeとingest_timeの扱いも指定します。
PoCを含めるなら、1ラインで正常と異常の両方を再現します。加えて、通信断や遅延、再送、重複排除の場面も含めます。
開発会社には、書き込みや代表クエリ、集計更新、復旧時間の実測値を提出してもらいます。そのうえで、実クエリと品質によって合否を決めます。
開発会社の比較(DB・IoT・現場運用の3面)
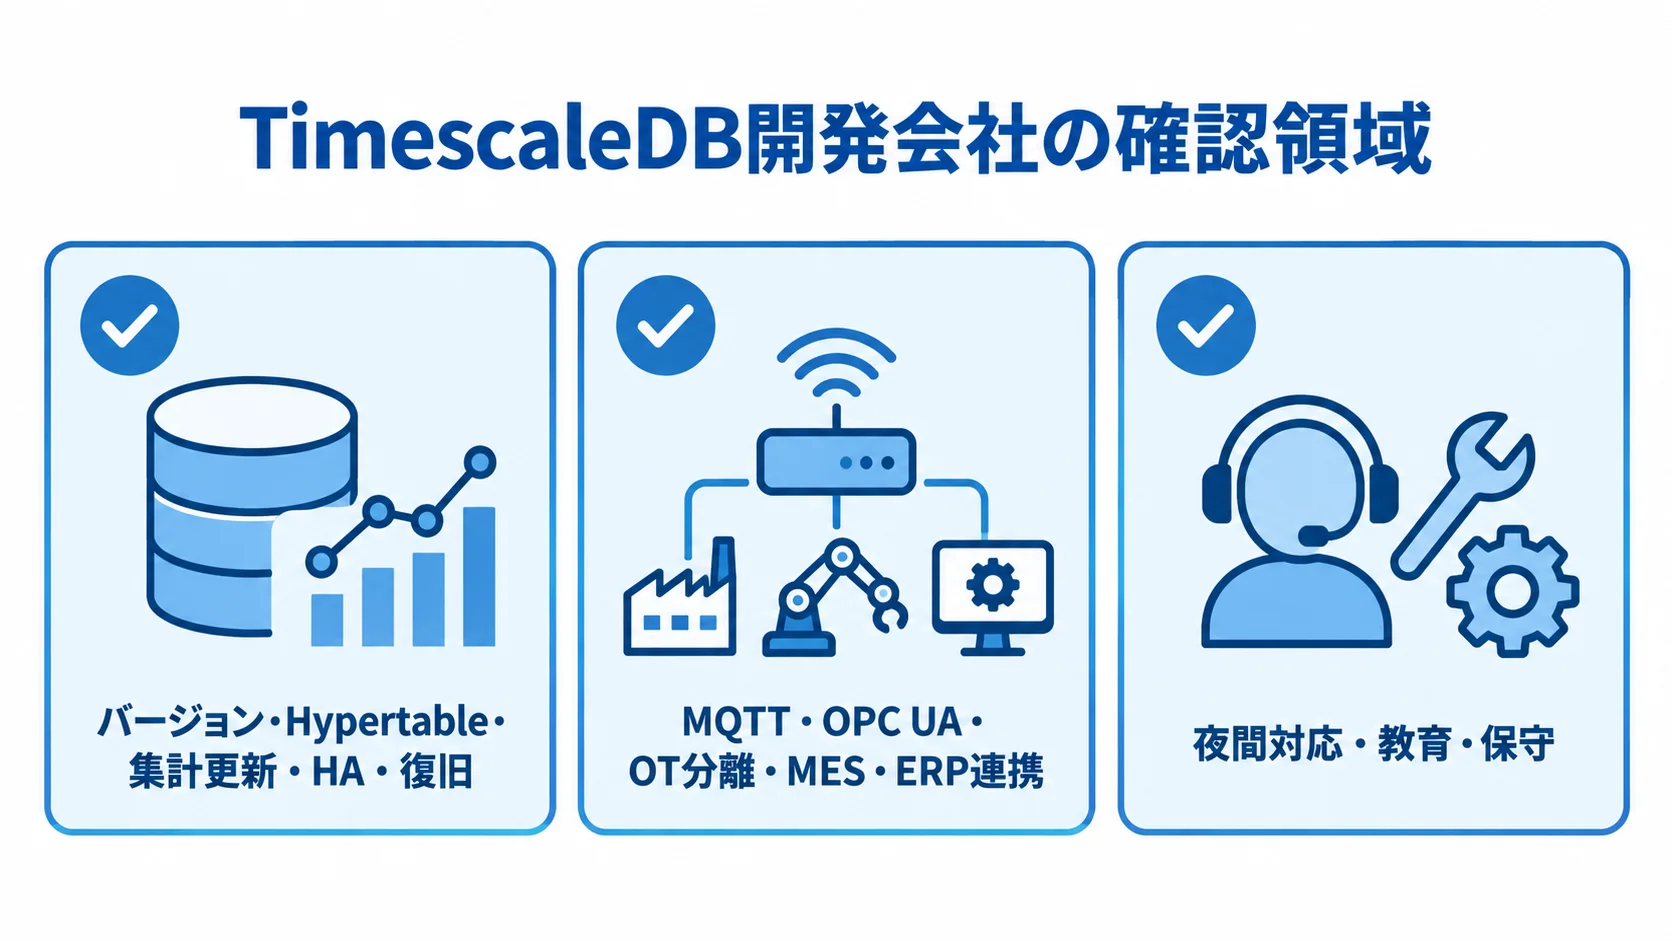
候補となる会社には、DB設計とクラウド制約への対応経験があるかを確認します。
- DB:バージョン、Hypertable、集計更新、遅延データ、HA、復旧
- IoT:MQTT・OPC UA、OT分離、MES・ERP連携、Azure・AWSの制約
- 運用:夜間対応、教育、保守、業務で使われる状態までの支援
提案書では、製品元とクラウドの役割、実装・保守とIoT連携の役割を、それぞれ分けて示してもらいます。
Timescale公式のUnited Manufacturing事例では、IoTセンサーのデータ基盤でContinuous Aggregateを活用しています。さらに、自動保持も使っています。
その事例は、運用負荷と分析性能の改善につながっています。ただし、他社の案件で同じ効果が保証されるわけではありません。
事例は参考にしつつ、自社データでのPoCや担当者の経験、障害時の連絡方法を契約前に確認します。
出典はTimescale公式「United Manufacturing」事例(2026年参照)です。
除外項目とリスクの確認
見積書は、工程と費用の対象範囲を分けて確認します。
- 開発項目:要件、PoC、ゲートウェイ、DB、API、画面、連携、移行、テスト
- 付帯項目:セキュリティ、教育、保守、クラウド、ライセンス、監視、通信、現地作業
「データ連携一式」などの記載があれば、設備数や方式、テスト回数を質問します。
納品物や前提、バックアップ保管を含むかも確かめます。
工場OTとIT・クラウドの分離、TLSの利用を確認します。さらに、IP許可またはVPC、最小権限、監査ログも確かめます。
秘密情報の扱いや脆弱性対応、復旧テストも項目に入れます。
暗号化だけでなく、拡張管理や更新時の停止・切り戻しも評価します。
TimescaleDBのシステム開発でよくある質問
採用時はデータ量だけでなく、業務システムや現場運用、クラウド制約も検討します。導入前の疑問に答えます。
TimescaleDBは通常のPostgreSQLと何が違いますか?
TimescaleDBはPostgreSQLを拡張したデータベースで、Hypertable、time_bucket、Continuous Aggregateを利用できます。
SQLやトランザクション、マスタとのJOINを活用できるため、時系列の書き込みや検索、集計を設計しやすくします。ただし、データ収集から運用まで、すべてを自動で提供する製品ではありません。
Timescale Cloudと自社運用はどちらが安いですか?
小規模検証では、構築やバックアップ、監視の初期作業を抑えやすいTimescale Cloudが比べやすいです。
一方で、大規模で既存基盤を使える場合は、自社運用が有利になる可能性があります。その際は、管理工数や障害、更新、セキュリティも含めて比べます。
利用料だけでなく、3年分のクラウド費と開発費、保守費、停止リスクを並べて比べます。
最初から全工場へ導入したほうがよいですか?
まずは1設備または1ラインのPoCから始めると安全です。通信断や復旧も含めて確認します。
正常値や遅延の場面、再送や重複の場面を試し、現場がアラートに対応できるかを検証します。
また、PoCの合格条件と拡張条件を先に決めておきます。成果を確認できた領域から、段階的に広げます。
生データは何年保存すればよいですか?
保存年数は一律に決めず、追跡性や品質保証、法令・契約の要件に応じて粒度を分けます。分析や復旧の要件も含めて判断します。
生データ30日、分集計2年、日集計5年といった設計例もあります。ただし、実際の期間は業務要件とデータ量で決めます。
集計更新と生データ削除の期間が重ならないかを確認します。さらに、削除の前後の値と復旧もテストします。
TimescaleDBのシステム開発のまとめ
開発は、要件整理、選定、設計開発、テスト、稼働、定着の6フェーズで進みます。
要件には、設備数だけでなく時刻の扱いも含めます。欠損・遅延・再送・重複の扱いも必要です。さらに、ロットや保持期間、現場担当者も入れます。
導入前の6フェーズの合格条件の整理
導入前には、目的とデータ、障害ケースを計画にまとめます。加えて、PoCの内容と運用分担を入れます。復旧目標や担当者も、計画に含めます。
条件がそろえば、機能数や単価だけでなく、実際に運用できるかで提案を比べられます。
1ラインの実データによる次の判断
まずは、1ラインの実データを使った小さなPoCに進みます。実用性と総額を判断するため、次の順で確認します。
- 書き込みや代表クエリ、集計更新、通信断からの復旧を測定します。
- 現場がアラートへ対応できるかを確かめます。
- 合格した構成を複数設備や工場へ展開します。
PoCは150万〜400万円程度、MVPは500万〜1,500万円程度、本番中規模は1,500万〜5,000万円程度の推定レンジです。これらはTimescaleDB固有の定価ではありません。
クラウド利用料と開発費、移行費、保守費を分けて考えます。
HAやセキュリティの費用も、別に見ておきます。
同じPoCの合格基準で、複数社を比べてください。
段階的に進めることで、初期費用と運用リスクを管理しながら業務に定着させられます。
▼全体ガイドの記事
・TimescaleDBのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。