
トピックモデルは、大量の文書における単語の共起から、文書群に潜む話題(トピック)を自動で推定する教師なし学習の手法です。
問い合わせや議事録など、正解ラベルを付けにくいテキストの全体像をつかむのに役立ちます。ただし、トピック名は自動では正しく付かず、前処理やトピック数で結果が変わります。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
トピックモデルによる文書の話題の表し方
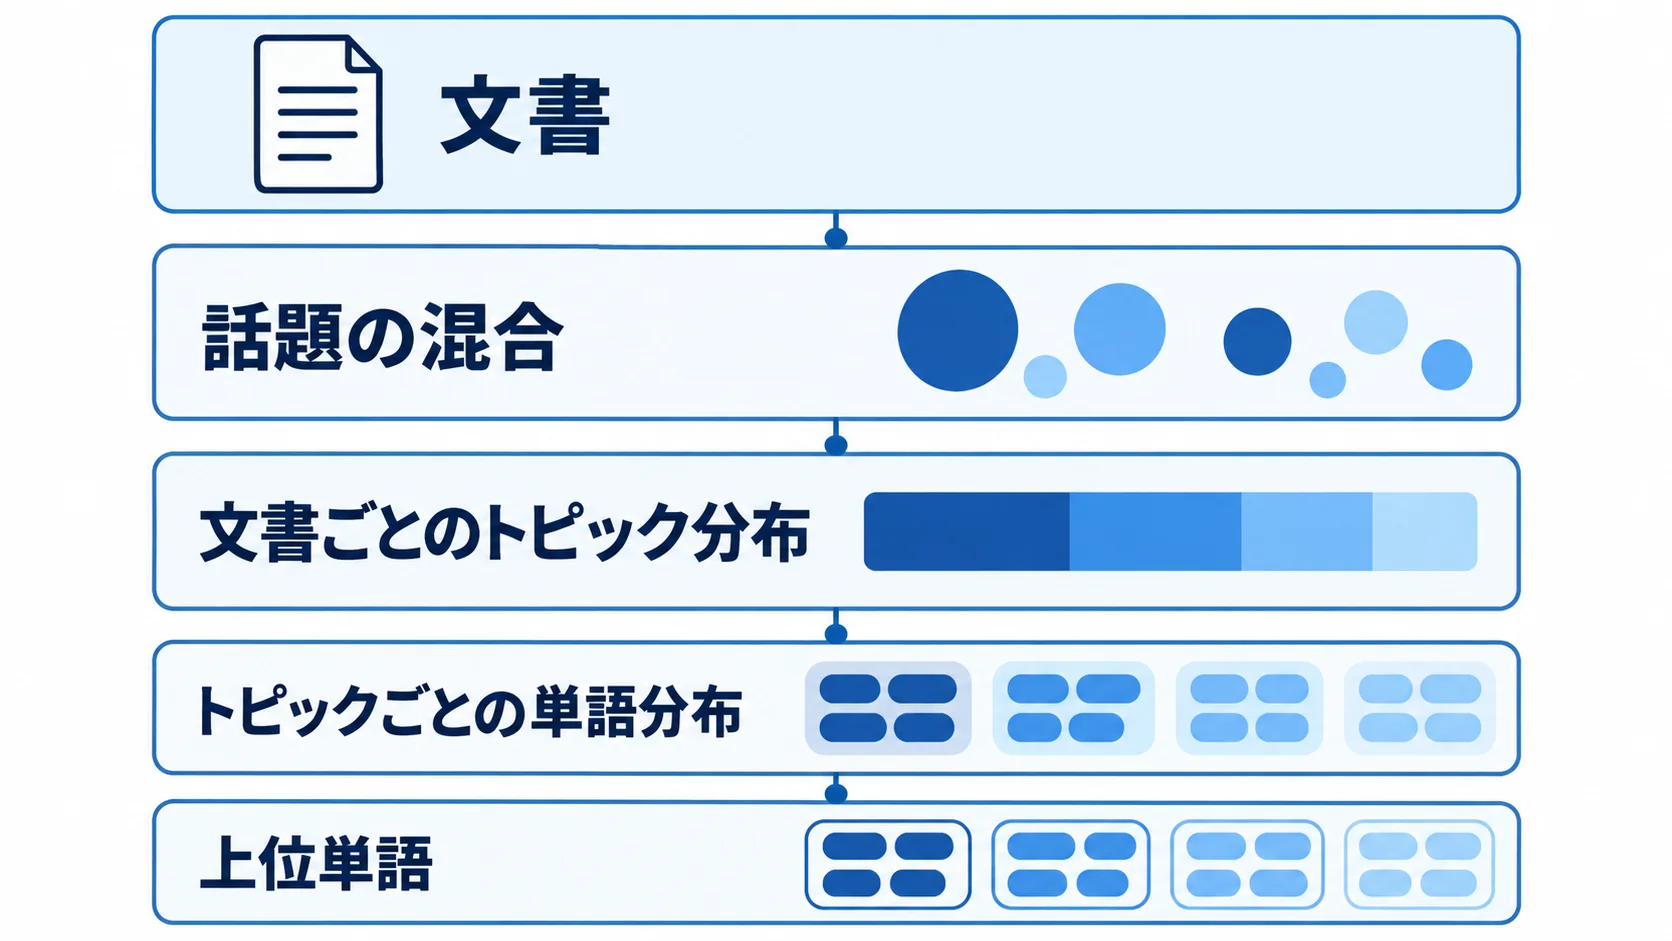
トピックモデルは、直接は観測できない話題を、文書に現れる単語の組み合わせから推定します。たとえば、「障害」「復旧」「監視」が同じ文書群に現れ、「契約」「見積」「発注」が別の文書群に現れる場合は、それぞれ運用や購買に関するトピックとして解釈できます。
1つの文書は、複数の話題を割合で持てるのが特徴です。
LDAが推定する文書と単語の確率分布
LDA(Latent Dirichlet Allocation)は、文書ごとのトピック分布と、トピックごとの単語分布を推定する生成確率モデルです。
scikit-learnのLatentDirichletAllocationは、文書単語行列を入力にします。この行列は、文書を行、語彙を列として並べたもので、トピック単語行列と文書トピック行列へ分解されます。次に、学習結果の上位単語を見て、トピックの意味を人が確認します。
分析目的と解釈可能性で決めるトピック数
トピック数が少なすぎると異なる話題が混ざり、多すぎると似た話題が細かく分割されます。
そこで、トピック数の候補を複数試し、コヒーレンスとトピック間の重複を比べます。そのうえで、文書分類の使いやすさと、担当者が名前を付けられる粒度も合わせて、トピック数を選びます。単一の数値だけで最適解を決めないようにします。
トピックモデルの結果を左右する文書単語行列の品質
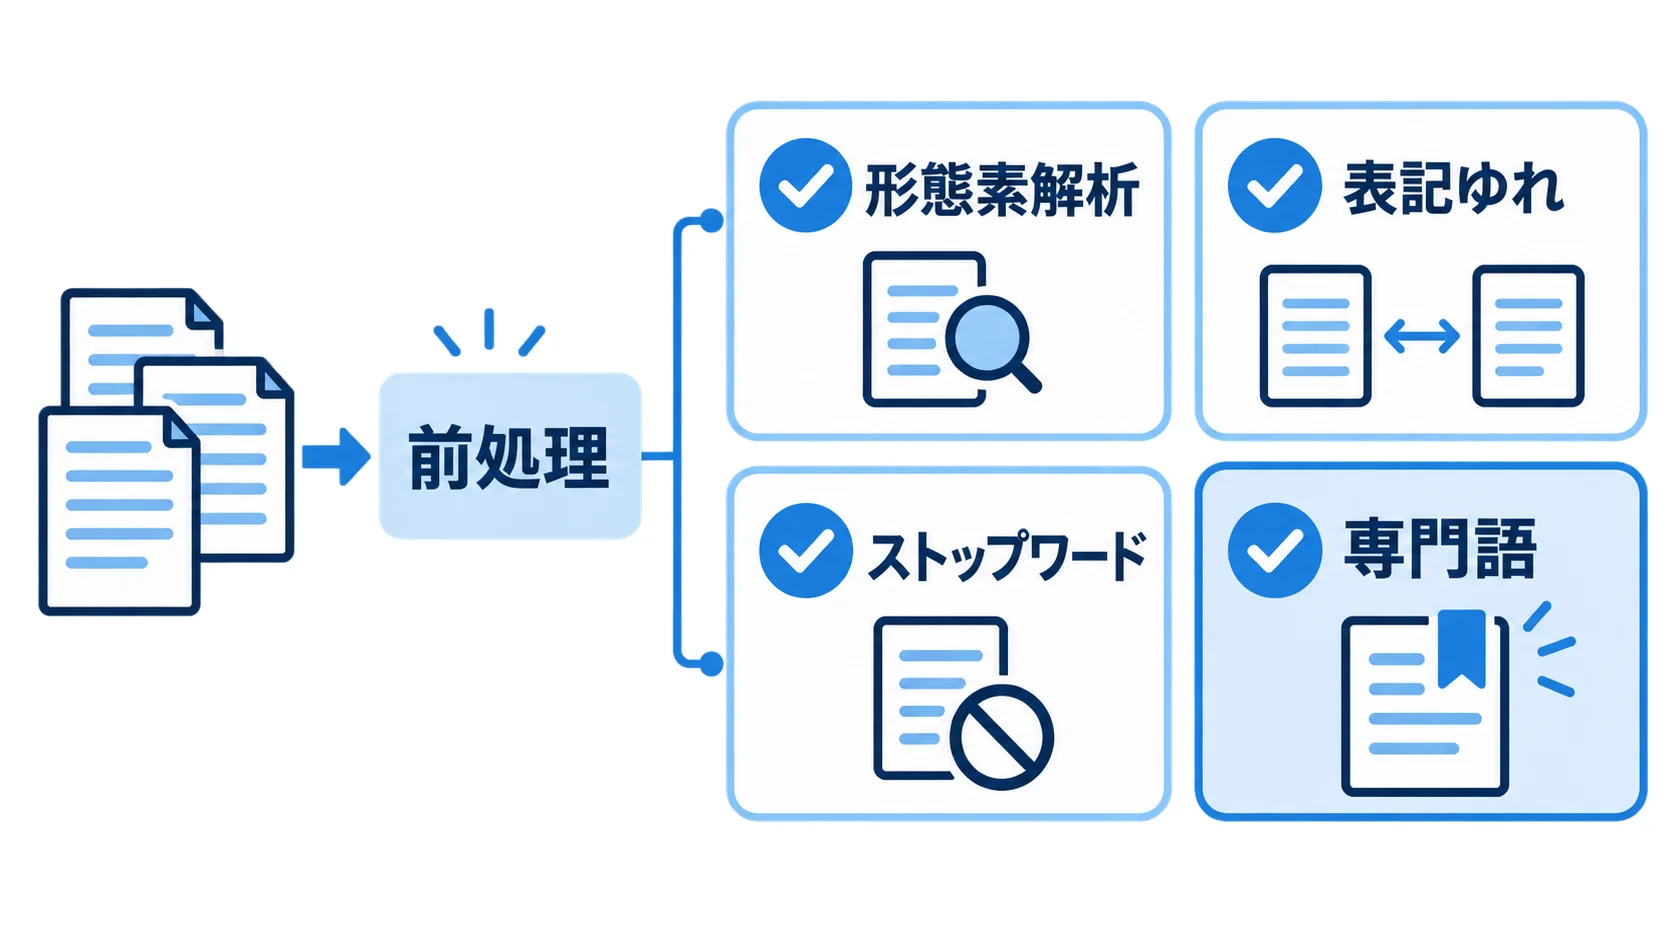
日本語の文書では、形態素解析で単語に分割したうえで、不要な記号や固有のノイズを扱います。さらに、一般的すぎる語やストップワードも扱います。表記ゆれや略語は統合する一方で、業務上重要な専門語は削除しないようにします。
単語の分割や除外のルールは結果の解釈に直結するため、分析条件として保存しておきます。
カウント行列とTF-IDFの使い分け
LDAは単語の出現回数を前提に説明されることが多く、CountVectorizerなどで文書単語行列を作ります。
一方、TF-IDFは文書内では重要だが全体では珍しい語を強調する表現で、検索や類似度、LSAなどに適しています。手法の前提と実装が期待する入力形式を確認し、カウント値とTF-IDFを混同しないようにします。
語彙数と文書数に応じた疎性の抑え方
文書数に対して語彙が大きすぎると、ほとんどの文書に現れない語が増えて、学習と解釈が不安定になります。そこで、極端に少ない語や、ほぼすべての文書に現れる語を除外します。あわせて、最小文書頻度と最大文書頻度を検討します。
除外の前後で重要な専門語が残っているかは、代表文書を目視して確かめます。
トピックモデル分析の進め方
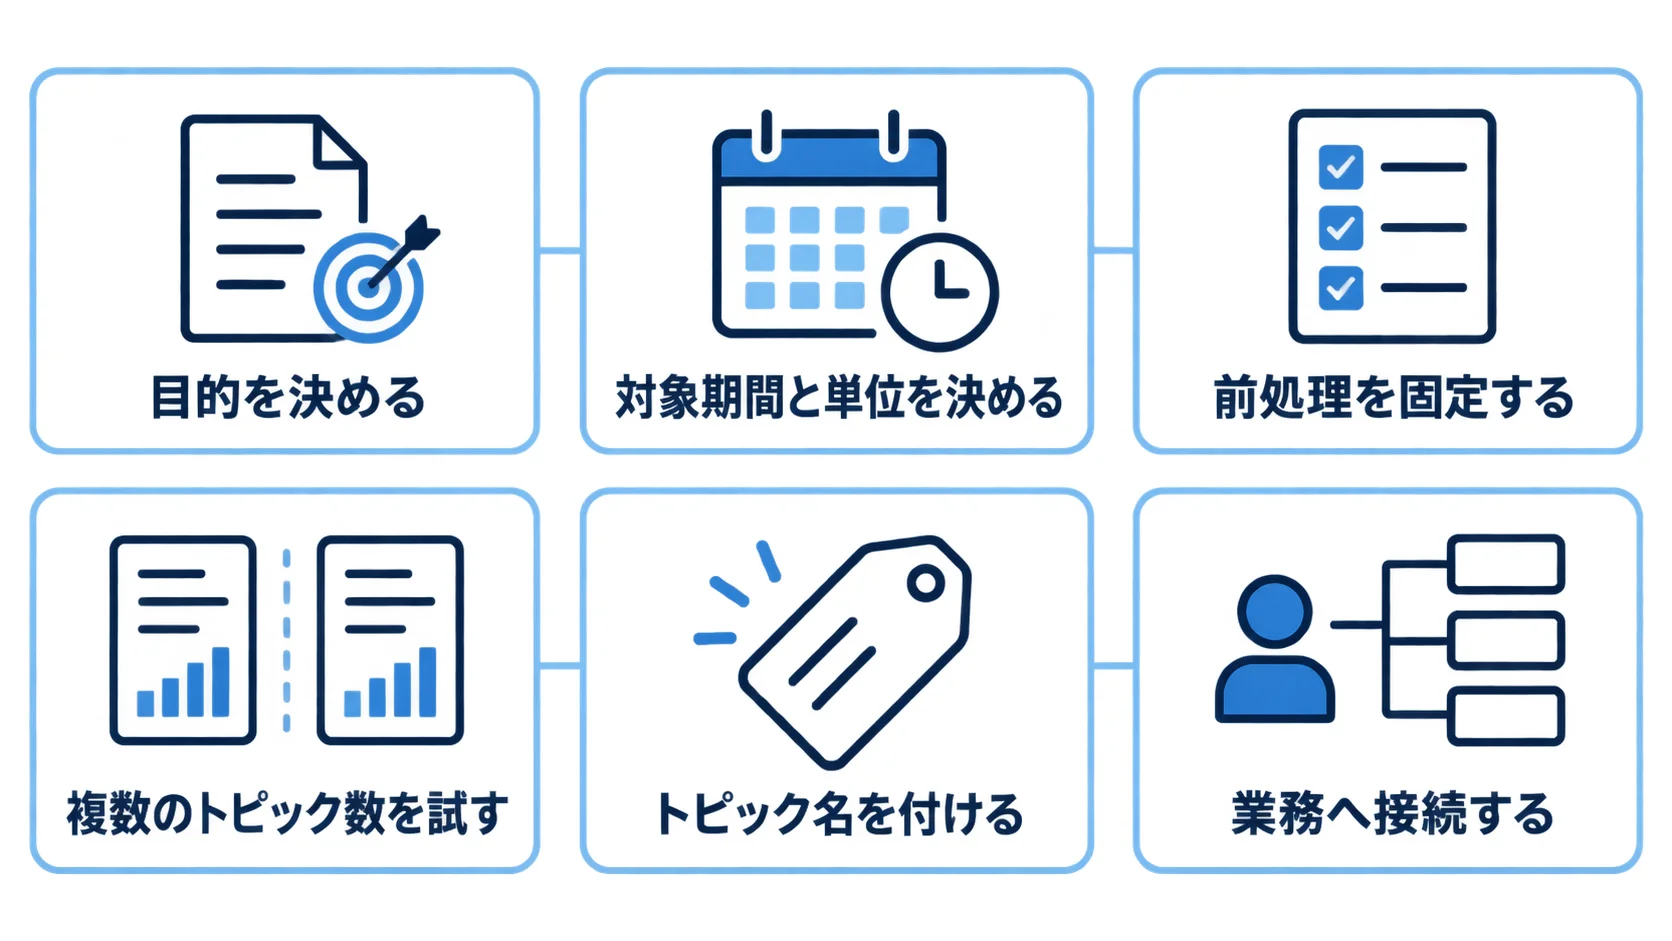
トピックモデルの結果は前処理やトピック数で変わるため、分析は段階ごとに条件を決めて進めます。
- 目的の設定:問い合わせの分類、文書の洗い出し、傾向把握のほか、検索改善などの用途から決めます。
- 対象期間と単位:1文書の定義や重複を確かめ、言語、個人情報、集計期間も見ておきます。
- 前処理の固定:形態素解析や正規化の方法、除外語、語彙上限を記録する。
- トピック数の比較:上位単語と代表文書を並べ、人が解釈しやすい候補を残します。
- トピック名の付与:上位単語に加えて、代表文書や業務担当者の知見から名称を付けます。
分析結果は、使い道が決まって初めて役立ちます。
- 業務への接続:文書検索や担当振り分けに加えて、FAQ整備、課題の優先順位にも利用します。
トピックモデルの出力は、文書に含まれる話題の確率や割合です。そのため、自動分類の正解ラベルとしてではなく、担当者がレビューする候補や、文書群の変化を観測する特徴量として使います。
担当者は、トピックが変化した時期に、新サービス、障害、制度変更がなかったかを業務データと突き合わせます。
数値指標と人による解釈を組み合わせた評価
パープレキシティや対数尤度などの数値は参考にできます。ただし、数値が良いほど人にとって意味のある話題になるとは限りません。
担当者は、上位単語が一般語ばかりになっていないか、同じトピックの単語がまとまっているか、異なるトピック同士が重複していないかを確認します。
人手評価では、トピックの上位単語と代表文書を見せ、同じ名称を付けられるか、文書の検索や分類に役立つかを確かめます。担当者の間で意見が割れる場合は、目的と粒度を見直します。
最終的に採用したモデルと乱数シード、前処理、トピック数を記録し、再実行したときに比べられるようにします。
目的に応じて検討するLDA以外の方法
NMFは非負行列を分解し、単語と文書の組み合わせを部品として解釈しやすい場合があります。一方、LSAはTF-IDFなどの文書行列を低ランクの意味空間へ写像します。
近年は、文書埋め込みとクラスタリングを組み合わせる方法もあります。ただし、埋め込みモデル、クラスタ数、距離の選択が解釈に影響します。
どの手法を選ぶかは、確率的なトピック混合が必要か、検索や類似度が目的かで変わります。また、短文が多いか、更新頻度が高いかによっても変わります。
まずは小さなサンプルで複数の手法を比べ、担当者が使える出力と運用コストを基準に採用します。
トピックモデルで起きやすい失敗と対策
上位単語だけでトピック名を断定する失敗
上位単語は統計上の特徴で、文脈を含みません。そのため、代表文書、共起語、時期を確かめ、担当部署も踏まえたうえで、人が名称と説明を付けます。曖昧な名前を残すときは、分析上の仮ラベルであることを明記します。
トピック数を増やせば細かく分析できるという思い込み
トピック数を増やしすぎると、似たトピックが分裂して、運用担当者が使い分けられなくなります。そこで、少数の候補を比べ、目的に必要な粒度になっているか、トピック間の重複が減っているかを確認します。
個人情報や機密情報をそのまま分析する失敗
問い合わせや議事録には、氏名、連絡先、契約情報が含まれることがあり、ソースコードなどが入る場合もあります。そのため、目的に不要な情報はマスキングしたうえで、アクセス権限、保存期間、モデルや外部サービスへ送信する範囲を決めておきます。
担当者は、トピックの上位語から機密語が表に出ていないかも確認します。
トピックモデル導入のチェックリスト
分析の目的から結果の評価まで、導入前に確かめておく点を5つ挙げます。
- 分析目的や文書単位を定義し、対象期間と利用者も定めたか。
- 形態素解析と表記ゆれの扱い、ストップワード、語彙上限を記録したか。
- カウント行列やTF-IDFなど、手法に合う入力を選んだか。
- トピック数の候補を比較し、上位単語と代表文書を確認したか。
- 数値指標だけでなく、担当者による解釈と業務利用性を評価したか。
あわせて、個人情報の扱いと記録に関する項目も確かめます。
- 個人情報・機密情報のマスキングとアクセス権限を決めたか。
- 乱数シードとライブラリのバージョン、採用理由、再分析条件を記録したか。
定期的に分析する場合は、過去モデルのトピック名を新しい結果にそのまま対応づけられるとは限りません。そこで、上位語や代表文書を比べて対応関係を確認し、トピックの新設、統合、消滅を記録します。
月次の件数だけでなく、急増した文書の内容までレビューする運用を設計すると、変化の早期発見に役立ちます。
生成されたトピック名や要約をそのまま社外へ出す場合は、誤分類や機密語の混入を確認します。また、人がレビューしてからレポートや検索画面に反映する段階を設けると、安全に活用しやすくなります。
文書群の話題を探索する方法としてのトピックモデル
トピックモデルは、文書を複数の話題の混合として表します。そのうえで、トピックごとの特徴語と、文書ごとの話題の割合を推定します。
LDAは代表的な確率モデルで、問い合わせや社内文書の洗い出し、傾向把握、検索改善の仮説づくりに利用できます。
出力されたトピックは、正解として自動採用しません。結果は前処理やトピック数で変わり、手法や乱数によっても変わります。そのため、代表文書を人が確かめ、業務で使える名前を付けて施策へつなげます。
評価条件とデータの扱いを記録しておけば、文書が増えたときも再現性を保って分析できます。
よくある質問(FAQ)
トピックモデルを使うときによく出る疑問に、順に答えます。
Q. トピックモデルとは何ですか?
大量の文書に含まれる単語の共起パターンから、文書群に潜む話題と、各文書が持つ話題の割合を推定する教師なし学習の手法です。
Q. LDAはトピックモデルと同じものですか?
LDAはトピックモデルの代表的な手法の一つです。文書ごとのトピック分布と、トピックごとの単語分布を確率モデルとして推定します。
Q. トピック数はいくつに設定すればよいですか?
目的と解釈可能性で決めます。複数候補を試し、トピック間の重複、代表文書のまとまり、担当者が使える粒度、数値指標を合わせて選びます。
Q. LDAにTF-IDFを入力してもよいですか?
LDAは単語の出現回数を前提に説明されるため、まず文書単語のカウント行列を検討します。TF-IDFはLSAや類似度など別の目的で使われる表現なので、手法の前提と実装を確認して選びます。
Q. トピックモデルの結果はどう評価しますか?
パープレキシティなどの数値に加え、上位単語と代表文書のまとまり、トピック間の重複、担当者が付ける名称の一致、検索や分類など業務での有用性を確認します。
参考資料
LDAの説明や入力の作り方は、scikit-learnの公式ドキュメントで確認できます。
- scikit-learn User Guide「Latent Dirichlet Allocation」
- scikit-learn「LatentDirichletAllocation」
- scikit-learn User Guide「Feature extraction」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。