
DevOps事例は、開発の自動化から運用文化の変革まで、4つの取り組みに分けて見られます。
発注企業の立場から、同規模・同業態の企業の取り組みを比べると、投資判断と推進方針の精度を高められます。全体像をまだ知らない場合は、先にDevOps強いの完全ガイドをご覧ください。
▼全体ガイドの記事
・DevOps強いの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
CI/CDパイプライン構築で手動デプロイを脱却した事例
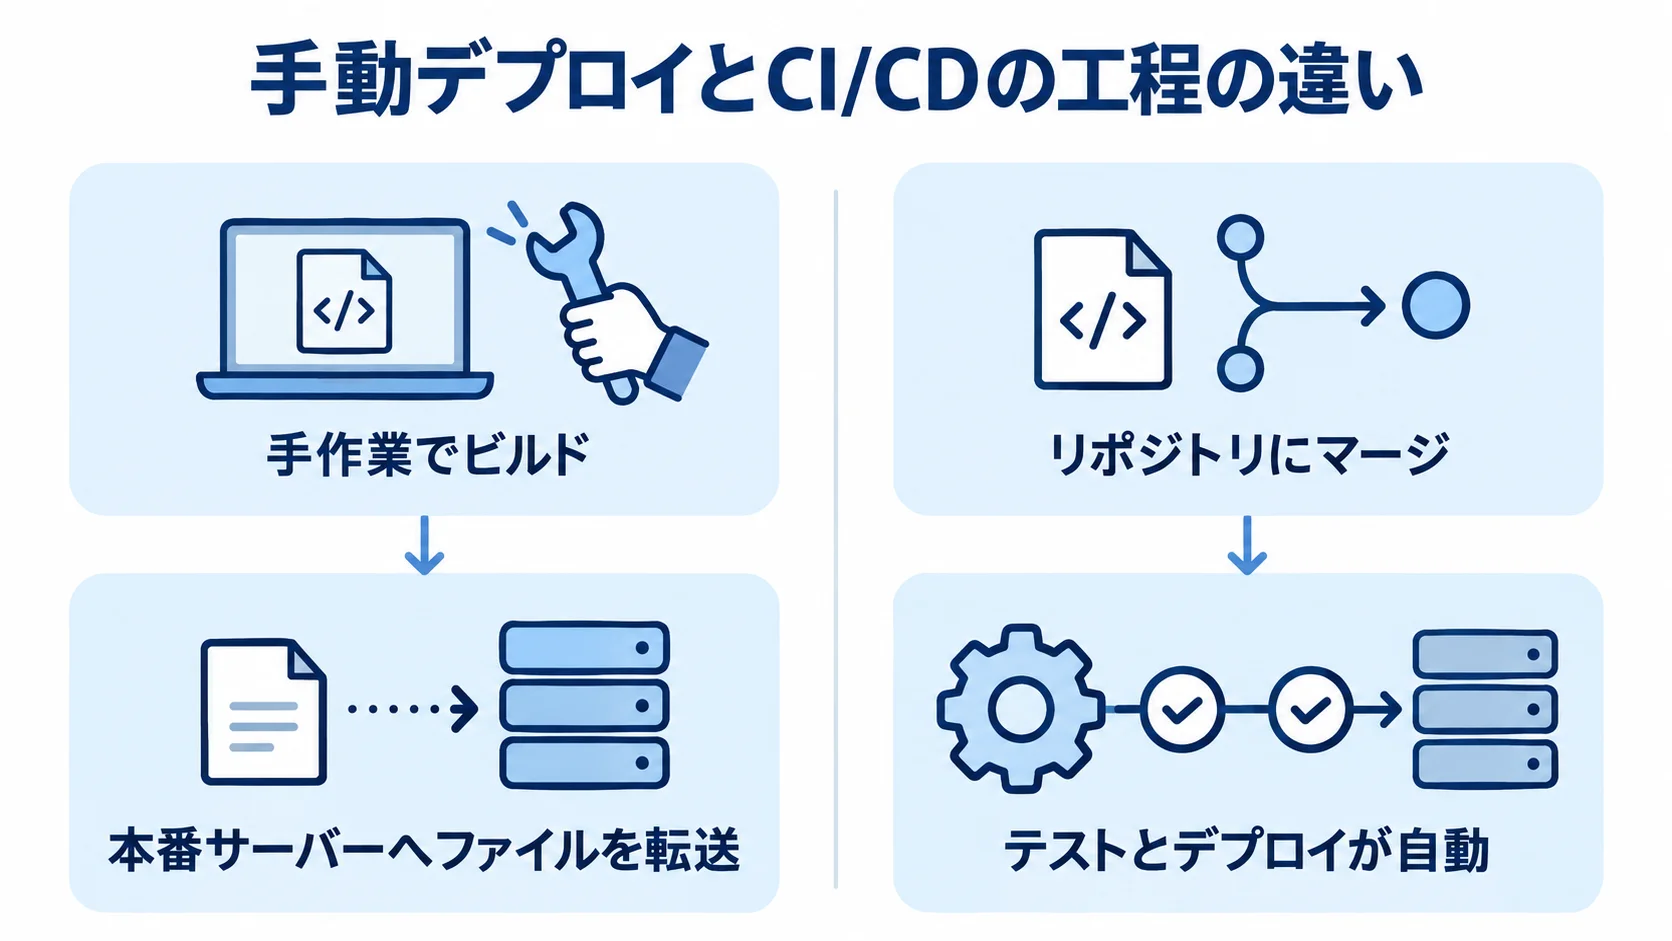
CI/CD(継続的インテグレーション/継続的デリバリー)の構築は、DevOpsのなかで効果が見えやすい取り組みです。手動デプロイからの脱却にもつながります。
多くの現場では、担当者がコードを手作業でビルドし、テスト後に本番サーバーへファイルを転送しています。この手作業の工程は、デプロイを遅らせるだけでなく、人為的ミスも招きます。
CI/CDでは、コードをリポジトリにマージすると、テストとデプロイが自動で進みます。
GitHub Actionsで週次リリースを日次に変えた事例
CI/CDの効果が見えやすいのは、リリース頻度です。この事例では、GitHub Actionsを使い、マージ後に自動テストとステージング環境へのデプロイを行いました。
- リリース頻度:週1回の夜間作業から日次へ変更
- 反映条件:コードレビューを通過した変更を当日中に本番へ反映
週次から日次になったことで、機能改善や不具合修正を届けるまでの時間が短くなりました。この変化は、作業の自動化だけにとどまりません。
安全に短時間でデプロイできるようになると、「小さく作り、すぐ出し、反応を見て直す」反復を回せます。一方で、一度に大きく出す方式は、障害時の原因を特定しにくく、影響も大きくなりがちです。
小さく頻繁に出すと、問題の原因を特定しやすく、切り戻しも簡単に行えます。さらに、安全に速く出せる状態は、チームの開発文化も変えます。
自動テスト組み込みで本番障害を減らした事例
CI/CDは、リリース速度以外の面でも効果があります。CIの段階でテストを行うと、品質確認を前倒しでき、本番障害を減らせます。
たとえば、ある事例では、以前すり抜けていた不具合の多くを、マージ前に検出できるようになりました。
- ユニット・結合テスト:CIで必ず実行し、問題を早期に検出
- 静的解析:コードの問題を自動で検出するチェックを追加
- シフトレフト:本番での発覚を待たず、変更の早い段階で不具合を止める
自動テストがあれば、開発者は既存機能への影響を確かめながら、リファクタリング(内部構造の改善)を進められます。一方で、手動テストだけに頼ると、影響を恐れて改善をためらいがちです。
一次データでは、CI/CDやセキュリティスキャンを含むDevOps系SaaSは月数万円程度です。本番障害一件の対応費や信頼失墜と比べると、自動テストはDevOps導入の最初の一歩として費用対効果の高い取り組みです。
IaCで環境構築を自動化し再現性を確保した事例
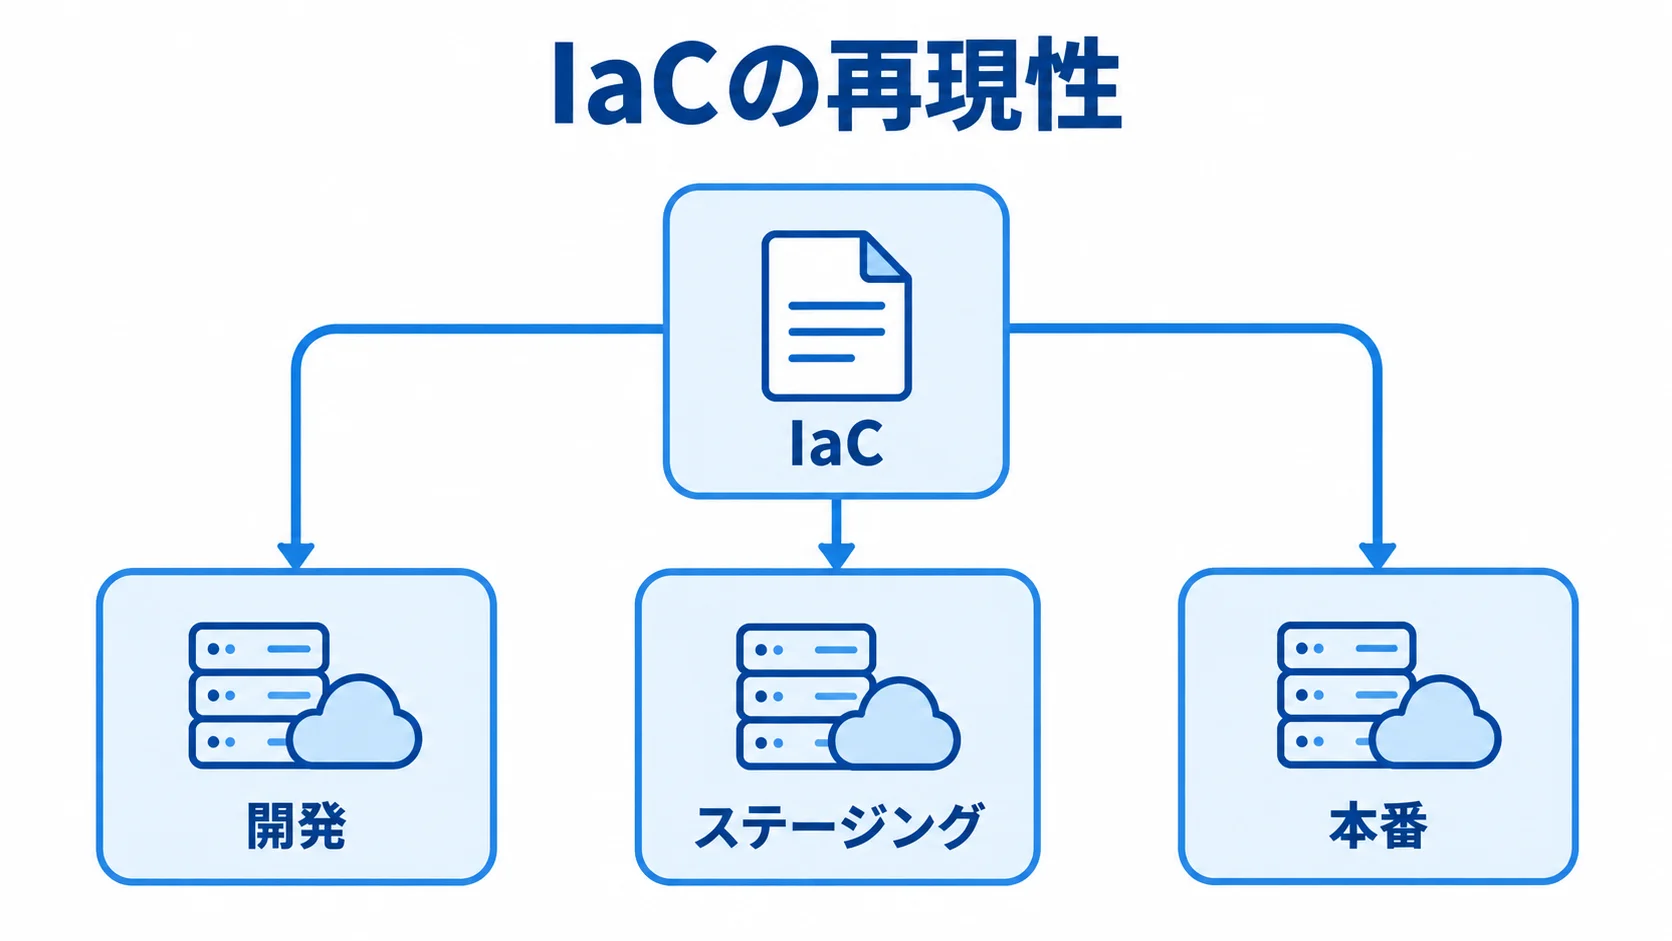
DevOpsの成熟度を高めるのが、Infrastructure as Code(IaC)です。具体的には、サーバー、ネットワーク、データベースなどの構成をコードに記し、環境を自動で構築します。
開発・ステージング・本番を同じコードから生成できるため、環境の違いによる「開発環境では動いたのに本番では動かない」という問題を根本から減らせます。IaCの価値は、この再現性にあります。
環境構築を数日から数十分に短縮した事例
以前は、検証環境の準備にサーバー設定、ミドルウェア導入、ネットワーク構成を手作業で行っていたため、毎回数日かかっていました。さらに、担当者ごとの設定差も問題でした。
- 構築時間:IaCの実行で数日から数十分に短縮
- 環境の再現:本番と同じ構成を検証のたびに用意
- 変更履歴:構成をコードでバージョン管理し、担当者と内容を記録
- 知識共有:ベテランの頭の中にあった設定をコードに残し、属人化を解消
同じ環境をすぐ用意できるため、開発の速度と信頼性が高まりました。一次データでは、クラウド開発費用の約8割が人件費とされています。このため、自動化による工数の削減は、コストにも影響します。
コンテナ化でポータビリティを高めた事例
コンテナは、アプリケーションと実行環境を一つにまとめ、異なる環境でも同じように動かす仕組みです。ある事例では、ECS Fargateのようなマネージド基盤を採用しました。
- 運用の軽減:サーバー管理を意識せず、必要なコンテナ数に調整
- 移行への備え:標準形式でクラウド間の可搬性を確保
- 基盤の選択:ポータビリティとマネージドサービスの利点を両立
必要な分だけコンテナを増減できるため、運用負荷とインフラ費を利用状況に合わせられます。また、コンテナは、クラウド移行時の費用を抑え、ベンダーロックインのリスクを和らげる方法としても挙げられています。
独自サービスを使いすぎると、特定の事業者への依存につながります。IaCとコンテナは、DevOps基盤の再現性と可搬性を支える要素です。
サーバーレス化でアイドルコストをゼロにした事例
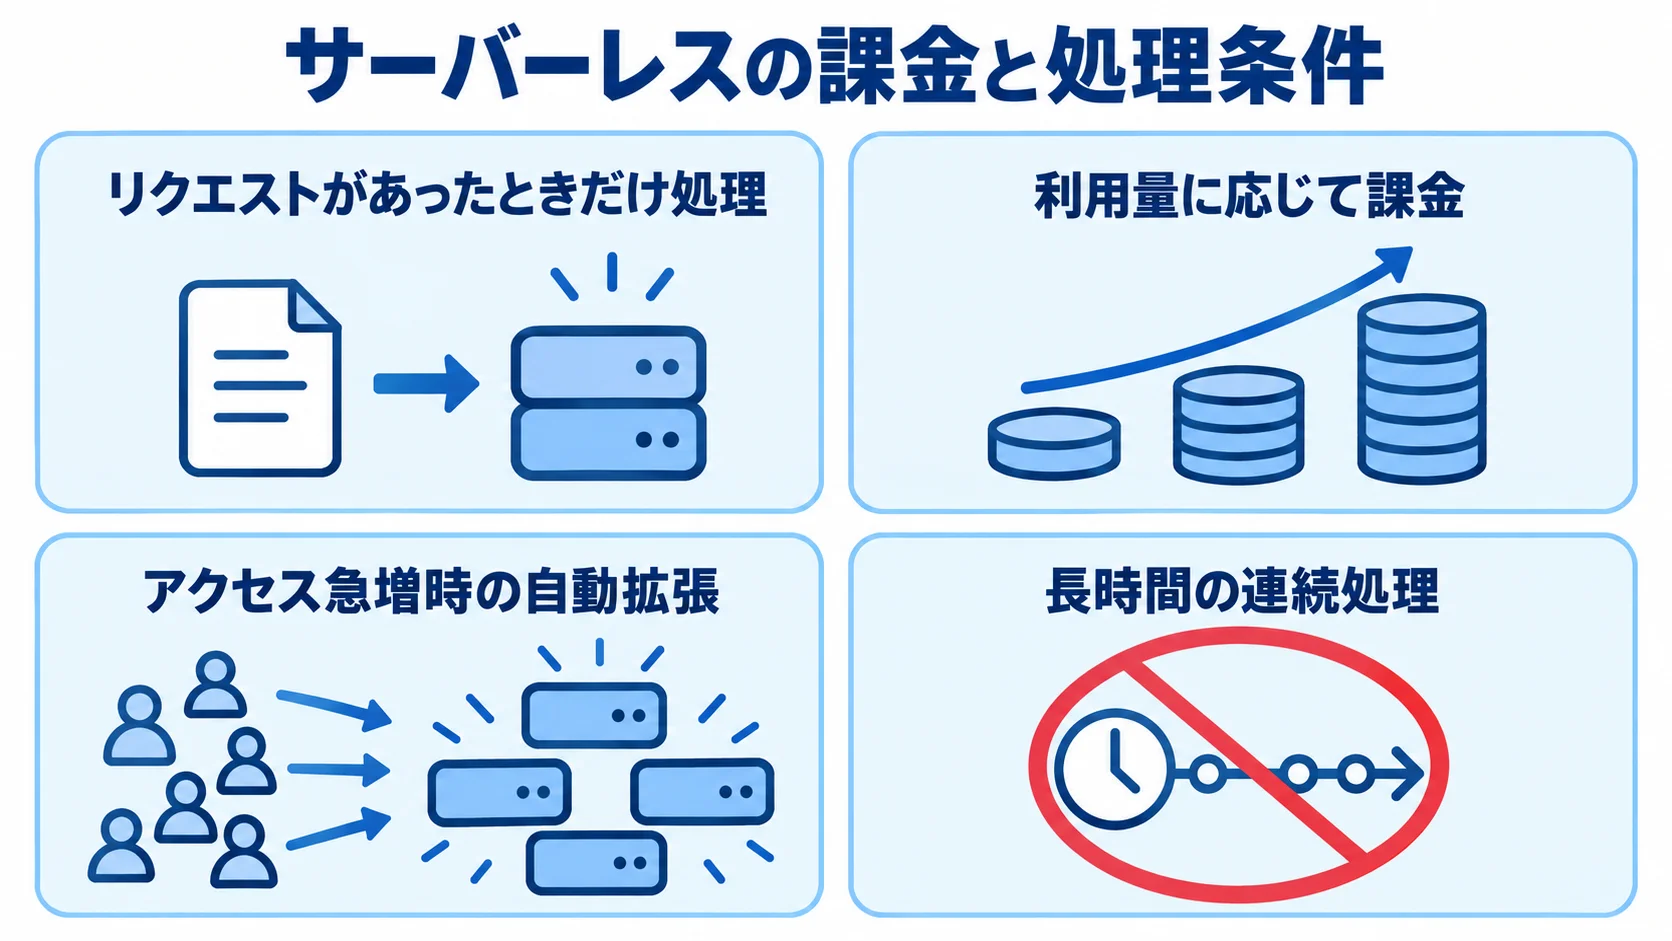
DevOpsは開発速度だけでなく、インフラコストの見直しにもつながります。その代表例が、サーバーレスアーキテクチャです。
サーバーレスは、リクエストがあったときだけ処理を行い、利用量に応じて課金されます。その結果、常時起動が不要になり、アクセスのない時間のアイドルコストもゼロに近づけます。
Lambda+API Gateway構成で月数百円に抑えた事例
ある事例では、アクセスが少〜中規模の業務系APIに、Lambda(サーバーレスの関数実行基盤)、API Gateway、DynamoDBを組み合わせました。
- 利用料の目安:少〜中程度のアクセスなら月数百円から
- 無料枠:利用状況によっては、無料利用の範囲内に収まるケースもある
- API呼び出し:多くのクラウドで月100万回まで無料
- コンピューティング:100万GB秒あたり十数ドル程度
常時稼働のサーバーと比べると、インフラ費を大幅に圧縮できました。ただし、金額は少〜中程度のアクセスなど、利用条件によって変わります。
サーバーレス化には、コスト以外の利点もあります。たとえば、台数管理やOSのパッチ適用が不要になり、運用チームの負荷も軽くなります。
アクセスが急増した際は基盤側が自動で拡張するため、繁忙期の前に増強する作業も不要です。この事例では、従量課金と運用負荷の軽減を両立しました。
一方で、長時間の連続処理などは向かない領域もあります。そのため、用途を見極めて採用する必要があります。
オンプレ移行でインフラ費を3分の1に圧縮した事例
サーバーレスと並ぶコスト策は、オンプレミスからクラウドへ移り、マネージドサービスを活用することです。ある企業は移行後、インフラ費を従来の3分の1程度まで減らしました。
移行の決め手は、専任要員やハードウェア費を削減できた点でした。
- 設計・構築:従業員50〜100名規模で100万〜400万円
- データ移行:20万〜80万円
- 初期費用合計:トータルで150万〜500万円前後
- 移行後の月額費:中規模で3万〜10万円程度
マネージドサービスでは、データベースやキャッシュなどの基盤機能をクラウド事業者が運用します。このため、運用人件費も削減できます。
初期投資は小さくありませんが、運用費も含めて数年単位で比べると回収できるケースが多いとされます。移行の判断では、初期費用だけでなく総保有コストを比較します。
この事例は、DevOpsが現場の改善にとどまらず、経営レベルのコスト構造にも波及することを示しています。
SRE化と内製化で運用文化を変革した事例
DevOpsの先にある運用文化の変革、その到達点の一つが、SRE(Site Reliability Engineering)への移行です。SREでは、信頼性をエンジニアリングの対象として扱います。
許容範囲の中で素早く変化できるよう、SLO(サービスレベル目標)を定めます。そのうえで、繰り返し作業のトイルを自動化し、障害対応を仕組みにします。
従来のITIL型運用は、「絶対に止めない」ことを重視します。一方、SRE型は、信頼性を数値で管理しながら、変化に対応する運用へ切り替えます。
SLO設定と監視自動化で障害対応を変えた事例
ある事例では、障害が起きてから人が気づく運用から、SLOの達成状況を常時監視する体制へ切り替えました。その結果、兆候を早く検知し、利用者に影響が出る前に対応できるようになりました。
- 信頼性の基準:SLOで目標を明確にし、達成状況を監視
- 監視ツール:Datadogのようなサービスを、ホストあたり月15〜23ドル程度で利用
- 障害対応:アラート後の対応や復旧手順を自動化
「何を信頼性の基準とし、どこまで許容するか」を数値で合意すると、運用判断のぶれを抑えられます。
また、自動対応と手順のコード化により、夜間や休日の緊急対応が軽くなりました。SREの中核は、トイルを撲滅し、信頼性の向上に時間を使うことです。
外部伴走からCCoE立ち上げで内製化した事例
DevOpsを一過性で終わらせないため、ある企業は内製化へ段階的に移行しました。外部の伴走を受けてCI/CD構築やIaC整備を進め、自社の社員へ技能を移すことも行いました。
- 外部伴走:本業に集中しつつ、自社へ技能移転してノウハウを蓄積
- CCoE:Cloud Center of Excellenceとして、クラウド活用を全社で推進する専門チーム
- 内製化:外部伴走後も、自社で運用を続けられる体制を整える
委託は本業に集中できる一方、ノウハウが社内に蓄積されにくい面があります。伴走型は、この両立しにくい点を乗り越える進め方です。
CCoEは、各部門のクラウドやDevOpsの知見を集め、標準化やガバナンス、人材育成を担います。また、採用・育成・評価の制度を整えて、社内展開を進めます。
riplaは、受託とクラウド構築・運用の伴走を通じて、自社で回せる内製化ロードマップを設計します。成功のためには、DevOpsを組織の能力として定着させることが欠かせません。
まとめ
ここまでの事例は、開発の自動化から運用文化の変革まで、4つの取り組みに分けられます。事例を読むときは、成果だけでなく、導入条件も確かめておきましょう。
CI/CDは週次から日次へ、IaCは環境構築を数日から数十分へ短縮した例があります。また、自動テストは本番障害を減らし、サーバーレスはアイドルコストを抑えました。
オンプレミスからの移行では、インフラ費を3分の1に圧縮した事例があります。さらに、SLOやCCoEは、運用を組織の能力に変えます。ただし、成果は各社の条件によって異なります。
着目したいのは、ツールの名前だけでなく、着手した工程と現場への定着方法です。そのうえで、自社の課題に照らし、効果が見えやすいCI/CDの自動化から小さく始めるとよいでしょう。
riplaは、フルスクラッチ受託と国内開発、クラウド構築・運用の伴走を組み合わせ、DevOpsを組織に根づかせる支援を行っています。全体像は完全ガイドをご覧ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。