
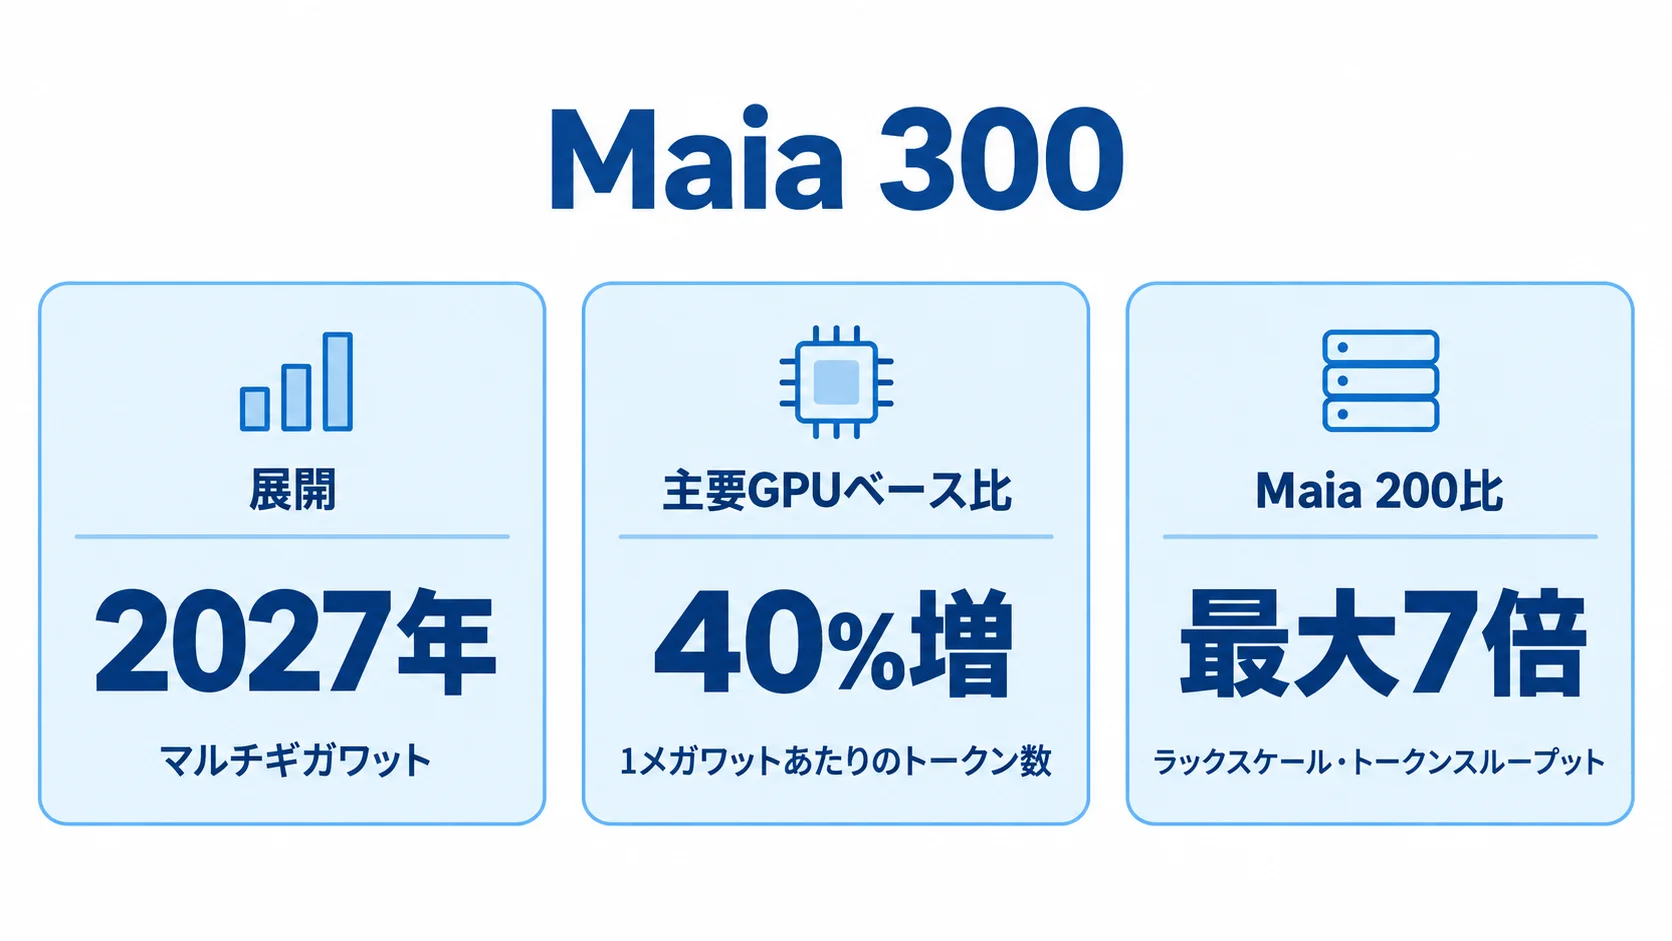
Microsoftは2026年10月12日、Azure Maiaファミリーを2027年からマルチギガワット規模で展開し、Microsoftの製品・サービスにおける主要な推論システムにすると発表しました。次世代の「Maia 300」は、主要なGPUベースシステムと比べて1メガワットあたりのトークン数40%増、Maia 200と比べて最大7倍のラックスケール・トークンスループットを見込みます。
企業のIT・事業責任者にとって、これはMicrosoftがGPU以外の選択肢を増やすというだけの話ではありません。CopilotやMicrosoft Foundryのようなサービスを、モデルの性能だけでなく、推論コスト、応答遅延、リージョン、容量、SLAの組み合わせで選ぶ段階に入ったことを示します。
ただし、発表時点でMaia 300の一般利用者向けSKU、提供リージョン、価格、SLAは示されていません。Microsoftの期待値を自社のワークロードへそのまま当てはめず、利用モデルと同時実行数をそろえた評価、契約条件、データセンターの制約を分けて確認する必要があります。
※本記事は2026年10月15日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
2027年からマルチギガワットへ|Maia 300が担う推論基盤
今回の発表の中心は、チップ単体の性能ではなく、Azure Maiaを世代継続のインフラとして大規模展開する計画です。Microsoftは2027年からマルチギガワット規模でMaiaを展開し、Microsoftの製品・サービスにおける主要な推論システムにすると説明しています。
Maia 200はすでにMicrosoft Copilotを含む本番ワークロードで稼働しています。GitHub CopilotとMicrosoft Foundryも年末までに続く予定です。Maia 200はOpenAIモデル、MicrosoftのMAIモデル、主要なオープンソースモデルファミリーを実行しており、特定のモデルだけに閉じた基盤ではありません。
Maia 300は、長いコンテキストの推論、低遅延の会話体験、継続的なマルチステップのエージェントタスクを対象にした推論ファーストの設計です。チャットの1回の応答よりも、長い文脈を読み、ツールを呼び出し、複数ステップを継続する処理を効率よく動かすことに軸があります。
AI推論向けクラウド支出が学習から移る流れを読むには、AI推論向けクラウド支出96%増予測の記事も参考になります。Maia 300は、この推論需要を支える供給側の設計です。
ポイント
Maia 300は、Microsoftが2027年から推論基盤を大規模展開する計画の一部です。Maia 200のCopilotなどでの運用実績を次世代設計へつなげ、Azureサービスの供給能力と効率を高める位置付けです。
N2P・HBM4 18TB/s・96基ラック|性能の源泉はデータ移動
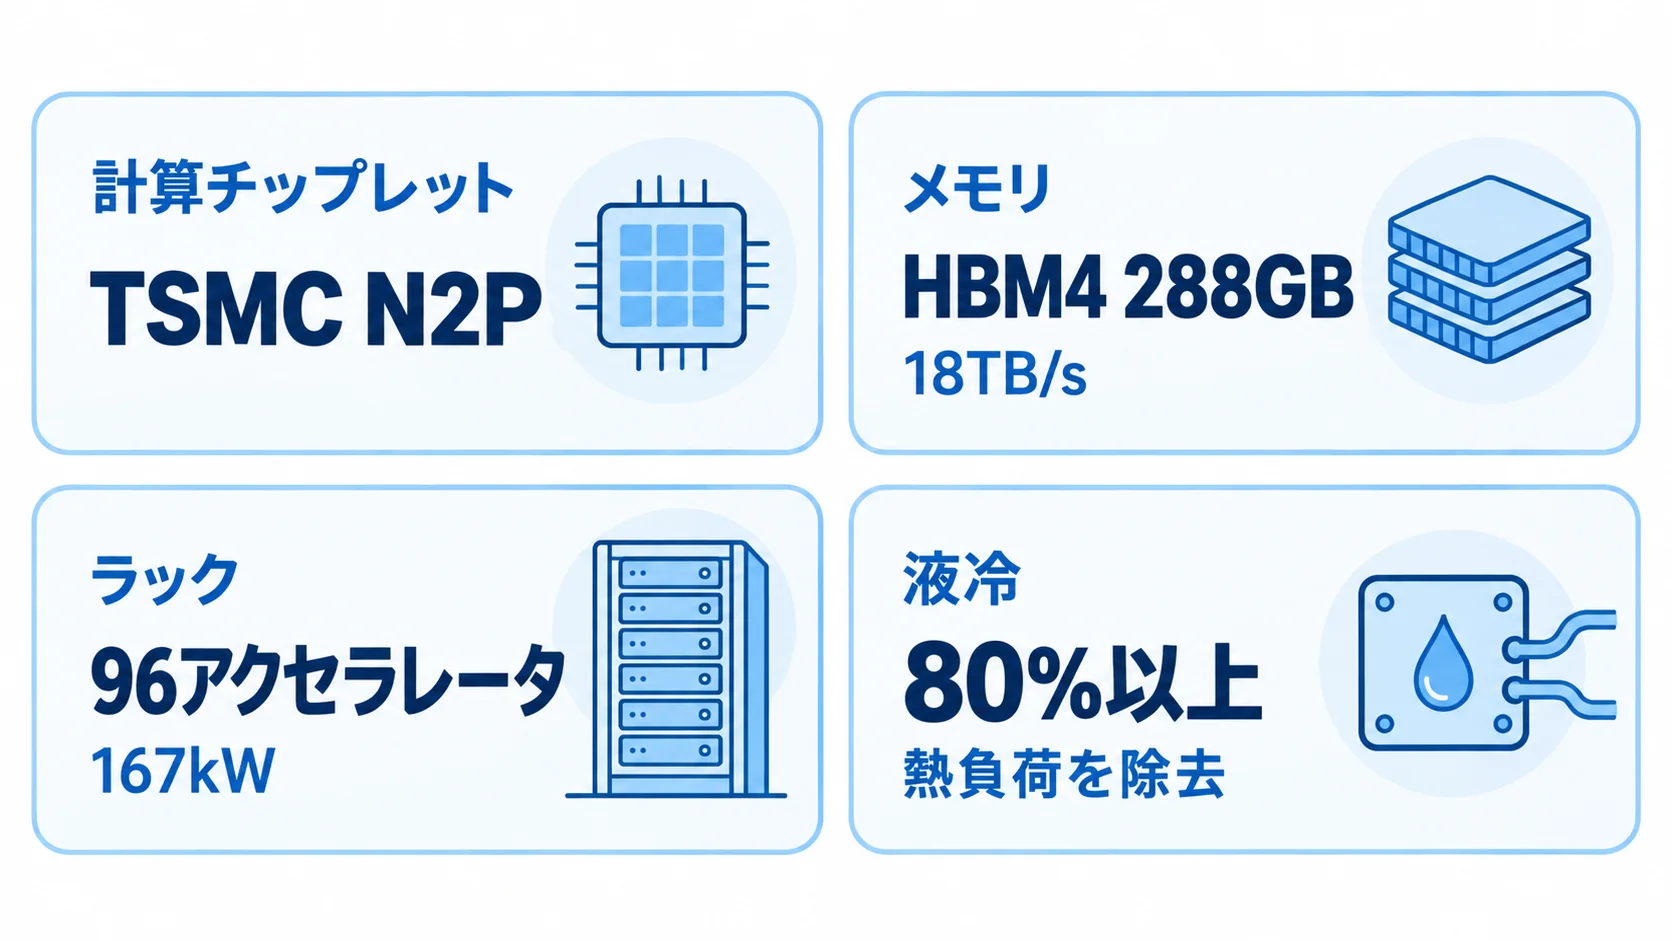
Maia 300の特徴は、計算性能だけを引き上げるのではなく、データを計算装置へ運ぶ経路を含めて設計していることです。計算チップレットにはTSMCのN2Pプロセスノードを使い、メモリコントローラーとI/Oは別のチップレットに分けます。機能ごとに適した製造技術を使い、データの局所性をソフトウェアで制御します。
メモリは、1アクセラレータあたり8個のHBM4スタックで、容量288GB、ピークメモリ帯域幅18TB/sです。Maia 200と比べてメモリ帯域幅は2.5倍、容量は33%増、HBM帯域幅あたりの電力効率は約2倍とされています。長いコンテキストやKVキャッシュを扱う推論では、演算器の数だけでなく、メモリを待たせない設計が応答性能を左右します。
ラックは96アクセラレータを24個の4アクセラレータ・トレイに収め、電力エンベロープは167kWです。液冷はアクセラレータ、電圧レギュレーター、スイッチASICの熱負荷の80%以上を除去します。AI基盤の比較で電力と冷却を後回しにできない理由が、ラックの構成に表れています。
| 項目 | Maia 300 | Maia 200との関係 |
|---|---|---|
| 製造・構成 | TSMC N2Pの計算チップレットを含むマルチチップレット | 世代更新 |
| メモリ | HBM4、288GB、18TB/s(1アクセラレータ) | 帯域幅2.5倍、容量33%増 |
| ラック | 96アクセラレータ、167kW | アクセラレータ密度2倍 |
| 推論効率 | 主要GPUベース比で1メガワットあたり40%増を見込む | ラックスケールのトークンスループット最大7倍を見込む |
表の数値はMicrosoftが公表した設計値または期待値です。モデル、コンテキスト長、バッチ、同時実行数、精度設定が変われば結果も変わります。自社で比較するときは、同じ入力と出力、同じ許容遅延、同じ電力条件で測定してください。
ポイント
Maia 300の効率改善は、N2P、HBM4、低精度形式、NUMA型メモリ、ラックと冷却を一体で設計した結果です。18TB/sや最大7倍という数字だけを取り出さず、自社の推論条件で評価します。
GPU依存は減るが、Azure依存へ置き換わるのか|クラウド選定の読み方
MicrosoftはMaia 300について、主要なGPUベースシステムに比べて1メガワットあたりのトークン数40%増を見込み、Maia 200については主要GPUインフラ比で最大1.7倍多いトークンをワットあたりで処理すると説明しています。これは、Microsoftの環境と想定ワークロードに基づく公表値です。
企業の料金は、トークン/ワットだけでは決まりません。クラウドのGPU・アクセラレータ料金、最低利用量、予約期間、リージョン、容量確約、データ転送料、運用費を合わせて比較します。AIエージェントの従量課金を考えるときも、AIエージェントのコスト暴走と対策の記事で扱うように、1回の推論より連鎖する実行回数を把握することが先です。
もう一つの問題は、発表時点でMaia 300を一般利用者が直接選べる条件が出ていないことです。提供リージョン、VMまたはサービスのSKU、対応モデル、価格、SLA、容量予約の詳細が示されていないため、「Maia 300を使う」と「Maia 300の設計を使ったMicrosoftのサービスを利用する」は区別しなければなりません。
ポイント
Maia 300の効率値と、企業が支払うクラウド料金・SLA・容量は別の論点です。GPUの置き換えを判断するのではなく、Azureのサービス契約として性能、供給、データ境界、切り戻し条件を比較します。
Copilot・Foundryの基盤に何が起きるか|直接チップを選べない企業の確認点
Maia 300の効果が最初に現れるのは、企業がアクセラレータを直接購入する場面より、Microsoftのサービス基盤です。Maia 200はCopilotで本番稼働し、GitHub CopilotとMicrosoft Foundryも年末までに続く予定です。Maia 200が複数のモデルファミリーを実行していることから、専用チップを単一モデルだけに固定しない設計が分かります。
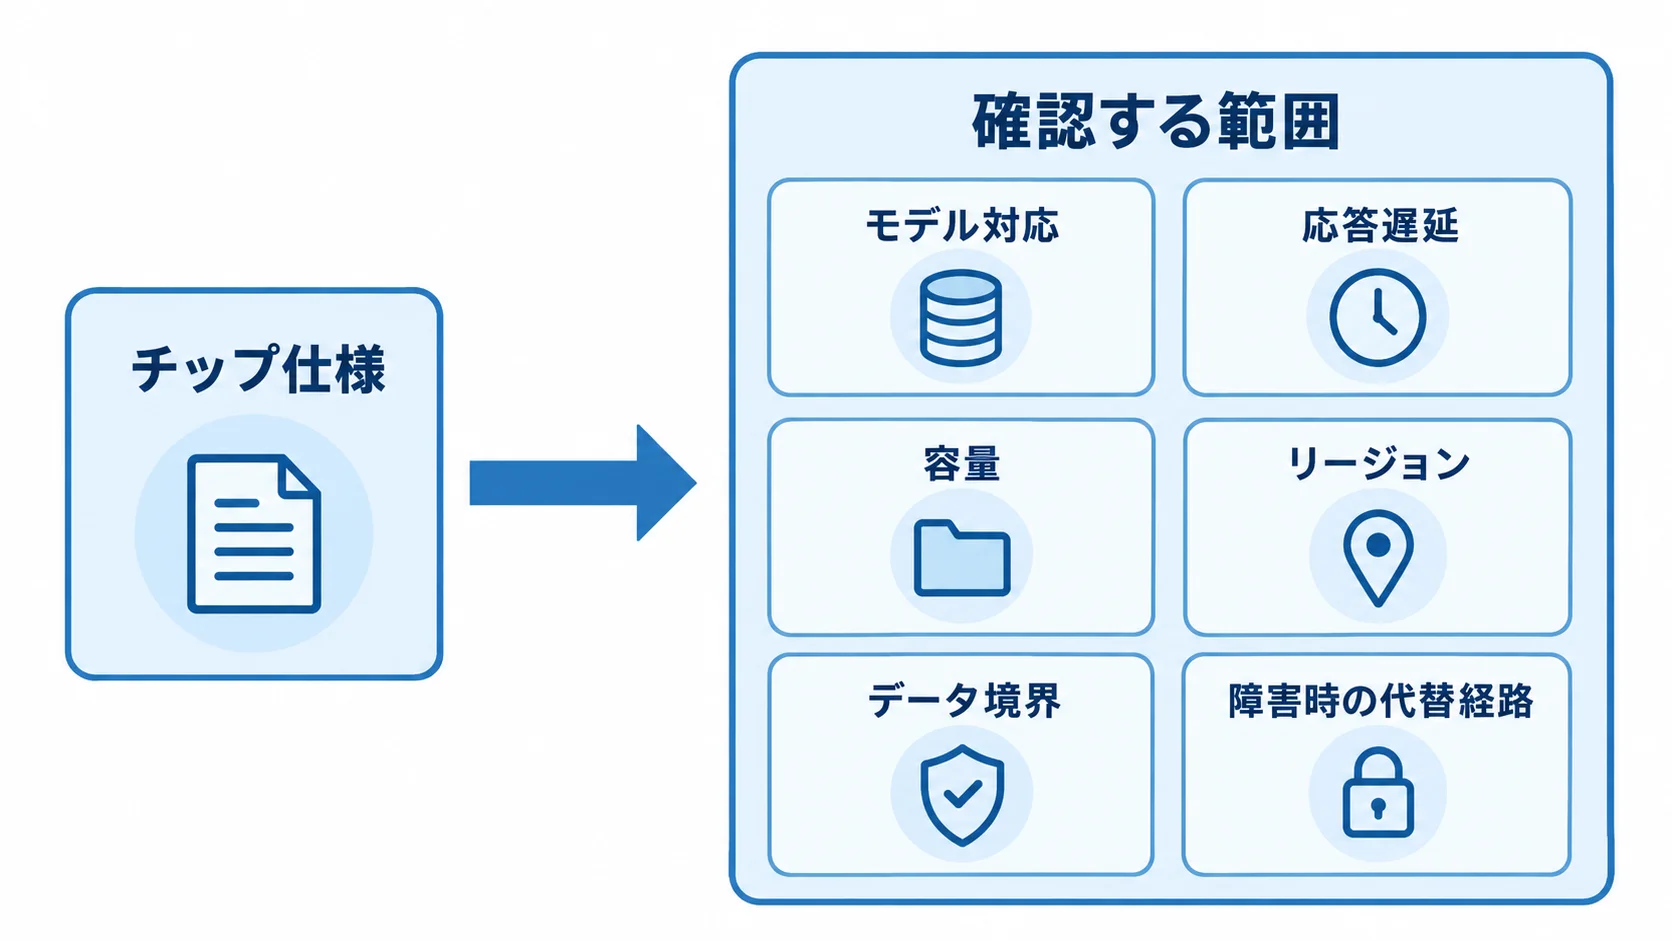
Microsoft Foundryを使う企業が確認するのは、アクセラレータの型番だけではありません。利用するモデルが対象のサービスで動くか、長いコンテキストで応答遅延がどう変わるか、同時実行数の上限と容量予約がどうなっているかを、実際のアプリケーションで確かめます。
Copilotを導入する企業は、応答性能と同じくらい、テナントのデータ境界、利用リージョン、監査ログ、障害時の代替経路を確認します。Microsoft Copilotの大規模導入の記事で扱うようなコストと統合の論点に、推論基盤の供給条件を加えるイメージです。
ポイント
CopilotやFoundryの利用企業は、Maia 300を直接指定できるかではなく、モデル対応、応答遅延、容量、リージョン、データ境界、障害時の代替経路が要件を満たすかを確認します。
導入前に確認する5項目|モデル・料金・容量・設備・切り戻し
Maia 300をめぐる判断は、半導体のスペック表だけでは終わりません。2027年の本番展開を待つ企業は、次の5項目を現在のAzure利用状況と照らして整理しておくと、提供条件が出たときに比較しやすくなります。
- ワークロード:モデル、コンテキスト長、同時実行数、許容遅延を測定し、推論のピークを決める。
- 料金:アクセラレータ単価だけでなく、従量、予約、最低利用量、データ転送を比較する。
- 容量とリージョン:必要な時期に必要な容量を確保できるか、データ境界と合わせて確認する。
- 設備と責任分界:167kWラックや液冷は主に提供側の設計だが、供給制約やSLAへどう反映されるかを確認する。
- 切り戻し:GPUなど別の基盤へ戻す条件、モデル差分、ログと監視の互換性を決めておく。
発表された最大7倍は、Maia 200とのラックスケール比較です。自社のAPI応答時間やエージェントの完了時間が7分の1になると約束する数値ではありません。採用判断では、同じモデルと入力で小さな負荷試験を行い、費用、遅延、エラー率、容量の変化を記録します。
この準備があれば、Maia 300の提供条件が公開されたときに、GPU依存を減らすべきかを事業の指標で判断できます。チップを選ぶこと自体を目的にせず、必要な推論を安定して、予算内で、説明可能な形で運用できるかを基準にします。
ポイント
導入前に、ワークロード、料金、容量・リージョン、設備と責任分界、切り戻しの5項目を定義します。Maia 300の提供条件が出たとき、GPUとの比較を事業要件へ結び付けられます。
よくある質問
Q. Azure Maia 300はいつ使えますか?
Maia 300は2027年に本番展開を開始する予定です。一般利用者向けのSKU、提供リージョン、価格、SLAは2026年10月15日時点で示されていません。
Q. Maia 300はGPUよりどのくらい速いですか?
Microsoftは、主要GPUベースシステム比で1メガワットあたりのトークン数40%増、Maia 200比で96アクセラレータ構成のラックスケール・トークンスループット最大7倍を見込んでいます。自社のワークロードでの速度を保証する数値ではありません。
Q. Maia 300はMicrosoft CopilotやFoundryで使われますか?
Maia 200はMicrosoft Copilotで本番稼働し、GitHub CopilotとMicrosoft Foundryは年末までに続く予定です。Maia 300は2027年に本番展開を開始する計画ですが、各サービスでの利用条件は発表時点で示されていません。
Q. 企業はMaia 300を直接購入・指定できますか?
2026年10月15日時点で、一般利用者向けにMaia 300を直接購入・指定できるSKUや価格は示されていません。サービスのモデル対応、リージョン、容量、SLA、データ境界を契約単位で確認する必要があります。
まとめ
Azure Maia 300は、N2Pのマルチチップレット、HBM4の18TB/s、96アクセラレータ・167kWラック、マルチギガワット展開を組み合わせた推論基盤です。Microsoftは2027年の本番展開を計画し、CopilotやFoundryを含むサービスの基盤へMaiaを広げています。
企業が今決めるべきことは、Maia 300へ乗り換えることではありません。自社の推論ワークロードと料金・容量・リージョン・SLA・切り戻し条件を定義し、提供条件が公開された時にGPUとの比較を再現できる状態をつくることです。
ポイント
Maia 300はGPU依存を単純に消す製品ではなく、推論基盤の選択肢を増やすクラウド側の取り組みです。効率の公表値と、企業が契約するサービスの性能・料金・供給条件を分けて判断します。
関連記事
- AI推論向けクラウド支出96%増を解説|学習から推論への投資シフト
- 生成AIの従量課金・推論モードを解説|コスト管理のポイント
- Microsoft Copilotの大規模導入を解説|コスト・統合と選定のポイント
- AIエージェントのコスト暴走を解説|3日で約17万円のBedrock実例と対策
- NVIDIAがVera Rubinのラック設計をOCPに公開を解説|250kW・液冷時代のAIデータセンター
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。