
Cloudflareは2026年7月、AIクローラーを「Search」「Agent」「Training」という用途別に管理する選択肢を、すべての顧客に提供すると発表しました。AIに見つけてもらうか、AIの代理操作を受け入れるか、学習利用を許可するかを、サイト運営者が同じ設定にまとめず個別に選べるようになっています。
検索流入を増やしたいサイトにとって、AIクローラーをすべて遮断することが最適とは限りません。一方で、robots.txtを書くだけでは意図どおりに扱われているか把握しにくいのも事実です。
発見性、コンテンツ利用、アクセス負荷を分けて方針化し、実際のアクセスを観測する運用が、企業のIT・事業責任者には求められます。
※本記事は2026年8月時点の情報です。
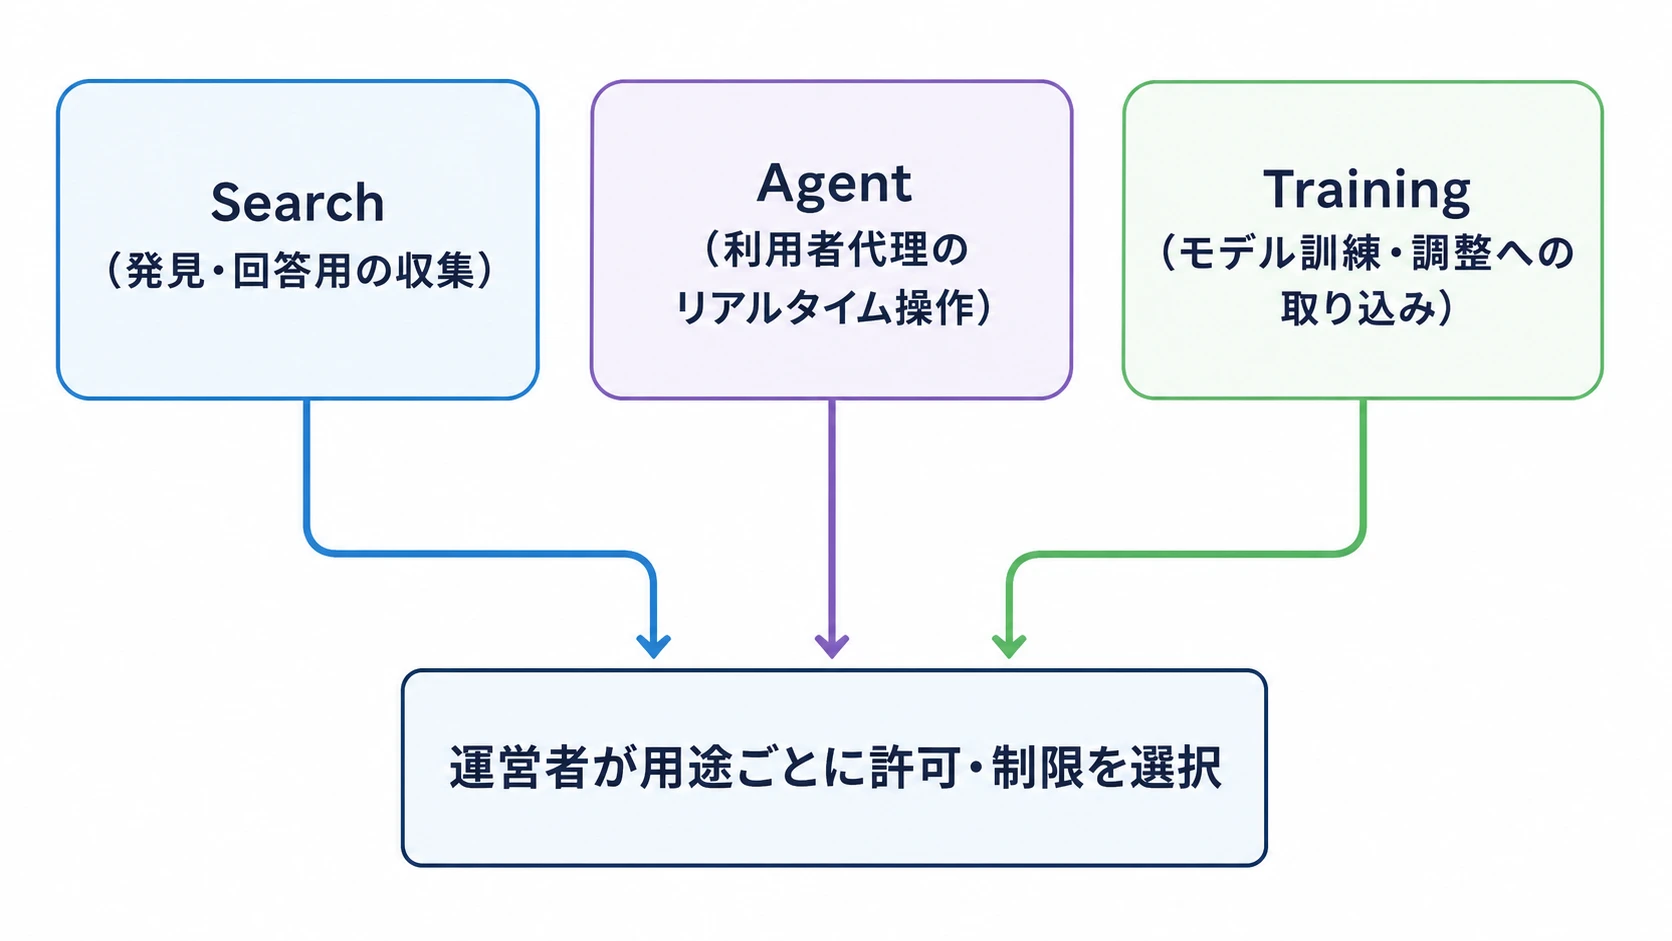
「AIかどうか」ではなく、何のために来るかで分ける
Cloudflareは、AI関連トラフィックを主に3用途で捉えています。Searchは後で質問に答えるためにコンテンツを収集・インデックスする行為、Agentは利用者の代理としてリアルタイムに操作や取得を行う行為、Trainingはモデルの訓練やファインチューニングのためにコンテンツを取り込む行為です。
同じ運営者が複数用途のクローラーを持つ場合もあるため、用途を分離して扱うことをCloudflareは促しています。
| 用途 | サイト運営者が考える問い |
|---|---|
| Search | 自社コンテンツを検索・回答の候補として発見してほしいか |
| Agent | 利用者の代理で来訪するAIに、閲覧や操作を許可するか |
| Training | モデルの訓練・調整にコンテンツを使わせるか |
「見つかる」は、許可範囲を決める運用になります
検索・生成AIでの露出を望む場合でも、学習利用まで一律に許可する必要があるとは限りません。逆にTrainingを遮断する設定が、複数用途のクローラーへどのように適用されるかは個別の設定・クローラー特性を確認する必要があります。発見性を高めるGEOの考え方と、アクセス許可の方針を混同しないことが大切です。
ポイント
Search・Agent・Trainingは目的が異なります。一律に許可・遮断するのではなく、用途ごとに発見性と学習利用への方針を分けて検討します。
robots.txtは「書く」だけでなく、読まれ方を確認する
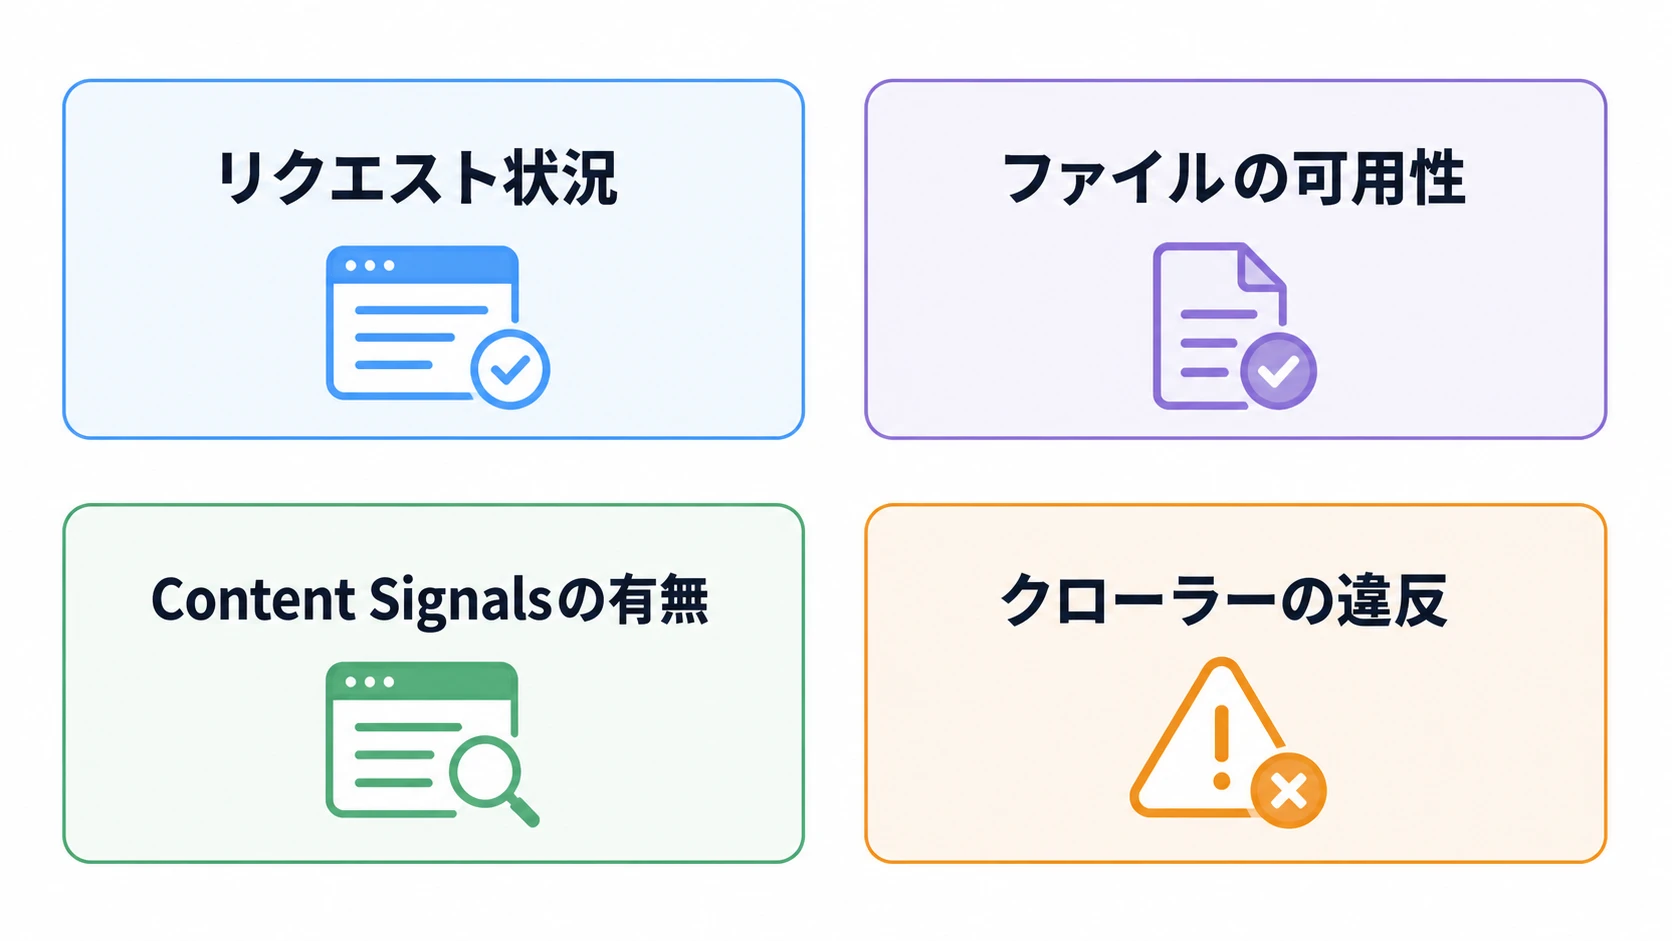
CloudflareのAI Crawl Controlには、robots.txtへのリクエスト状況、ファイルの可用性、Content Signalsの有無、クローラーによる違反を確認する機能があります。クローラー名、運営主体、AI training・general search・AI assistantといった用途別に絞り込めるため、設定と実際のアクセスを突き合わせる材料になります。
同ドキュメントは、robots.txtで明示的に許可していないパスへAIクローラーがアクセスした記録を「違反」として確認できると説明しています。ただし、違反の判定は現在のrobots.txtと過去のリクエストを照合するため、ルールを変更した直後は以前は許可されていたアクセスも違反として表示され得ます。
数値だけで遮断判断をせず、変更履歴と合わせて確認しましょう。
ポイント
robots.txtのルールを変更した直後は、過去のアクセス記録との突合で違反表示が一時的に増えることがあります。数値の変化だけでなく変更履歴と合わせて確認します。
運営者が決めるべきことは、遮断の可否より利用条件です
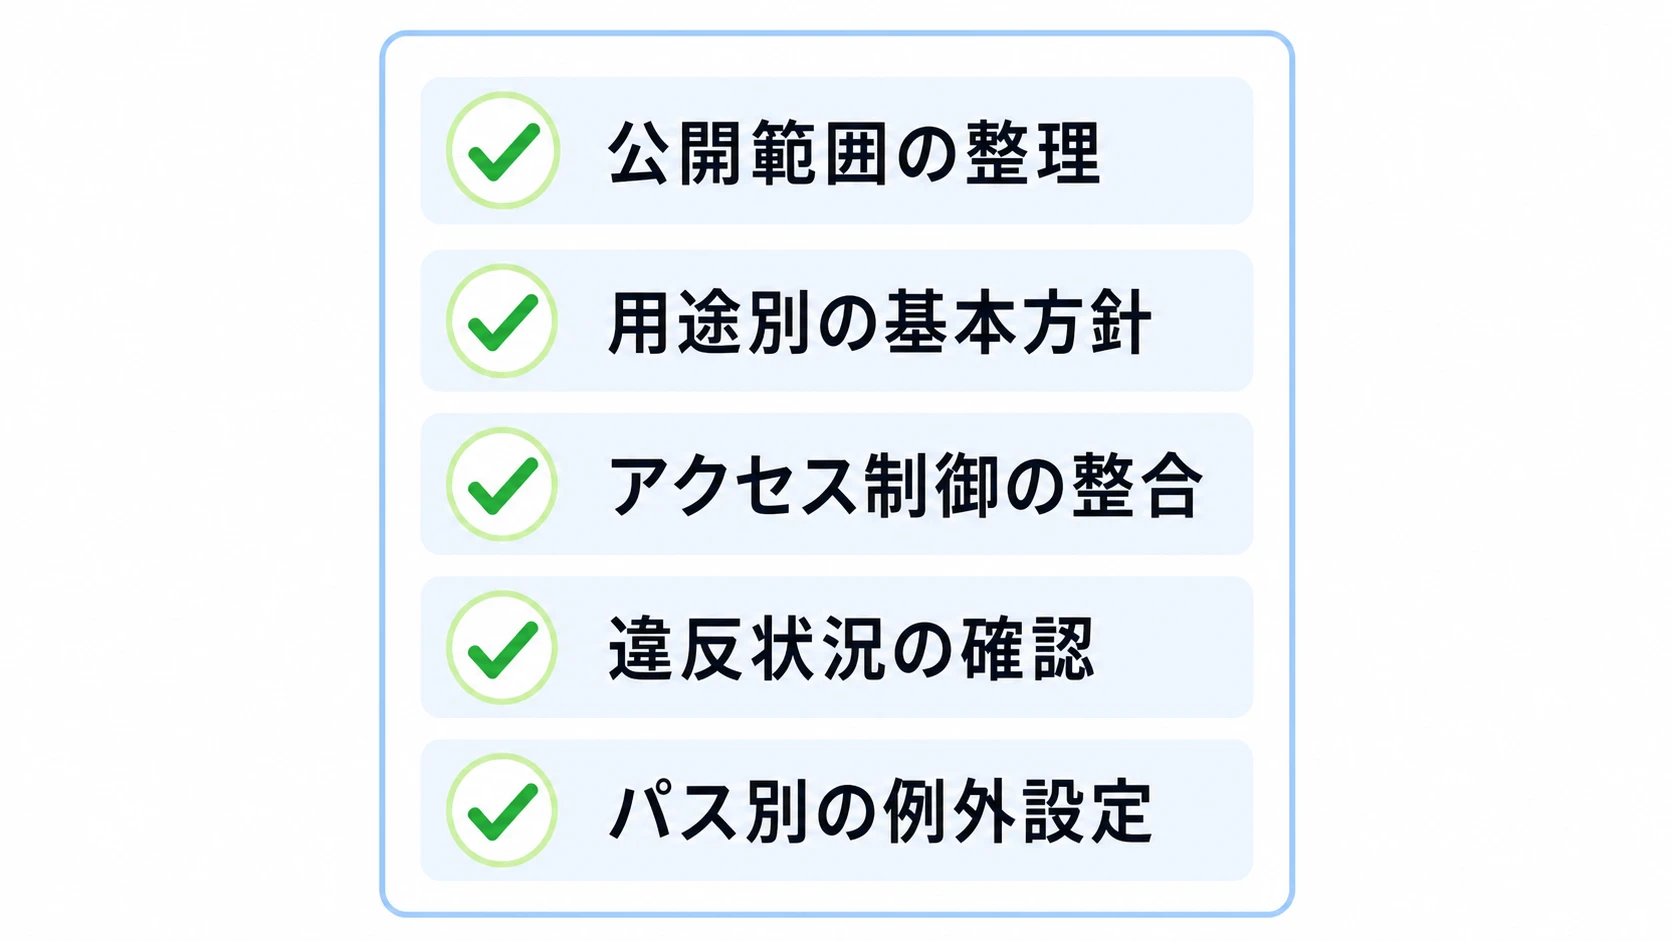
Cloudflareの用途別管理を踏まえると、サイト運営者は遮断の可否よりも利用条件を先に整理する必要があります。次の項目を出発点にしてください。
- 検索・AI回答で発見されたいコンテンツと、公開範囲を限定したいコンテンツを分ける
- Search、Agent、Trainingの各用途について、許可・制限・遮断の基本方針を作る
- robots.txtの公開状態と、WAFなど追加のアクセス制御が矛盾していないかを確認する
- 用途別のアクセス状況と、規約違反の疑いを定期的に確認する
- コンテンツ更新、会員領域、問い合わせフォームなど、パスごとの例外を設ける
技術設定はコンテンツ戦略の代替ではありません。サイトの一次情報を読みやすく整える検索・開発の論点とともに、どの利用を受け入れるかを編集・法務・セキュリティで合意しておくと、変更時の判断が速くなります。
ポイント
遮断か許可かではなく、パス単位の例外まで含めた利用条件を編集・法務・セキュリティで事前に合意しておくことが、変更時の判断を速くします。
よくある質問(FAQ)
Q. AIクローラーを遮断すると、検索にも表示されなくなりますか?
一律にはいえません。CloudflareはSearch、Agent、Trainingを別の用途として扱う選択肢を示しています。実際の影響は、どのクローラーをどの設定で制限するか、各検索サービスがどのクローラーを使うかによって確認してください。
Q. robots.txtだけでAIクローラーを管理できますか?
robots.txtは方針を示す重要な手段ですが、設定後のアクセス状況も確認する必要があります。Cloudflareのドキュメントでは、robots.txtの可用性や、明示的に許可していないパスへのAIクローラーのアクセスを確認できると説明されています。
Q. Trainingを拒否すれば、AI検索からの発見性も失いますか?
必ずしもそうとは限りません。CloudflareはSearchとTrainingを別用途として管理する考え方を提示しています。ただし複数用途を持つクローラーもあるため、設定の適用範囲と実際のアクセスを確認して判断します。
まとめ
AIクローラーへの対応は、すべてを許可するか拒否するかの二択ではありません。Cloudflareの用途別管理とrobots.txtの観測機能は、検索、代理操作、学習利用を分けて考えるきっかけになります。自社の発見性とコンテンツ利用の方針を明文化し、設定後もアクセスを確認する運用へ進めましょう。
参考情報:
Cloudflare Blog「Your site, your rules: new AI traffic options for all customers」
Cloudflare Docs「Directives」
ポイント
AIクローラーへの対応は遮断か許可かの二択ではありません。Search・Agent・Trainingを分けた方針と、robots.txtの観測を組み合わせて運用します。
関連記事
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。