
Googleは2026年10月8日、本番AIエージェントの品質を継続的に調べるオープンソースのADKエージェント「AQuA(Ambient Quality Agent)」を紹介しました。AQuAは会話の失敗を見つけ、同じ原因のセッションをまとめ、デプロイ済みソースの行範囲までたどって編集案を示す仕組みです。
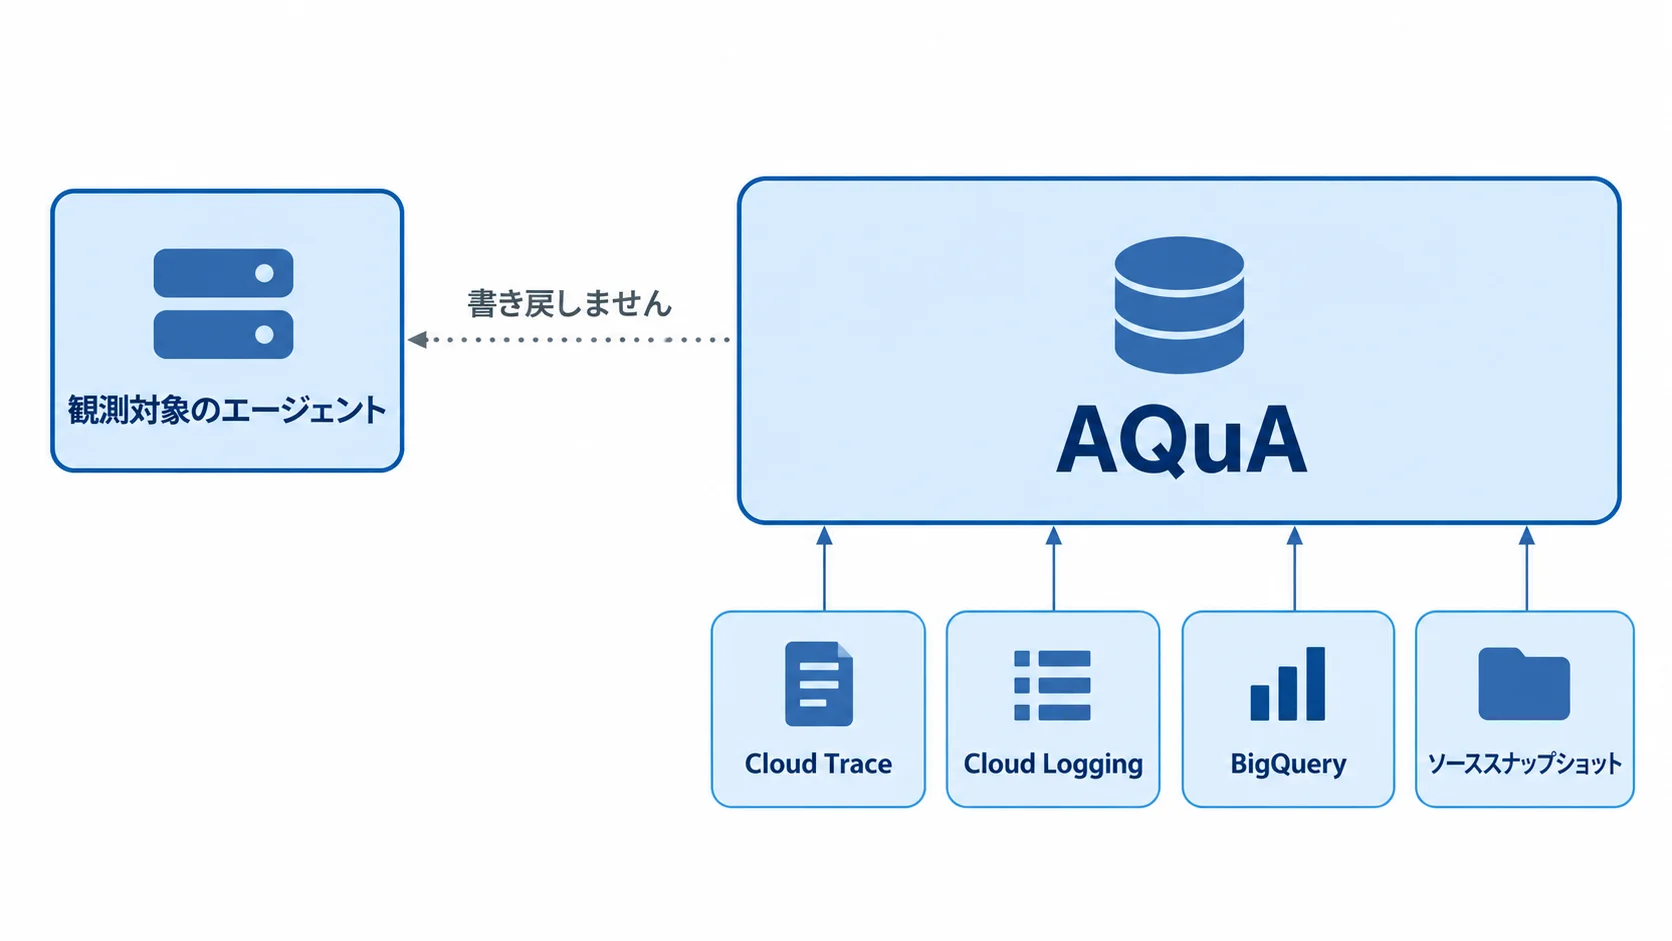
本番運用では、HTTP 200が返り、ツール呼び出しにもエラーがないまま、会話の品質だけが落ちることがあります。AQuAはCloud Trace、Cloud Logging、BigQueryの本番の軌跡をリクエスト処理の外側から読み、事前に作った評価ケースでは現れなかった失敗を扱います。
修正を自動適用する製品ではありません。企業が導入する際は、テレメトリとソーススナップショットの境界、評価目標、人が編集案をレビューして再評価する手順を決める必要があります。
※本記事は2026年10月16日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AQuAとは|本番エージェントの「外側のループ」を担う
AQuAは、稼働中のエージェントに回答を返す機能ではありません。Google Cloudプロジェクト内で観測対象のエージェントの横に置き、蓄積されたセッションの軌跡を定期的、デプロイ後、または任意のタイミングで調査します。評価結果はインサイトとして残り、再発する問題を追いかけられます。
従来の開発では、評価ケースを実行し、採点して、プロンプトやツールを直す内側のループが中心でした。AQuAが扱うのは、その外側です。利用者が実際に入力した会話を材料に、想定外の使われ方や、モデル・ハーネス・ツールの変更後に起きた静かな劣化を拾います。
セッションの記録、デプロイ時のソーススナップショット、BigQueryのテーブルはプロジェクト境界内に置かれます。AQuAはリクエスト処理経路に入らず、観測対象のエージェントへデータを書き戻しません。障害を検出する仕組みと、応答を生成する仕組みを分けた設計です。
ポイント
AQuAはエージェントの応答を置き換える部品ではなく、本番の会話品質を監視し、改善の材料を作る外側のループです。
5段階の調査|失敗をクラスタ化し、再発を追跡する
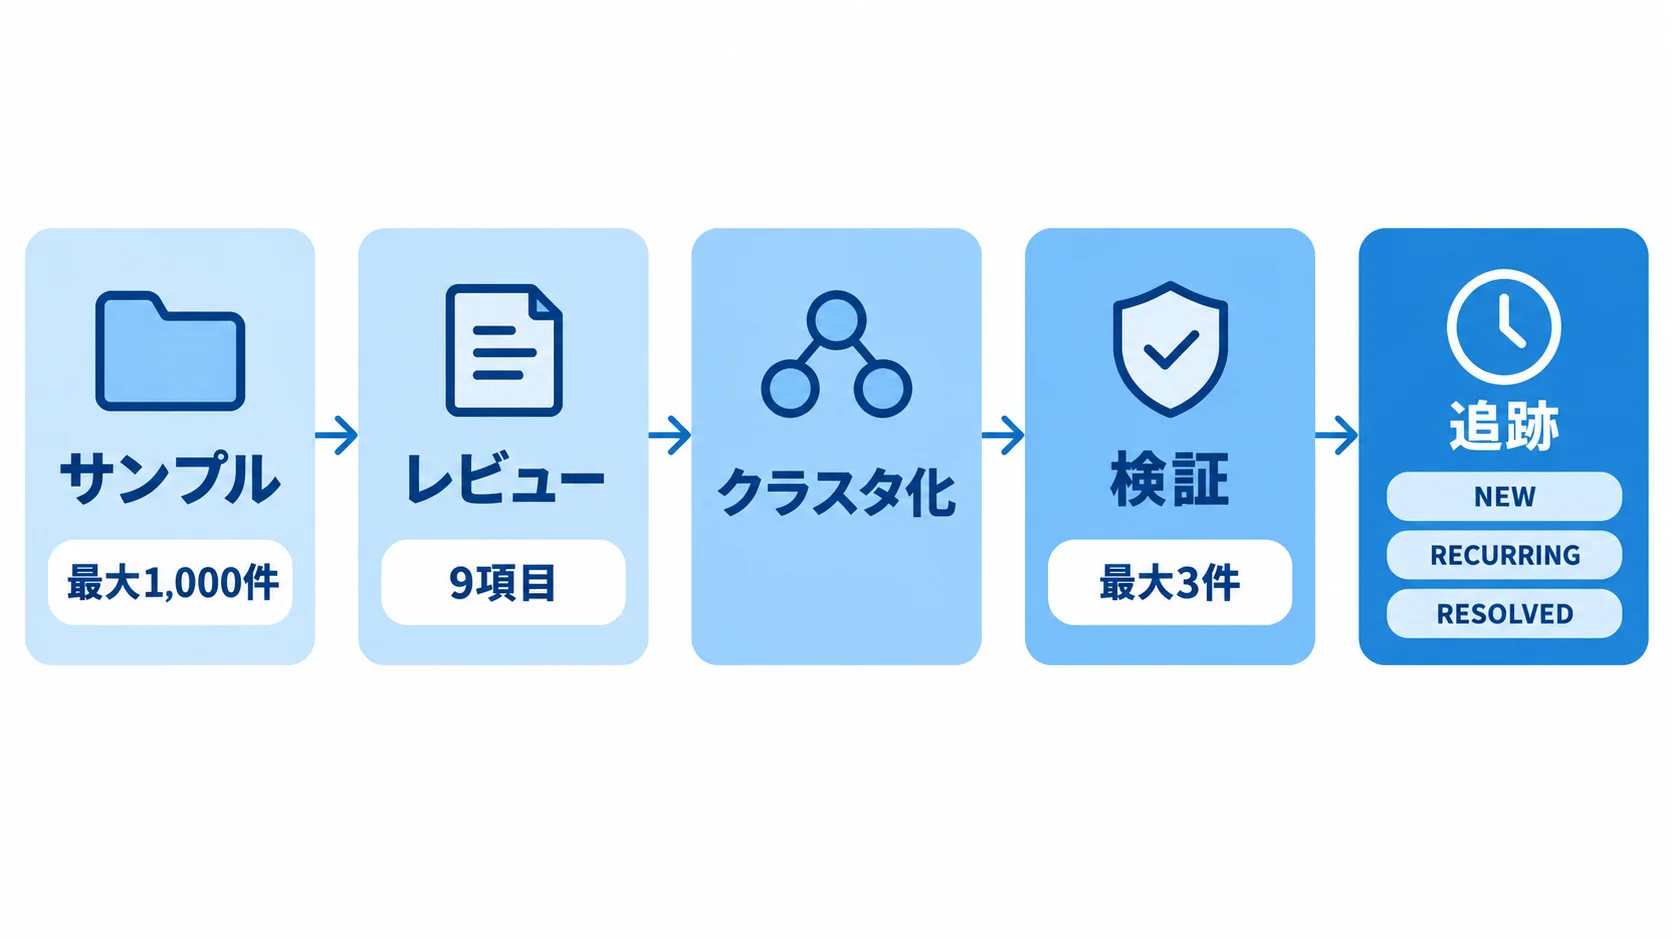
AQuAは最近のセッションを最大1,000件までランダムにサンプルします。1件ずつ9項目のチェックリストでレビューし、問題があれば「実際に起きたこと」と「期待されること」を構造化した actual / expected の所見として記録する設計です。
次に、同じ失敗メカニズムを持つ所見から候補クラスタを作り、別のモデルが各クラスタを最大3件の完全なトランスクリプトで検証します。証拠が足りない候補は採用しません。検証を通った問題はBigQuery上で、初出の NEW、再発の RECURRING として管理され、14日間見つからなければ自動的に RESOLVED になります。
この分け方は、モデルの判定をそのまま事実として扱わないためのものです。候補を先に広く拾い、完全な会話で検証してからチームの課題に登録します。AQuAの公式例では、32セッションから42件の所見を作り、9候補クラスタに集約した後、誤検知3クラスタを棄却して6件を検証済みの問題として残しました。
| 仕組み | 主な対象 | 得られるもの |
|---|---|---|
| オフライン評価 | 既知の評価ケース | デプロイ前の合否 |
| オンライン評価 | 本番の指標推移 | スコアの変化 |
| AQuA | 本番会話の失敗軌跡 | 検証済みクラスタと原因調査の根拠 |
AgentOpsの可観測性・評価・監視を整えたうえで、AQuAへ渡すセッションの範囲を決めます。役割分担が明確になります。
AQuAは全件を深く読む仕組みではありません。サンプル数と、見逃したくない業務の条件を先に定義します。
ポイント
AQuAは最大1,000件を対象に候補を作り、最大3件の完全な会話でクラスタを検証します。サンプル設計と検証上限は品質と費用の両方を左右する設計要素です。
根本原因診断|デプロイ済みソースの行まで編集案を示す
インサイトの調査はダッシュボードのChat、または agents-cli aqua run から起動します。AQuAは失敗した会話と、その会話を生んだデプロイ時の不変なソーススナップショットを照合し、コードに原因があるときは <path>:<start>-<end> の形式で該当箇所を示す仕組みです。編集案も提示します。
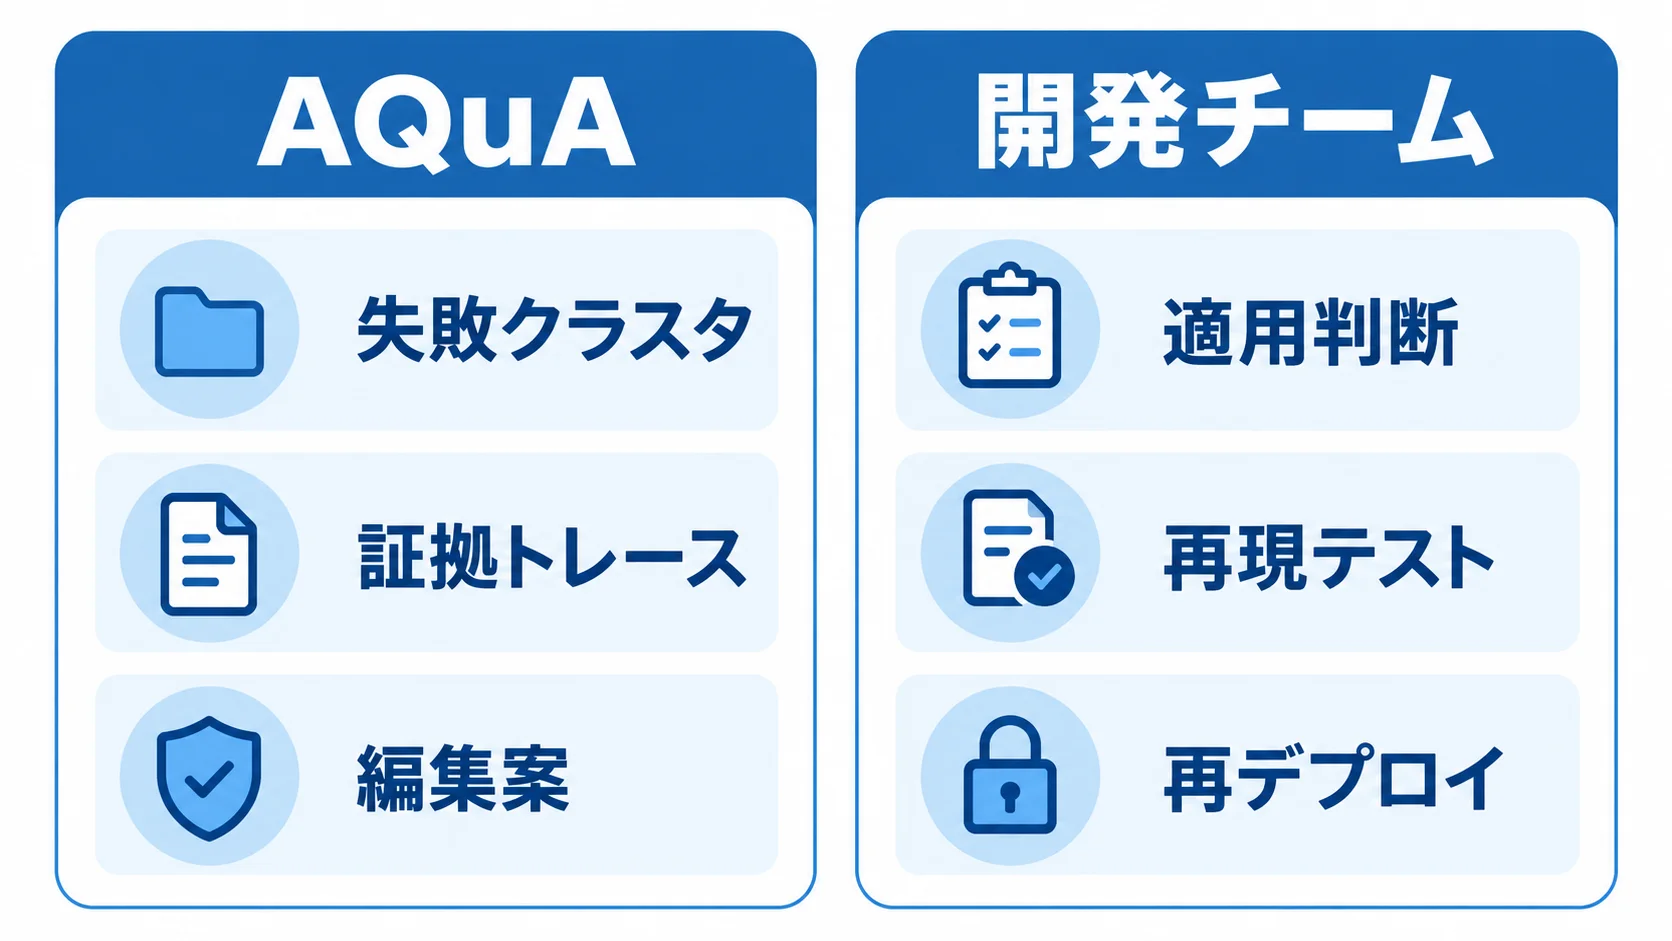
原因が上流の依存関係、エージェント間の引き継ぎ、取得したデータにある場合は、コード差分を無理に作らず、軌跡上の該当段階を指摘します。編集を適用したり、プルリクエストを作ったりする処理は自動では行いません。人が変更の妥当性を判断し、再現テストと再デプロイを進める余地を残しています。
旅行コンシェルジュの例では、座席の空き状況を確認せずに3Aや3Bを保存する問題が15セッションで起きました。食事の好みがサブエージェントへ渡らない問題は7セッションで発生しました。プロンプトを2か所直して再デプロイした結果、前者は2件のエッジケースまで87%減り、後者は0件です。未修正の問題を追跡に残した点も、運用設計の参考になります。
Gemini EnterpriseのAgent Anomaly Detectionのような検知機能と比べると、AQuAは失敗を一時的なアラートで終わらせません。複数セッションの共通原因をまとめ、デプロイ済みコードの根拠へ結び付けます。
ポイント
AQuAの出力は修正そのものではなく、失敗クラスタ、証拠トレース、ソース行に結び付いた編集案です。適用判断と再評価は開発チームが担います。
導入条件とデータ境界|ADKのテレメトリを自社環境で扱う
公式READMEによると、AQuAはADK BigQuery Agent Analyticsプラグイン、Cloud Telemetryのリンク済みBigQueryデータセット _AllSpans、agents-cli の既定テレメトリに対応します。
既存のログがどの形式で保存され、どのプロジェクトとサービスアカウントから読めるかを確認することが出発点です。
- 実行環境:Python 3.11〜3.13、
uv、npm、Terraformをそろえます。 - CLI:
agents-cli1.6以降が前提です。 - Google Cloud:組織に属するプロジェクト、
GOOGLE_CLOUD_PROJECT、Application Default Credentialsを用意します。 - ダッシュボード:IAPで保護し、組織の管理OAuthクライアントを使います。
ダッシュボードはCloud Run上でIAPの背後に置く構成です。組織を持たない環境では、公式READMEに TF_VAR_ui_iap_enabled=false と agents-cli aqua ui-proxy を使う代替手段が示されています。セッション本文とソーススナップショットを同じプロジェクト境界に置けるか、権限を誰に与えるかを先に決めます。
導入前に、AIエージェント実験で起きる失敗を自社の業務フローに置き換え、検出したい品質条件を言葉にしておくと、後述の goal.md が形だけになりません。
企業が先に決める運用|自動修正ではなく検証可能な改善へ
AQuAのレビューは、開発者が書く平易な目標 goal.md で業務上の合否条件に合わせる設計です。決定的なPython指標は eval_config.yaml に置けます。
Geminiの管理軌跡AutoRatersで task_success、tool_use_quality、trajectory_quality を測定することも可能です。まず「何を失敗と呼ぶか」を決めることが必要です。
費用はセッション数と軌跡の長さ、診断するインサイトの数で変わります。公式例では、96セッションのレビュー・クラスタ化・検証が合計0.70ドル(約105円)、32セッション・1,583 spansの例が合計3.76ドル(約564円)でした。根本原因診断は1インサイトあたり0.33〜2.47ドル(約50〜371円)です。※1ドル=150円で換算。固定の利用料ではないため、自社の実測値で予算を作ります。
実務では次の順番にすると、AQuAの提案をそのまま本番へ流し込まずに済みます。
- 業務の成功条件と、見逃したくない失敗を
goal.mdと指標にする。 - 必要なトレースだけを選び、ログ・会話本文・ソーススナップショットの権限を分ける。
- クラスタの証拠トレースと編集案を担当者がレビューする。
- 修正をテスト環境で再現し、再デプロイ後の軌跡で効果を確かめる。
- 再発・解消の履歴を見ながら、サンプル数と指標を調整する。
AIエージェントのROI評価では、導入前の期待値だけでなく、運用後に品質とコストがどう動いたかを追う必要があります。AQuAを入れる場合も、検出件数を増やすこと自体を成果にせず、再現テストの合格率や再発の減少を評価軸にします。
ポイント
AQuAの導入効果は、インサイトの数ではなく、根拠のある修正を安全に適用し、再発を減らせたかで判断するものです。
よくある質問
Q. AQuAは本番エージェントの応答を直接変更しますか?
いいえ。AQuAはリクエスト処理経路に入らず、観測対象エージェントへ書き戻しません。原因に応じた編集案を提示しますが、編集の適用やプルリクエストの作成は自動では行いません。
Q. AQuAはどのテレメトリに対応していますか?
Cloud Trace、Cloud Logging、BigQueryに加え、ADK BigQuery Agent Analyticsプラグイン、Cloud Telemetryのリンク済みBigQueryデータセット(_AllSpans)、agents-cliの既定テレメトリに対応します。
Q. AQuAの調査は何件のセッションを読み、どのように問題を検証しますか?
1回につき最近のセッションを最大1,000件ランダムにサンプルし、9項目のチェックリストでレビューする方式です。失敗をクラスタ化した後、別モデルが各候補を最大3件の完全なトランスクリプトで検証します。
まとめ
AQuAは、本番AIエージェントの会話をサンプリングし、失敗をクラスタ化して、デプロイ時ソースの行範囲まで原因をたどるオープンソースのADKエージェントです。検証を通ったインサイトを追跡し、品質改善の外側のループを作る仕組みです。
導入時は、既存テレメトリとの接続、データと権限の境界、業務目標、サンプル数、費用を確認します。編集案を人が判断し、テストと再デプロイで効果を確かめる運用まで決めて、初めて本番品質の改善に使える仕組みになります。
ポイント
AQuAは自動修正ツールではなく、本番の失敗を根拠付きで開発ループへ戻す監視・診断基盤として評価する対象です。
関連記事
- AgentOpsを解説|AIエージェントの可観測性・評価・監視のポイント
- Gemini EnterpriseのAgent Anomaly Detectionとは?ADK・トレース・検知の仕組み
- AIエージェント実験の失敗事例を解説|丸投げを防ぐ監督体制のポイント
- AIエージェント導入を解説|過度な期待を避けるROI評価のポイント
- AIエージェントのコスト暴走を解説|3日で約17万円のBedrock実例と対策
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。