
SpaceXAIは2026年9月21日、Grok 4.7をコーディングとナレッジワーク向けのモデルとして発表しました。
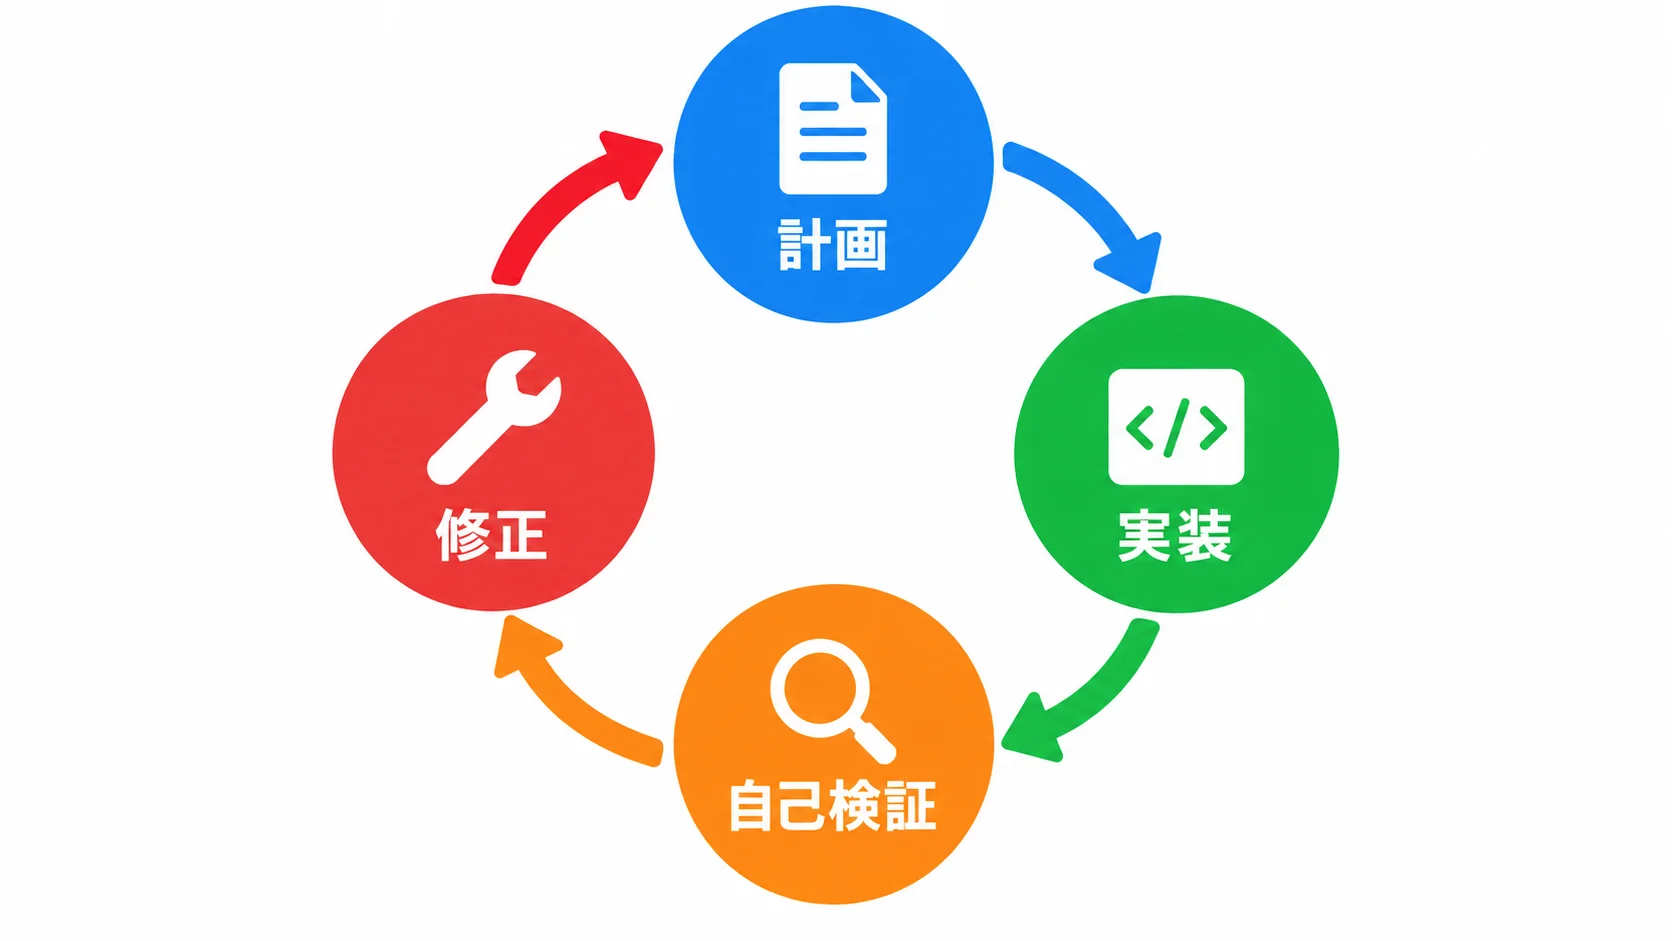
公式説明では、長時間の難しいタスク、自己検証、長いコンテキスト管理を改善しています。
この記事では、Grok 4.7のエージェント型コーディングを、モデルの訓練方針と実務の評価項目に分けて整理します。
※本記事は2026年9月22日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
長時間タスクへの改善|自己検証とコンテキスト管理
公式発表は、Grok 4.7がGrok 4.6より大きい基盤モデルを使い、長い強化学習を実施したと説明しています。数時間かかる課題へ重みを置いた訓練です。
- 長いタスクを継続する
- 自分の成果物を確認する
- 長いコンテキストを管理する
ポイント
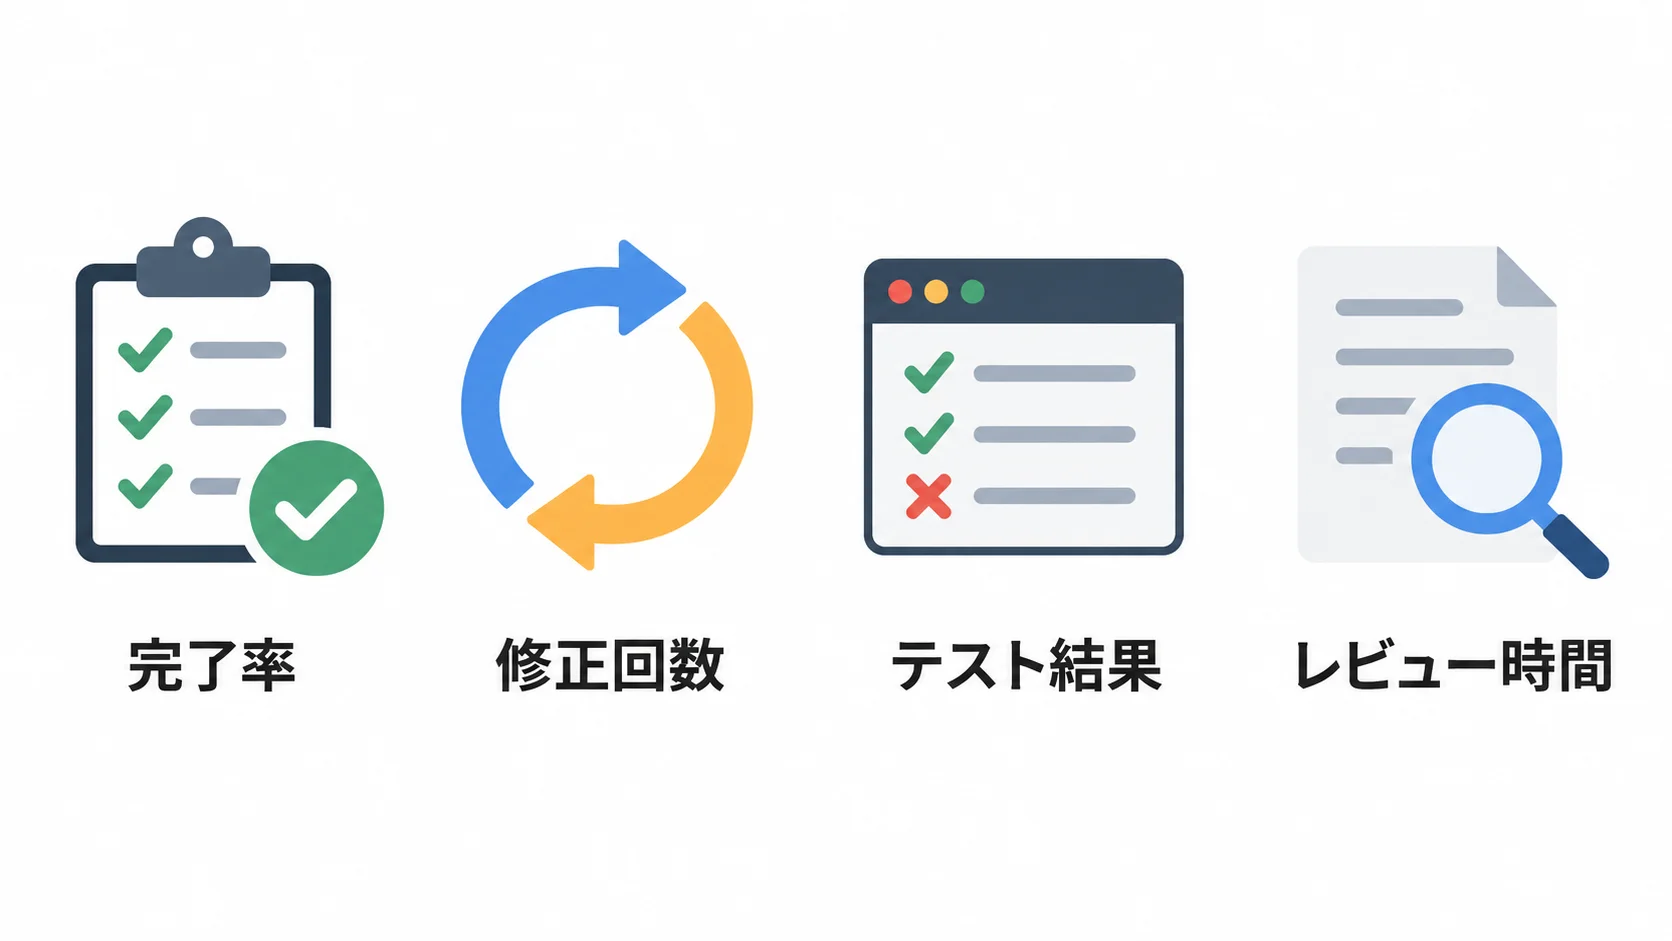
自己検証は機能説明です。実務では、修正回数と人手レビューを測ります。
ハーネスとの関係|モデル単体と開発環境を分ける
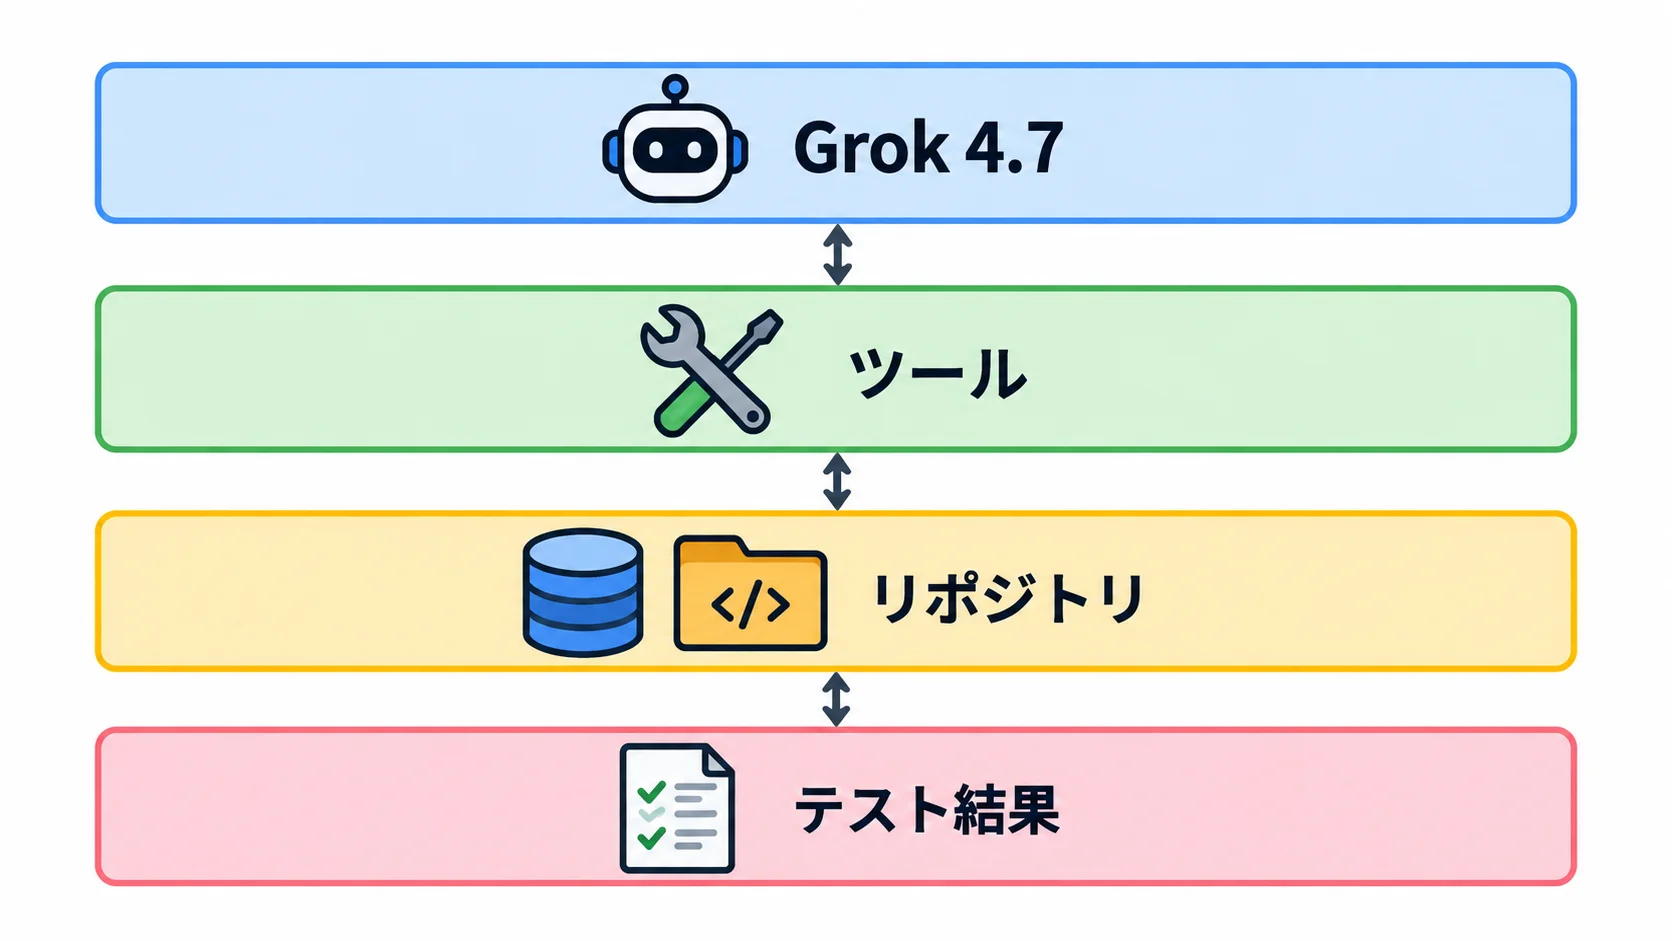
Grok 4.7はGrok Botのハーネスをネイティブに理解するよう訓練したと、公式発表にあります。これはモデルの訓練方針であり、利用者側のツール権限や開発環境を自動で決めるものではありません。
AgentOpsの評価・監視を参考に、ツール呼び出しの失敗、テスト結果、レビュー時間を記録します。AIコードレビューの工程も分けて管理します。
ポイント
モデルの改善と開発環境の改善を分け、導入後の失敗要因を追跡します。
評価手順|長時間タスクを同じ条件で測る
設計例として、同じリポジトリとテストを使い、完了率、修正回数、実行時間を記録します。
モデルの説明と自社の測定値を分けると、導入後の改善点を追跡できます。
ポイント
長時間タスクは完了率だけでなく、修正とレビューまで測ります。
Grok 4.7のコーディングに関するよくある質問
長時間タスクに強い理由は何ですか?
公式発表では、大きい基盤モデル、長い強化学習、自己検証、長いコンテキスト管理を挙げています。
Grok Botと同じ製品ですか?
Grok 4.7はモデル名です。公式発表ではGrok Botのハーネスを理解する訓練にも触れています。
タスク分解|モデルとツールの責任範囲を決める
長時間タスクは、モデルの推論とツール実行を分けて評価します。
設計例では、権限、テスト、レビュー担当を固定し、失敗時の戻し方を決めます。
導入時は何を評価しますか?
タスク完了率、修正回数、テスト結果、ツール失敗、レビュー時間を同じ条件で測ります。
まとめ
Grok 4.7は長時間のコーディングや知識作業を意識したモデルです。自己検証の説明を、実務の評価指標へ落とし込んで比較します。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。
関連記事4選
コーディングAIの評価と運用に関する関連記事です。