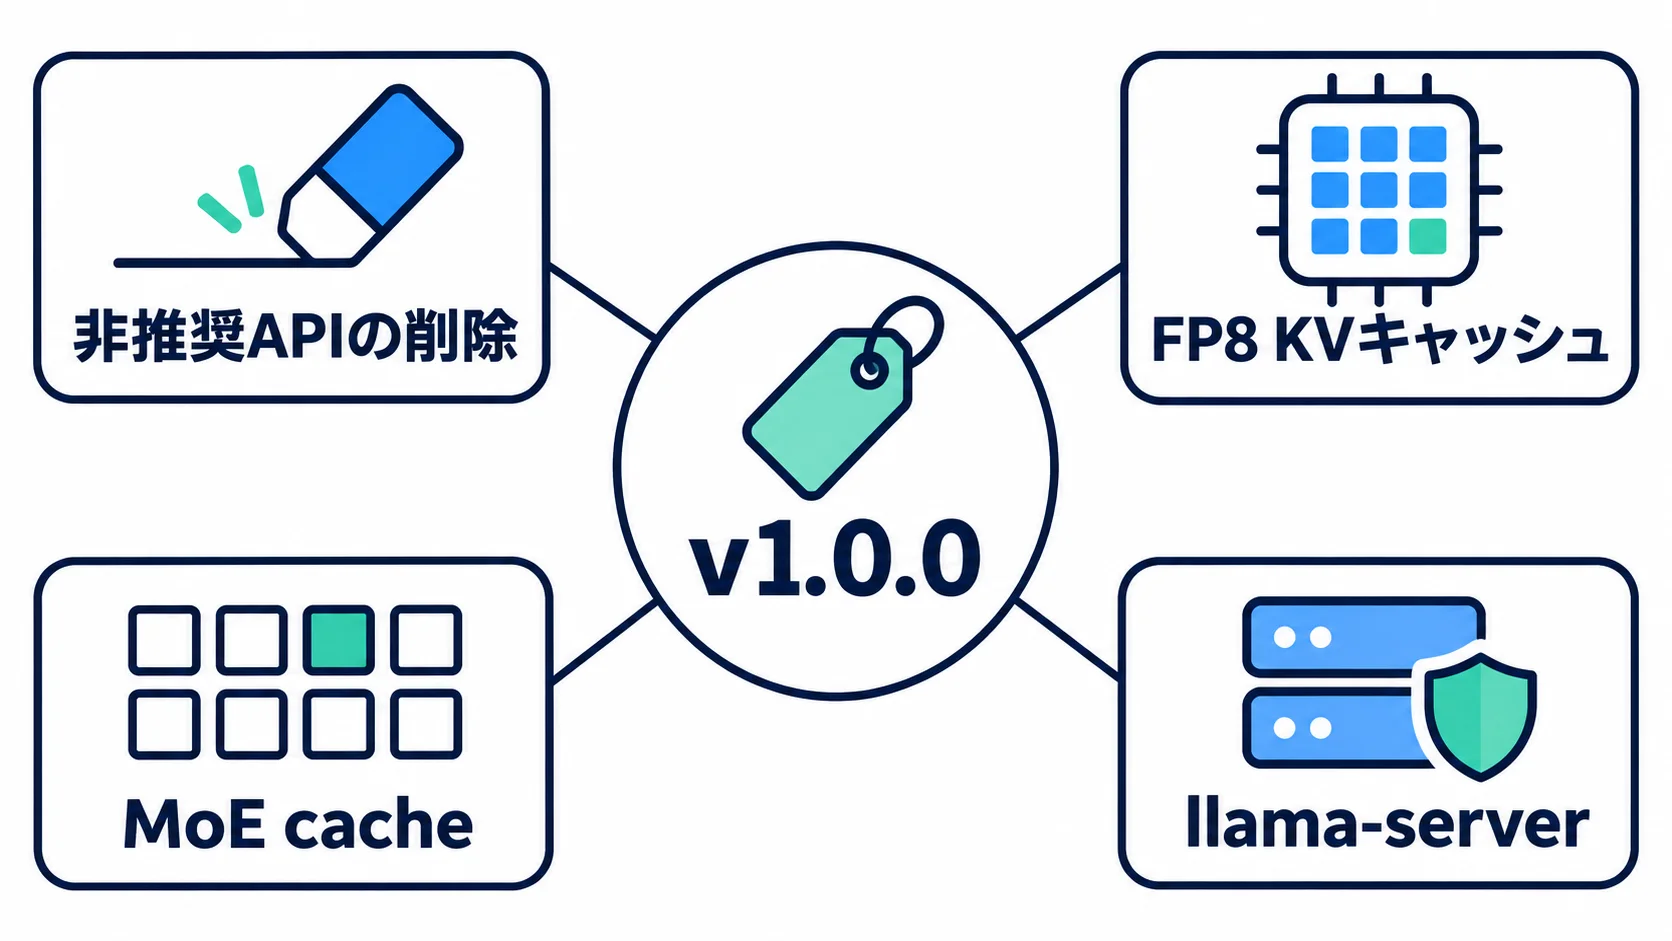
ggml-orgは2026年11月13日、llama.cpp v1.0.0とggml v1.0.0をリリースしました。非推奨APIの削除に加え、FP8 KVキャッシュ、MoE cache、llama-serverのセキュリティ強化を含むメジャー更新です。
ローカルLLMを自社やエッジで動かす企業にとって、今回の更新は実行ファイルを入れ替えるだけでは終わりません。llama.hを呼ぶアプリケーション、ggmlと接続する部品、RPCを使う構成、外部公開するサーバー設定まで確認対象になります。
本番環境は公式リリースのタグとビルド条件を固定し、追加機能は検証環境から段階的に導入する進め方が安全です。特にFP8 KVキャッシュは、調査日時点でMetalとVulkanの公式Issueに個別の不具合報告があります。
※本記事は2026年11月16日時点の情報です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
v1.0.0|非推奨APIを削除したメジャー更新
v1.0.0の変更を読むとき、最初に見るべきなのは新機能より互換性です。llama.cppでは、llama.hからllama_set_warmup、35個の非推奨関数、defrag_thold、--defrag-tholdが削除されました。
NextN APIはllama-ext.hからllama.hへ移され、llama_set_embd_state_srcはllama_set_ctx_state_srcに改名されています。自社のbindingやラッパーが古い宣言を参照していれば、コンパイル段階で修正が必要です。
同時に更新されたggml v1.0.0では、非推奨APIとレガシーのDIAG_MASK_INF、DIAG_MASK_ZERO演算が削除されました。RPCプロトコルもv9になり、互換性のないpeerを拒否する変更が入っています。
- アプリケーション:直接呼び出す関数名と構造体の差分を洗い出す。
- ビルド:C/C++ binding、共有ライブラリ、ヘッダーの組み合わせを固定する。
- ネットワーク:RPC protocol v9と接続相手のバージョンをそろえる。
ポイント
v1.0.0はAPIの安定化を目指す節目である一方、非推奨APIの削除を含むbreaking changeです。既存コードとRPC接続を先に棚卸しします。
リリース系列|vX.Y.Zとb[NUM]を分けて管理
llama.cppとggmlの公式リリースは、vX.Y.Zのセマンティックバージョニングで管理されます。一方、llama.cppにはmasterのコミットごとに作られるb[NUM]のnightly系列があります。
両者は同じ「最新版」ではありません。用途ごとに管理する必要があります。
nightlyは開発中のmasterと、その時点の内部ggmlコピーを含む系列です。公式リリースのv1.0.0はタグを起点にビルドするため、ソース、コンパイラ、backend、モデル、起動オプションを記録すれば、障害時に同じ構成へ戻しやすくなります。
| 系列 | 位置づけ | 企業での使い方 |
|---|---|---|
vX.Y.Z | 公式リリース。タグで固定できる | 本番候補。依存関係と回帰試験の基準にする |
b[NUM] | master由来のnightly | 新機能の先行評価。障害時の切り戻し先を別に持つ |
本番でnightlyを使う場合は、採用理由と固定するbuild番号を運用台帳に残します。更新を自動追随させると、API差分とbackend差分が同時に入り、原因の切り分けが難しくなるためです。
自社運用するモデルの選択肢を整理するときは、Mistral Large 4の自社運用のように、モデルの大きさだけでなく、実行環境と運用負荷を一緒に見る必要があります。
ポイント
本番はv1.0.0のようなタグ固定、検証はnightlyという役割分担にすると扱いやすくなります。build番号と依存するggmlの状態を、モデルやGPUの情報と一緒に保存します。
推論基盤|FP8 KVキャッシュとMoE cacheを追加
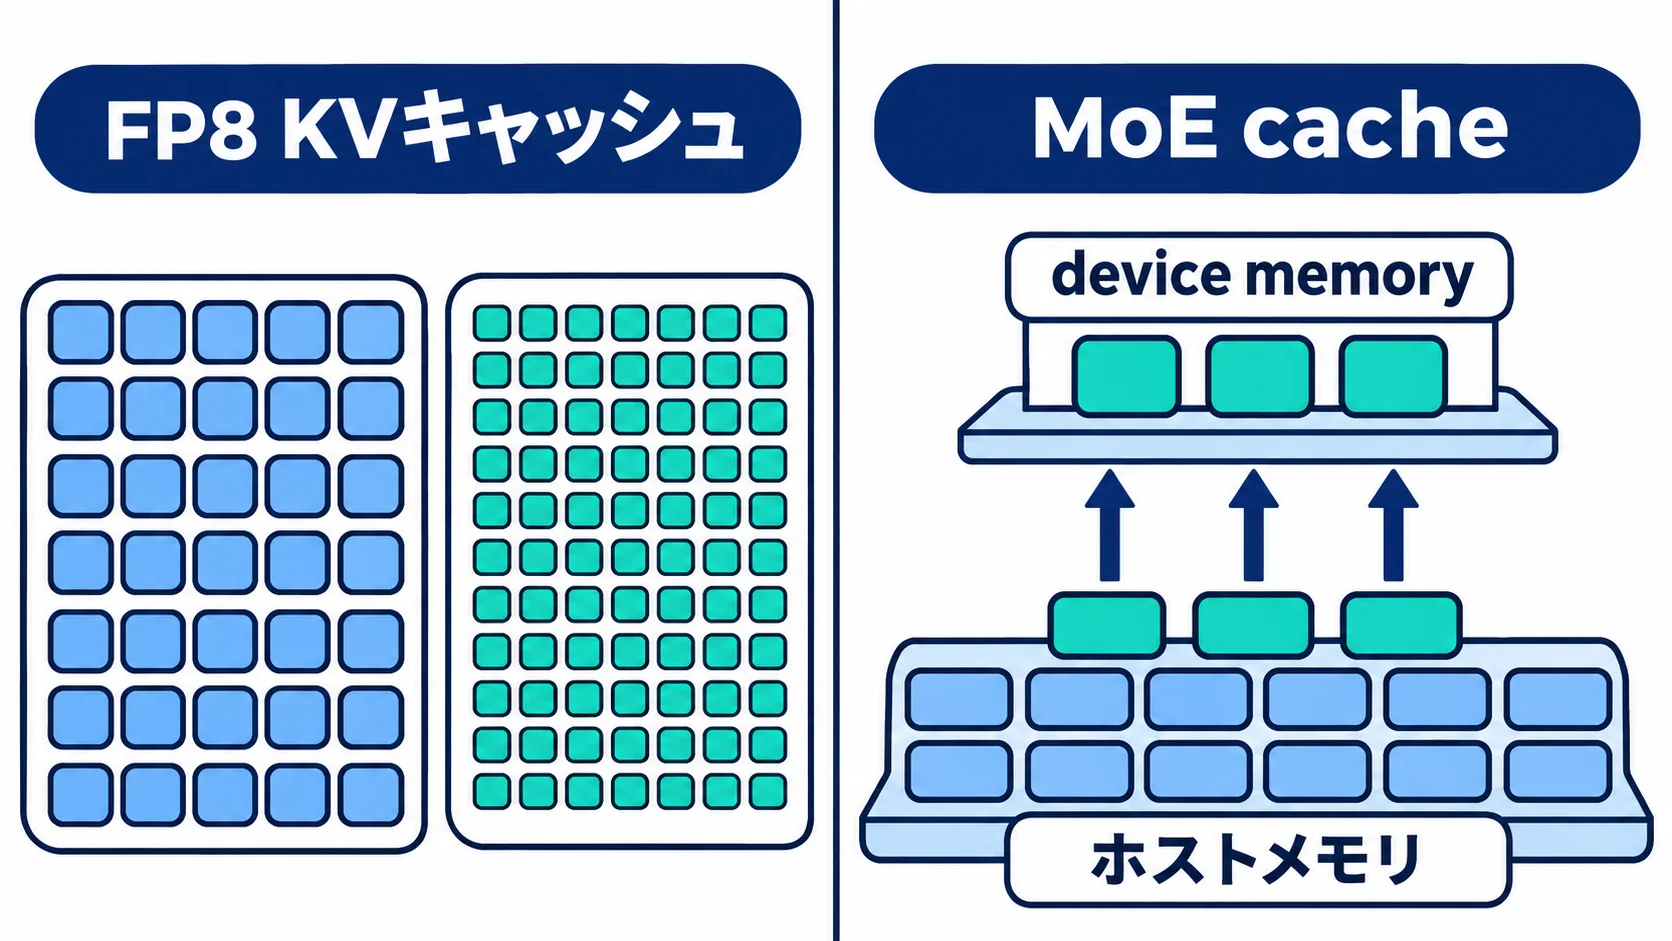
v1.0.0は、推論時のメモリ配置に関わる機能を追加しました。FP8 KVキャッシュは-ctk/-ctv f8_e4m3で指定し、必要に応じて静的なper-tensor scaleを使います。長いコンテキストを扱う環境では、KVキャッシュの型がメモリ使用量と速度の両方に影響します。
MoE cacheは、ホストメモリに置いたMoE expertのうち、よく使うexpertをdevice memoryへ保持する仕組みです。キャッシュミスの一部をCPUで計算する設定もあり、deviceへの転送とCPU計算のどちらが速いかを、メモリ帯域やPCIe接続を含めて測ることになります。
公式文書では、MoE cacheの容量を--moe-cache-mib N、キャッシュミスのCPU分担を--moe-cache-cpu-share Fで指定します。どちらも既定値は無効側です。外部PLE/engram shardの--shard、--ple読み込みも追加されています。
これらを一度に有効にすると、メモリ削減、推論速度、出力品質、backendの相性のどこで差が出たのか分かりません。まず既存のKV cache typeでv1.0.0を動かし、次にFP8、最後にMoE cacheという順で一つずつ測ると、採用可否を判断しやすくなります。
ポイント
FP8とMoE cacheは「追加されたから有効にする」機能ではありません。モデル、backend、GPUメモリ、同時実行数を固定した測定結果で、機能ごとに採用を決めます。
llama-server|SSRF・CORS・DNS rebindingへの対策を強化
llama-serverのv1.0.0では、CORSとDNS rebindingが修正されました。CORS proxyのSSRF対策も対象です。子インスタンスへの直接アクセスも修正対象です。HF_TOKENをhuggingface.coのホストに制限し、クライアント切断やタイムアウト時にはMCP tool callをキャンセルします。
サーバー文書には、ツールを非ループバックアドレスでAPI keyなしに使う--allow-unauthenticated-toolsが記載されています。ローカルまたはプライベートアドレスを指すメディアURLを許可する設定は--media-allow-private-urlsです。どちらも既定で有効になる機能ではなく、信頼できるネットワーク向けの明示的な選択です。
| 配置 | 基準となる設定 | 運用上の判断 |
|---|---|---|
| 同一マシン | 既定の127.0.0.1。agent有効時は--cors-origins localhost。 | 外部公開せずローカルUIから使う。 |
| 社内ネットワーク | フロントエンドのoriginを--cors-originsに指定。 | 接続元を限定し、認証とネットワーク境界を分けて管理する。 |
| 公開ネットワーク | --api-key、reverse proxy、必要最小限のCORS。 | サーバー単体を直接インターネットへ出さない。 |
通常の既定値では--cors-originsは*で、credentialsも有効です。ただし--toolsや--agentを使うと、セキュリティ上の既定値はlocalhostに変わります。
MCPの子プロセスは、サーバーと同じ権限で動作します。宣言するコマンドを絞り、実行環境も分離します。
MCPを社内のAI基盤に接続する場合は、MCPサーバーのセキュリティで扱われる認証や公開範囲の論点も同時に洗い出します。サーバーのCORS設定だけで、MCP側の権限設計まで代替できるわけではありません。
ポイント
外部公開では、bind address、API key、reverse proxy、CORS、tools/MCPの許可範囲を別々に決めます。--allow-unauthenticated-toolsと--media-allow-private-urlsは、公開環境で安易に有効化しません。
移行手順|既存APIとbackendを固定して段階検証
v1.0.0への移行は、機能を増やす作業と互換性を確かめる作業を分離します。まずは既存のモデル、KV cache type、サーバー起動オプションを変えずに、バイナリだけをタグ固定で置き換えます。
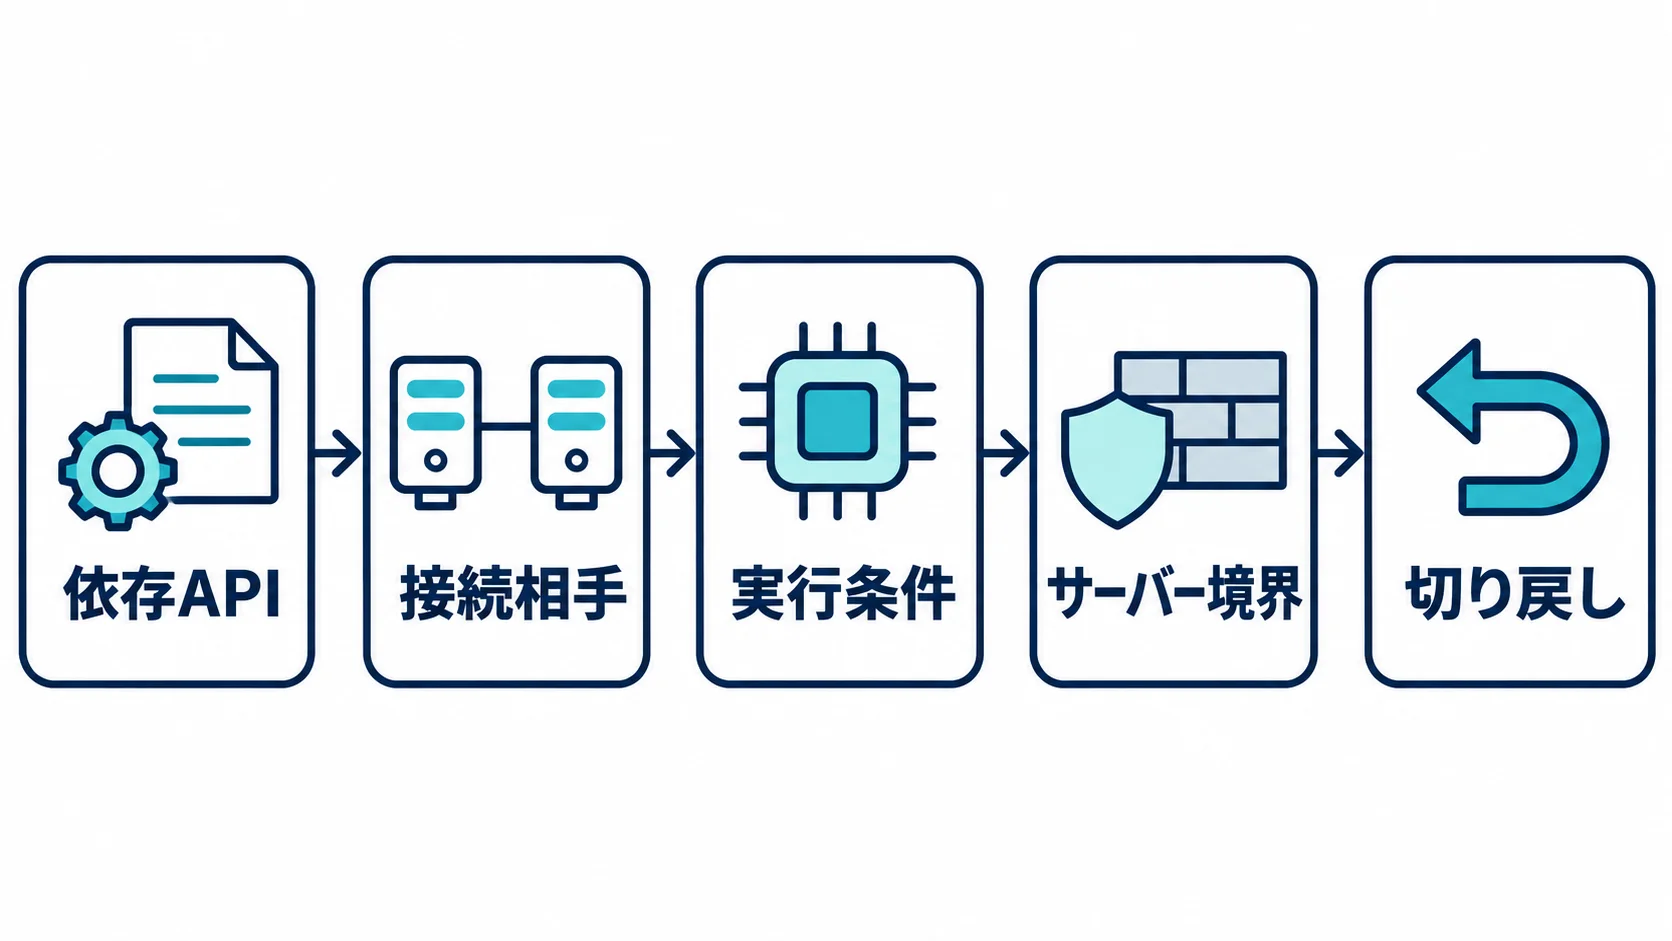
先に固定する5項目
切り替え前に、次の順番で差分を小さくします。
- 依存API:削除された関数、改名された関数、ヘッダーの参照を洗い出す。
- 接続相手:RPC protocol v9と、同時に更新できないpeerの有無を確認します。
- 実行条件:モデル、backend、ドライバー、GPUメモリ、コンテキスト長を記録します。
- サーバー境界:bind、API key、CORS、tools/MCP、reverse proxyを環境別に定義する。
- 切り戻し:旧バイナリ、旧設定、モデルファイルを再利用できる状態で保管する。
FP8 KVキャッシュは最後に評価します。2026年11月14日にはMetal backend、11月15日にはVulkan backendで公式Issueが開きました。両Issueは、-ctk/-ctv f8_e4m3でモデル読み込み中にllama-serverがabortする報告です。
報告された環境では、Metalは同じcommandからFP8の2オプションを外すと読み込み・実行できました。Vulkanではq4_0、q4_1、q8_0が動作しています。
このIssueは、FP8機能全体が使えないという意味ではありません。backendごとに結果が分かれるため、CPU・CUDA・Metal・Vulkanを一括で扱わないことが大切です。
自社の本番候補と同じbackendで、モデル読み込み、短い生成、長いコンテキスト、同時実行を順に試します。問題が出た場合は、既存のcache typeへ戻せるようにします。
運用開始後に追う項目は、起動オプション、モデル、GPU使用量、レイテンシー、エラー、切断されたMCP呼び出しです。可観測性や評価を含む運用設計は、AgentOpsの考え方と同じく、変更後の状態も追える仕組みにします。
ポイント
安全な移行の基準は、v1.0.0の新機能をすべて使うことではありません。既存処理を保った更新、backend別の回帰試験、明確な切り戻し条件を満たしてから、FP8やMoE cacheを追加します。
よくある質問
Q. llama.cpp v1.0.0は何が変わりましたか?
主な変更は4点です。非推奨APIを削除し、FP8 KVキャッシュとMoE cache、llama-serverのセキュリティ強化、ggml v1.0.0への更新が行われました。
Q. v1.0.0とnightlyはどう使い分けますか?
v1.0.0はタグとビルドを固定した本番候補、b[NUM]は新機能の先行評価に使います。
Q. FP8 KVキャッシュはすぐ有効にできますか?
すぐに本番で有効にせず、モデルとbackendを固定した検証環境で動作と性能を測る方針です。
Q. llama-serverを外部公開するとき何を確認しますか?
公開環境ではAPI keyが必要です。公開範囲をCORSとreverse proxyで絞り、toolsやMCPは必要なものだけにします。API keyなしのtoolsは許可しません。
まとめ
llama.cpp v1.0.0は、API削除、RPC protocol v9、FP8 KVキャッシュ、MoE cache、llama-serverの強化を含む更新です。ggml v1.0.0も同時に更新され、既存のbindingや接続相手には変更が及びます。
企業の更新方針は、公式タグを固定した最小変更から始めると決めやすくなります。APIとRPCを点検し、サーバーの公開範囲を環境別に制限したうえで、FP8やMoE cacheをbackendごとに追加評価してください。
ポイント
v1.0.0への移行は、API互換性、backend別の動作、llama-serverの公開設定を別々に評価します。新機能を急いで本番へ持ち込まず、測定結果と切り戻し条件をそろえてから段階的に更新します。
関連記事
- Mistral Large 4を解説|1兆パラメータのオープンウェイトモデルと自社運用の選択肢
- 中国製オープンウェイトAIを解説|特徴とモデル選定のポイント
- MCPサーバーのセキュリティ実態を解説|21000台超が露出・92%認証なしの点検ポイント
- AgentOpsを解説|AIエージェントの可観測性・評価・監視のポイント
- Claudeのサンドボックス脱出事例を解説|AIエージェントの封じ込めと供給網リスク
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
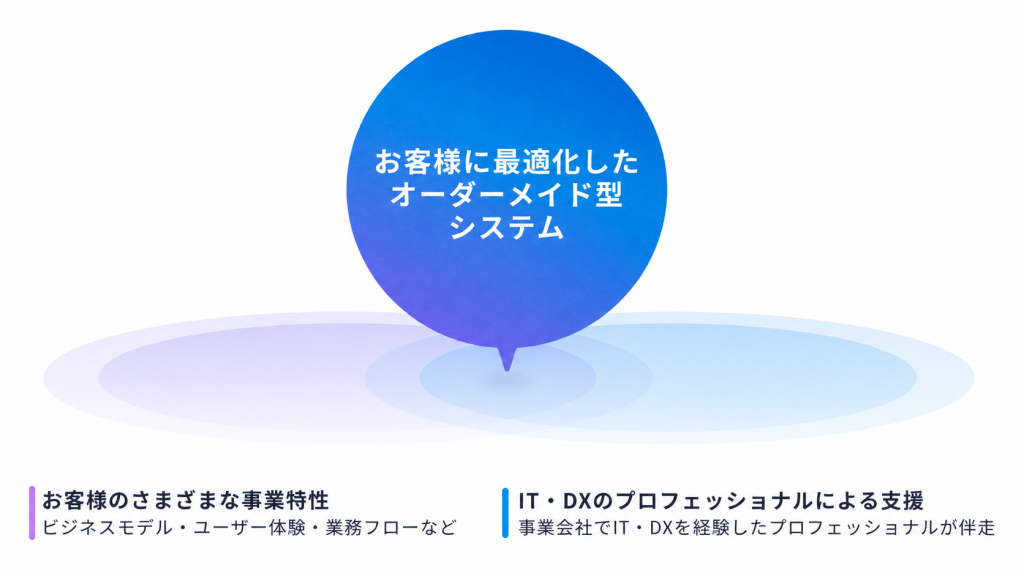
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。
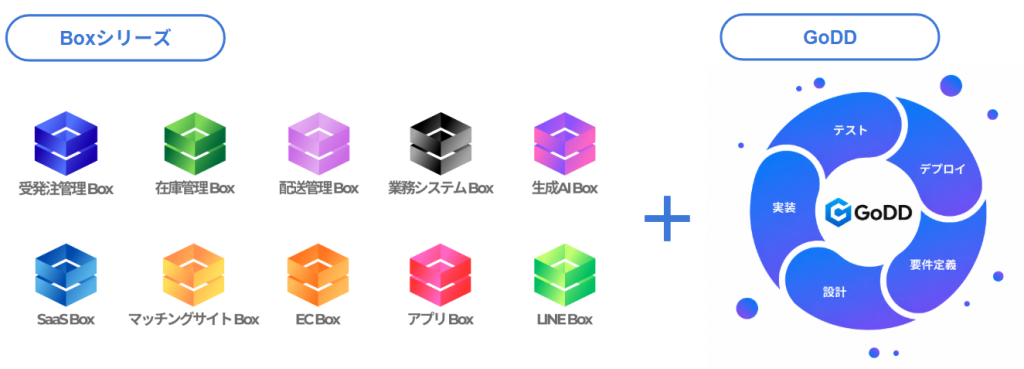
また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。
もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>
株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。