
受発注AIエージェントの導入は、業務の棚卸しとKPI設計から運用定着まで、5つのステップで進めます。
背景には、EDIや受発注システムを運用している企業でも、約3割の業務で「手作業が80%以上」残っているとの指摘があります。全体像は以下の完全ガイドで解説しています。
▼全体ガイドの記事
・受発注AIエージェント開発・構築の完全ガイド
- 現場の業務課題を整理する
- 全体像を把握する
- 導入手順と進め方を確認する
AIシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
受発注業務が抱える課題とAIエージェントが生まれた背景
受発注業務の自動化は、長年の課題でした。OCRによる文字認識やRPAによる定型処理は一定の効果を上げてきました。ただし、どちらも例外処理に弱いという限界を抱えていました。
実際、取引先がフォーマットを少し変えただけでエラーが起き、結局は人が手入力する状況が続いてきました。
RPAとOCRが越えられなかった「例外処理の壁」
従来のRPAは、事前に決めた厳格なルールに従って動くため、取引先のレイアウトが変わったり表記が揺れたりした時点でエラーになり、人の介入が必要になります。
OCRは文字を読み取る精度こそ上がりましたが、読み取った後のコード判定やデータ補正は、依然として人の査読と手入力に頼っていました。
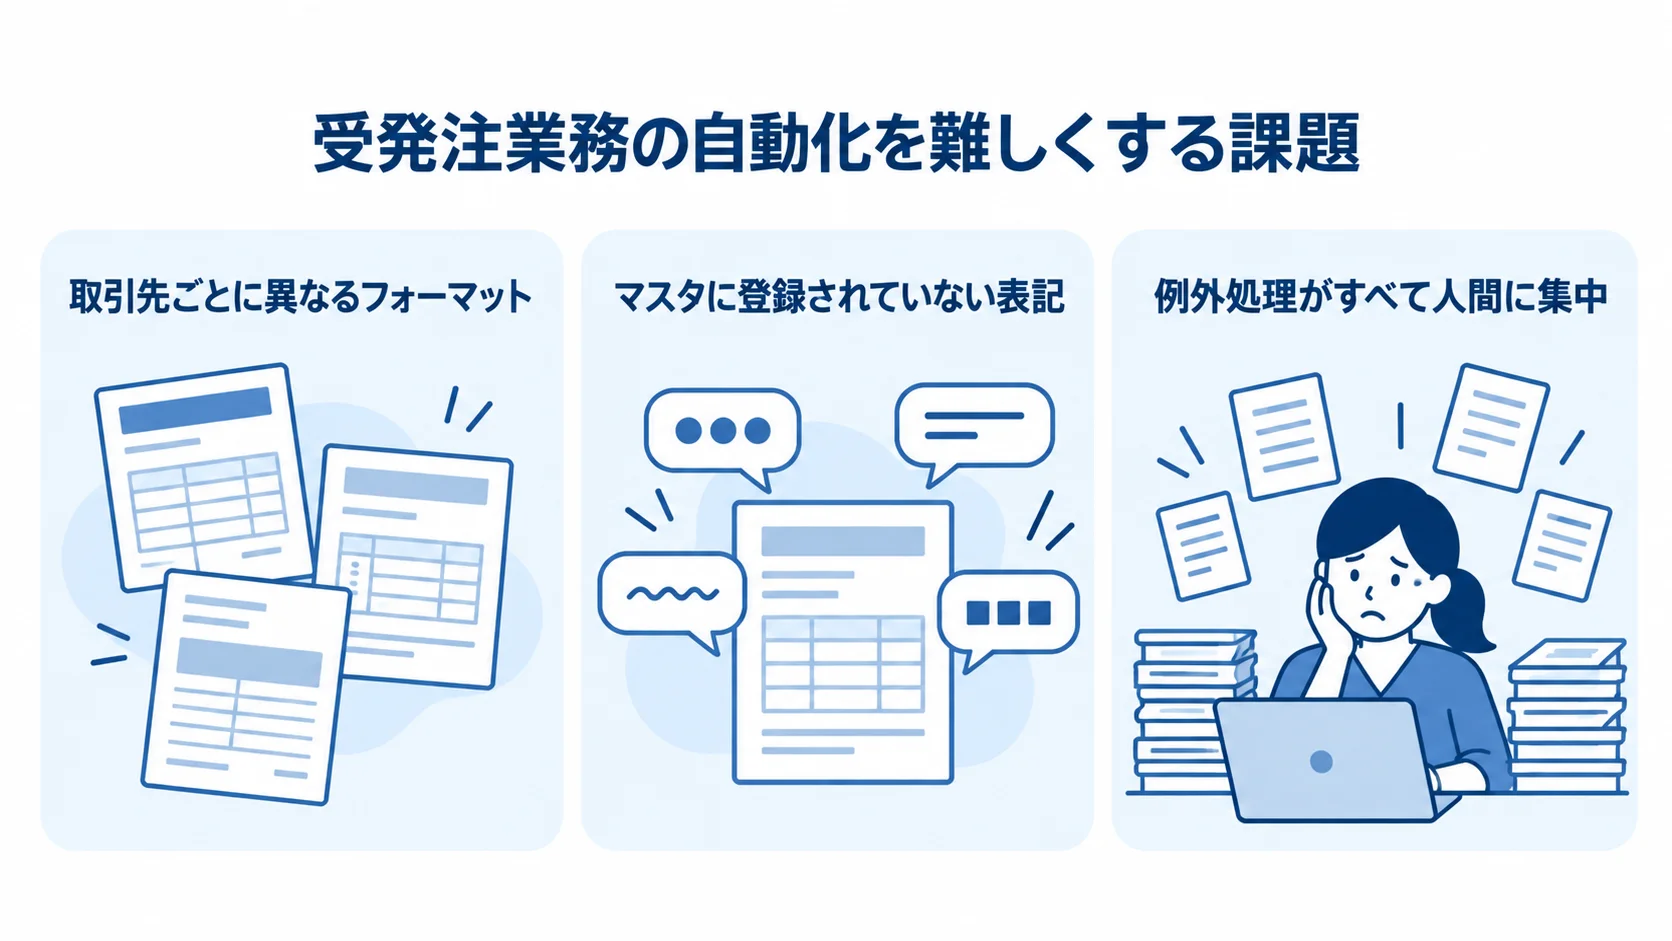
従来の方式が抱える課題を整理すると、主に次の3点に集約されます。
- 取引先ごとに異なるフォーマット(PDF・Excel・FAX・メール)への対応
- 商品の略称や旧品番など、マスタに登録されていない表記への対応
- 判断に迷うケースの例外処理がすべて人間に集中してしまう構造
LLMとAIエージェントによる業務の変化
2025年以降、大規模言語モデル(LLM)を活用した「AIエージェント」の実務への適用が急速に進んでいます。AIエージェントは、マスタデータや過去の受注履歴を参照しながら自律的に考えて判断し、複雑な業務プロセスを最初から最後まで完結させる力を持ちます。
従来のRPAがルールに基づいて動くのに対し、AIエージェントはLLMによる文脈の理解と状況への適応によって判断します。たとえば、AIは「3月15日にいつもの商品Aを50個、急ぎで頼む」というメール本文からも、日付・商品候補・数量を正確に対応づけられます。これにより、人は手入力から離れ、AIが作成したデータを確認・承認する管理業務へと役割が移っていきます。
受発注AIエージェント導入の5ステップ全体像
受発注AIエージェントの導入を成功させるには、一度ツールを入れて終わりにせず、計画に沿って順に進めることが欠かせません。
ステップ1:業務の棚卸しとKPI設計
最初に、現在人が担当している受発注業務をすべて洗い出し、かかっている時間(工数)やミス率、取引先ごとの受注チャネルの特性を一覧にします。そのうえで、自動化の優先順位(ROIインパクト)を決め、目標値となるKPI(重要業績評価指標)を明確にします。
KPIの代表例は、次のとおりです。
・受注入力の処理時間は、現状比でどれだけ短縮するかを見ます。
・入力エラー率は、AI自動処理の精度目標(例:95%以上)を基準に測ります。
・例外処理の件数は、人間の介入が必要なケースの割合で把握します。
この段階の業務分析が不十分だと、後の要件定義や開発で手戻りが起きやすくなります。そのため、現場の担当者への丁寧なヒアリングと、実際の受注データのサンプル収集が欠かせません。
ステップ2:データ整備とシステム連携環境の確認
AIエージェントは、マスタデータや過去の受注履歴を参照して判断するため、データの品質がそのまま精度を左右します。商品マスタの表記統一、取引先ごとの略称・通称の対応表の整備、過去の注文データの整理が、この段階の中心的な作業です。
特に重要なのが、AIが「カンニング」できるルールブックの整備です。RAG(検索拡張生成)を使うAIエージェントは、自社の取引先マスタや商品データベース、過去の注文実績をリアルタイムで参照して判断します。社内に蓄積された暗黙知(「A社は締め日が特殊」「特定商品の略称対応表」など)を文書にまとめ、データベース化しておくと、AIの精度を高めやすくなります。
既存の販売管理システムやERPとのAPI連携が可能かどうかも、この段階で確認しておきます。
要件定義とPoC(概念実証)の進め方
業務の棚卸しとデータ整備が終わったら、いよいよ要件定義に入ります。この段階では、自社で開発するか、パッケージやSaaSを導入するかの方針も決めます。要件定義の質は開発の成否を大きく左右するため、現場の担当者と開発チームが密に連携して進めることが重要です。
SaaS型と独自開発型の選択基準
受発注AIエージェントの導入形態には、大きく「SaaS型(パッケージ)」と「独自開発型(スクラッチ)」の2種類があります。それぞれの特徴を理解したうえで、自社の要件に合う方式を選ぶことが大切です。
SaaS型は、初期導入費用が比較的低く、実績のある機能をすぐに使えるのが強みです。一般的な初期導入費用は0〜50万円程度、月額の基本料金は中小企業向けで月額5万〜30万円程度とされています。
一方、独自開発型は、自社特有の業務フローや他システムとの高度な連携が必要な場合に適しており、要件定義から本番稼働まで数百万〜数千万円規模の費用が見込まれます。スピードと初期コストを重視するならSaaS型、自社固有の商習慣への対応やセキュリティ要件が厳しい場合は独自開発型が選択肢になります。
スモールスタートと短周期PoCの実施方法
いきなり全業務をAIエージェントに移すと、例外処理が一気に増えて現場が混乱するおそれがあります。そのため、特定の取引先や一部の帳票レイアウトだけを対象に「スモールスタート」することが推奨されています。
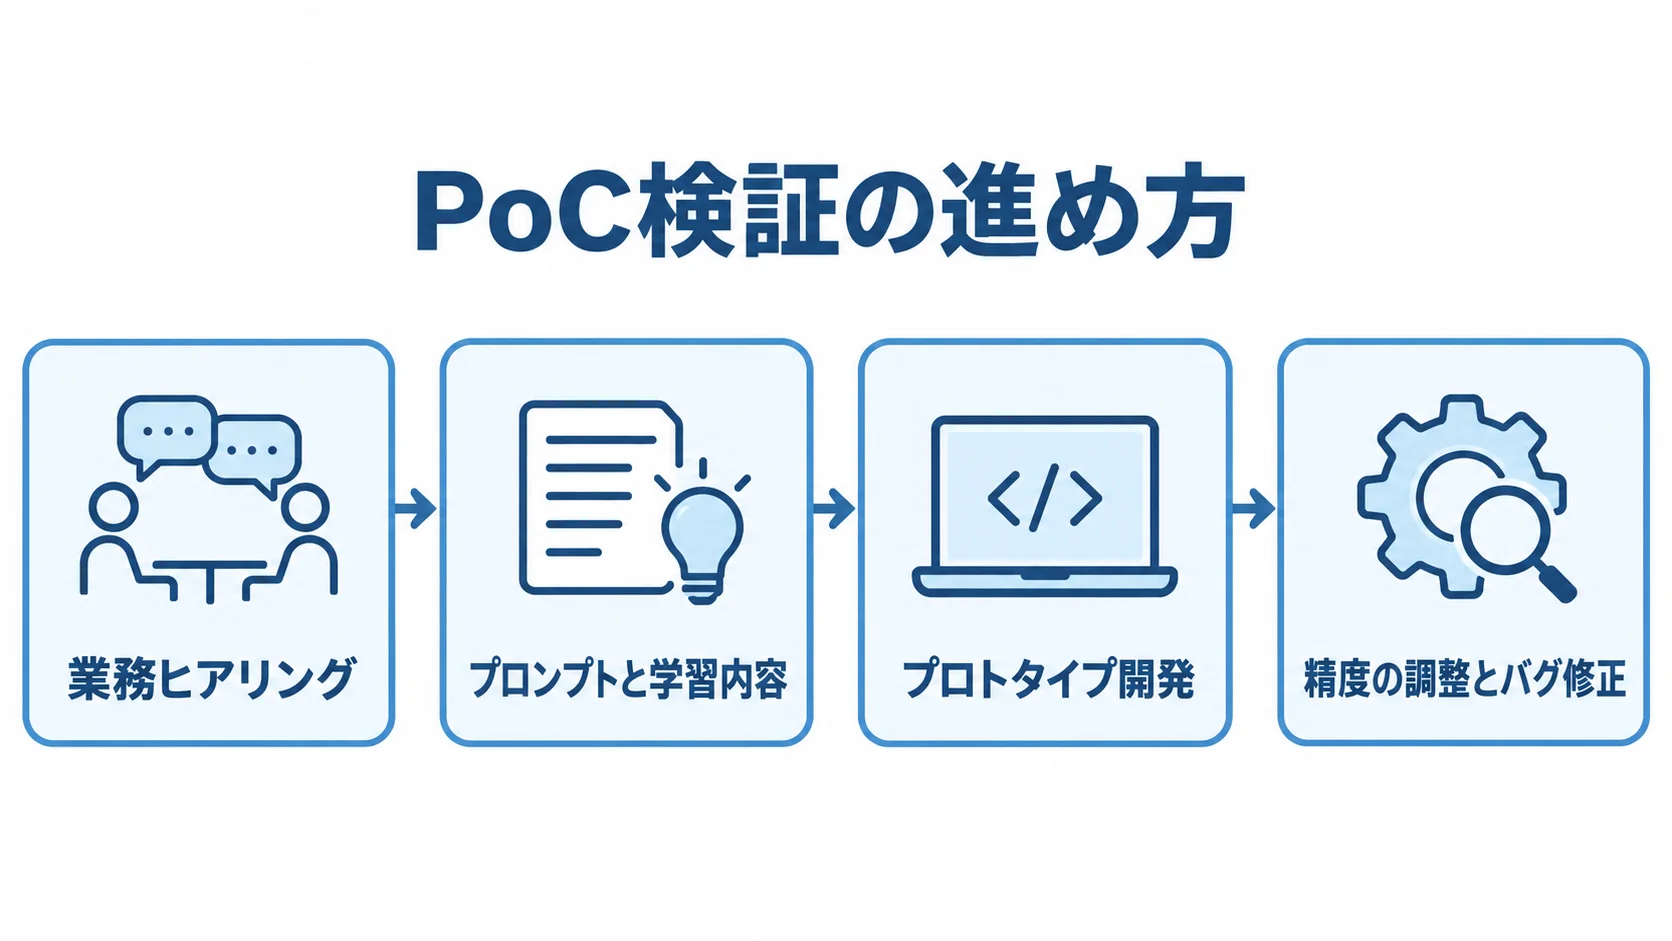
実際のPoC検証は、約2ヶ月のスケジュールで進めるのが一般的です。1ヶ月目は、現場担当者への業務ヒアリングを行い、AIエージェントのプロンプトと学習内容を確定させ、プロトタイプを開発します。
2ヶ月目は、AIが実際に出力したデータ(商品候補・得意先特定など)と人の判断との差異を比較検証し、精度の調整とバグ修正を繰り返して、本稼働に向けて精度を引き上げます。このPoC期間中に、目標KPIの達成見込みを数値で確認しておくことが、本開発に進む判断の根拠になります。
本開発・既存システム連携の進め方
PoCで精度が確認できたら、本番環境への開発と実装に進みます。このフェーズの主な作業は、AIエージェントのコア機能の開発と既存システムとの連携です。プロジェクト管理と技術的な難所を把握しておくと、開発をスムーズに進められます。
AIエージェントコア開発と検証ロジックの構築
本開発では、LLMによるデータ解析、RAGを使った社内マスタの参照、自動検証ロジックの実装が中心になります。取引先から届いた非構造化データを構造化JSONに変換したあと、AIエージェントは複数の検証プロセスを順に実行します。
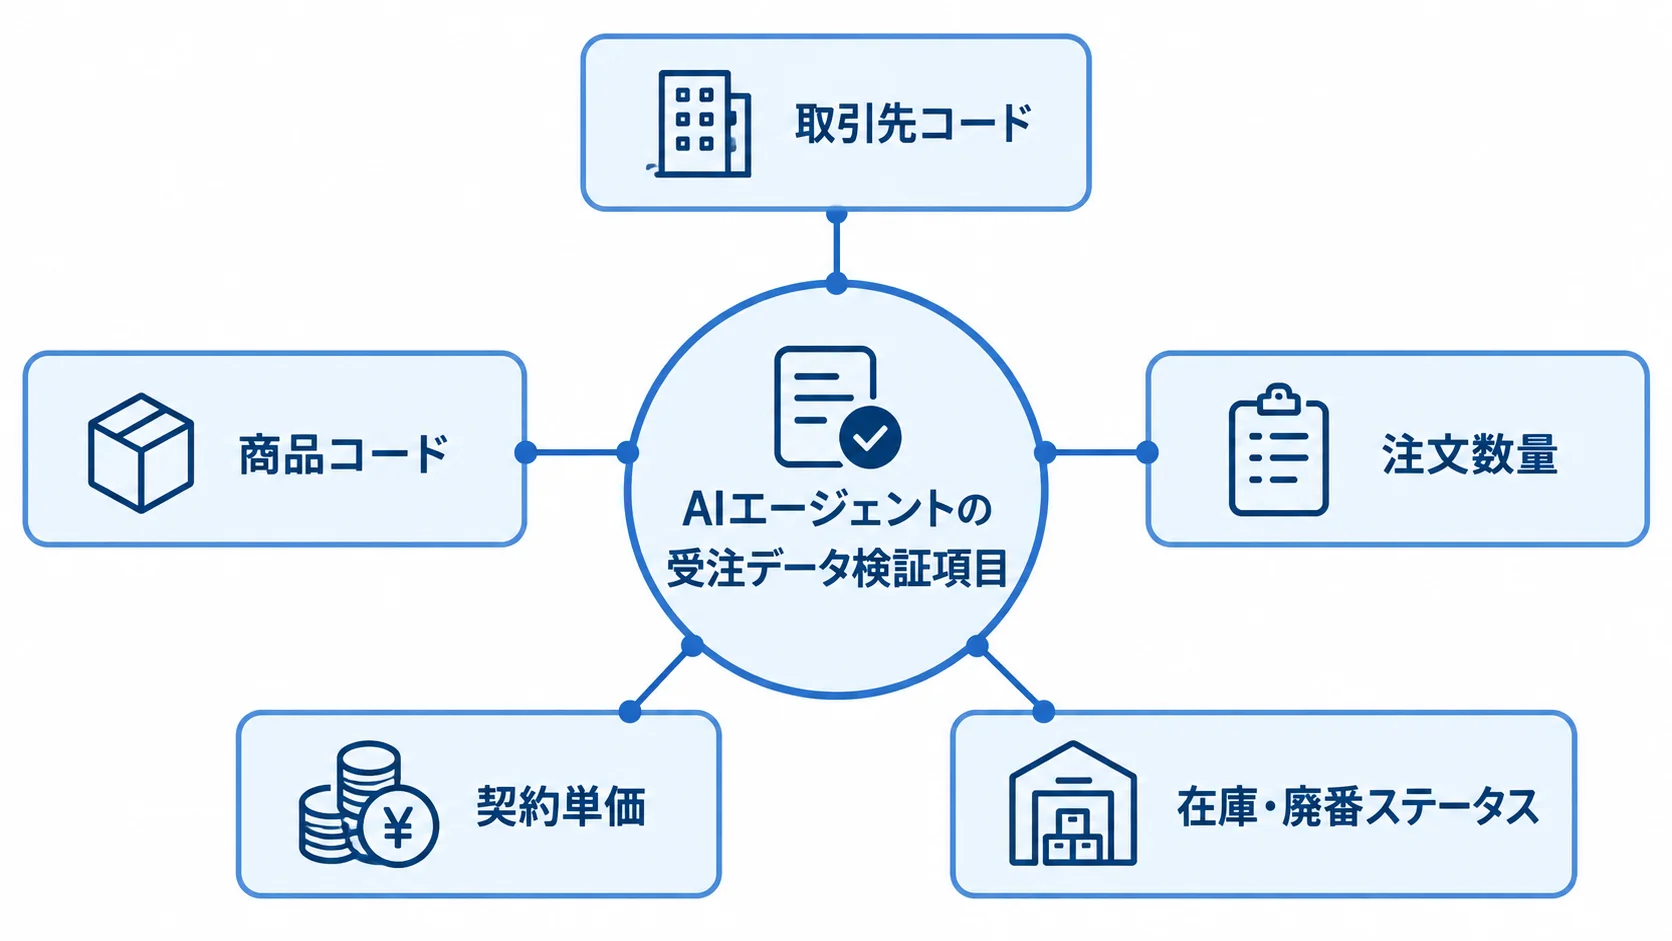
検証プロセスで主に確認する項目は、次の5つです。
・取引先コードは、略称や旧社名から正しい顧客コードへのマッピングで特定します。
・商品コードは、商品の通称・略称からのマスタ照合で割り出します。
・注文数量は、過去の注文量との乖離(アノマリー)を検知して判定します。
・契約単価との照合では、記載単価と登録済みの契約単価が一致するかを見ます。
・在庫・廃番ステータスを確認し、代替商品を自動で提案します。
AIの確信度が一定の閾値(例:95%)を下回る場合は、人のチェックを仰ぐタスクリストに入れます。AIは判断の根拠とエラー箇所を明記したうえで、人に引き渡します。
販売管理・ERPシステムとの連携実装
検証を通過したデータは、APIまたは自動ファイル連携の機能を通じて、既存の販売管理システムや基幹システム(ERP)へ自動で登録されます。「OBIC7」「SMILE」「アラジンオフィス」といった主要な販売管理システムとの連携実績があるベンダーに依頼すると、開発コストと期間の短縮につながります。
連携方式は、大きく2つあります。ひとつは、APIを使ったリアルタイム連携です。在庫や受注の状況を既存システムにリアルタイムで反映できる一方、既存システム側のAPI仕様の確認と認証設定に工数がかかります。
もうひとつは、CSVなどのファイルを介したバッチ連携です。シンプルで安定していますが、処理にタイムラグが生じます。既存システムの仕様と業務上の要件を照らし合わせて、適切な方式を選びます。
運用定着と継続的な精度改善の進め方
本番稼働を開始した後も、AIエージェントの精度を保ち、高めていく取り組みが欠かせません。初期運用では想定外の例外ケースが起きることがあるため、運用体制と改善の流れを整えておくことが、長期的な成功につながります。
人間とAIの役割分担と運用体制の設計
AIエージェントの稼働後、人の役割は「手入力・データ整形」から「AIの判断結果を確認・承認する管理業務」へと変わります。そのため、現場がこの変化を受け入れられるよう、運用体制の設計と社内教育が欠かせません。
具体的には、AI処理件数や自動処理率を日次または週次で追う担当者を置くことが推奨されます。自動処理率やエラー率も、あわせて確認します。例外件数が増えている場合は、新しい取引先フォーマットの追加や商品マスタの未登録データが原因になっていることが多く、迅速な対応が精度の維持に直結します。
AIエージェントが「なぜその判断を下したか」を担当者が把握できるよう、判断根拠のログを記録し、参照できる仕組みを整えておくことが重要です。
プロンプト最適化とRAGデータの継続更新
AIエージェントの判断精度を高めるため、新しい例外ルールをRAGの参照データやプロンプトに追加・更新し続けます。取引先が新しい注文フォーマットを使い始めた場合や、商品が廃番になったり新規に登録されたりした場合は、対応する学習データやルールブックを速やかに更新します。
運用保守の費用は、構成の規模によって月額40万〜200万円程度が見込まれます(サーバー等のクラウドインフラの維持費、障害監視、定例のチューニング費用を含む)。定期的にレビューの場を設け、KPIの達成状況を確認しながら改善を続けることが、受発注AIエージェントを長期的に活用するための前提になります。
よくある失敗パターンと回避策
受発注AIエージェントの導入では、技術面の課題のほかに、計画や運用面の落とし穴によって期待した成果が得られないケースがあります。典型的な失敗パターンを知っておくと、事前に対策を講じられます。
データ品質の軽視とマスタ整備不足
「AIを導入すれば何とかなる」という期待から、データ整備を後回しにするケースがよく見られます。しかし、AIエージェントの判断精度は、参照するマスタデータや過去の受注データの質に直接左右されます。商品コードの表記が統一されていない、取引先の略称対応表がない、過去データに誤りが多いといった状態では、高性能なAIを使っても精度は上がりません。
回避策として、PoCを開始する前に、商品マスタの表記統一と取引先の略称対応表の整備を優先します。特に、過去の受注データのうち一定期間分をサンプリングしてAIに読み込ませ、精度を検証してからPoC本番に進む手順が有効です。データ整備の工数は見落とされやすいため、プロジェクト計画の段階で十分な時間を確保することが重要です。
一括移行による現場混乱と段階的導入の重要性
全業務を一度にAIエージェントへ切り替える「ビッグバン型」の移行では、想定外の例外処理が大量に発生し、現場が混乱するおそれがあります。AIの判断エラーが業務に影響すると、現場からの信頼を失い、プロジェクト全体が頓挫することも少なくありません。
段階的な導入が基本原則です。まず、特定の取引先(注文量が多く、フォーマットが比較的安定している先)を対象に試験運用を始め、精度と運用上の課題を確かめます。その後、対象の範囲を徐々に広げることで、現場への影響を抑えながら移行を進められます。
人が確認・承認する仕組みを残したまま自動化の割合を段階的に高めていくことが、現場の受け入れと精度向上の両立につながります。
投資対効果(ROI)の考え方と費用計画
受発注AIエージェントの導入には、要件定義から運用保守まで、継続的な費用がかかります。そのため、初期投資と期待できる効果を数値で把握し、経営層の承認を得られるよう、説得力のある費用計画を立てることが欠かせません。
工程別の費用相場と予算化のポイント
フルスクラッチで開発する場合は、工程ごとに費用がかかります。コンサルティング・要件定義は40万〜200万円、PoC(概念実証)は100万〜500万円です。AIモデルの本開発と既存システム連携は人月の規模に応じて費用が決まり、運用保守は月額40万〜200万円程度が見込まれます。
SaaS型を選ぶ場合は、初期導入費用が0〜50万円程度で、月額の基本料金は規模によって月額5万〜100万円超と幅があります。また、国や自治体のIT投資支援補助金(IT導入補助金、ものづくり補助金、省力化投資補助金など)を活用すると、実質的な自己負担を大幅に抑えられる可能性があります。補助率や上限額は制度によって異なるため、導入計画の段階で確認しておくことをお勧めします。
ROI算出と投資回収期間の見積もり方
ROIを算出する基本的な考え方は、「年間の人件費削減額」から「年間のシステム維持・運用コスト」を引いた額を、「初期投資の実質自己負担額」で割ることです。受発注業務で削減できる工数に、担当者の時間あたりの人件費を掛けた年間の削減人件費が、投資回収の主な源泉になります。
たとえば食品商社の事例では、RPAと受注AIエージェントを組み合わせることで、年間数千時間規模の削減効果が報告されています。さらに、受注業務の自動化によって、担当者は取引先への提案や問題解決対応といった付加価値の高い業務に時間を充てられるようになります。こうした定性的な効果も、長期的な競争力の向上につながります。
初期計画では達成が難しく見えたROIも、段階的な拡大展開と継続的な精度改善によって実現できるケースが多くあります。
まとめ:受発注AIエージェント導入の成功の基本
受発注AIエージェントの導入は、業務の棚卸しとKPI設計から始め、データ整備、要件定義・PoC、本開発、運用定着の5つのステップを順に踏むことが成功の基本です。各ステップで何を決め、何を確認するかを事前に押さえておくと、プロジェクトのリスクを大きく減らせます。
特に重要なのは、PoCでのスモールスタートとデータ品質の確保です。どれほど高性能なAIエージェントを導入しても、参照するマスタデータが整っていなければ、精度は上がりません。
また、一括移行ではなく、対象範囲を段階的に広げる進め方が、現場の受け入れと品質向上の両立につながります。本番稼働後も、プロンプトを見直し、RAGのデータを更新し続けて、自社の受発注業務に合わせてAIエージェントを育てていく視点が求められます。
▼全体ガイドの記事
・受発注AIエージェント開発・構築の完全ガイド
関連する活用事例や進め方は、次の記事で確認できます。
- 受発注のAIエージェント活用事例|発注・受注処理を自動化する実例
- 受発注AIエージェント開発に強い開発会社・ベンダー6選|選び方も解説
- 受発注AIエージェント開発の費用相場|見積もり内訳とコストを抑えるコツ
▼RFP作成前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。