
受発注業務へのAI活用は、現状を把握し、活用領域を選び、PoCで試してから本格導入して現場に定着させる流れで進めます。
FAXや手書き帳票の手入力など、人手に頼る受発注業務は多くの企業に残っています。労働力不足が進むなか、こうした業務をそのまま続けることは、企業の成長を阻むリスクです。
▼RFP作成前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
受発注のAI活用の全体像は、次の完全ガイドで体系的に解説しています。
AIシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
受発注でAI活用が注目される背景
受発注業務は、多くの産業でサプライチェーンの中心的な役割を担っています。ただ、実態はいまだアナログな作業基盤に頼る企業が少なくありません。労働力不足や業務効率化の要請が高まるなかで、AIによる受発注の自動化・高度化に注目が集まっています。
アナログ依存が生む構造的な課題
流通・製造・物流などの分野では、受発注管理が長年にわたり「経験と勘」と紙帳票・FAXを中心としたアナログな基盤に頼ってきました。こうした基盤では、手入力による手戻りや伝票の読み違い、数量の打ち間違いといったヒューマンエラーが起きがちです。これらは誤発注や誤配送に直結し、取引先との信頼関係を損なうリスクを常に抱えています。
また、取引先ごとに異なるデータフォーマットに合わせる手作業も、担当者の業務負担を大きく押し上げています。特に月末・期末など注文が集中する時期には、残業が慢性化し、ミスが増えるという悪循環も生じがちです。こうした課題は個社の問題にとどまらず、産業全体の持続可能性を揺るがす構造的な問題です。
EDIとAI融合による技術進化
電子データ交換(EDI)の普及は、データを一か所で管理できる仕組みや24時間稼働を可能にし、受発注業務の信頼性向上に大きく貢献してきました。しかし、従来のEDIには、新規取引先との接続構築に数週間〜数ヶ月を要するという導入の壁がありました。
現在、このEDIとAIを融合させた技術進化が3段階で進んでいます。第一段階は、自然言語処理(NLP)と機械学習を活用したEDIのセルフサービス化です。この段階では、接続経路の自動構築やデータ構造の動的マッピングが可能になります。
第二段階では、不規則な大量発注や急激な配送条件の変動といった例外処理を、AIが自律的に検出し、適切な対応をオペレーターに提示します。さらに第三段階は、マルチエージェント型AIによる高度な意思決定の代行です。在庫不足時の代替品選定や緊急発注ルートの自動選択が、現実味を帯びてきています。
受発注業務でAIを活用できる領域
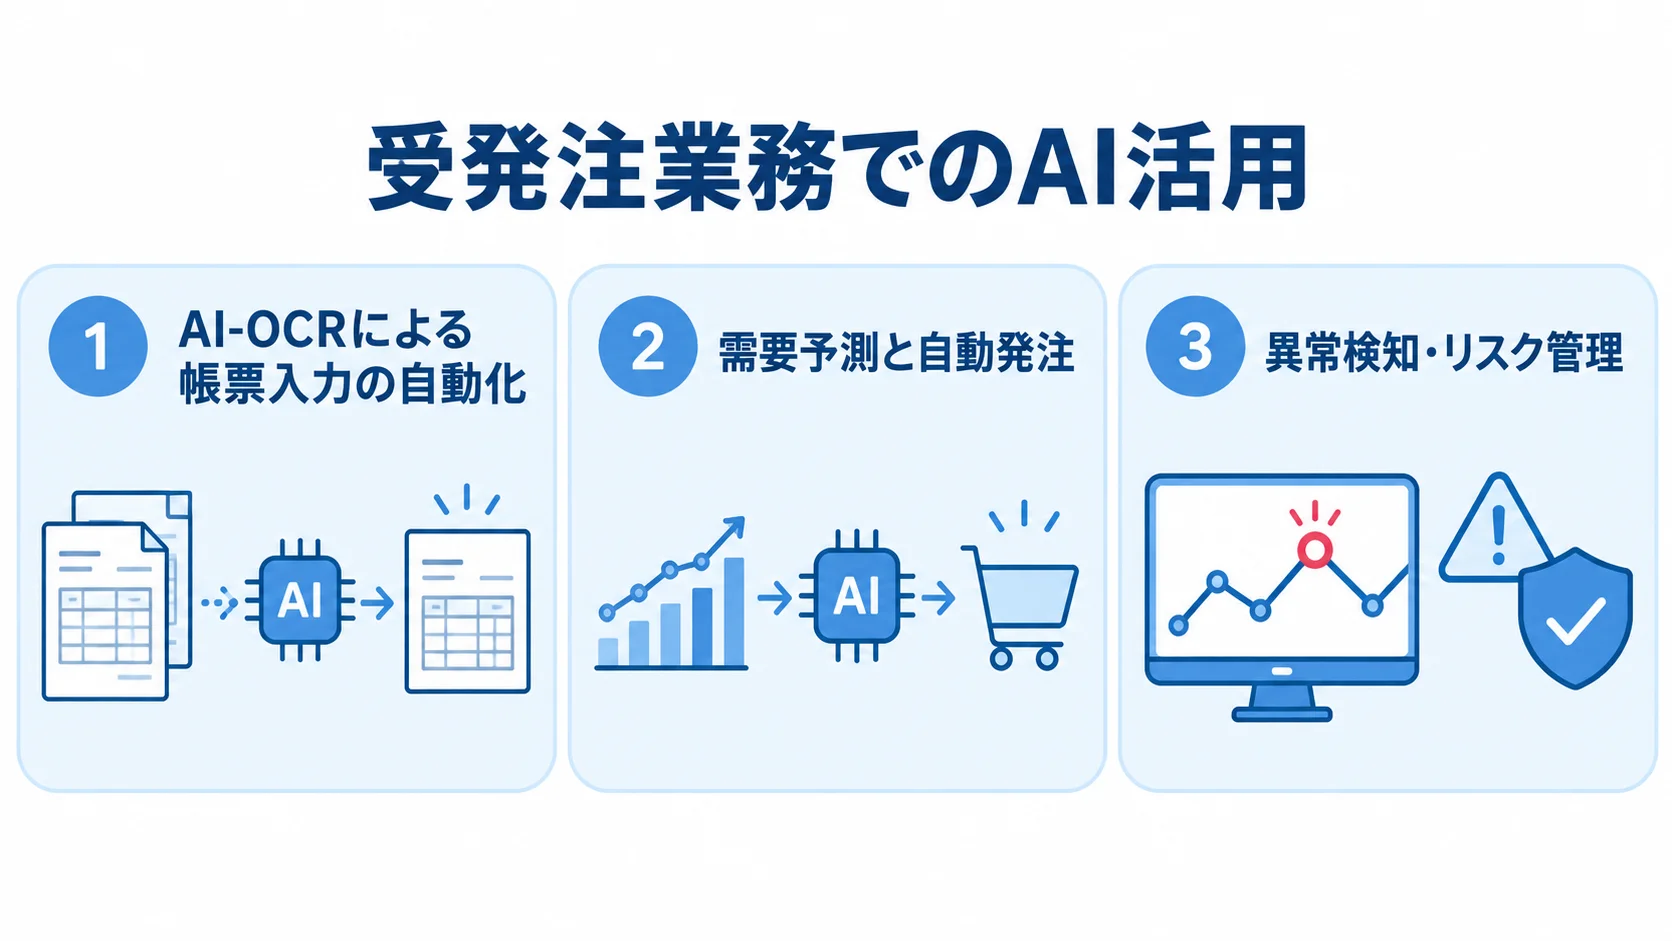
受発注業務でのAI活用は、入力の自動化から需要予測、リスク管理まで幅広い領域に及びます。自社のどこから手をつけるかを決めるには、まず全体の活用領域を把握しておくことが欠かせません。
AI-OCRによる帳票入力の自動化
取引先ごとにレイアウトが異なるFAXやPDF帳票は、RPAだけでは対応が難しく、自動化の進みにくい領域でした。これに対して、近年台頭している「ノンセッティング型AI-OCR」は、フォーマットを利用者側で設定しなくても、さまざまな非定型帳票を自動で解釈・構造化し、データに変換します。
高度なAI-OCRは、画像認識でFAXの紙の傾きを補正し、かすれた手書き文字も補ったうえで、基幹システムのマスタと照合して正しい商品コードを導き出します。これにより、担当者の作業は、AIが出力した最終データを確認し、承認することが中心になります。
物流業における導入事例では、手作業で1時間以上かかっていた受注・出荷指示情報のシステム登録を、わずか15分に短縮(約80%削減)した実績が報告されています。
需要予測と自動発注
在庫管理では、「欠品による販売機会の損失」と「過剰在庫による保管コストの膨張」が、長年のトレードオフ課題となってきました。AIを使った需要予測では、過去の販売データや在庫履歴に加え、天候・気温変動、カレンダー要因・イベント情報、競合他社の価格動向といった多角的な外部データを使います。
これらのデータを、ARIMA、ランダムフォレスト、LSTMなどの機械学習アルゴリズムで相関分析します。これにより、商品ごとの需要予測カーブを描き出し、適正在庫数と発注推奨値を毎日自動で再計算・更新します。
大手スーパーマーケットチェーンが全店舗に自動発注システムを導入した事例では、在庫量を平均約30%削減し、発注作業時間も約50%削減したことが報告されています。また、食品卸や飲食チェーンでも同様の取り組みが広がっており、自動発注AIによって年間数千〜数万時間規模の業務工数削減が実現されつつあります。
異常検知・リスク管理への活用
商品コードの入力桁ズレや、数量の桁間違い(例:10箱のつもりが100箱・1,000箱と入力されるケース)による大量の誤発注は、食品・医薬品卸などの現場で日常的に起きていました。AIの異常検知システムは、取引先ごとの過去の最大受注・発注パターンや曜日別の変動レンジを機械学習します。
基準値を大幅に超える注文が入力されると、アラートを出したり、一時保留にしたりする仕組みを備えています。こうした仕組みを使うと、誤発注に起因する返品対応コスト、緊急配送の手配コスト、返品廃棄コストを大きく抑えられます。
ある食品卸売業では、年間の返品対応コストを1,500万円以上削減した事例が報告されています。また、ECにおける動的競合価格追従AIも、需要や在庫と連動した受発注管理の精度向上に貢献しています。
受発注AI活用の導入ステップ
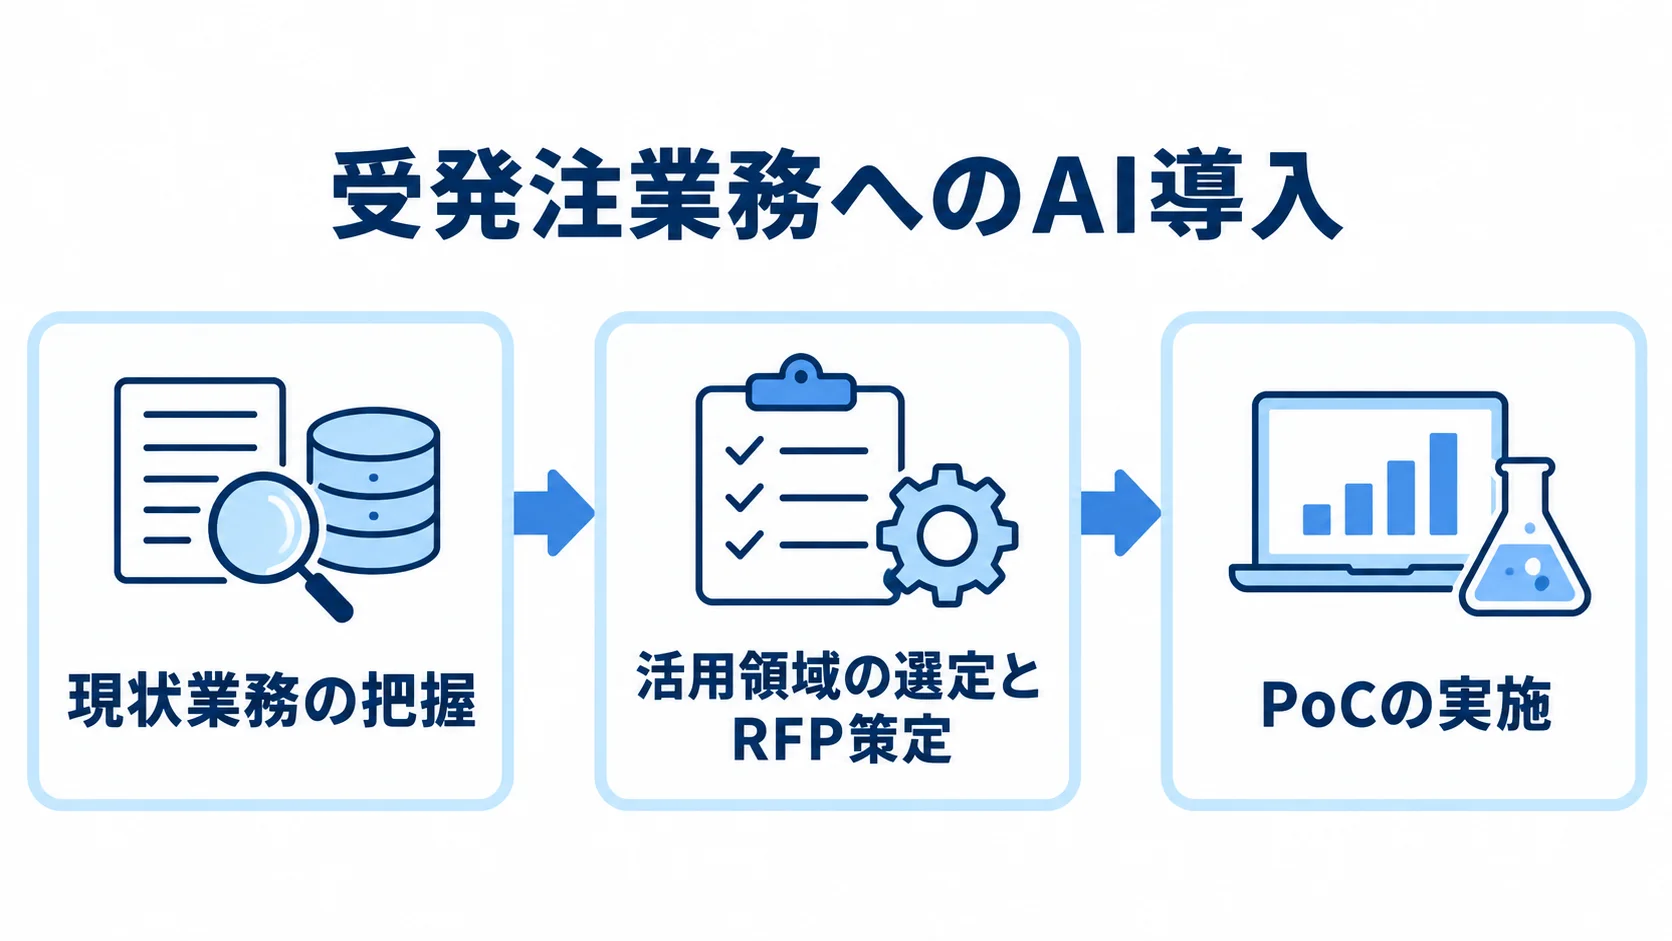
受発注業務へのAI導入を成功させるには、全社一括ではなく段階的に進めることが鍵となります。最初に現状を把握し、PoCで効果を確かめてから広げる流れが基本です。
ステップ1:現状業務のプロセスマッピングとボトルネック特定
まず、受発注業務の全フローを一覧にし、どこで手作業や確認ミスが多いかを洗い出します。残業や過剰在庫が生じている場所も明らかにします。
「月に何件のFAX帳票を手入力しているか」「誤発注の発生頻度と対応コストはどの程度か」「在庫の廃棄ロスは年間いくらか」といった問いに、数字で答えられるようにします。こうした定量的な現状把握が、AI導入の優先領域を決める根拠になります。
同時に、商品マスタ、過去のExcel受注履歴、在庫ログなど、自社が持つデータの形式と品質を点検し、整理(データクレンジング)しておく必要があります。AIの学習データの質は予測精度に直結します。そのため、この工程を省くと、後の段階で大きな手戻りが生じます。
ステップ2:活用領域の選定とRFP策定
ボトルネックが明らかになったら、AIで解決できる領域を絞り込みます。業務の形態が「小売・店舗運営(多品種少量)」か「卸売・製造(非定型FAXやメール注文の処理、BtoB)」かによって、採用すべき最適なAIツールや技術構成は変わります。
小売・EC寄りならAI需要予測・自動発注ツール(FULL KAITENやsinopsなど)、BtoBの帳票処理が中心ならノンセッティング型AI-OCRを起点にするのが現実的です。活用領域が決まったら、RFP(提案依頼書)にまとめ、複数の開発会社やベンダーに見積もりと提案書を依頼します。
費用対効果(ROI)と技術実績を客観的に比べることで、自社に合うパートナーを選べます。この段階では、要件を丁寧にヒアリングし、自社特有の商慣習やイレギュラー処理に対応できる伴走型のパートナーかどうかを見極めることが大切です。
ステップ3:PoC(概念実証・試験導入)の実施
PoCでは、特定の店舗や1カテゴリの商品、取引先のみを対象に、実際にAIを稼働させます。需要予測やAI-OCRの読み取り精度、基幹システムとの連携精度を、1〜2週間の初期プロトタイプで検証します。
全社展開の前に小さく試すと、データ品質の問題やマスタの表記ゆれなど、想定外の課題を早めに見つけられます。早い段階で見つかれば、修正コストも最小限に抑えられます。
PoCの評価指標は、「AI処理件数÷総件数(自動化率)」「AI読み取り精度(活字・手書き別)」「処理時間の削減率」「エラー発生率の変化」などを、事前に決めておくと良いでしょう。こうしておくと、本格導入の判断材料がはっきりします。
セキュリティ体制の整備と既存システムとの連携
AIを受発注業務に本格導入するには、機密情報の保護と、既存の基幹システム(ERP・販売管理システム等)との円滑な連携が欠かせません。機密情報には、たとえば顧客情報、仕入価格、商品マスタがあります。
セキュリティ体制の構築と社内利用ルールの策定
AIが扱う顧客リスト、仕入価格、独自マスタ情報などの機密情報が、外部の公開型生成AIモデルへ流出しないよう、セキュアなインフラ環境を整えることが大切です。具体的には、API利用を基本とし、データの暗号化と匿名化を徹底します。さらに、入力を制限する従業員ガイドラインを整備し、社員に教育します。
特に注意が必要なのは、ベンダー契約での知的財産権の扱いです。自社の取引・売上データで学習させた「学習済みAIモデル」の所有権、著作権、再販権が、どちらに帰属するかを、契約前に確かめる必要があります。
この確認を怠ると、将来、別のベンダーへ移行したり内製化したりする際に、ロックイン被害が生じるおそれがあります。
既存システム(ERP等)とのデータ連携・段階的移行
本格導入では、APIやCSVを使って基幹システムと連携し、手動の処理とAIの処理を一定期間並行させて検証します。並行稼働中は、AIの出力データを従来の手入力データと照合して、精度を見ていきます。精度が確認できた範囲から、段階的に自動化を広げていきます。
連携の設計では、受発注データのフォーマット変換ルールを明文化し、マスタデータの同期タイミングを決め、AI処理のエラー時の例外フローを整えておくことが大切です。これらを事前に整理しておけば、本番稼働後の混乱を防げます。
現場定着と運用フェーズの進め方
AIを導入しても、現場のスタッフに使われなければ意味がありません。技術の実装だけでなく、組織の中で「人の心の変化」に寄り添う伴走支援の仕組みが、AIを定着させるうえで最も重要な要素です。
「入力者」から「承認者」への業務ロールシフト
AI-OCRや需要予測AIが台頭していくと、担当者の役割は「データを入力する人」から「AIが出力したデータを最終確認し、承認する人」へと変わります。この役割の変化を文書にまとめ、新しい業務プロセスとして定めることが、現場定着の第一歩になります。
このシフトは、担当者にとって「発注量を決める不安(過剰仕入への恐れや欠品時の顧客対応)」や「1文字の間違いも許されない転記の重圧」から解放されることを意味します。そこで、AIによる変化は、仕事を奪われる脅威ではなく、高付加価値業務に集中できる機会として伝えることが、スタッフの受け入れにつながります。
モデルドリフト対策と継続的な精度維持
AIは、導入した初期の段階で予測精度が最も高く、時間がたつにつれて外部のトレンドとのズレが生じます。このズレは「モデルドリフト」と呼ばれます。たとえば、季節変動パターンの変化や新規取引先の追加、商品ラインナップの変更があると、学習時点のモデルでは対応できなくなります。
この劣化に備えるには、ベンダーとの契約前に、保守契約でどこまでカバーされるかを必ず確認してください。確認すべきは、継続的な再トレーニングの体制、精度維持のためのチューニング、異常発生時の監視体制です。保守と再学習の費用やスケジュールを明確にしておくことは、長期的なROIの確保に欠かせません。
よくある失敗パターンと回避策
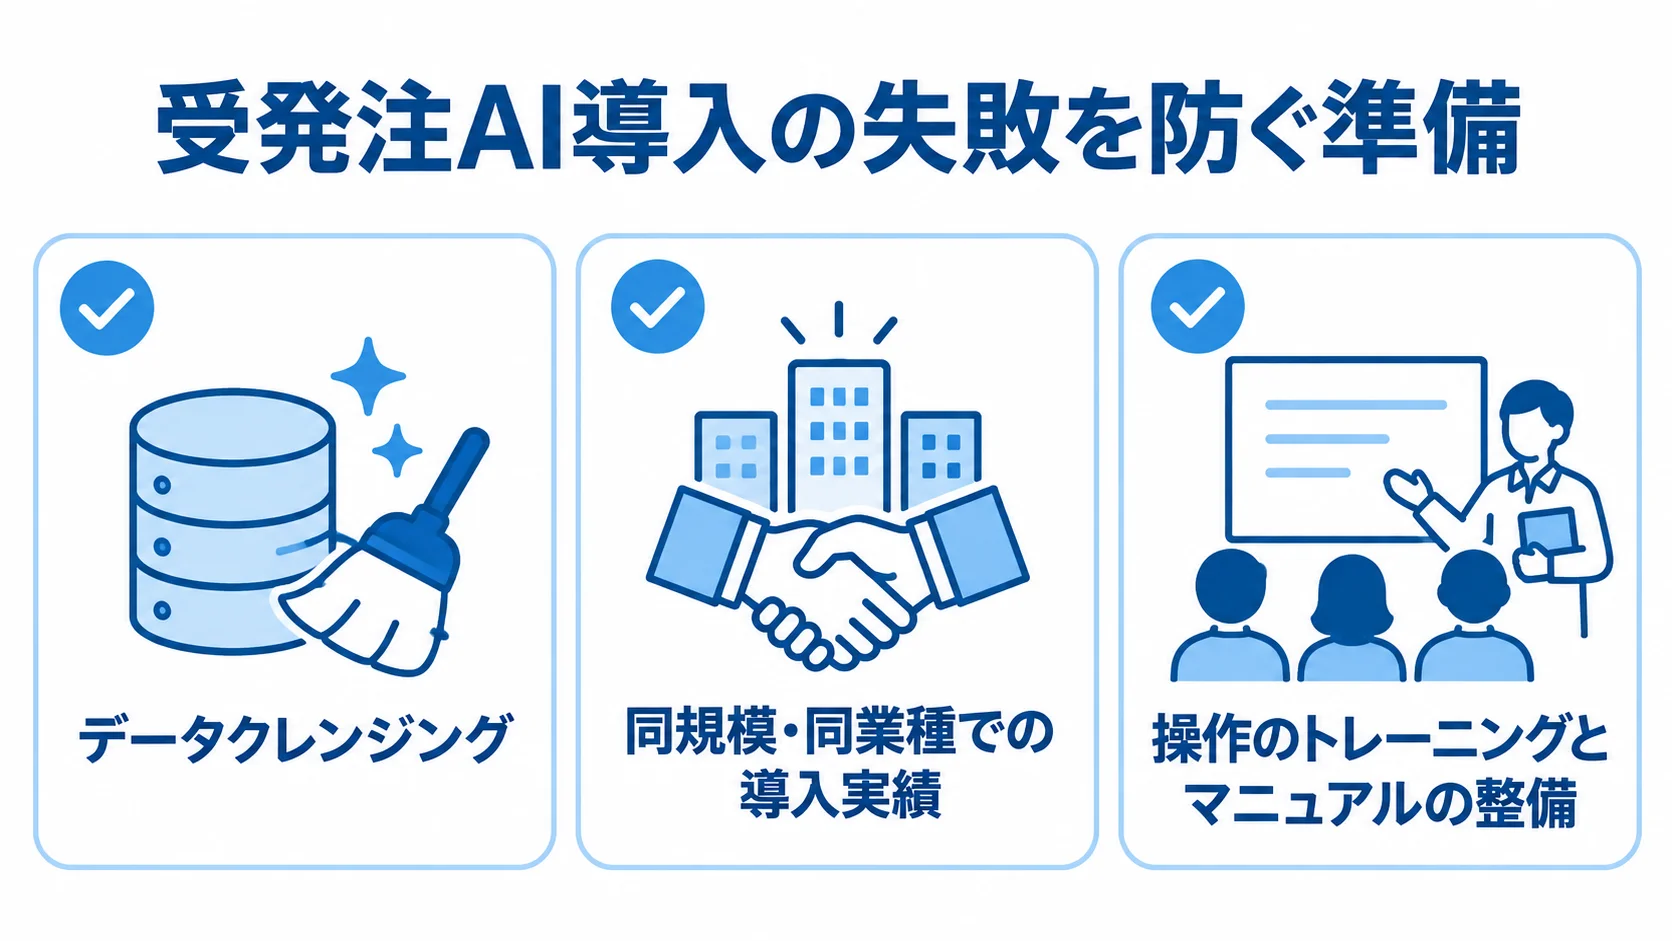
受発注へのAI導入は、準備が不十分なまま進めると、「一過性の失敗プロジェクト」に終わるおそれがあります。現場でよく見られる失敗のパターンと、その回避策を先に押さえておく必要があります。
失敗1:データ品質の軽視
AI導入プロジェクトで多く見られる失敗の一つが、学習データの品質問題です。たとえば、商品マスタに表記ゆれ(「商品A-赤」と「A赤」が別コードで登録されているなど)があったり、過去の受注履歴にミスデータが大量に混じっていたりすると、AIの予測精度は大きく下がります。
回避するには、ステップ1の段階でデータクレンジングを確実に行い、マスタの名寄せと標準化を終えてからAIの学習に進みます。データ品質の確保は地味な作業ですが、後工程の精度を左右する最も重要な作業です。
失敗2:自社の商慣習に対応できないベンダーの選定
大手コンサルや巨大IT企業が提供する「高価で融通の利かないパッケージ」に依頼すると、自社特有の非定型な商慣習やイレギュラー処理にシステムがまったく合わず、プロジェクトが頓挫することがあります。特に中小・中堅企業では、標準化されたパッケージよりも、現場のフローに合わせてカスタマイズできる柔軟性が欠かせません。
回避するには、ベンダーを選ぶ段階で、「同規模・同業種での導入実績があるか」「要件定義から運用定着まで伴走できるか」を必ず確かめます。提案書の事例が大手企業ばかりで、中小企業の実績が乏しい場合は、自社との適合性を慎重に見極める必要があります。
失敗3:現場への定着支援の後回し
技術の実装に力を注ぐあまり、現場スタッフへの教育や定着支援を後回しにするケースも多く見られます。AIツールを導入しても、使い方が分からない、信頼できないという声が現場から上がり、結局は旧来の手作業に戻ってしまうことがあります。
回避するには、社内に推進役(AIメンター)を置き、操作のトレーニングとマニュアルの整備を、導入プロジェクトの一部として計画段階から組み込みます。また、「AIが推奨した発注値を人間が最終確認する」という業務プロセスをマニュアルにまとめ、現場全員が同じ理解で運用できるようにします。こうした備えが、長期的な定着率の向上につながります。
まとめ:受発注のAI活用の進め方と成功のポイント
受発注業務へのAI活用は、ノンセッティング型AI-OCRによる帳票入力の自動化、需要予測と自動発注、異常検知によるリスク管理など、幅広い領域で効果を発揮します。ただし、その効果を引き出すには、現状分析から活用領域の選定、PoC、本格導入、運用定着まで、段階を踏んで着実に進めることが欠かせません。
大切なのは、自社のボトルネックを正確に把握したうえで、「小さく始めて成果を確かめながら広げる」進め方です。そのうえで、データ品質の確保、伴走型ベンダーの選定、現場定着の支援が、長期的なAI活用の成否を分けます。加えて、モデルドリフトに備えた保守体制も必要です。
AIを「単なる人員削減の手段」と捉えるのではなく、今いる人材をより付加価値の高い業務へ移す手段として位置づけることが、受発注業務のDXを成功させる本質的な視点です。まずは、現状業務のプロセスマッピングから始め、AI活用の第一歩を踏み出してください。
まとめで挙げた段階的な進め方の全体像は、次の完全ガイドで順を追って確かめられます。
まとめで触れた内容は、次の記事で詳しく解説しています。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。