
RAGの立ち上げは、課題と要件の整理、データ準備とインデックス構築、LLM連携とテストの順に進めるのが基本です。この順で進めると、業務課題に合うシステムに近づけます。
ChatGPTなどの大規模言語モデル(LLM)の普及で、RAGへの関心が高まっています。仕組みや費用に迷う担当者も少なくありません。
▼全体ガイドの記事
・RAG開発/構築の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
RAG構築の全体像
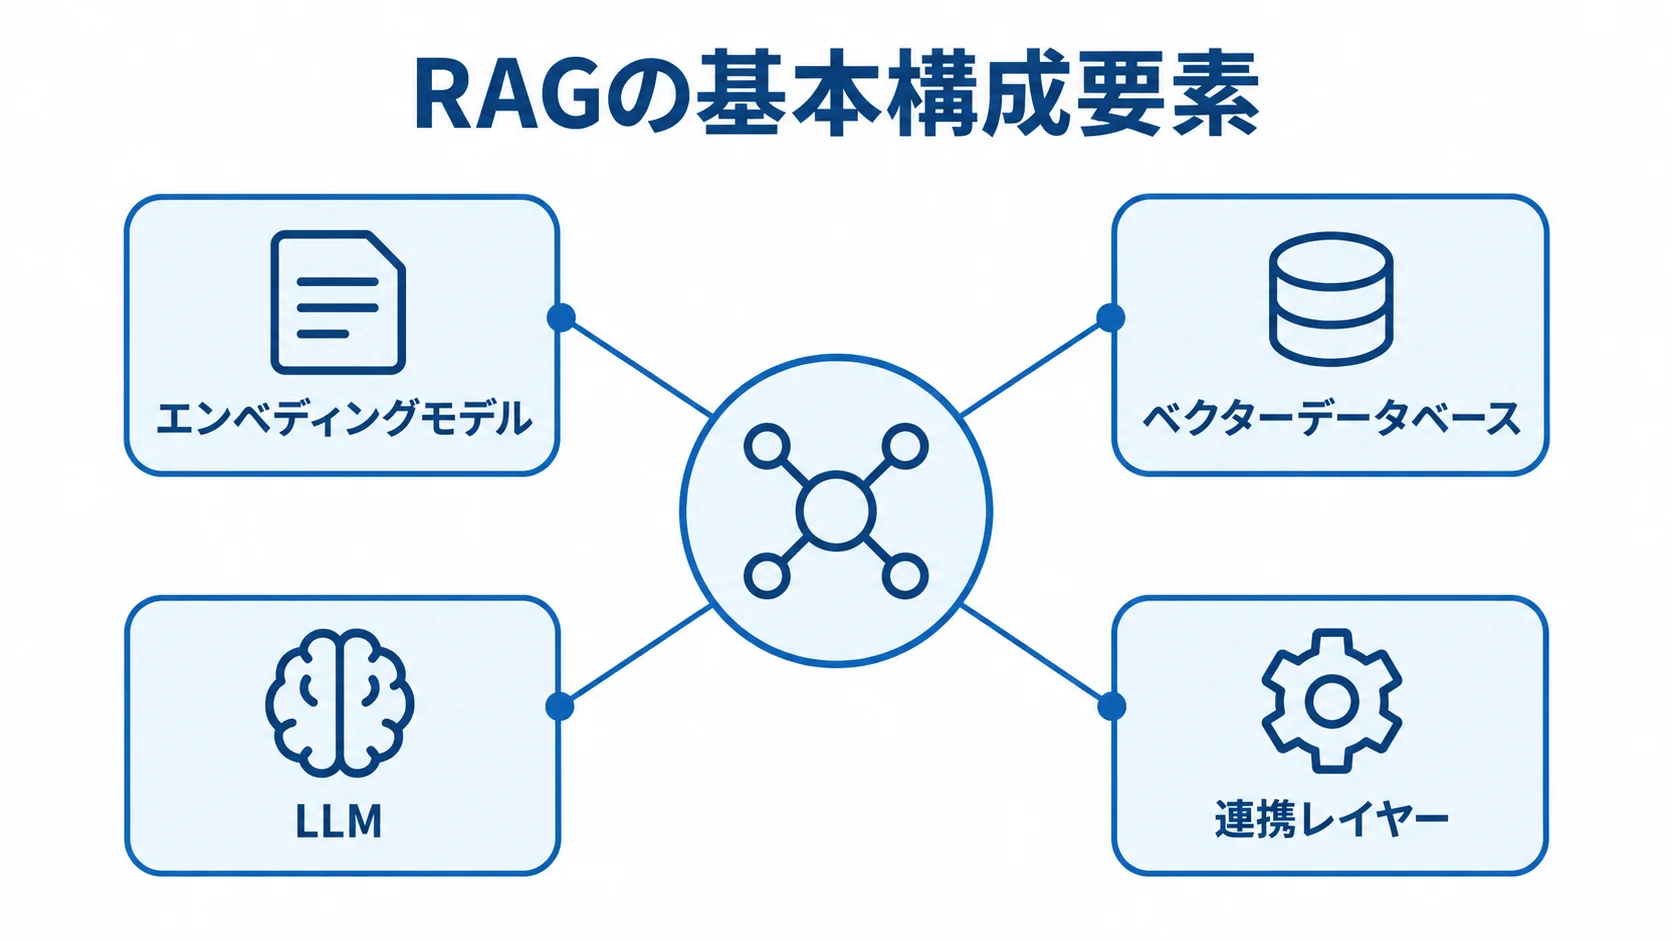
RAGは、LLMの自然言語処理と、外部の知識ベースから情報を検索・取得する仕組みを組み合わせた技術です。
従来のLLMは学習データの範囲内で回答するため、最新情報や自社固有の知識への対応が難しい課題があります。そこで、RAGは外部データを参照しながら回答を生成し、精度と信頼性の向上を図ります。
RAG(検索拡張生成)の定義
RAGの正式名称はRetrieval-Augmented Generation(検索拡張生成)で、Meta AI Researchが2020年に発表しました。当時の組織名はFacebook AI Researchでした。
LLMに検索エンジンの機能を組み合わせ、根拠のある回答をより正確に生成するアーキテクチャです。
- 検索:質問をベクトルに変換し、文書から意味の近い情報を探します。
- 回答生成:取得した情報を文脈としてプロンプトに入れ、LLMが根拠に沿って答えます。
- 基本構成:エンベディングモデル、ベクターデータベース、LLM、連携レイヤーの4要素です。
- 製品例:データベースとLLMには、複数の候補があります。
- 連携例:オーケストレーションには、LangChainやLlamaIndexなどを使います。
ベクターデータベースにはPinecone・Chroma・pgvectorがあり、LLMにはOpenAI GPT-4o・Anthropic Claude・Google Geminiなどがあります。
RAGは、ファインチューニング(追加学習)をせずに、特定領域の専門知識に基づく回答を実現できます。また、ファインチューニングよりデータ更新のコストと時間を抑えられるため、情報が頻繁に更新される環境で有効です。
RAG構築が選ばれる理由
ハルシネーションとは、事実に基づかない情報を生成してしまう問題です。RAGが選ばれる理由の一つは、回答の根拠となる文書を示せることです。根拠があるぶん、ハルシネーションを抑えやすく、回答の信頼性も担保しやすくなります。
ファインチューニングは、高品質な学習データの整備にコストと時間がかかります。一方、RAGは既存のPDF・Word・Webページを活用できます。
- 社内検索:社内規程・マニュアルや、法律・医療分野の専門文書を検索対象にします。
- 顧客・製品対応:サポートBotや、製品仕様書に基づくQ&Aに使います。
- 採用FAQ:採用に関する質問への自動回答にも使えます。
McKinseyの2025年調査では、導入企業の情報検索時間が平均45%削減され、新入社員の業務習熟期間も30%短縮された事例があります。
プライバシーと機密性の面でも、RAGはオンプレミスやプライベートクラウドに展開できます。そのため、外部にデータを送らずに高精度なAI回答システムを構築できる選択肢として注目されています。
RAG構築の進め方
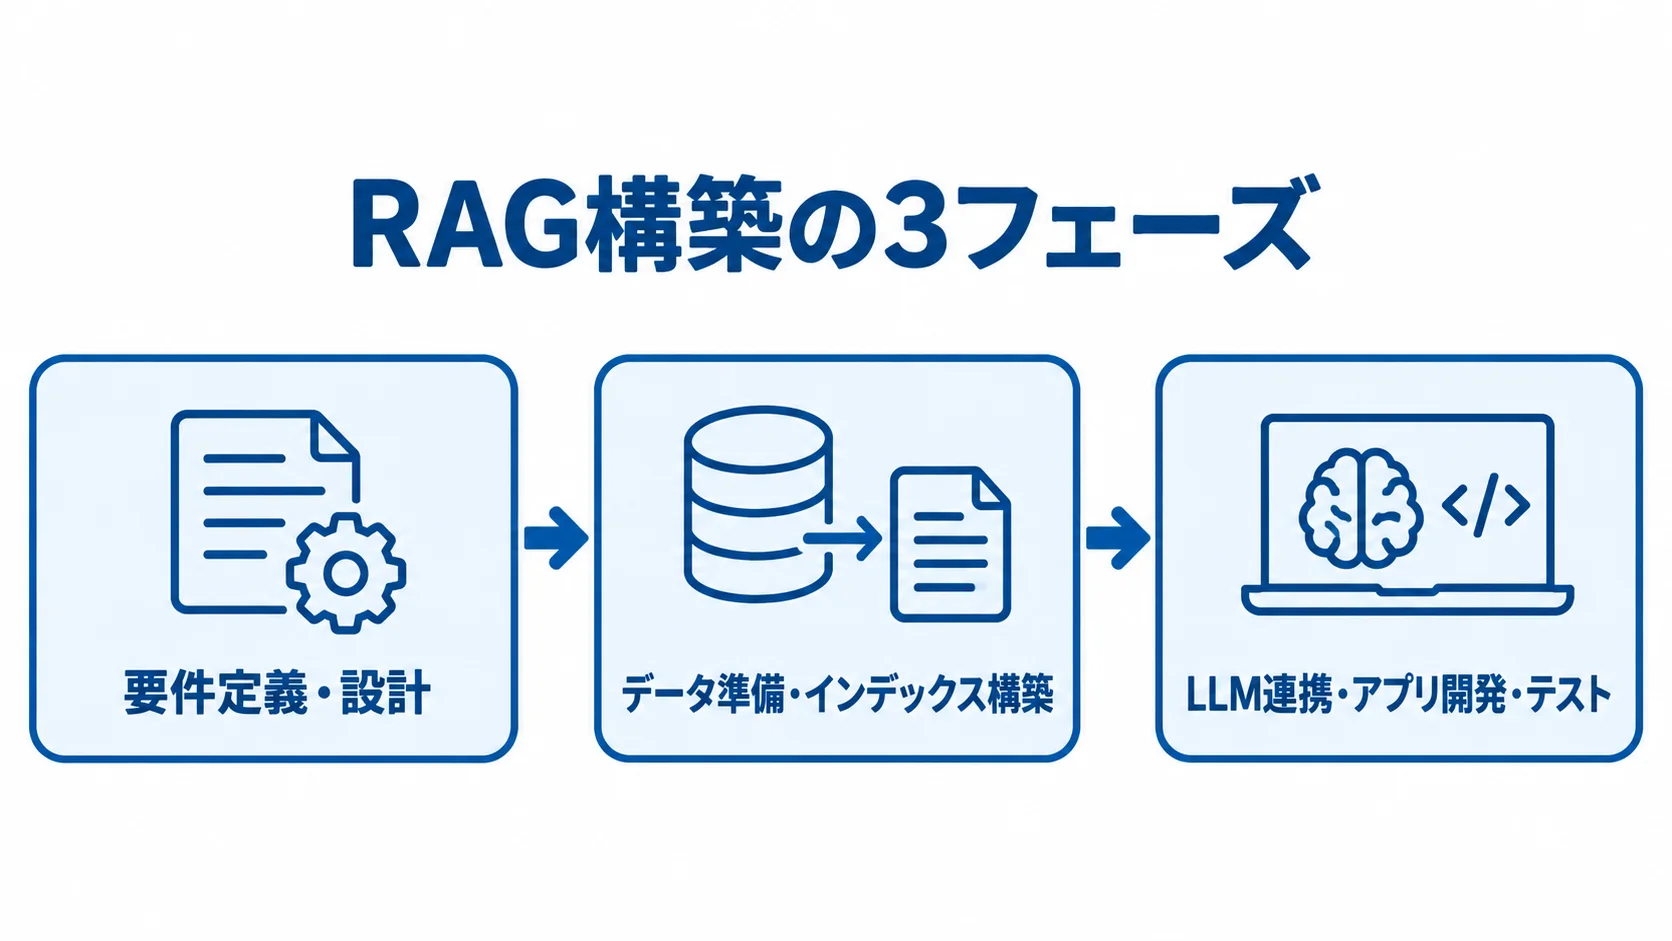
RAG構築は、要件定義から本番リリースまでを3つのフェーズに分けて進めるのが一般的です。
各段階の判断と作業が、全体の品質と効率を左右します。特に、データの質がシステム品質を決めるため、準備には十分な時間とリソースを投じることが成功の鍵です。
フェーズ1:要件定義・設計
RAG構築の第一歩は、発注側と開発会社で何のために作るのかを明確にし、解決するビジネス課題と期待効果を定量化することです。
たとえば、月間5,000件の社内問い合わせのうち、定型的な3,000件を自動回答し、担当者の工数を月80時間削減する、といった目標です。
対象ドキュメントとスコープも決めておく必要があります。社内規程や製品マニュアル、過去の提案書など、対象によって文書の構成が変わるためです。
開発会社は、PDF・Word・PowerPoint・Webページ・データベースなどの種類と件数、更新頻度を把握して、データパイプラインを設計します。そのうえで、この情報を踏まえ、構成要素ごとの技術を選びます。
- LLM:GPT-4o・Claude 3.5 Sonnet・Gemini 1.5 Pro。
- エンベディングモデル:text-embedding-3-large・multilingual-e5-large。
- ベクターデータベース:Pinecone・Chroma・Weaviate・pgvector。
- フレームワーク:LangChain・LlamaIndex。
個人情報の扱い、アクセス制御、データの保存場所といったセキュリティ要件も、発注側と開発会社で整理します。
レスポンス速度や同時アクセス数、稼働率などの非機能要件も定めます。このフェーズは一般的に2〜4週間です。
要件定義では、業務側の担当者とエンジニアが密に連携することが求められます。
フェーズ2:データ準備・インデックス構築
データ準備は、コストと時間がかかり、システム品質にも直結する工程です。まず開発会社が対象文書を集め、クレンジングします。
PDFやWordなどの非構造化データは、pdfplumberやPyMuPDF、Unstructured.ioなどでテキストを抽出して構造化します。そのうえで、誤字・脱字やフォーマットの揺れを確認し、必要に応じて修正します。
抽出したテキストは、チャンキングで分割します。分割方法は検索精度を大きく左右するため、実装のしやすさと検索結果の質を比べて方式を選びます。
- 固定長方式:指定した文字数で分割しやすい一方、文の途中で意味が途切れるおそれがあります。
- 意味的方式:段落・章・トピックの境界で分割します。実装コストはかかりますが、質の高い検索結果を得やすくなります。
一般的なチャンクサイズは256〜1,024トークン程度で、隣接するチャンク同士には10〜20%の重複を設けて、文脈の断絶を防ぎます。
各チャンクをエンベディングモデルでベクトル化し、ベクターデータベースに格納します。
日本語の文書を扱う場合は、日本語対応モデルが大切です。候補には、text-embedding-3-largeやHugging FaceのJapanese BERT系モデルがあります。
インデックス構築後は、サンプルクエリで検索精度を検証します。
期間は、データ量と品質によって変わります。数千件なら2〜4週間ですが、数十万件規模では2〜3ヶ月かかることもあります。
フェーズ3:LLM連携・アプリ開発・テスト
データ基盤の準備が済んだら、LLMとの連携とアプリケーション開発に進みます。
LangChainやLlamaIndexを使えば、質問のベクトル化、関連チャンクの取得、LLMへの情報連携と回答生成を効率よく実装できます。
プロンプトエンジニアリングも重要な工程です。取得文書を根拠に回答すること、根拠がなければ「わかりません」と答えること、出典を明示することを、システムプロンプトで指示します。
プロンプト設計の質は、ハルシネーションの抑制と回答の信頼性に直結します。
フロントエンドでは、チャットUIと検索UIのほか、ドキュメントの追加・削除やインデックス管理を行う管理画面を実装します。社内ポータルやSlackなどのSaaSとの連携も、この段階で行います。
テストでは、RAGAS(RAG評価フレームワーク)を使った定量的な品質評価が欠かせません。
RAGASでは、RAGシステムの品質を指標ごとに自動評価します。継続的な品質管理にも役立ちます。
- Context Relevancy:検索コンテキストの関連性。
- Answer Faithfulness:回答の忠実性とハルシネーションの有無。
- Answer Relevancy:回答とユーザー質問の関連性。
本番前には、現場の担当者がユーザー受入テスト(UAT)を行い、実際の利用を想定したクエリで品質を確かめます。
期間の目安は、シンプルなシステムで1〜2ヶ月、複数システムとの連携を含む複雑なシステムで3〜4ヶ月です。
RAG構築の費用相場
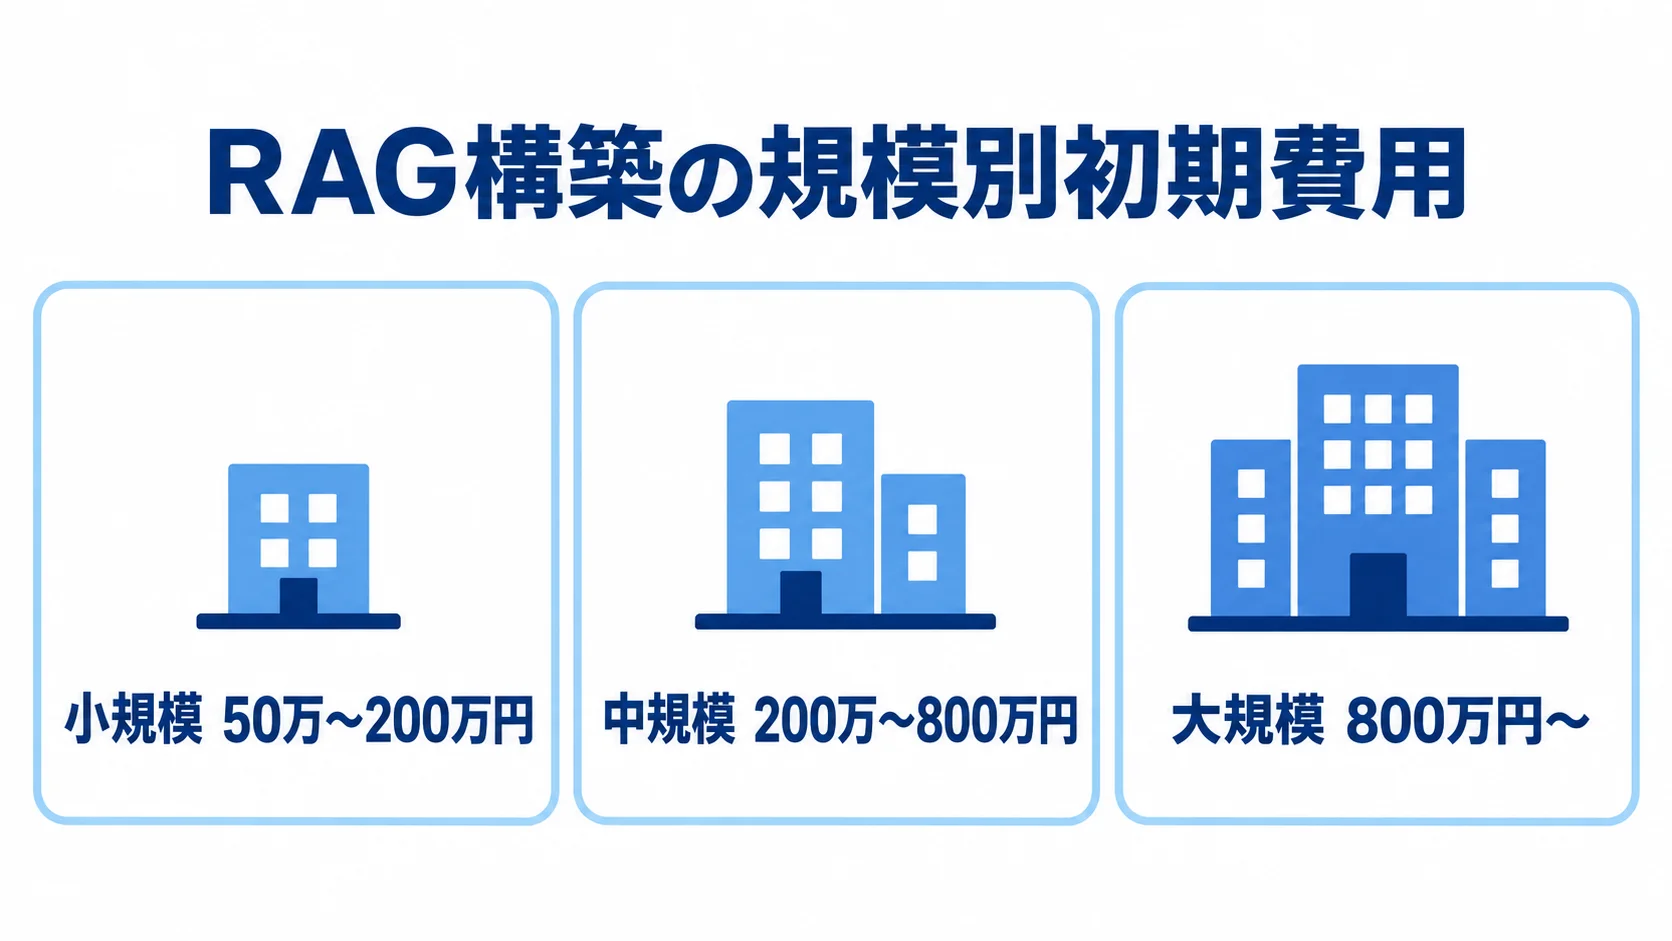
RAG構築の費用は、対象文書の規模、システムの複雑さ、既存システムとの連携要件によって変わります。
規模別の初期開発費に加えて、リリース後のランニングコストも含めた総コストで検討します。
- 小規模:文書数千件以下・単一用途で、初期費用は50万〜200万円程度。
- 中規模:数万件・複数用途や既存連携ありで、初期費用は200万〜800万円。
- 大規模:数十万件以上・複数部門や複数言語、高可用性要件ありで800万円〜。
小規模は、数百件のPDFやWordをインデックス化し、簡易なチャットUIで社内問い合わせに対応する構成です。
LangChainやOpenAI API、ChromaなどのOSSデータベースを組み合わせるため、比較的低コストで実現できます。開発期間は1〜2ヶ月が一般的です。
中規模では、社内ポータルやSlack、Teamsとの連携、文書管理、アクセス権限管理などを含みます。開発期間の目安は3〜5ヶ月です。
大規模は、金融機関や製造業の社内知識基盤、複数の外部サービスとのAPI連携などが該当します。
ランニングコストは月額15万〜100万円程度が目安です。内訳として、LLM APIは月額数万〜数十万円かかります。
このほか、クラウドインフラは月額3万〜20万円、ベクターデータベースは月額1万〜10万円です。運用保守費用は月額10万〜50万円で、利用量や構成を踏まえて総額を見積もる必要があります。
見積もりのポイント
外部に委託する場合、見積もりの精度がプロジェクトの成否に関わります。見積もり前に整理する項目と、発注先の判断基準を確認しておきましょう。
適切に準備して比べることで、コストを抑えながら高品質なRAGシステムを目指せます。
データ資産の洗い出しと要件の明確化
RAGの見積もり精度を高めるには、まず対象ドキュメントの全体像を把握することが最も重要です。件数や総ページ数に加えて、形式や更新頻度も整理しておきます。
文書ごとに閲覧権限も確認します。全員が閲覧できるか、部門ごとに制限するかを、発注側で明確にします。
スキャンPDFが多い場合は、OCRが必要になるため、コストと開発期間が増えます。
代表的な質問パターンを20〜50件程度用意しておくと、開発会社が複雑さを見積もりやすくなります。
連携とセキュリティについても、見積もり前に要件を整理しておく必要があります。
- 連携先:Slack・Teams・社内ポータル・SSO認証との接続要件。
- データ保護:クラウドへの送信可否とオンプレミス構築の必要性。
情報をそろえて見積もりを依頼すると、精度が上がり、契約後にスコープが変わることによる増額のリスクを抑えられます。
発注先の選び方と比較ポイント
発注先は、最低3社以上から見積もりを取り、RAG構築の実績、日本語処理の精度、運用保守体制の3点で比べます。
RAGは近年注目が高まった技術です。そのため、実績のある開発会社はまだ多くありません。
RAGは、リリース後も継続的な調整が欠かせないため、技術提案と支援体制を確かめます。
- 技術提案:LLM・DBの選定、チャンキング設計、RAGAS評価を具体的に提案できるか。
- 日本語処理:形態素解析の精度や日本語対応エンベディングモデルへの理解。
- 運用体制:ドキュメント追加・更新、データパイプライン、回答監視、LLM更新への支援。
費用だけで決めず、各観点を総合して、長期的な成功につながる発注先を選びます。
PoCから始める段階的アプローチ
初めて構築する場合は、大規模開発に入る前に小規模なPoC(概念実証)を行います。代表的な数百件の文書を使い、最小限のRAGパイプラインを構築して、回答品質と業務効果を検証します。
PoCの費用は50万〜150万円、期間は2〜4週間が一般的です。
PoCでは、4つの観点から検証します。
- 検索精度:意図した文書が上位に取得されるか。
- 回答品質:正確性・ハルシネーションの頻度・回答速度。
- 画面の使いやすさ:実際のユーザーが利用できるインターフェースか。
- 連携可能性:社内システムと連携できるか。
結果を踏まえて本番開発の範囲と費用を確定すると、投資リスクを抑えながら進められます。
PoCなしで本番開発に着手したプロジェクトの失敗率は、PoC実施プロジェクトの約3倍というデータもあります。
技術の成熟度が上がっても、データ品質とチャンキング戦略の課題は残ります。
PoCで丁寧に検証しておくことは、長期的な投資対効果を高めることにつながります。
ここまで、RAG構築の全体像や進め方、費用相場、見積もりのポイントを見てきました。
まず自社の課題と文書を洗い出し、信頼できるパートナーと段階的に進めることが大切です。RAGを正しく構築できれば、社内の知識活用が大きく進み、業務効率化と顧客対応品質の向上を同時に実現できます。
▼全体ガイドの記事
・RAG開発/構築の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。