
RAGは、LLMが外部の知識を検索して回答に反映させる仕組みです。社内固有の情報を活かすには、データ整備、検索設計、回答評価を合わせて進める必要があります。
社内文書検索やFAQ自動化などへの活用が進んでいます。構築の進め方や費用などを詳しく知りたい方は、下の関連記事をご覧ください。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
RAG構築・LLM開発の進め方
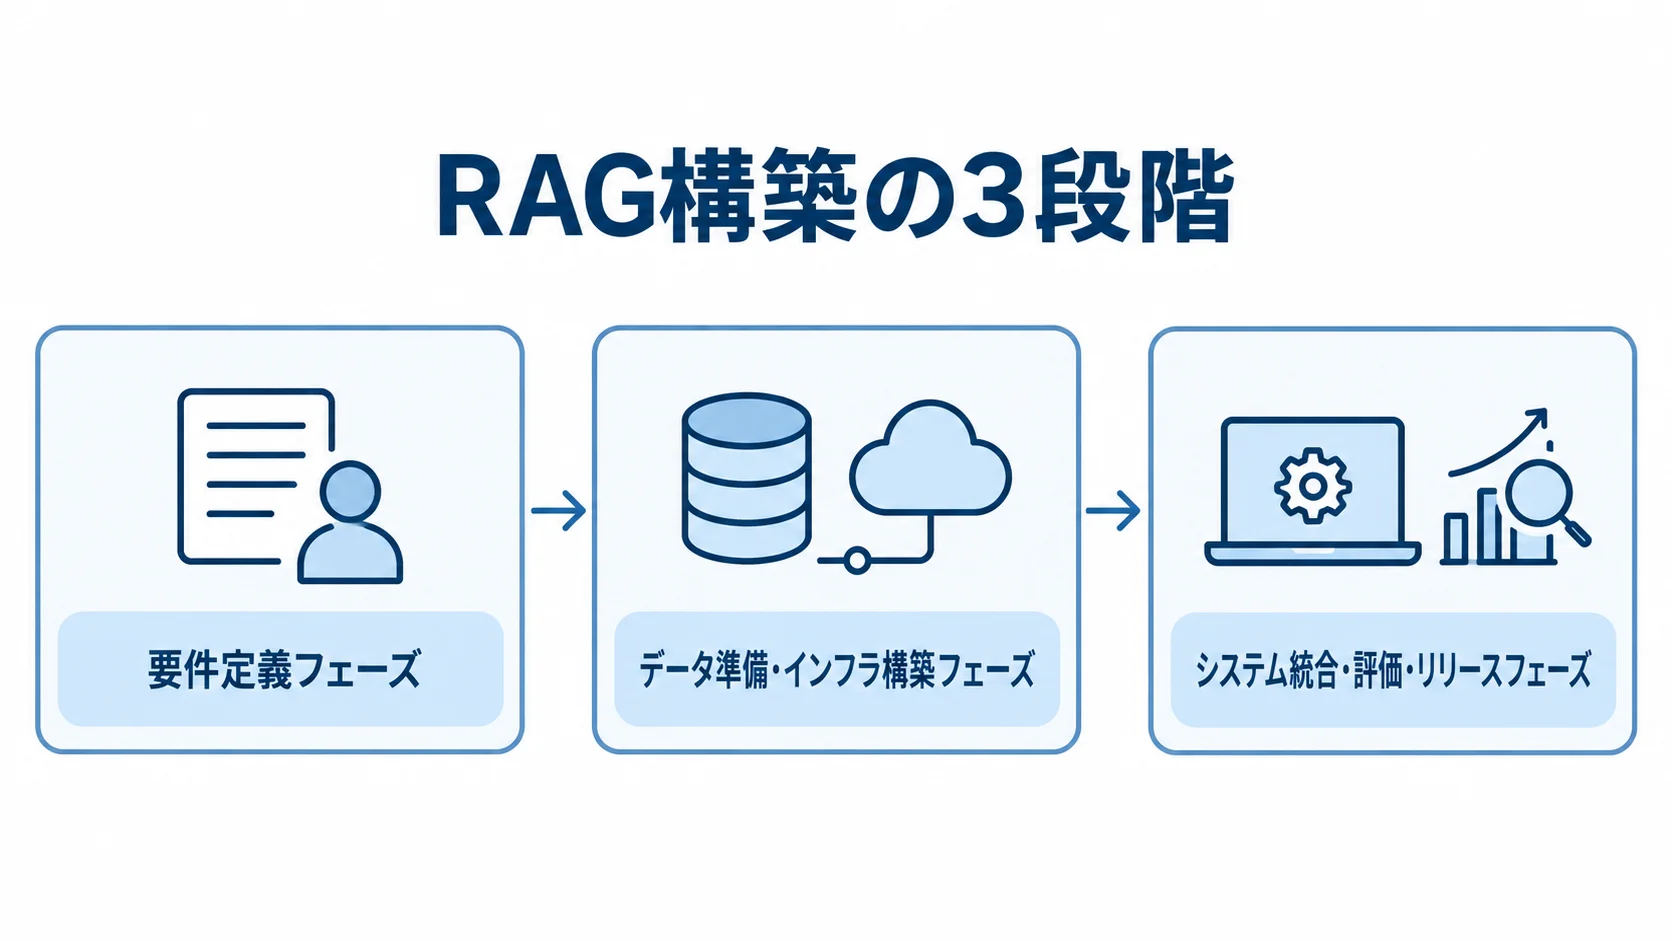
RAG構築は、「要件定義フェーズ」「データ準備・インフラ構築フェーズ」「システム統合・評価・リリースフェーズ」の3段階で進めるのが基本です。
生成AIを扱うプロジェクトは、技術面の不確実性が高いです。そのため、PoC(概念実証)を通じて早期に課題を洗い出すアジャイル的なアプローチが、成功の鍵になります。
各フェーズでは、経営層・業務部門・IT部門の三者を巻き込み、ユースケースと評価指標を明確にしながら進めることが求められます。
要件定義フェーズ:ユースケース特定とアーキテクチャ設計
RAG構築でもっとも大切なのが要件定義フェーズです。ここでは「誰が」「どのような質問をして」「どのような回答を得たいのか」を、ユースケースとして定義します。対象の分野と利用場面を絞り込むと、後続フェーズの設計判断が明確になります。
たとえば、社内規程集を対象にした問い合わせBot、製品マニュアルを参照したカスタマーサポート支援、契約書類のレビュー自動化といった利用場面があります。
目的が曖昧なままシステムを構築すると、回答精度が低くても改善の方向性がわからず、プロジェクトが迷走するリスクがあります。ユースケースが決まったら、次はアーキテクチャ設計に進みます。RAGシステムの主要な要素は、次の4つです。
- ベクターデータベース:データ量・運用コスト・セキュリティ要件に応じて選びます。
- エンベディングモデル:OpenAIのtext-embedding-3-small、text-embedding-3-largeなどから選びます。
- LLM:GPT-4o、Claude Sonnet、Gemini Proなどから、精度・レイテンシ・APIコストを考慮して選びます。
- オーケストレーション層:LangChainまたはLlamaIndexが広く使われ、RAGパイプライン全体の実装を大幅に効率化できます。
ベクターデータベースには、Pinecone(マネージドサービス)、Chroma(軽量なオープンソース)、pgvector(PostgreSQL拡張)、Weaviate(マルチモーダル対応)などがあります。
エンベディングモデルは、精度とコストのバランスで人気があります。
機密データを扱う場合は、Azure OpenAIやAWS Bedrockのようなプライベート環境での構築も検討が必要です。
データ準備・インフラ構築フェーズ:チャンキングとベクトル化
データ準備フェーズでは、まず対象ドキュメントの収集と前処理を行います。次に、PDFやWord、Excel、社内WikiやConfluenceなどを統一フォーマットに変換し、不要なヘッダー・フッター・特殊文字を除いて品質を高めます。RAGの回答精度に最も大きく影響するのが、「チャンキング(文書の分割)」の設計です。
分割方法には、次のようなものがあり、実データで試して決めます。
- 固定長チャンキング:500〜1000トークン程度の固定長で区切る方式。
- セマンティックチャンキング:段落・セクション単位で区切る方式。
- スライディングウィンドウ:前後のコンテキストを保持しながら区切る方式。
チャンクが小さすぎると文脈が失われ、大きすぎるとノイズが多くなります。そのため、実際のユースケースで検索精度を測りながら調整します。チャンキングが終わったら、エンベディングモデルで各チャンクをベクトルに変換し、ベクターデータベースに格納します。
ベクトル検索とBM25等のキーワード検索を組み合わせたハイブリッド検索を実装すると、専門用語や固有名詞の検索精度が向上します。さらに、メタデータ(文書名・作成日・カテゴリ等)を付与すると、フィルタリング検索や検索結果の説明性も高まります。
インフラ面では、次のセキュリティ対策を講じます。VPC内でのプライベート構築とAPIキーのシークレット管理を行います。通信の暗号化とアクセスログの取得も、あわせて行います。
システム統合・評価・リリースフェーズ:品質担保と本番運用
LLM統合フェーズでは、ユーザーの質問→ベクトル検索→関連チャンク取得→プロンプト生成→LLM回答生成というRAGパイプライン全体を実装します。プロンプトエンジニアリングも重要な工程で、取得したコンテキストの組み込み方、回答フォーマットの指定、ハルシネーションを防ぐ指示の書き方を繰り返し調整します。
評価工程では、RAGシステム固有の指標で定量評価を行います。評価の軸は次の3つです。
- Faithfulness:回答がコンテキストに忠実かどうか。
- Answer Relevance:回答が質問に対して適切かどうか。
- Context Precision:検索されたコンテキストが適切かどうか。
RAGASなどの評価ライブラリを使うと、LLMによる自動評価も可能です。
本番リリース前には、実際のエンドユーザーによるUAT(ユーザー受入テスト)を必ず実施します。そのうえで、回答精度・応答速度・UIの使いやすさについてフィードバックを集め、プロンプトやチャンキング設定を調整します。
リリース後は、API利用コスト・レイテンシ・回答品質を継続的にモニタリングし、文書の更新に合わせてベクターDBを定期的に再インデックスする運用フローを整備します。生成AIシステムは運用しながら改善する前提のため、改善サイクルを回し続けられる体制が長期的な成果につながります。データ準備から評価・リリースまでの進め方は、RAG構築・LLM開発の進め方の記事で詳しく解説しています。
RAG構築・LLM開発でおすすめの開発会社
RAG構築では、LLMの活用経験だけでなく、データエンジニアリングとベクターデータベースを扱える力が求められます。さらに、クラウドインフラやプロンプトエンジニアリングまで総合的に扱える開発パートナーを選ぶことが大切です。
生成AIの技術は急速に進化しています。そのため、最新のモデルやフレームワークに追いつき続ける必要があり、技術力の高さとノウハウの蓄積量が開発会社選定の鍵になります。
パートナー選定で押さえるべきポイント
RAG開発会社を選ぶとき、まず確認したいのは、RAG構築実績と使用技術スタックです。LangChainやLlamaIndexを使ったRAGシステムを作った経験があるかを見ます。特に見ておきたいのは、PoC段階のシステムを本番環境にスケールアップした経験です。実証実験で終わらず継続稼働しているシステムを持つ会社は、ノウハウの蓄積量が格段に異なります。
また、PineconeやChroma、pgvectorなど複数のベクターデータベースを比較・選定した経験があるかを確認します。さらに、Azure OpenAI ServiceやAWS Bedrockなどのマネージドサービスでの構築実績も確かめます。社内文書を扱う場合は、VPC内での構築やデータを社外に送信しないアーキテクチャ設計など、セキュリティ対応が欠かせません。
LLMの選定力や継続改善の進め方も大切な指標です。確認したい観点は、次の4つです。
- LLMの選定力:GPT-4o、Claude、Geminiなど複数のLLMを比較検証して、最適なモデルを選べるかどうか。
- 評価・改善の実行力:RAGASなどの評価フレームワークで定量的な品質評価の仕組みを持っているかどうか。
- 継続改善への対応:構築後の運用保守やドキュメント更新、モデルアップグレードまで依頼できるか。
- 伴走力:開発会社の担当者がビジネス課題の本質を理解し、運用や活用定着まで伴走してくれるかどうか。
RAGシステムは構築後の継続改善が欠かせないため、一貫して依頼できる会社を選ぶと、長期的な投資対効果が高まります。
おすすめ開発会社・ベンダー6選
国内でRAG構築・LLM開発の支援実績がある代表的な会社を6社ご紹介します。
- ①株式会社ripla:コンサルティングから開発・運用まで一気通貫で支援する企業です。
- ②株式会社NTTデータ:エンタープライズ向けの大規模AI開発に強みがあります。
- ③株式会社サイバーエージェント AI Lab:国内有数の生成AI研究・開発組織です。
- ④株式会社LayerX:バックオフィスのAI自動化に特化したプロダクト開発で培った、LLM/RAG活用のノウハウを持つ企業です。
- ⑤株式会社PKSHA Technology:自然言語処理技術に特化した企業です。
- ⑥株式会社Accenture Japan:グローバルなAI開発の実績と、Applied Intelligence部門を持っています。
株式会社riplaは、IT事業会社として社内DXを推進してきた経験を活かし、業務課題の整理から要件定義、RAGシステム設計、開発、定着支援までを一貫して担えます。
同社は、LangChain/LlamaIndexを用いたRAG構築や、Azure OpenAI Serviceを活用したセキュアな生成AI開発に対応しています。ビジネス成果にコミットするパートナーを求める企業に特に適しています。
株式会社NTTデータは、Azure OpenAI ServiceやAWS Bedrockを活用したプライベートLLM環境の構築実績が豊富です。金融・公共・製造など高いセキュリティ要件が求められる業界でも、RAG導入実績が多くあります。全社規模でAIを展開しようとする大企業に特に向いています。
株式会社サイバーエージェント AI Labは、LLMの独自開発から企業向けRAGシステムの構築まで幅広く手がけています。日本語LLMの研究開発でも先進的な取り組みを行っており、高度な技術力が求められるプロジェクトに対応できます。
株式会社LayerXは、文書処理、情報抽出、ワークフロー自動化の分野でRAGを実装した経験が豊富です。業務効率化を目的とした生成AI開発を得意としています。
株式会社PKSHA Technologyは、対話AIやFAQシステムの開発で多くの実績を積み上げています。カスタマーサポートBotや社内問い合わせ対応システムなど、RAGを活用した対話AIシステムの設計・開発でも高い技術力を備えています。
同社は、Microsoft・AWS・Googleなど主要クラウドベンダーと強いパートナーシップを結んでおり、大規模エンタープライズ案件に対応できます。
RAG構築を依頼する会社の比較・選定方法は、RAG構築・LLM開発でおすすめの開発会社・ベンダー6選と選び方で解説しています。
RAG構築・LLM開発の費用相場
RAG構築の費用は、対象ドキュメントの数量やLLM APIの利用規模によって大きく変わります。開発工数やセキュリティ要件、ベクターDB環境なども費用に影響します。
PoC(概念実証)から始めて段階的に本格展開するのが一般的です。最初から全社規模のシステムを作るより、小さく始めて成果を確かめながら投資を広げるほうが、リスクを抑えられます。
費用は、システム開発費(初期費用)とAPIランニングコスト(継続費用)の両方を把握しておく必要があります。
費用の内訳:開発費・APIコスト・インフラ費
RAG構築にかかる費用は、「システム開発費(初期)」「LLM APIランニングコスト(継続)」「ベクターDB・インフラ費(継続)」の3区分で考えます。システム開発費には、要件定義、アーキテクチャ設計、データ前処理、チャンキング設計、エンベディング処理、ベクターDB構築が含まれます。さらに、LLM統合、UI/API開発、テスト、品質評価、リリース作業も含まれます。
開発規模によって50万円〜1000万円以上と幅が広く、特にデータ前処理(PDF解析・OCR処理・文字起こし等)の工数が費用に大きく影響します。
APIとインフラの費用は、次の3つです。
- LLM APIランニングコスト:利用するモデルと月間リクエスト数によって変わります。
- エンベディング生成コスト(text-embedding-3-smallは約$0.02/1Mトークン):初回インデックス構築時の一括処理が主な費用です。
- ベクターDB・インフラ費:選ぶ製品と運用形態によって、費用が大きく変わります。
GPT-4oの場合、入力1Mトークンあたり約$5、出力1Mトークンあたり約$15(2024年時点)が目安です。月間1000件の問い合わせ処理でRAGコンテキストを含めると、月数万円〜十数万円程度になるケースが多いです。
Pineconeはマネージドサービスで月$70〜、pgvectorはPostgreSQLのインスタンス費用のみで月$20〜です。Chroma/Weaviateはセルフホスト可能で、クラウドインスタンス費用のみとなります。セキュリティ要件が高い場合は、Azure OpenAI Serviceの利用料やVPCの構築・維持費が追加で必要になります。
規模別の費用目安:PoC・部門導入・全社展開
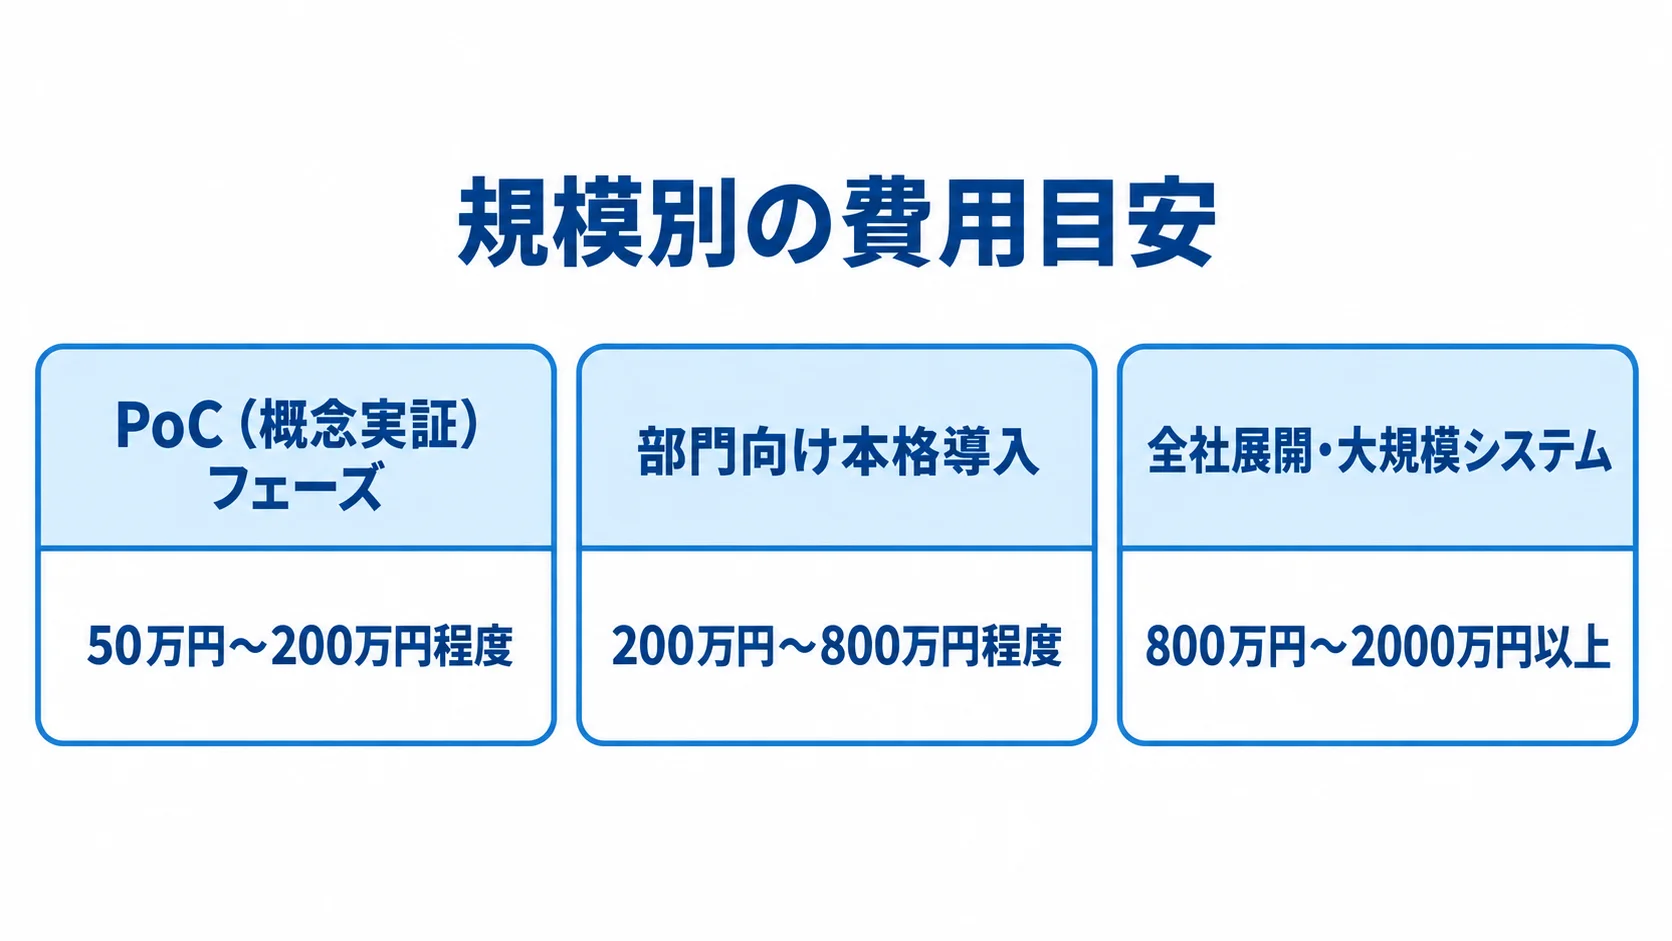
RAG構築の費用は導入規模によって大きく異なり、以下はあくまで目安となる費用レンジです。
- PoC(概念実証)フェーズ:開発費用の目安は50万円〜200万円程度、開発期間は1〜2ヶ月が一般的です。
- 部門向け本格導入:開発費用の目安は200万円〜800万円程度、開発期間は3〜6ヶ月が標準的です。
- 全社展開・大規模システム:開発費用の目安は800万円〜2000万円以上、開発期間は6ヶ月〜1年程度になるケースもあります。
PoCでは、対象ドキュメントを数十〜数百件に絞り、特定のユースケースで回答精度を検証します。Chromaやpgvectorなどのオープンソースを活用し、開発コストを抑えて早期に成果を確認するのが推奨されます。PoCの費用を抑えるには、Azure OpenAI Serviceなどの既存クラウドサービスを最大限に使い、カスタム開発を最小限にとどめることが大切です。
部門向けの本格導入では、社内ナレッジベースや製品マニュアルなど数百〜数千件のドキュメントを対象に、業務で継続的に使えるシステムを構築します。認証・権限管理・監査ログなどのエンタープライズ機能が必要となり、開発工数も増えます。継続的なランニングコストとして、月10万円〜30万円程度(APIコスト+インフラ費)を見込んでおく必要があります。
全社展開では、複数部門・複数言語・多数のデータソースを統合し、高い可用性と安定したパフォーマンスが求められるため、インフラ設計・セキュリティ対策・監視体制の整備に多くの工数が必要です。ランニングコストも月50万円〜100万円以上になることも珍しくありません。
費用を抑えるには、まず1部門でPoCを行い成功したら横展開する段階的な展開、社内エンジニアを育てる内製化の推進、モデルの使い分けやキャッシュ活用によるAPIコストの工夫が有効です。PoCから運用までの費用や見積もり方は、RAG構築・LLM開発の見積相場や費用についての記事で解説しています。
RAG構築・LLM開発の外注・発注方法
RAG構築を外部の開発会社に任せる企業が増えています。LLMやベクターDB、RAGパイプラインの設計には高度な専門知識が必要で、自社のエンジニアだけで対応しようとすると、学習コストと開発工数が膨大になります。
外注で最新の技術動向を把握した専門家のノウハウを使い、開発スピードと品質を高める方法が、生成AI活用を早く立ち上げる有効な選択肢になります。
発注側は、丸投げにせず自社の業務知識を積極的に提供することが、期待どおりのシステムを実現する鍵になります。
外注のメリット:専門性の活用と開発スピードの向上
RAG構築を外注する最大のメリットは、LangChain、LlamaIndex、各種ベクターDB、LLM APIのノウハウを持つ専門家のスキルをすぐに使えることです。自社でゼロから学ぶより開発期間を大幅に短縮でき、技術選定のやり直しリスクも減らせます。
チャンキング戦略、プロンプトエンジニアリング、回答品質評価(RAGAS等)は、経験なしに習得するのが難しい生成AI特有のノウハウです。そのため、実績ある開発会社のベストプラクティスを取り込める点も大きなメリットです。
さらに、次の場面でも専門会社のノウハウが役立ちます。
- マネージドAIサービスの選定:AWS/Azure/GCPのどの基盤を使うかを選ぶ。
- アーキテクチャ設計:セキュリティ要件を満たす構成を決める。
外注する範囲は、フルアウトソーシングから、要件定義のみ、インフラ構築のみ、品質評価のみといった部分委託まで様々です。自社にエンジニアがいる場合は、設計・アーキテクチャの決定を外部専門家と共同で行い、実装の一部を内製化するハイブリッドな進め方も有効です。コストを抑えながら、技術力を社内に蓄積できます。
外注から始めて徐々に内製化を進め、自社で保守・改善できる体制を目指すと、長期的なコストを下げることにつながります。
発注前の準備:要件整理と評価基準の設定
外注を成功させるうえで最も大切なのが、発注前の準備です。整理しておきたい要件は、次の5つです。
- ユースケースの明確化:どのドキュメントを対象に、誰がどんな質問をして、どんな回答が必要か。
- 対象ドキュメントの整理:ドキュメントの種類・形式・数量・更新頻度・品質。
- セキュリティ・コンプライアンス要件:社外へのデータ送信可否、社内システムとの連携要件、アクセス権限の設計。
- 期待する回答品質の基準:正答率、応答速度、ハルシネーション許容レベル。
- 運用・保守の体制:社内担当者の有無、ドキュメント更新時の対応方法。
RFP(提案依頼書)には、これらに加えて、プロジェクトの背景、現状課題、目標、スケジュール、予算感、評価基準を盛り込みます。
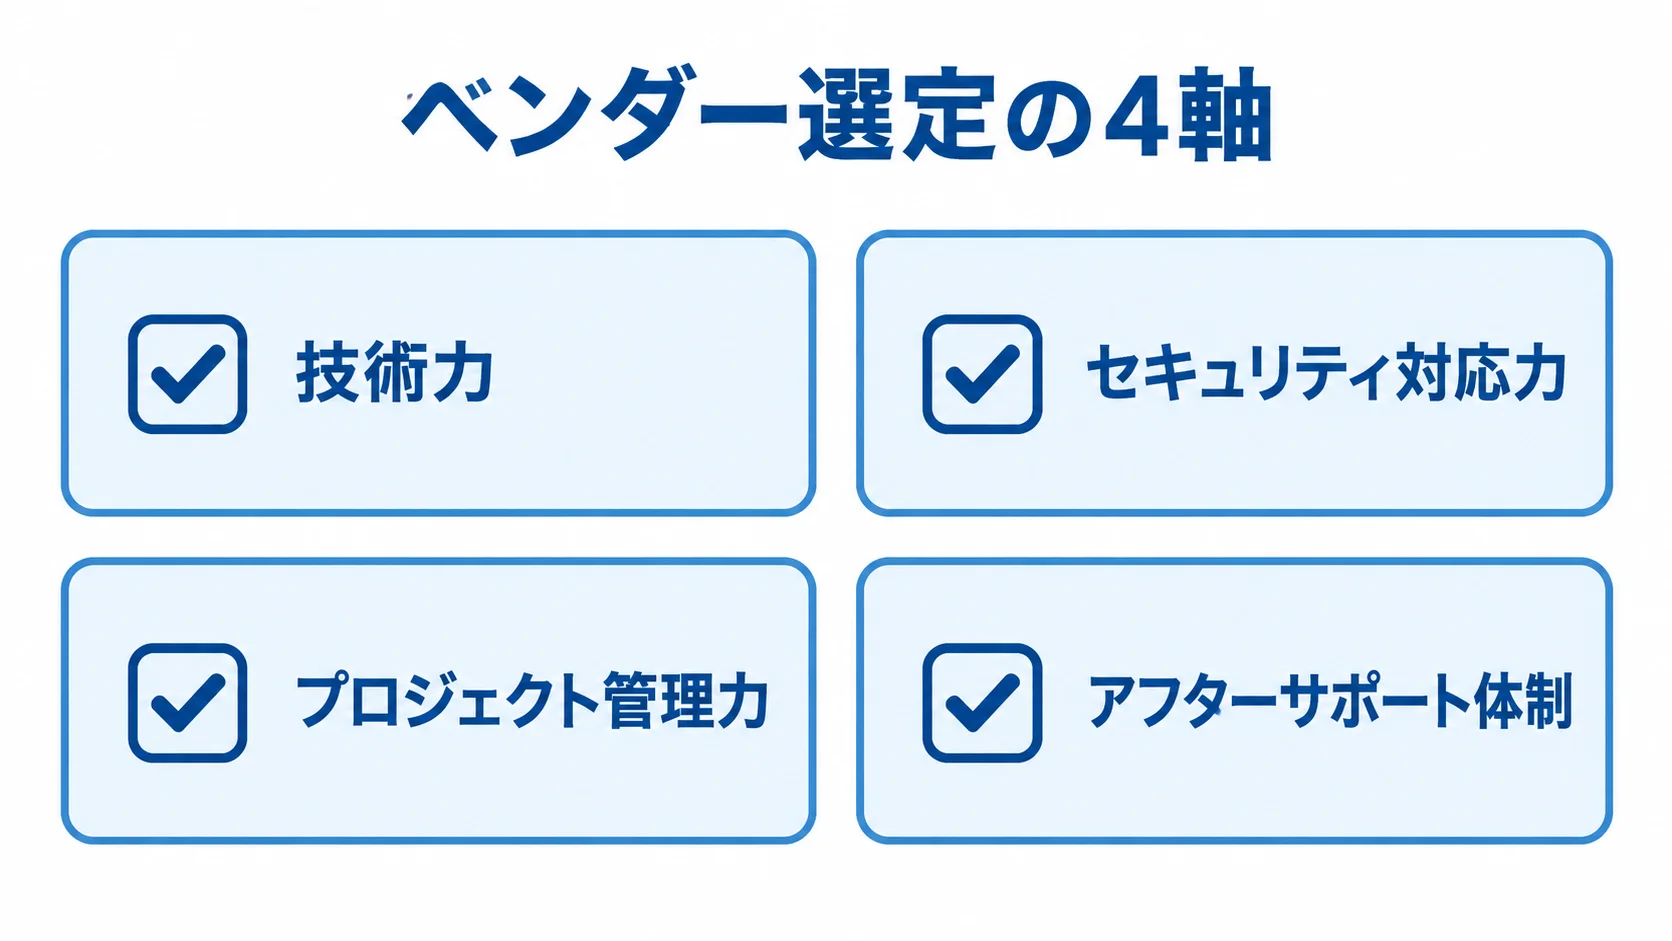
特に「何をもって成功とするか」の評価基準を事前に合意しておくと、プロジェクト完了後のトラブルを防げます。ベンダー選定では、3〜5社に絞って提案書と見積もりを取得し、技術力、セキュリティ対応力、プロジェクト管理力、アフターサポート体制の4軸で総合評価するのが推奨されます。
外注で陥りやすいリスクは、次の4点です。ユースケースが曖昧なため「作ったが使われない」ことや、セキュリティ要件が後から追加されてコストが増えることがあります。さらに、データ品質が低く回答精度が出ないことや、運用フローが未整備で更新されないことも挙げられます。
リスクを抑えるには、PoCフェーズを少額で発注し、技術力・コミュニケーション力・できあがりの品質を見てから本格開発を発注する段階的なアプローチも有効です。発注前に準備しておけば、これらは未然に防げます。発注前の準備と外注の進め方は、RAG構築・LLM開発の発注方法についての記事で解説しています。
まとめ
RAG構築・LLM開発について、進め方、開発会社、費用、外注・発注方法の4つのテーマを解説してきました。
進め方では、要件定義でユースケースとアーキテクチャを明確にし、データ前処理からリリースまでの各工程を着実に進めることが、品質向上の鍵です。
開発会社選定では、LangChain/LlamaIndexの実績、複数のベクターDBを比較した経験、セキュリティ対応力、継続改善への伴走力を総合評価します。
費用相場は、PoC段階で50〜200万円、部門導入で200〜800万円、全社展開で800万円〜と幅があります。継続するAPIランニングコストを含めた総コストで計画することが大切です。
発注方法では、ユースケース、ドキュメント要件、セキュリティ要件を整理してRFPを作成し、PoCから段階的に発注することでリスクを減らせます。
RAGは構築して終わりではなく、継続的な改善によって真の価値を発揮する技術です。まずは小さく始めて成果を確認し、段階的に活用範囲を広げることが成功への近道です。
個別テーマの詳しい解説は、冒頭の関連記事からご覧ください。
AIシステム開発やAI駆動開発の詳細は、次の資料でご確認いただけます。
AIシステム開発の完全ガイドブック
【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。