
RAG構築は、要件定義、データ整備、検索精度の検証、LLM統合と運用準備の順に進めると、無理のない納期を組みやすくなります。全体の目安は3週間〜6か月ですが、期間は規模や求める精度によって幅があるため、自社がどの範囲に当たるかを先に確かめることが大切です。
▼全体ガイドの記事
・RAG構築の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
RAG構築の開発期間の全体像
RAG構築の期間は、データ量、求める検索精度、既製SaaSやノーコードを使うか、フルスクラッチで作るかによって変わります。
RAG(検索拡張生成 / Retrieval-Augmented Generation)は、検索(Retrieval)と生成(Generation)を組み合わせる仕組みです。社内マニュアルや規程、問い合わせ履歴などを情報源として使います。自社データを検索可能な形へ整える工程が加わるため、期間の幅が広がります。
独自データは、ベクトルDB(embedding化した検索用データベース)に格納されます。LLM(大規模言語モデル)は回答時に、関連する情報をそこから検索して参照します。この構成は、ハルシネーション(もっともらしい誤答)を抑え、最新性や専門性のある回答を目指します。
AI FAQシステムやAIチャットボットなどの応用例も、RAGの検索基盤を利用します。
RAG構築の開発期間を見積もりにくい理由
RAGの品質は、コードの完成度だけでなく検索精度で決まります。その検索精度は自社データの性質に左右されるため、事前に見積もりにくい面があります。
- データとの相性:期待どおりに検索できるかは、実データを入れて検証するまで確定しません。
- 調整の反復:分割方法やモデルとの相性、ベクトルDBの検索設定を繰り返し調整し、その回数が期間を左右します。
一般的な業務システムは、要件が固まれば必要な工数をある程度見積もれます。一方でRAGでは、実データによる検証が欠かせません。そのため、見積もりには、設計時点の「作る工数」に加えて、目標精度に達するまでの「調整の工数」も含めておきます。
この特性を踏まえずに納期を固定すると、精度不足による手戻りが起き、大幅な遅延につながることがあります。
規模別の開発期間の目安
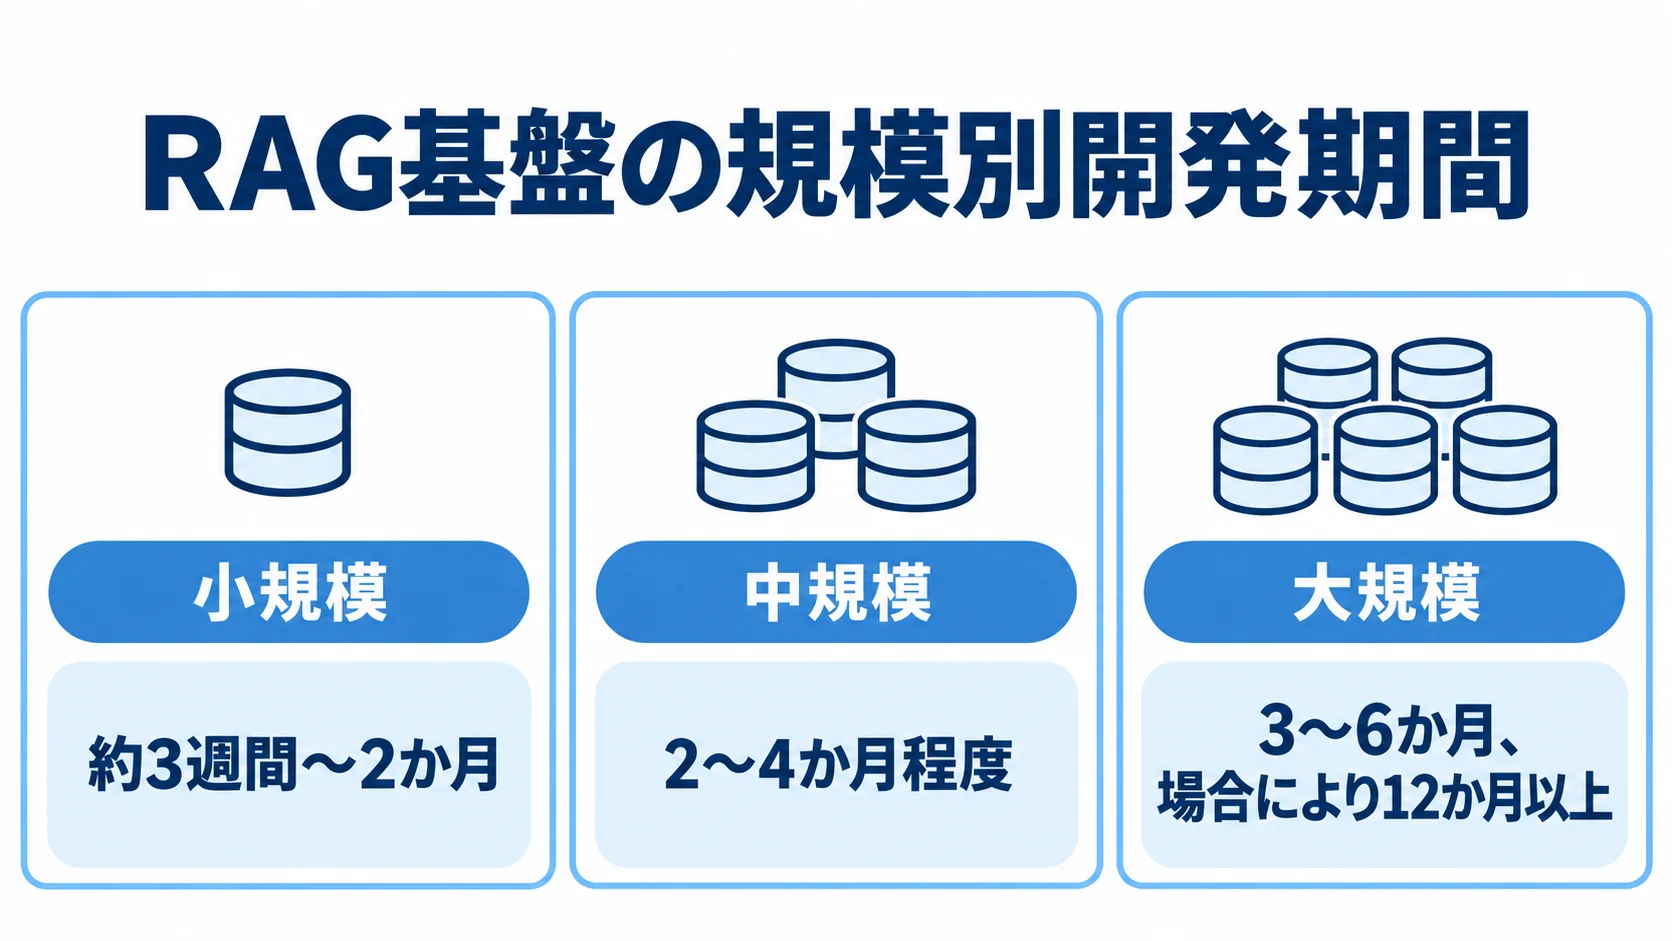
RAG基盤の開発期間は、対象データと精度水準によって規模ごとに異なります。
- 小規模:限定的な文書を扱うノーコード・既製SaaS構成で、約3週間〜2か月です。
- 中規模:複数部署の文書を統合する構成で、2〜4か月程度です。
- 大規模:基幹連携や高度な検索を含む構成で、3〜6か月、場合により12か月以上です。
小規模は、単一業務と限定的なドキュメント群が対象で、Difyなどのノーコードツールや既製SaaSを使います。なお、単純なプロトタイプ(Naive RAG)であれば、数時間〜数日で動く状態を作れる場合もあります。
中規模は、複数部署のマニュアル数千件を統合し、PineconeなどのベクトルDBで検索精度を高めるカスタム構成です。
大規模では、複数の基幹システムと連携し、ハイブリッド検索やリランキングで高精度を目指します。複数のAIエージェントが自律的に検索するAgentic RAGも大規模構成に含まれ、エンタープライズ規模では12か月以上かかる場合があります。
期間の差は、技術的な難易度だけでなく、対象データの量と品質、求める精度水準から生まれます。同じ技術スタックでも、データの整備状況によって必要な期間が倍近く変わるため、その前提で計画を立てます。
まず規模別の目安を確認し、自社のRAG基盤がどの範囲に当たるかを把握することが、現実的な計画の第一歩になります。
RAGパイプライン構築の工程別スケジュールと期間配分
中規模のフルスクラッチ開発では、RAG構築を6つの工程に分けて考えます。工程ごとの配分を把握しておくと、開発会社の見積もりを読み解きやすくなります。
工程は、要件定義から始まり、データ整備、Embeddingモデル選定・ベクトルDB構築へと進みます。そのあと、検索評価と精度チューニングを経て、LLM統合へ進みます。最後に、テスト・運用準備を行います。
- 要件定義:課題、対象データ、RAGとLLMの役割、ROIを決めます。
- データ整備:文書のクレンジング、分割、メタデータ付与に取り組みます。
- DB構築・評価:EmbeddingモデルとDBを選んだうえで、検索精度を調整します。
- 統合・運用準備:LLMを組み込み、テストと運用準備を進めます。
データ整備と検索評価・精度チューニングは、スケジュール全体で大きな比重を占めます。特に、この2工程に十分な期間を確保できるかが、プロジェクトの成否を分けます。
要件定義・データ整備フェーズ(前半)
前半では、対象業務とデータを定めたうえで、検索に使える形へ整えます。
- 要件定義:2〜4週間で課題を明確にし、対象文書を選定します。RAGとLLM単体の範囲を分け、ROI目標を定めます。
- データ整備:2〜6週間をかけて、クレンジング、チャンク分割、メタデータ付与を進めます。
要件定義では、最初から全社データを対象にせず、効果が見込める1つの業務に絞るスモールスタートが基本です。対象を広げすぎると、後続のデータ整備が際限なく膨らみます。
データ整備は期間の幅が大きく、RAG構築のなかでも工数を見積もりにくい工程です。具体的には、不要なヘッダー・フッターやOCRノイズ、制御文字を取り除き、文書を意味の塊であるチャンクに分割します。チャンクサイズは256〜1024トークン程度を目安に、文書の意味構造に合わせて設計します。
作成日、部署、カテゴリなどのメタデータも付与します。データ品質はRAG精度の上限を決めるため、この工程に時間をかける価値があります。
ベクトルDB構築〜検索評価〜LLM統合フェーズ(後半)
後半は、データ整備の進行に合わせて検索基盤を構築し、評価とLLM統合へ進みます。
- DB構築:Embeddingモデルを選び、ベクトルDBの環境を整えるまでに1〜3週間かかります。
- 検索評価:精度チューニングに2〜6週間かかり、クリティカルパスになりやすい工程です。
- LLM統合:パイプラインとプロンプト設計に2〜4週間かかります。
- テスト:運用準備に2〜4週間かけ、限定ユーザーでパイロット運用します。
Embeddingモデルには、text-embedding-3系やオープンソースのモデルなどがあります。ベクトルDBは、Pinecone、Milvus、Azure AI Searchなどから選び、インデックスを作成します。PostgreSQL拡張のpgvectorを使う場合もあります。
検索評価では、ベクトル検索とBM25などのキーワード検索を組み合わせたハイブリッド検索を実装します。Re-ranker(リランキング)で検索結果を再スコアリングし、RAGASなどで正解文書が上位に出るかを測ります。
評価結果をもとにチャンク設計へ戻って改善を繰り返します。LLM統合では、LangChainやLlamaIndexなどでパイプラインを実装します。
プロンプトには、取得情報だけを根拠に回答し、不明な場合は推測しない指示を含めます。これによって、ハルシネーションを抑えます。
ベクトルDB・embedding・検索設計が納期に与える技術的影響
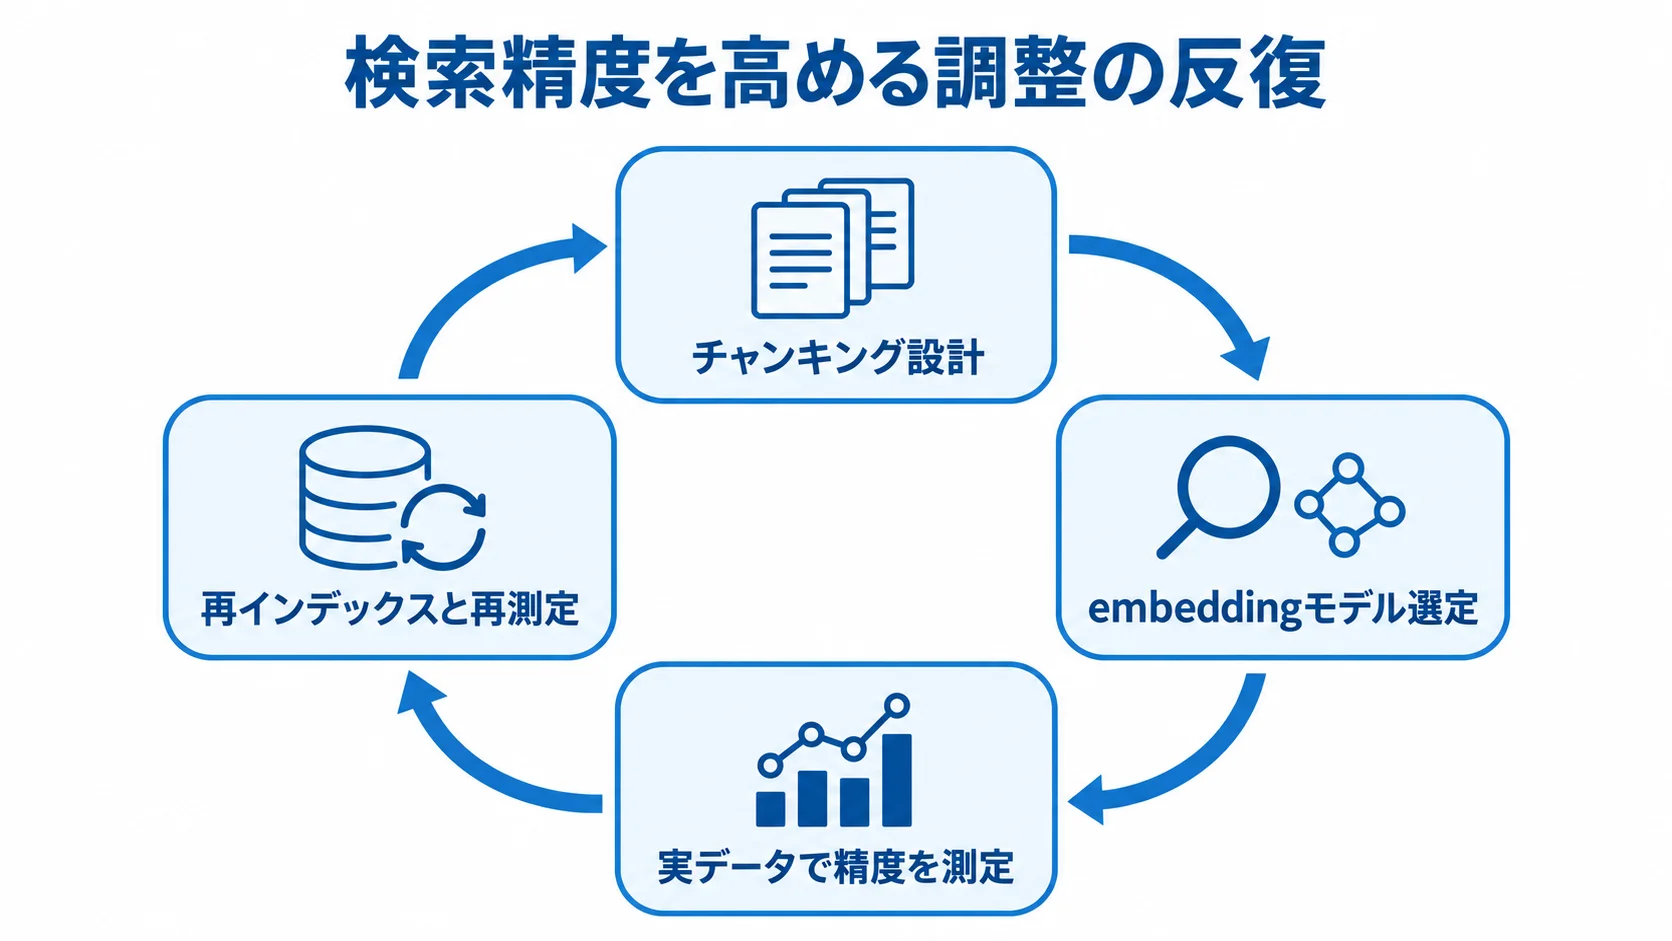
納期を考えるうえで、検索基盤の設計と、その精度を高める調整の繰り返しは避けて通れません。RAGの完了は、機能の実装が終わった時点ではなく、検索精度が目標に届いた時点で決まります。
到達までに何度調整を繰り返すかが、スケジュールを左右します。次に、期間に直結する技術要素を見ていきます。
チャンキング設計とembeddingモデル選定の反復
チャンキングは検索精度を左右する上流の設計で、選び方によっては後工程の期間も変わります。
- 分割方法:文書構造を保ちつつ、対象データに合う単位で区切ります。
- モデル選定:日本語や自社の専門用語にどれだけ合うかを、実データで比べます。
固定長で機械的に区切ると、見出しと本文、表とキャプションといった意味のまとまりが分断されます。そのため、文書構造に合わせた分割や、親文書と子チャンクの階層を保つ方法を、対象データに応じて検討します。
設計の良し悪しは、実際に検索させて検証します。また、embeddingモデルも、日本語やドメイン用語との相性がそれぞれ異なります。
複数のモデルを実データで比べ、精度を測りながらチャンクサイズやモデルを変えて、再インデックスと再測定を繰り返します。そこで、この反復で数週間が上乗せされる前提のもと、スケジュールを組みます。
ハイブリッド検索・リランキングの精度チューニング
求める精度が高いほど、検索設計は複雑になり、期間も延びます。単純なベクトル検索であれば、比較的短い期間で構築できます。
- ハイブリッド検索:意味が近い文書を探す検索と、キーワードで探す検索を組み合わせます。
- リランキング:候補を、回答に直結しやすい順に並べ直します。
ベクトル検索は意味検索に強く、型番や専門用語の完全一致には弱いため、BM25などのキーワード検索を併用します。Re-rankerの重み付けや取得件数(上位K件)は、対象データと質問の傾向に合わせて調整しなければ効果が出ません。
医療・金融・法務など誤答が許されない領域で95%以上の精度を求める場合、反復調整が数か月単位で期間を押し上げます。そこで、必要な精度水準を要件定義の段階で見極めておくと、過剰なチューニングによる納期の膨張を避けやすくなります。
開発手法による期間の違いと並行開発による短縮
期間は、開発手法と工程の並行方法によって変わります。検証を急ぐのか、本格運用を見据えて作り込むのかによって、進め方を選びます。
ノーコード/フレームワーク活用による立ち上げ加速
開発手法ごとに、試作までの速さと検索基盤の作り込みやすさが異なります。
- ノーコード・マネージド:実用レベルまで1〜3か月程度です。
- フルスクラッチ:独自実装に3〜12か月かかり、データ特性に最適化できます。
DifyやMicrosoft Copilot Studioは、GUI中心で数時間〜数日の試作に使えます。Amazon Bedrock Knowledge BasesやAzure AI Searchなどのマネージドサービスでも、同じように試作を始められます。
文書をアップロードすると、チャンキングからベクトル化までが自動で処理されるため、専門エンジニアがいなくても着手できます。
LangChainやLlamaIndexによるフルスクラッチ開発では、独自のチャンキングや検索ロジックを実装します。
まずノーコードで効果と課題を検証し、精度や制御の限界が見えた段階でフルスクラッチへ広げる進め方もあります。この段階的な進め方なら、初期の立ち上げを速めながら、本番品質への到達も目指せます。
並行開発によるクリティカルパスの短縮
工程を並行させると、RAG構築のスケジュールを圧縮できます。データ整備の完了を待つ間に、別の工程を進めます。
- 数件のきれいなサンプルデータを用意します。
- サンプルを使って、DB構築と検索・LLM生成のパイプラインを並行して開発します。
- パイプラインの完成後に、整備済みの本番データを投入します。
本番データのクレンジングが終わるまで開発を待つと、工程が直列になって期間が延びます。サンプルを先に使えば、数週間分の工数を短縮できます。
精度を検索精度と回答精度に分けて考えると、検索の調整とプロンプト設計も並行して進められます。たとえば、データサイエンティストは正しいチャンクが検索されるよう調整し、AIエンジニアはダミーの検索結果を使って出力形式や口調を整えます。
このように、データ整備と検索チューニングの周辺工程を先に進めておくことが、無理のない納期短縮につながります。
納期遅延の典型要因と対策
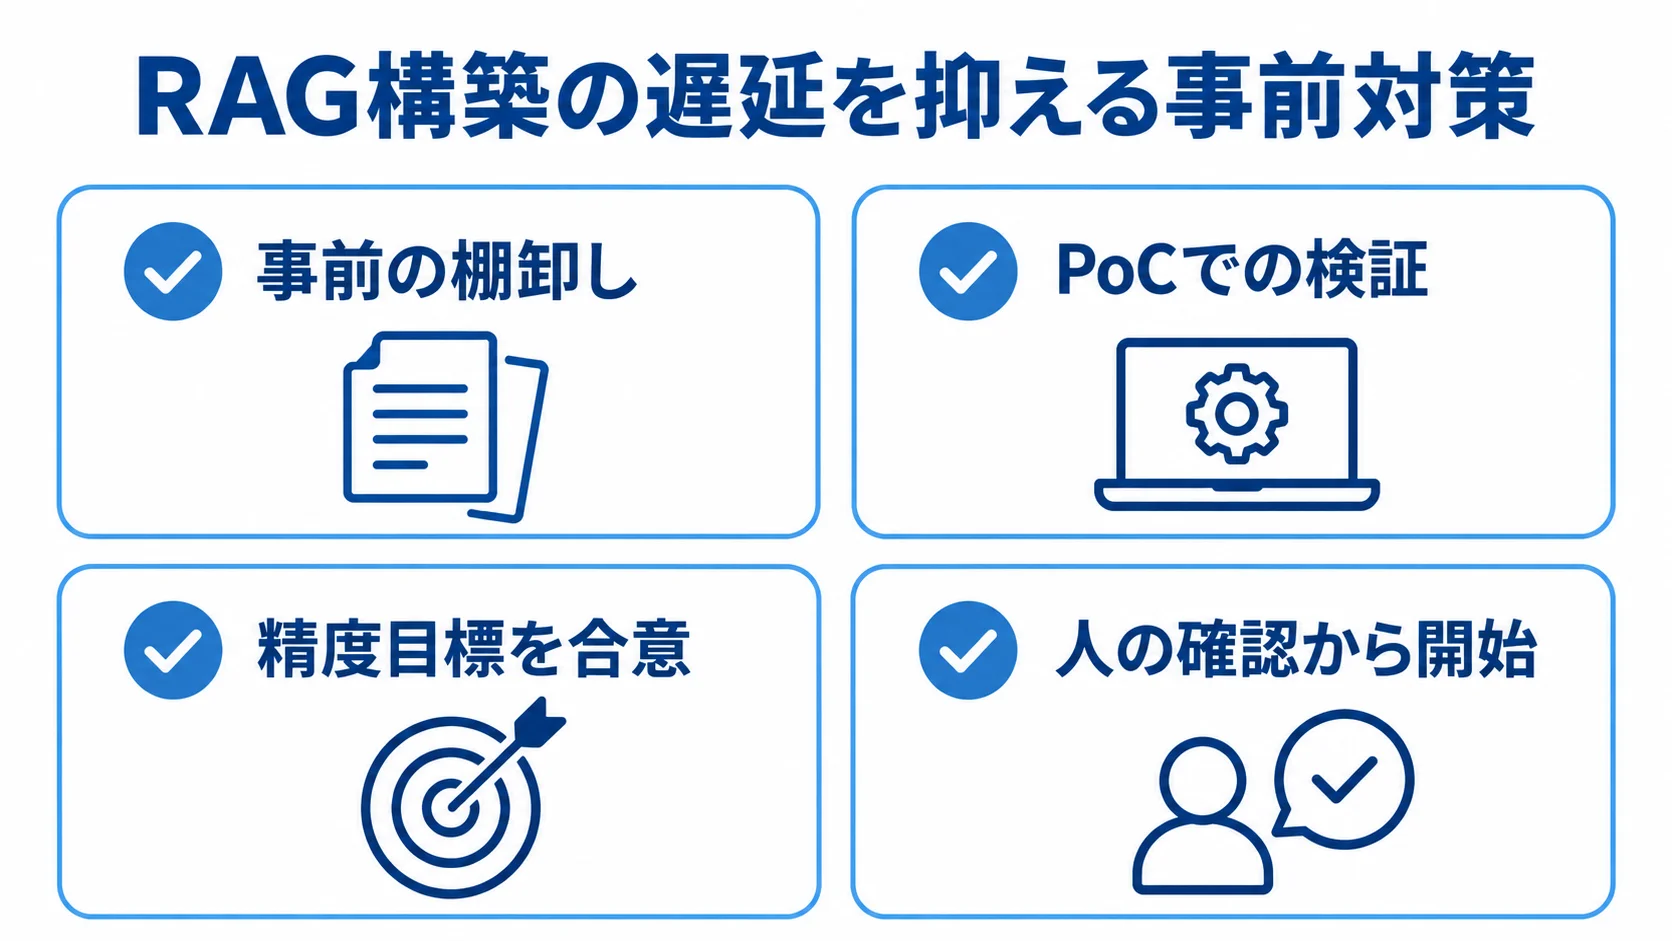
期間や工程を理解していても、RAG特有の遅延要因を放置すると計画は崩れます。主な原因は次の3点です。
- データ品質:社内データがAI-Readyでないと、整備の作業が膨らみます。
- 精度基準:目標を決めないと、調整もリリース時期も定まりません。
- 完全自動化:最初から人の介在をなくすと、例外処理が複雑になります。
データがAI-Readyでないことによる工数膨張
社内データがAI-Readyでないことは、よくある遅延要因です。既存のマニュアルをそのまま使えると見込んでいると、実装後に問題が見つかります。
- 事前の棚卸し:対象文書を一覧にし、それぞれの品質を確かめます。
- PoCでの検証:実データの一部を使い、検索精度を見極めます。
古い情報や重複、表記揺れ、レイアウトが崩れたPDFが見つかると、想定外のクレンジングが発生します。これは、Garbage In, Garbage Out(ゴミを入れたらゴミが出る)と表現されます。RAGでは入力データの品質が検索精度の上限を決めるため、通常のシステム開発以上に影響が深刻になります。
こうした事態を防ぐには、要件定義でデータ整備を独立したタスクとして見積もりに明記し、実装前に対象文書を確認しておきます。また、PoC(概念実証)で実データの一部を使えば、本開発での想定外の手戻りを大幅に減らせます。
精度基準の未設定と完全自動化へのこだわり
本番稼働できる検索・回答精度の目標値は、開発を始める前に関係者で合意しておきます。基準を決めないまま開発すると、リリース時期が定まりません。
- 精度目標を合意:Faithfulnessなどの指標ごとに、基準値を設けます。
- 人の確認から開始:Human-in-the-Loopで運用し、AIが任せられる範囲を徐々に増やします。
基準が曖昧だと「もう少し精度を上げたい」という要望が続き、検索評価と調整の期間が延びます。業務の性質に応じた現実的な水準を、関係者でそろえておくことが大切です。
想定外の質問や検索失敗まで全自動で対処しようとすると、例外処理が複雑になり、破綻しやすくなります。そこで、AIが迷いやすい場面は人が最終確認する形で始めるほうが、早く安定稼働につながります。
PoCを省いて本開発に進むと、当初は短い計画に見えても、精度不足の手戻りで全体の納期が延びるケースがあります。
まとめ
RAG構築の期間の目安は、小規模で3週間〜2か月、中規模で2〜4か月、大規模で3〜6か月です。エンタープライズ規模では、12か月以上かかる場合もあります。
工程ごとの目安は、要件定義が2〜4週間、データ整備が2〜6週間、ベクトルDB構築が1〜3週間です。検索評価・精度チューニングは2〜6週間、LLM統合は2〜4週間、テスト・運用準備は2〜4週間です。
ここまで、規模別の期間や工程配分、RAG特有の技術が納期に与える影響を見てきました。開発手法や並行化、遅延要因と対策についても触れています。
RAGは、コードが完成した時点ではなく、検索精度が目標に届いた時点で完了します。チャンキング、embedding選定、検索とリランキングの調整が、期間を左右します。
データのAI-Ready化と精度基準の事前合意に加え、Human-in-the-Loopでの開始が欠かせません。サンプルでのパイプライン先行構築と検索・生成の並行開発を活用すると、納期設定とリスク管理を両立しやすくなります。
具体的なスケジュールを相談する際は、複数の開発会社に要件概要と社内データの状況を提示し、見積もりを取ることから始めます。
▼全体ガイドの記事
・RAG構築の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。