
RAG基盤の保守・運用費用は、構成、利用量、精度維持にかける人的稼働によって、月額数万円から50万円以上まで変わります。
RAGは社内規程などの文書をベクトルDBに格納し、回答時に検索して使うことで、最新性・専門性のある回答を実現するアーキテクチャです。AIFAQシステムやAIチャットボットも、その応用例の一つです。費用は、インフラとAPIの利用料と、精度を保つ人手の両方で決まります。
▼全体ガイドの記事
・RAG構築の完全ガイド
AIシステム開発の費用の考え方や見積もりの注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
▼見積依頼前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
RAG基盤のランニングコストの全体像
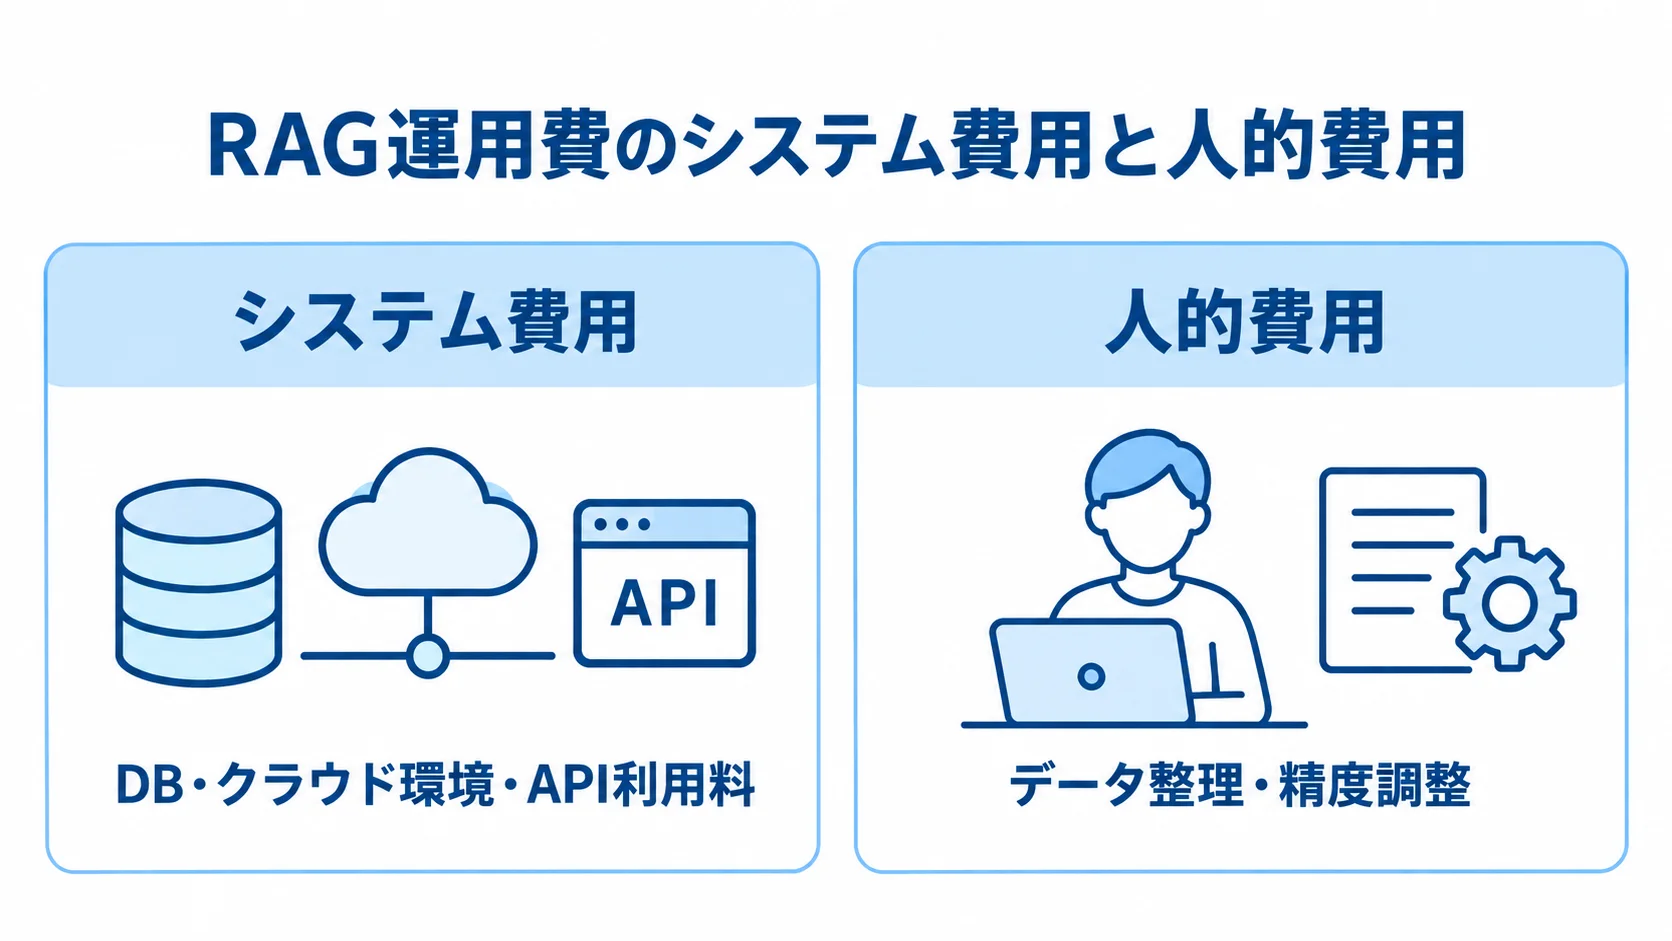
RAG基盤の運用費用は、インフラ・API費用と、検索精度を維持・向上させるための人的費用に大別されます。
一般的なWebシステムは、サーバー費用と保守契約で費用を把握できます。一方、RAGは検索精度が時間とともに劣化しうるため、継続的なチューニング費用も必要になります。
RAGは、精度を育て続ける前提で運用予算を組むことが出発点になります。
「システム費用」と「精度維持の人的費用」の2区分
RAGのランニングコストは、システム費用と精度維持の人的費用に分けると整理しやすくなります。
- システム費用:DB・クラウド環境の維持費と、API利用料
- 人的費用:データ整理、精度調整、失敗分析と改善に伴う作業
システム費用には、ベクトルDBのホスティング費、クラウド実行環境費、embedding APIとLLM APIの従量課金が含まれます。DBや実行環境の費用は技術構成で金額が決まり、API料金はアクセス量に応じて変動します。
人的費用には、ドキュメント更新に伴うデータ整理、検索精度の調整、ハルシネーション監視、失敗ケースの分析とプロンプト改善が含まれます。いずれもエンジニアやオペレーターの稼働に紐づく費用です。
多くの企業は人的費用を見落としがちです。API料金だけを予算に入れると、精度が徐々に落ち、利用者の信頼を失ってRAGが使われなくなるおそれがあります。
参照データが古くなれば回答も古くなるため、人的な維持費用は省けない固定的な支出として扱います。
固定費と変動費の考え方
RAG基盤の予算は、固定費と変動費を分けて捉えるのが基本です。
- 固定費:DB、常時稼働環境、精度維持の人的稼働
- 変動費:LLM・embedding API、再インデックス処理
固定費には、ベクトルDBの基本料金や常時稼働型コンテナ環境の費用、精度を維持する人的稼働が含まれます。利用量にかかわらず、毎月一定額が発生します。
変動費には、LLM APIとembedding APIの従量課金と、データ量の増加に伴う再インデックス処理があります。LLM API料金は、ユーザー数と問い合わせ1回あたりのトークン量に比例します。
RAGは検索で見つけた文書をLLMに渡すため、注入する情報量が多いほどトークンの消費も増えます。そこで、利用が広がったときに変動費がどこまで伸びるかをシナリオで用意しておくと、予算超過の防止に役立ちます。
インフラ・APIのシステム費用と変動費の暴走リスク
システム費用の中心は、ベクトルDBとインフラ、LLM・embeddingのAPI利用料です。費用ごとの月額の目安と、変動費が想定外に膨らむ仕組みを、予算を組む前に押さえておく必要があります。
ベクトルDBホスティング・インフラ維持費(固定費中心)
インフラ費用は、DBのデータ量と実行環境に分けて見ると内訳が分かります。
- ベクトルDB:月1.2万〜4万円が目安(大規模な構成では10万円超)
- 中規模RAG(約5,000ファイル):DB約2.5万円とAPI等約1.5万円を合わせ、月約4万円
- 実行環境:サーバーレス型は月数千円〜5万円、常時稼働コンテナ型は月10万〜50万円
パイプラインを動かすクラウド実行環境の費用も発生します。たとえば、AWS Lambdaなどはリクエストが来たときだけ起動します。一方、AWS EKSなどのコンテナ型は常時稼働するため、固定費がかかります。
安定して高頻度に使われる段階で常時稼働型へ移行するなど、利用実態に合わせて構成を見直すことが、インフラ費用の最適化につながります。
LLM API・Embedding APIの従量課金(変動費)
API費用は、LLMの利用とembedding処理で、金額や発生頻度が異なります。
- LLM API:月1万〜10万円が目安です。Agentic RAGでは通常の10〜50倍のトークンを使う場合があります。
- embedding API:1万件(各2,000文字程度)のベクトル化で約100円
embedding費用は主に初回の一括処理とドキュメント更新時に発生します。このため、日常的な変動費の中心はLLM APIです。
Agentic RAGは、検索と推論のループを自律的に繰り返します。その結果、費用が指数関数的に増えるリスクがあります。
モデルの使い分け、キャッシュ、リトライ上限は、設計段階で組み込んでおきます。さらに、予算アラートと月次のトークン監視を設定しておくと、大量アクセスやエラーループによる急増を見逃しにくくなります。
検索精度を維持・向上させるための保守費用
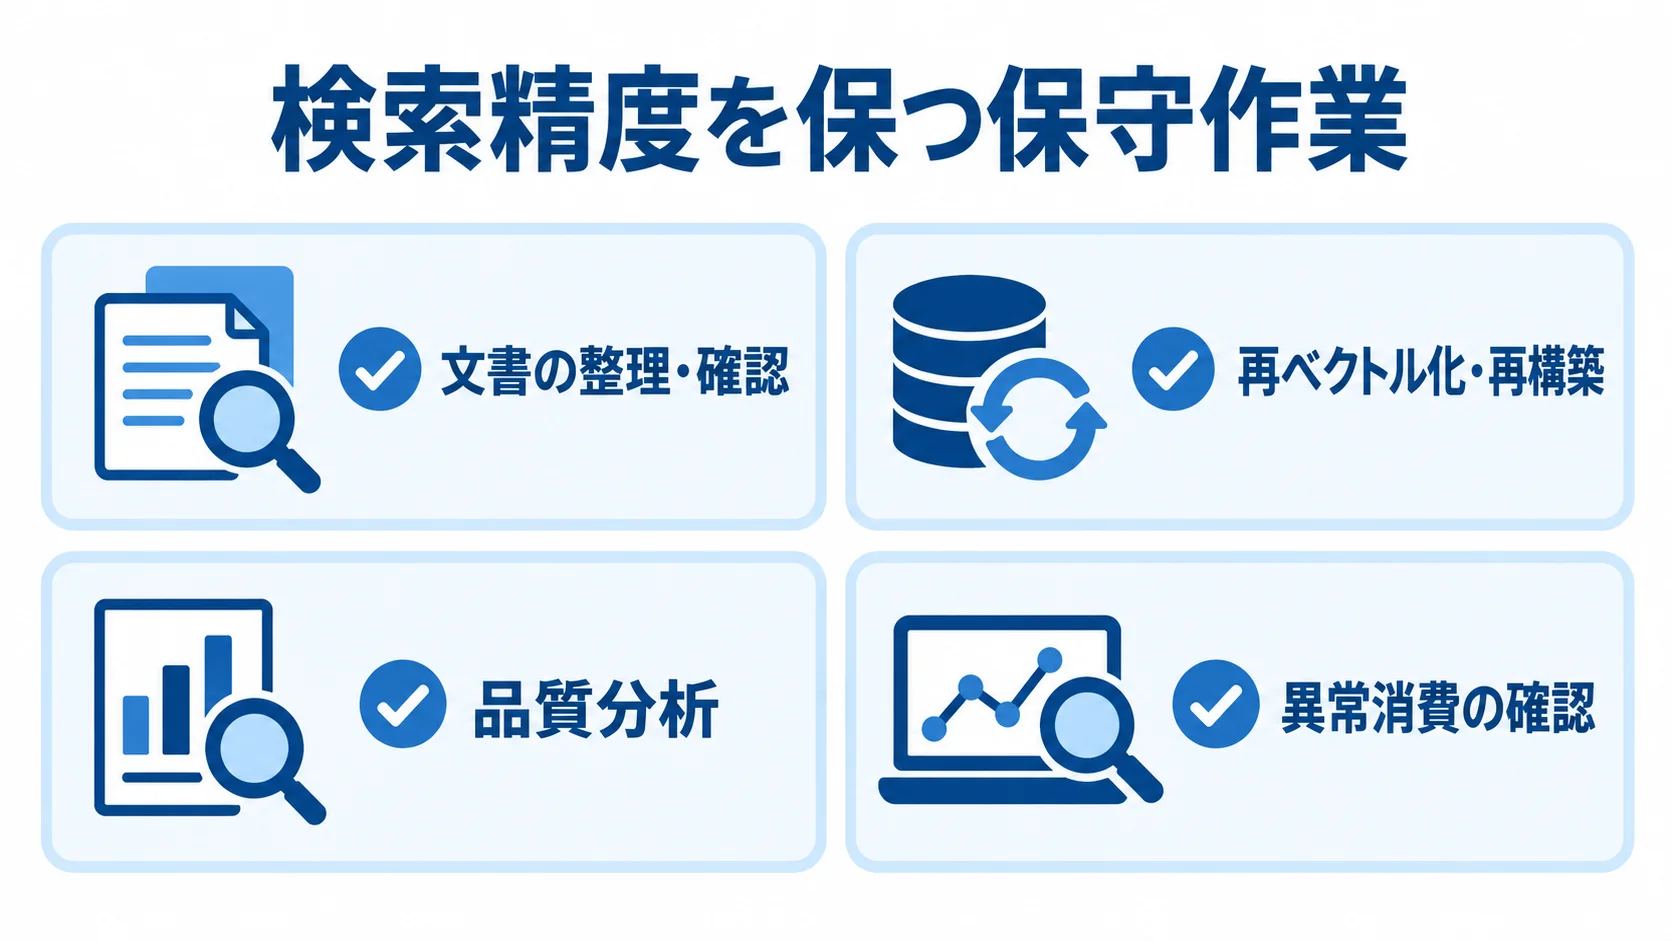
見落とされやすい一方で、長期的なコストの中核になるのが、検索精度を維持・向上させるための人的な保守費用です。
RAGの品質は参照データと利用状況に左右され、放置すれば精度は必ず劣化します。そのため、データ更新と精度監視の2つを、継続的にかかる費用として見ておく必要があります。
ドキュメント更新に伴う再Embedding・再インデックス
回答精度を保つための文書更新には、人的作業と再処理の費用がかかります。
- 文書の整理・確認:オペレーターやエンジニアの人的固定費として月15万〜40万円程度
- 再ベクトル化・再構築:データ量が多い場合、API・インフラ費として月5万〜15万円程度
embedding APIの費用は小額でも、更新対象を判断し、古い情報を洗い出す作業には人手がかかります。古い情報の削除と新しい資料の追加も、継続的に必要です。
社内規程や製品情報の更新が頻繁な企業ほど、更新運用の負荷は高くなります。そこで、更新頻度と担当体制を明確にして運用設計に組み込むと、精度の劣化を防ぎながら費用を平準化できます。
検索精度チューニング・ハルシネーション監視
品質を保つには、AIの挙動を記録・可視化して把握し、失敗ケースをもとに改善する必要があります。
- トレース・監査ツール:LangSmithやWeights & Biasesのライセンス料(利用量に応じて月3万〜10万円程度)
- 品質分析:月1〜2日分の工数、費用は月20万〜40万円
- 異常消費の確認:インフラ担当者の費用として月5万〜10万円
品質分析では、AIエンジニアが失敗ケースを抽出して改善案を作ります。異常なトークン消費やリトライループは、インフラ担当者が定期的に確認します。
監視を怠ると、品質劣化やトークンの異常消費に気づけなくなります。誤回答を放置すれば、利用者の信頼を失い、RAG導入そのものが失敗するおそれもあります。
ログ分析・品質モニタリング全体で月28万〜60万円程度が必要です。検索基盤の品質を保つ投資として、運用予算に明示しておきます。
モデルバージョンアップ対応と月額総額のイメージ
LLMは短い間隔で新しいモデルに更新されるため、その対応費用も運用予算に含めておく必要があります。
マイナー/メジャーアップデート対応の費用
LLMのバージョンアップは、マイナーとメジャーの2段階に分けて考えると、予算化しやすくなります。
- マイナー対応:3か月に1回程度、1回30万〜80万円
- メジャー対応:年1回程度、1回150万〜300万円のスポット費用
マイナー対応では、新モデルでのプロンプトの挙動を確認し、パラメータを調整します。同じプロンプトでも回答の傾向が変わることがあるため、既存のテスト用質問セットで回帰検証を行います。
メジャー対応や新モデルへの全面移行では、回帰テスト、評価指標の再設定、プロンプトの再設計などが必要です。毎月の支出にはなりませんが、年間の運用予算に含めておきます。
計画的に移行できる体制は、コスト管理に加えて、最新の性能やコスト効率の高いモデルを使い続けるための投資でもあります。
月額運用費の総額イメージ(規模別)
ここまでの費用を合算すると、規模ごとに月額運用費の幅が見えてきます。
- 小規模・限定用途:SaaSやノーコード中心で、更新頻度が低い場合は月数万円〜10万円台
- 中規模以上・フルスクラッチ寄り:月10万〜50万円以上。年間TCOで200万〜1,000万円以上になるケースもあります。
- SaaS中心:年間50万〜400万円程度に収まることが多い
フルスクラッチ寄りの構成では、インフラ・API費用に精度維持の人的費用が加わります。このため、初期費用だけでなく運用TCOも含めて、SaaSとフルスクラッチのどちらが適するかを判断します。
予算は「インフラ・API」「データ更新」「精度監視」「モデル対応」の4ブロックで積み上げます。利用拡大時に伸びやすい費目を先に把握しておくと、見通しが立ちます。
ランニングコスト最適化の技術的な勘所
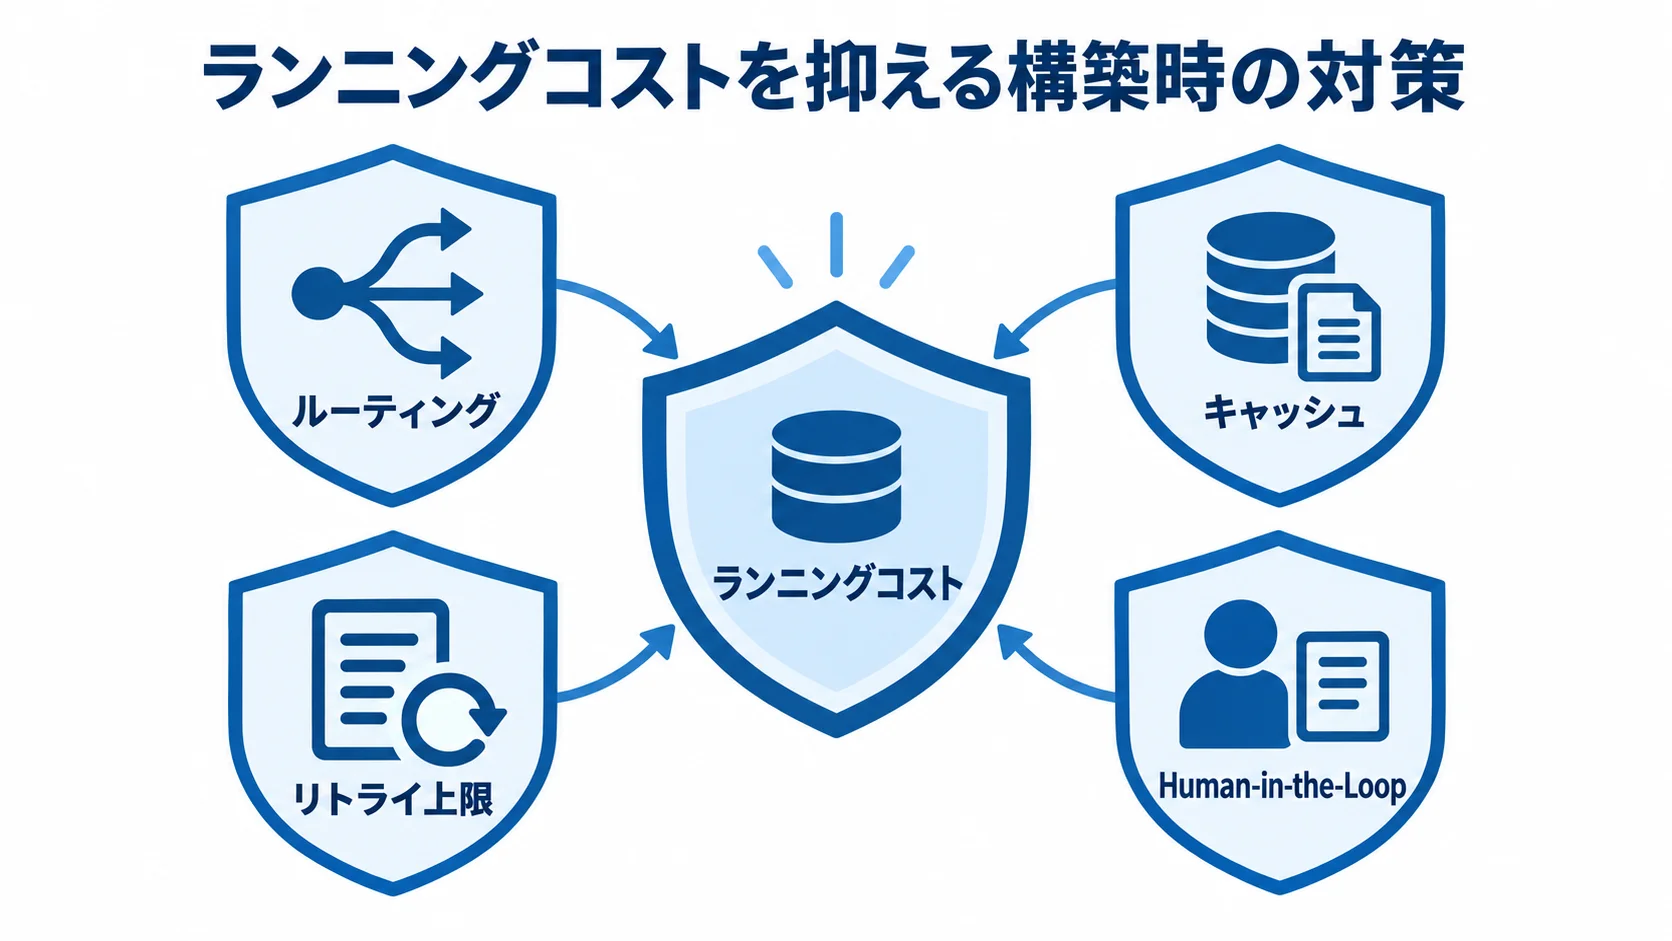
LLM APIのトークン課金や再処理費用の暴走は、構築時の技術的な工夫で抑えられます。
モデルの使い分け(ルーティング)とキャッシュ活用
ルーティングとキャッシュを構築時に設計すると、モデル利用料と再問い合わせの両方を抑えられます。
- ルーティング:複雑な判断は高性能モデル、定型処理や単純な検索は小型・低コストのモデルに振り分けて、高単価モデルの利用回数を減らす
- キャッシュ:過去の応答、検索結果、embedding生成結果を保存して再利用
キャッシュは、同じ質問や似た質問への再問い合わせを減らし、トークン消費と応答時間を抑えます。よくある問い合わせが上位に集中する業務では、特に効果が大きくなります。
運用を始めてから追加すると、改修費用がかかります。そのため、処理の振り分けとキャッシュの対象は構築段階で決めておくことが、長期的な費用効率を左右します。
リトライ上限とHuman-in-the-Loopによる暴走防止
リトライ上限と人の確認を組み合わせると、エラー時の費用増加や処理の連鎖を抑えられます。
- リトライ上限:一定回数失敗したら処理を中断し、人手に切り替える仕組み
- Human-in-the-Loop(人間による確認ステップ):迷いやすい分岐や重要な判断の前に、承認を挟む工程
RAGや外部APIのエラーをAIが解決しようとすると、無限ループに入り、一晩で多額のAPI費用が発生するリスクがあります。
完全自動化を避けると、誤った検索結果から無駄な処理が連鎖するのを止められます。また、誤回答による業務リスクも抑えられます。
トークン費用を定期的に監視して異常な消費がないかを確かめる運用を組み合わせると、ランニングコストを予測できる範囲に収められます。
まとめ
ランニングコストは、インフラ・API費用と精度を保つ人的保守費用に大別されます。ベクトルDBは月1.2万〜4万円、LLM APIは月1万〜10万円が目安です。
データ更新や精度監視の保守費用は、合わせて月数十万円規模になることもあります。中規模以上のフルスクラッチ構成は、月額10万〜50万円以上です。
年間TCOで200万〜1,000万円以上に達するケースもあります。一方、SaaS型は年50万〜400万円程度に収まることも多くあります。
初期費用だけでなく運用TCOを含めて方式を選びます。また、変動費の暴走を防ぐには、モデルの使い分け、キャッシュ、リトライ上限、Human-in-the-Loopを構築段階から設計に組み込みます。
RAGは、検索精度を育て続けて使う基盤です。人的な精度維持費用も含めて運用予算を組むことが、導入を成功させる出発点になります。
具体的な費用感を知りたいときは、複数の開発会社に見積もりを依頼します。その際、自社のデータ規模、更新頻度、想定利用量を伝えると、見積もりの前提がそろいます。
▼全体ガイドの記事
・RAG構築の完全ガイド
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。