
RAGのPoCは、実データで検索と回答の精度を確かめ、本開発に進めるかを判断する工程です。モックアップやプロトタイプは見た目や操作感を確かめるもので、精度の検証は別に行います。
PoCでは、アプリの完成度より、検索基盤とチャンキング・embeddingが自社データに合うかを検証します。
▼全体ガイドの記事
・RAG構築の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
RAG構築でPoCが欠かせない理由
RAGは、社内文書などをベクトルDBに格納しておき、LLMが回答時に関連情報を検索して使う仕組みです。AI FAQやAIチャットボットは、この検索基盤を使う応用例にあたります。
一般的な業務システム開発と比べても、RAGでは特にPoCが重要になります。検索精度は、コードの完成度よりも自社データとの相性に左右されるためです。
実際にデータを投入して検索するまで、精度は確実には予測できません。同じ技術構成でも、文書の構造や品質が違えば結果は変わります。そのため、本格的な投資の前に、実データの一部で期待する精度を確かめるPoCが欠かせません。
PoC・プロトタイプ・モックアップの位置づけ
検証段階で使うモックアップ、プロトタイプ、PoCは、確かめる対象が異なります。開発会社と発注側は、それぞれの役割を分けて、本開発の前に必要な精度検証まで進めます。
- モックアップ:UIや回答の見え方を共有し、体験のイメージを確かめます。
- プロトタイプ:DifyやLangChainなどで検索と生成を動かし、構造や操作感を見る試作です。
- PoC:実データで検索と回答の精度が業務に耐えるかを定量的に検証する工程です。
プロトタイプが動くことと、実用に足る精度が出ることは別です。そのため、検索精度の検証こそPoCの中核になります。UIや体験を確認するだけでなく、実データで精度を確かめてから、発注側が本開発の可否を判断します。
「PoC死」を避けるための実データ検証
ダミーデータでは成功しても、本番の実データで破綻する状態が「PoC死」です。これを避けるため、検証には実際の本番データの一部を含めます。
- 古い情報や表記揺れ:文書の更新状況や呼称のばらつきまで含めて調べます。
- PDFの崩れやノイズ:大量のPDFや、不要なヘッダー・フッターも検索対象にします。
- 精度の限界:実データでどこまで精度が出るかを、早めに把握します。
入力データの品質が、RAGの精度の上限を左右します。そのため、数件の整ったデモ文書だけでは、現実のノイズの影響を測れません。
PoCでは、理想条件での動作だけでなく、精度の限界まで確かめます。その限界を本開発の前に知っておくと、後工程での大きな手戻りや予算超過を防ぐ助けになります。
RAGのPoCの進め方・期間・費用感
PoCは、対象業務を1つに絞り、短期間で小さく検証するのが基本です。期間が長くなると撤退の判断が鈍り、PoCそのものが目的化してしまいます。そのため、期間と費用の枠を先に決めておきます。
スモールスタートの進め方と期間
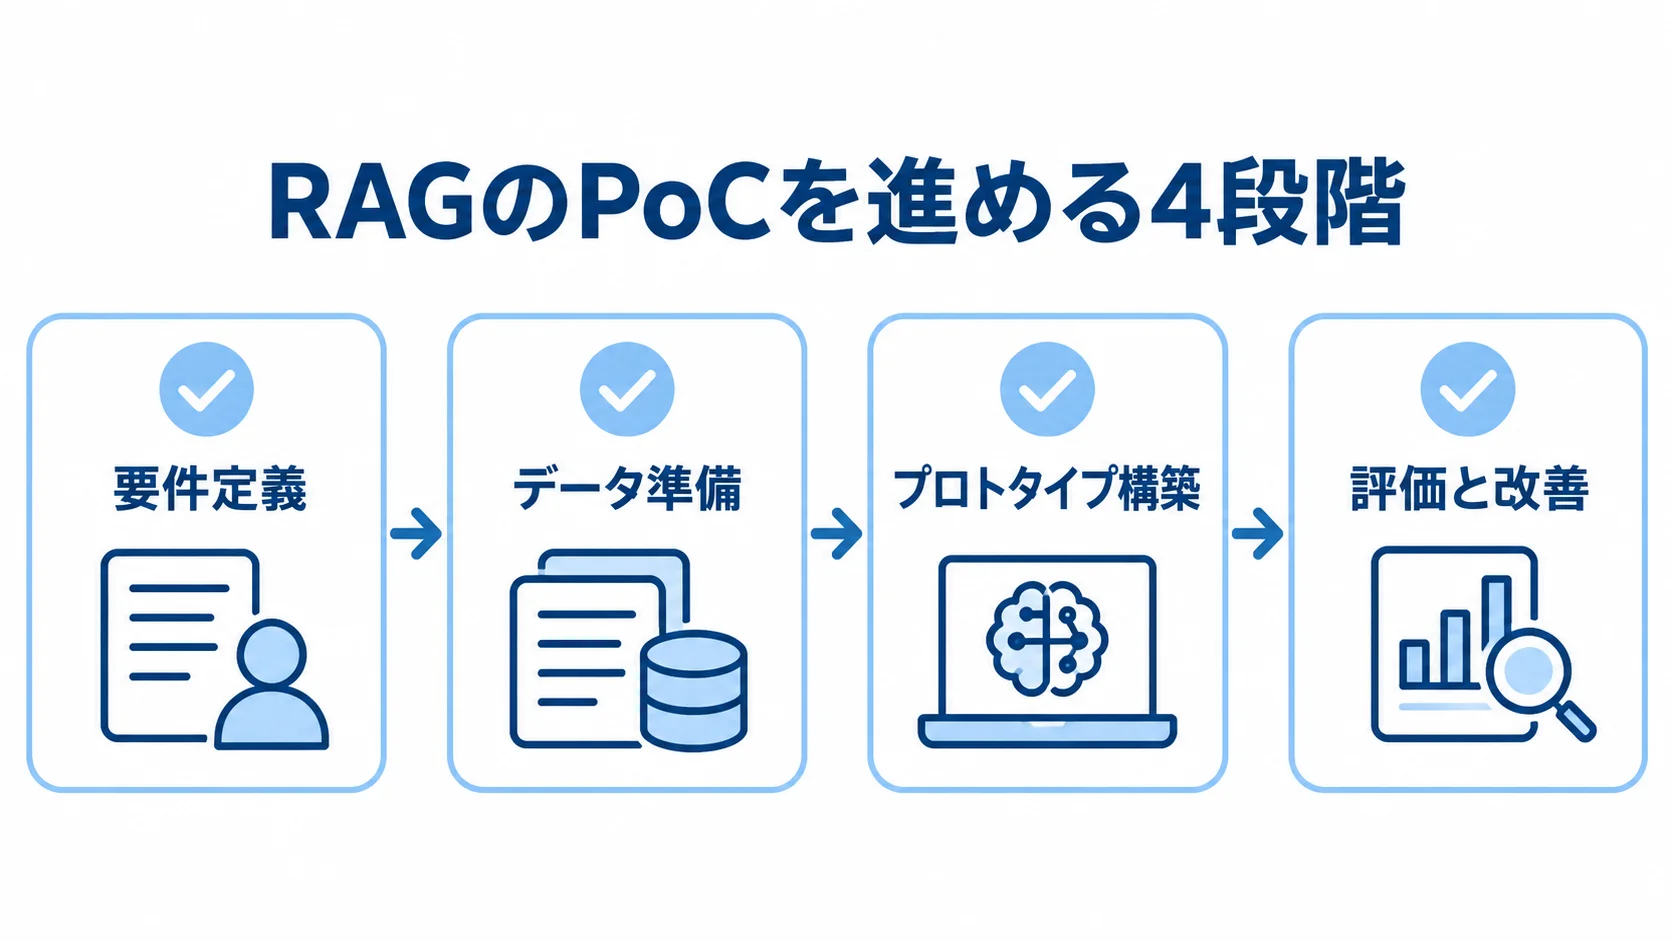
RAGのPoCは、4段階で進めます。まず、成果が見込めて効果を測りやすい業務を選び、そのうえで実データを使って検証します。
- 要件定義:対象業務を特定し、成果を測定しやすい1業務に絞ります。
- データ準備:実データの一部に前処理を施し、ノイズも含めてクレンジングします。
- プロトタイプ構築:LangChain、LlamaIndex、Difyなどで検索から生成までを立ち上げます。
- 評価と改善:チャンキング、embeddingモデル、プロンプトを調整し、精度の変化を測ります。
期間は2〜4週間を目安に、長くても1〜2か月に限ることが推奨されます。上限を決めておくと、成果が出なかった場合でも撤退の判断を保ちやすくなります。
費用感(ノーコード型/中規模PoC)
費用は検証の深さによって変わります。少数の文書で大まかな精度を確かめる場合と、本開発を見据えて技術要素を比べる場合とを分けて考えます。
- ノーコード型:Difyなどの既存SaaSによる限定検証で、50万〜150万円程度です。
- 中規模PoC:本格的なデータ連携や検索調整を含み、400万〜600万円程度です。
ノーコード型は、少数の文書で検索と生成を動かし、大まかな精度を見る方法です。一方、中規模PoCは2〜3人月が目安です。
中規模PoCでは、ハイブリッド検索やリランキングの試行に加えて、embeddingモデルの比較、評価データセットによる定量評価まで行います。
どちらを選ぶかは、RAGで解決したい課題の重要度と、本開発の投資規模で決まります。たとえば、数千万円規模の開発を予定するなら、中規模PoCで実現可能性とリスクを見極めます。
社内の感触をつかむ段階なら、ノーコード型で小さく試す方法が合理的です。ただし、中規模PoCへの投資が、全体の投資効率を高める場合もあります。
PoCで検証すべき技術要素(検索フェーズ)
RAGのPoCでは、検索(Retrieval)と生成(Generation)の2段階に分けて技術要素を検証します。根拠文書の検索と、その根拠に沿った回答の両方が精度を左右します。まずは前段の検索フェーズから見ていきます。
Retrieval精度とハイブリッド検索
検索フェーズで最初に確かめるのは、Retrieval精度(検索精度)です。これは、回答の根拠となる正解文書が、検索結果の上位K件に含まれるかを測る指標です。
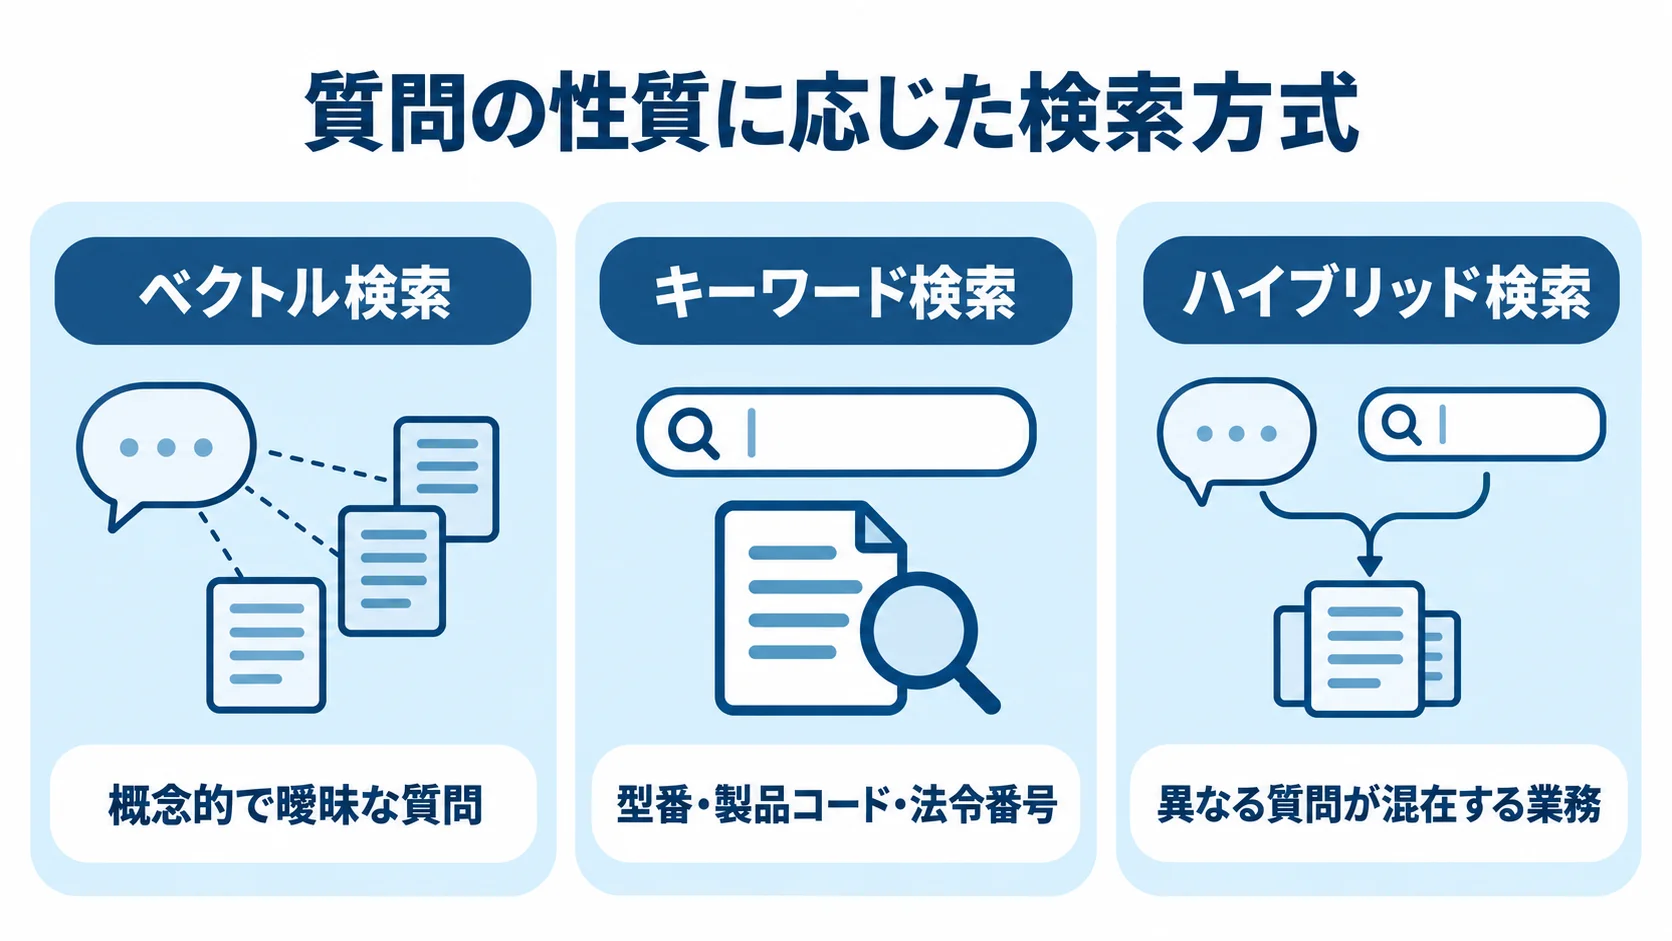
正解文書を取得できなければ、優れたLLMでも正しい回答は生成できません。そのため、質問の性質に応じた検索方式が機能するかを、PoCで確かめます。
- ベクトル検索:概念的で曖昧な質問に対し、意味の近さで文書を探します。
- キーワード検索:型番・製品コード・法令番号など、厳密な一致が必要な質問に強みがあります。
- ハイブリッド検索:異なる質問が混在する業務で、両方式を組み合わせます。
キーワード検索には、BM25などのスパース検索があります。実データと質問パターンで有効性を確かめておくと、本開発で採用する検索設計の判断材料になります。
チャンキング戦略・embeddingモデルの比較
Retrieval精度を左右する上流の設計として、チャンキング戦略とembeddingモデルを比較します。机上では優劣を決められないため、同じ質問セットで検索結果を比べます。
- チャンクのサイズ・切り方:文書の意味構造に沿う分割を複数案で比べます。
- embeddingモデル:日本語や自社ドメイン用語を適切に扱えるかを調べます。
たとえば、固定長で機械的に分割すると、見出しと本文、表とキャプションが分かれ、精度が落ちることがあります。
モデルごとに得意な言語やタスクは異なるため、業界用語や社内固有の呼称を含む実データで確認します。
PoCで比較しておくと、採用するチャンクサイズとembeddingモデルの目安がつきます。さらに、本開発での試行錯誤も減らせます。
PoCで検証すべき技術要素(生成フェーズ)と評価データセット
検索フェーズで根拠を取得できても、それに忠実に回答できなければ、RAGとしては不十分です。そのため生成フェーズでは、LLMの回答が的確で根拠に沿っているかを検証します。評価データセットは、その検証を客観的に行うための土台です。
回答品質評価(RAGAS)とハルシネーション率
生成フェーズでは、まず質問の意図に沿って的確に答えているかを評価します。その方法の一つに、RAGASなどのLLM評価フレームワークを使うものがあります。
- 文脈の適合性:Context Precision/Recallをスコアリングします。
- 回答の関連性:Answer Relevancyを評価します。
- 根拠への忠実性:Faithfulnessでハルシネーション率を確認します。
自動評価は、すべての回答を人手で目視する負担を減らし、改善効果を数値で測る助けになります。
Faithfulnessは、回答が検索文書に忠実かを測る指標です。LLMが内部の知識を混ぜて推測したり、根拠にない内容を補ったりしていないかを見ます。
誤答が許されない業務では、Faithfulnessを特に重視します。根拠の質が低く回答が難しい場合は、リランキングの導入も検討します。
リランキング(Re-ranker)は、検索結果を回答に直結する順に並べ直す仕組みです。評価を通じて、本番で必要な対策の程度を見極めます。
評価データセット作成と反復改善
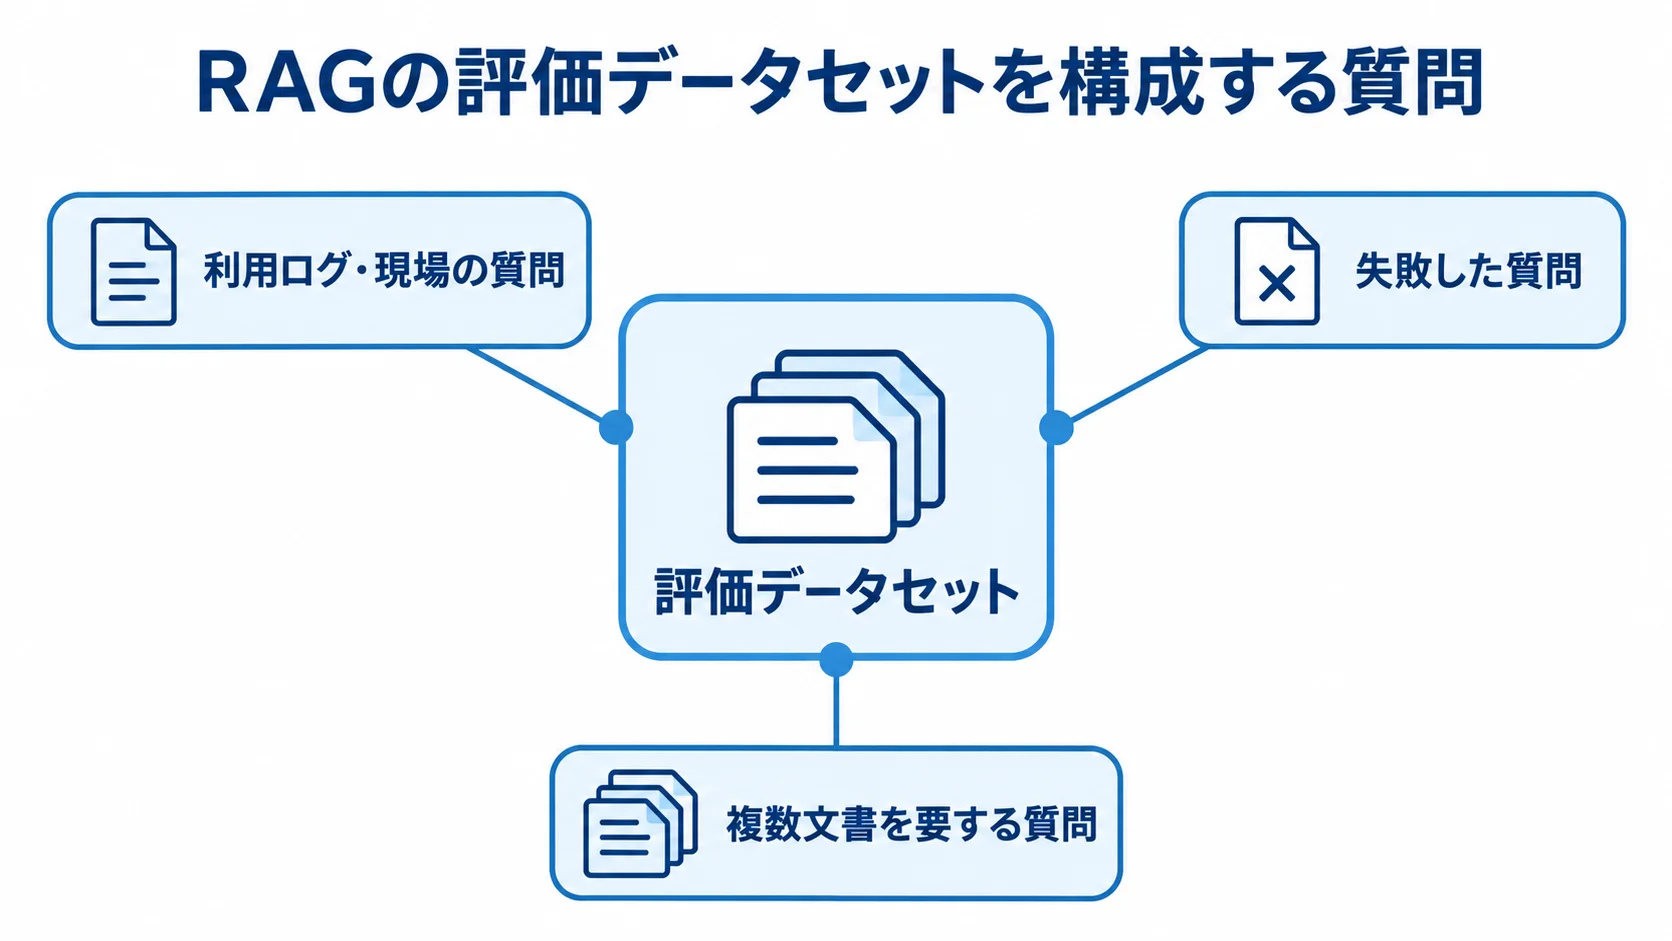
評価データセット(テストセット)は、検証を客観的かつ再現できる形で行うために必要です。
- 利用ログ・現場の質問:実際の利用状況や頻出質問を集めます。
- 失敗した質問:過去に答えられなかった質問を含めます。
- 複数文書を要する質問:文書横断が必要な問いも加えます。
同じ質問セットで改善の前後を比べれば、チャンキングやembeddingの変更が有効だったかを、数値で判断できます。
改善では、チャンクサイズを変えて再インデックスし、スコアを比較します。この反復によって、自社データに合う設定を探します。
質問セットなしに感覚で判断すると、改善の方向を誤り、期間を空費するおそれがあります。そのため、質問セットは早い段階で整えておくことが、PoCの成否を分けます。
PoCから本開発への移行判断基準(Go/No-Go)
PoCを検証だけで終わらせず次へつなぐには、開始前に本開発へ進める状態を決めておく必要があります。後から基準を決めると、判断が曖昧になりがちです。
精度・業務効率・ROIの定量基準
Go/No-Goは、精度・業務効率・ROI(投資対効果)の定量基準で判断します。業務の性質に合わせた目標を、事前に定めておきます。
- 精度:Faithfulnessなどの回答正確性を、例として95%以上に設定します。
- 業務効率:該当業務の処理時間を50%削減できるかなど、実務への効果を測ります。
- ROI:処理件数や人件費削減、費用回収までの月数を試算します。
精度の基準は業務に応じて決め、誤答リスクが高い領域ほど厳しくします。ただし、精度が高くても業務が楽にならなければ、投資の意義は乏しくなります。
ROIの試算では、月間の処理件数と人件費の削減効果に、初期開発費とAPI等の運用費を合わせて見ます。そのうえで、何か月で費用を回収できるかを確かめます。
基準は、PoC開始前に経営層と合意しておきます。そうすると解釈のぶれを抑えられ、数値で判断できます。
基準未達時の打ち手
基準に届かなくても、すぐに撤退と決める必要はありません。まず原因を切り分け、追加の改善と撤退のどちらが妥当かを検討します。
- チャンク戦略の見直し:自社データの意味構造に沿う分割を試します。
- データ整備(AI-Ready化):ノイズが多い場合、クレンジングや構造化に投資します。
- プロジェクトの撤退:精度の見込みも追加投資の余地もなければ、いったん見送ります。
チャンクの切り方がデータの構造に合わないと、検索精度が下がることがあります。そのため、意味構造に沿って切り方を改めると、精度が改善する場合があります。
また、元データのノイズが精度の上限を下げている場合は、クレンジングや構造化が効果的なことがあります。
打ち手を検討したうえで判断し、基準を満たした場合にだけ本開発へ移行します。PoCは2〜4週間、数十万〜数百万円の投資です。この投資は、数千万円規模の本開発が空振りに終わるリスクを避けるための保険となります。
まとめ
PoC・プロトタイプ・モックアップの違いから、進め方と費用、検索と生成の検証、評価データセット、Go/No-Go基準までを見てきました。
RAGでは検索精度が自社データとの相性に左右されるため、実データを使ったPoCが重要です。整ったダミーデータだけで検証するのは避けます。
対象業務を1つに絞り、期間は2〜4週間を目安に進めます。ノーコード型は50万〜150万円、中規模PoCは400万〜600万円が目安です。
検索フェーズでは、Retrieval精度やハイブリッド検索を含め、チャンキングとembeddingを検証します。一方で、生成フェーズではRAGAS等を使って品質を測ります。
評価データセットで反復改善し、精度・業務効率・ROIの基準を開始前に合意します。そのうえで、数値に基づいて本開発への移行を決めます。
PoCの数十万〜数百万円の投資は、本開発の失敗リスクを避けるための、費用対効果の高い保険です。まず対象業務を1つ選び、実データで検証します。
▼全体ガイドの記事
・RAG構築の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。