
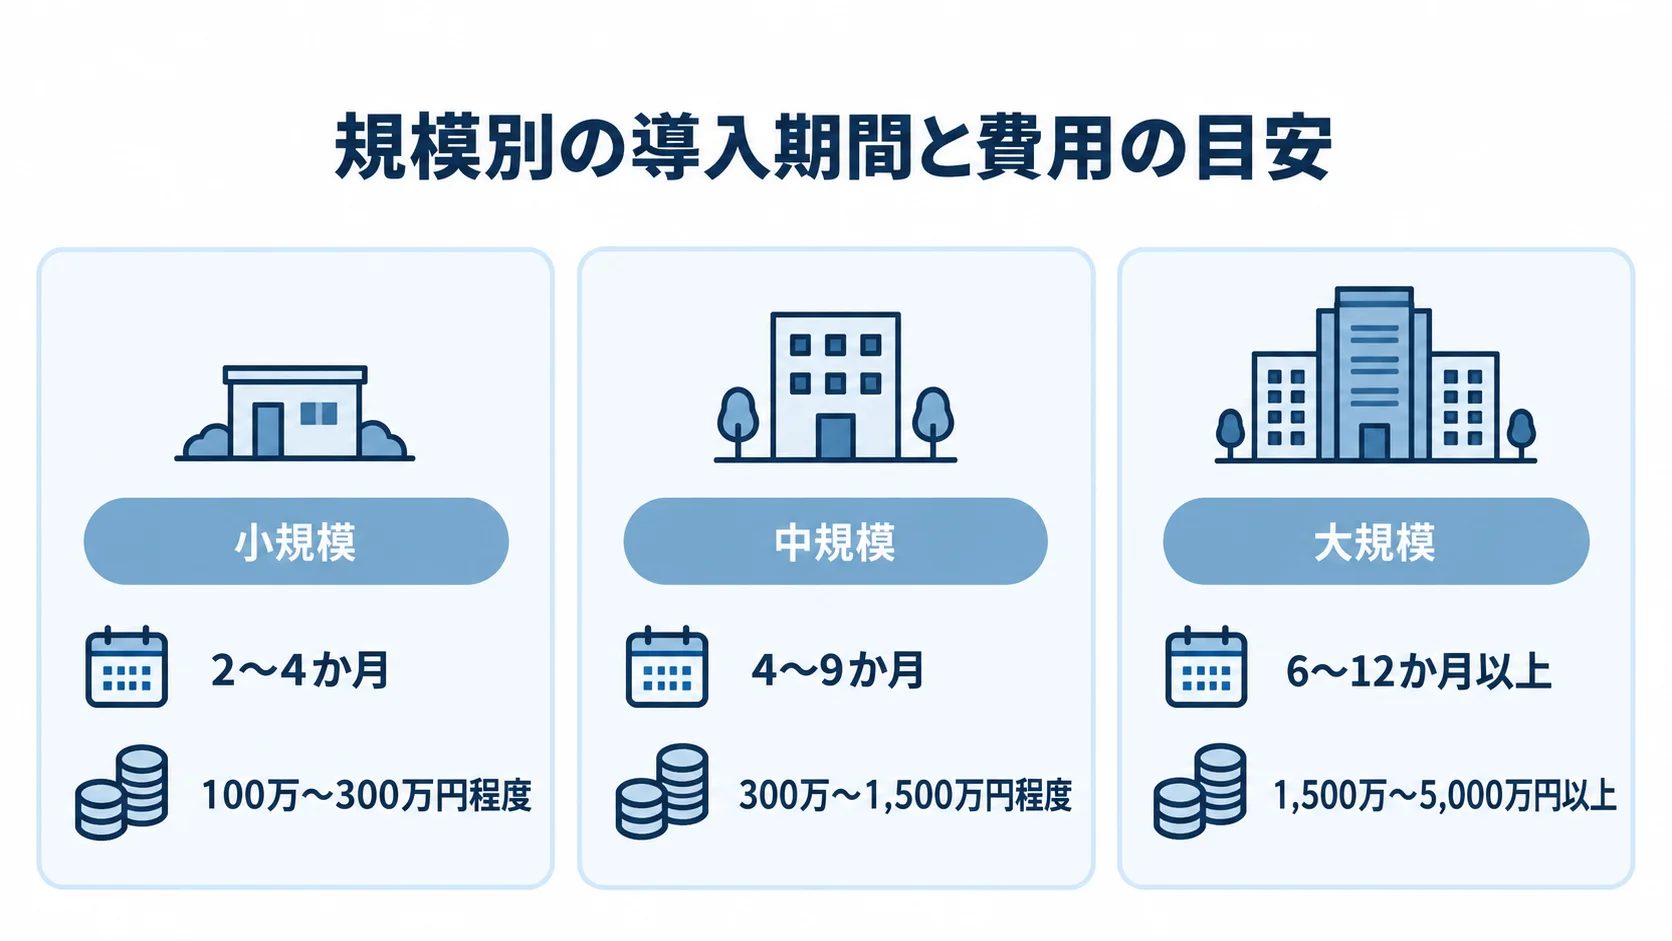
Amazon Redshiftの導入期間は、規模により小規模で2〜4か月、中規模で4〜9か月、大規模で6〜12か月以上が目安です。要件定義、設計・構築、テスト・移行の順に進めると、分析基盤の本稼働につながります。
導入の全体像は、Amazon Redshift導入の完全ガイドもあわせてご覧ください。
▼全体ガイドの記事
・Amazon Redshift導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Amazon Redshift導入の開発期間の全体像
Amazon RedshiftはAWSのフルマネージド型クラウドDWHで、テラバイトからペタバイト級のデータを分析できます。
列指向ストレージとMPP(大規模並列処理)により、従来のオンプレミスDWHで数時間かかる集計を、数分から数秒で実行できます。
用途は、経営ダッシュボードやマーケティング分析のほか、IoTデータ分析や機械学習の前処理基盤まで広がっています。
Redshiftは、エンジン自体の構築やチューニングの工数が小さいため、作業の中心はデータ移行と加工、モデリングと可視化になります。この特性が、納期見積もりの土台になります。
導入期間は、データ量、既存システム数、分析要件の複雑さによって変わります。全社のデータや分析を一度に網羅すると、期間が延びてプロジェクトが頓挫しやすくなります。そこで、規模別の期間目安をもとに計画を立てることが、現実的な第一歩になります。
事業課題に直結する1〜2のユースケースに絞るMVP(実用最小限の製品)なら、3〜6か月で早期に成果を目指せます。
規模別の導入期間と費用の目安
期間と初期費用は、データソース数や基盤に含める機能によって異なります。規模は、単一システム、複数ソース、全社基盤の3段階で見ると分かりやすくなります。
- 小規模:単一システムと基本ダッシュボードで2〜4か月、100万〜300万円程度
- 中規模:複数ソースや部門横断基盤で4〜9か月、300万〜1,500万円程度
- 大規模:全社基盤やAI活用を含み6〜12か月以上、1,500万〜5,000万円以上
小規模では、基幹系やSaaSのデータをRedshiftに集約し、売上や在庫を可視化します。
Serverlessや小規模RA3、AWS Glueなどのマネージド型ETLを使えば構成を簡潔にでき、短期間で立ち上げられます。
中規模では、複数の基幹システムやSaaS、ログを統合し、部門横断のKPIと権限管理を備えます。
データモデル、ETL/ELT、複数ダッシュボードの整備が中心になります。
中規模の体制は、データエンジニア、BIエンジニア、プロジェクトマネージャーで組みます。
大規模では、Amazon S3のデータレイク連携やAI・機械学習の前処理も含みます。大量データの性能設計、厳格なガバナンス、全社への段階的な展開が必要になるため、見積もりには十分な余裕を取ります。
導入期間を左右する変数
同じ中規模でも、4か月で済む場合と9か月かかる場合があります。その差は、主にデータの品質や連携方法、既存のAWS環境の使い方によって生まれます。
- データ品質:表記ゆれ・重複・欠損が多いと、名寄せやクレンジングに数か月かかる場合があります
- 移行元と連携方式:データソースの数が増えるほど、ETL/ELTの設計・実装・テストの工数が増えます
- AWSの利用状況:既存のVPCやIAMを流用できれば、セキュリティ設計と構築を圧縮できます
- 分析要件:定型レポートか、部門別の指標やドリルダウン分析かで作り込みが変わります
要件定義で条件を洗い出しておけば、納期を見積もる材料がそろいます。
早くデータ活用を始めたい場合でも、前処理が期間の大部分を占めることがよくあります。
工程別のスケジュールと期間配分
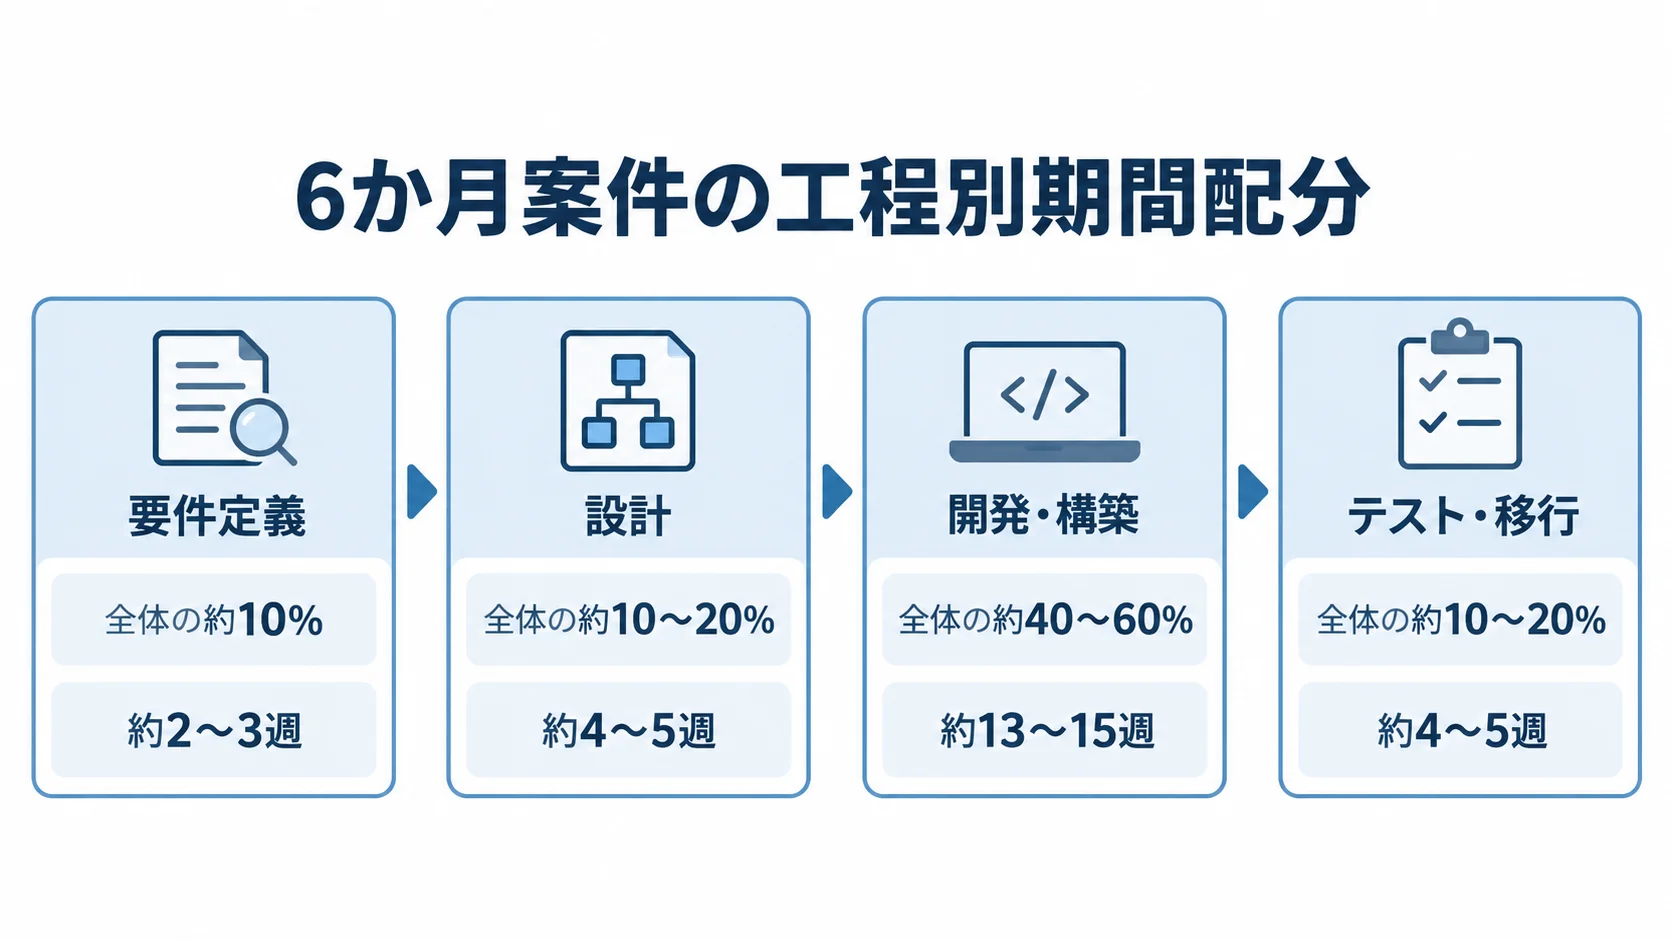
6か月(約26週)の中規模案件では、要件定義・技術選定から運用開始までの期間を、工程ごとに配分します。
- 要件定義:全体の約10%。6か月案件では約2〜3週
- 設計:全体の約10〜20%。6か月案件では約4〜5週
- 開発・構築:全体の約40〜60%。6か月案件では約13〜15週
- テスト・移行:全体の約10〜20%。6か月案件では約4〜5週
開発・構築は、最も工数が大きい山場です。
データ設計とKPI設計は要件定義・設計の重要な論点で、集約の粒度や指標の判断が、構築工数と実用性を左右します。
要件定義と設計に十分な時間を取ることが、結果として納期を守ることにつながります。
要件定義・技術選定フェーズ(全体の約10%)
要件定義では、何のデータを誰が分析し、どの意思決定に使うかを決めます。
範囲とKPIは、事業課題から決めます。「流行っているからRedshift」のように、技術を先に決めることは避けます。
要件定義・技術選定は、Amazon Redshift導入の成否を左右します。
- 分析要件:対象業務のKPI、必要なデータソース、データ発生量、更新頻度の整理
- Redshiftの方式:データ量・利用パターン・運用体制から、従来のクラスターか自動スケールするServerlessかの選択
- 周辺サービス:S3との役割分担、AWS GlueなどのETL/ELT、BIツールの選定
断続的な利用や利用量が読めない初期段階では、Serverlessが候補になります。
安定した大規模な運用では、リザーブドインスタンスを使うプロビジョンド型が向きます。
BIツールには、Amazon QuickSightやTableauのほか、Power BIやLooker Studioなどがあります。こうした方針を文書に残しておくと、後工程での手戻りを防げます。
期間の目安は1〜3週間です。
設計・構築フェーズ(全体の約50〜70%)
設計・構築は全体の5〜7割を占め、作業は次の3つの領域に分かれます。
- 設計:スタースキーマなどのデータモデル、KPI、ダッシュボード、IAMやスキーマ権限
- 基盤と連携:クラスターまたはワークグループ、VPC、セキュリティグループの設定
- データと可視化:ETL/ELT、初期ロード、差分連携、BI接続とダッシュボードの実装
Redshiftでは、サーバー構築やパッチ適用、バックアップをAWSが担います。このため、開発チームは加工ロジックとモデリングに集中できます。
作業は2週間〜1か月単位のスプリントに区切り、できた成果を定期的に確認します。
SQLのビューやdbt(data build tool)によるELTでは、変換ロジックをコードで管理します。そこにレビューとテストを組み込めば、品質を保てます。
中規模の期間は13〜16週程度が目安です。
テスト・移行・運用開始フェーズ(全体の約10〜20%)
本番運用に移る前に、要件と集計結果を検証します。なかでも数値検証は、連携の欠損や集計ミスを見逃すと意思決定を誤らせるため、欠かせません。
- 数値検証:既存帳票や現行システムとの集計値の突き合わせ
- 性能検証:想定データ量でのクエリの速さと、分散キー・ソートキーの確認
- アクセス検証:権限設定が意図どおりに働くかの確認
数値の整合性の確認は、工数の読みが外れやすい作業です。
テストの後は、ユーザー受け入れテスト(UAT)を行い、一部の部門やユースケースから使い始めます。
全部門へ一斉に広げず、まずパイロット部門に使ってもらいます。寄せられた意見をもとに、モデルやダッシュボードを継続的に改善します。
リリース後も性能とコストを監視します。
この工程は3〜5週程度が目安です。
Redshiftならではの期間短縮の仕組み
Redshiftは、オンプレミスやフルスクラッチの構築に比べて導入期間を短くしやすいサービスです。エンジンと運用インフラの大部分をAWSが管理するためです。
期間短縮を支えるのは、既存のAWS環境を流用することと、マネージドサービスを使うことです。
サーバーの調達やOSの導入、バックアップなど、数週間から数か月かかる作業も、コンソールやAPIで進められます。
既存AWS環境の流用による構築工数の圧縮
AWS上で基幹システムやWebサービスが稼働していれば、既存環境を使うことで構築工数を圧縮できます。流用できる資産は、事前に洗い出しておきます。
- ネットワーク:VPC、サブネット、セキュリティグループの活用
- 運用基盤:IAMによる権限管理、監視、ログ収集の利用
- データ連携:RDSやAurora、S3との転送設計の簡素化
S3のデータは、COPYコマンドやRedshift Spectrumで取り込めます。
AWSを初めて本格的に使う場合は、アカウント、ネットワーク、セキュリティの初期整備に要する期間も、見積もりに含めます。
既存資産を流用できるかどうかは、導入期間に直結します。そのため、要件定義の段階でAWSの利用状況を一覧にしておきます。
マネージドサービスとServerlessによる立ち上げ加速
Redshiftは短時間でクラスターを起動でき、パッチ、バックアップ、障害復旧をAWSが担います。Redshift Serverlessであれば、クラスターのサイズを事前に見積もる必要もありません。
- 即時起動:ワークグループを作成すれば、すぐにクエリを実行できます
- 自動スケール:ワークロードに応じて処理能力が変わる仕組み
- 一時停止:未使用時は自動で停止し、課金も止まります
従来のオンプレミスDWHでは、サーバー調達に数週間、セットアップとチューニングにも数週間かかります。一方でRedshiftは、これらの準備をコンソールやAPIで進められます。
PoC(概念実証)やプロトタイピングと相性がよく、要件定義と並行して実データを検証できます。インフラ構築や運用設計の時間を減らせる点が、納期短縮に直接つながります。
Redshift導入で納期を短縮する具体的な方法
マネージドサービスの利点に進め方の工夫を重ねると、納期をさらに短くできます。その中心になるのが、MVPとスプリントによる段階的な展開です。
1〜2ユースケースに絞ったMVPアプローチ
全社のデータと分析を一度に対象にすると、要件や連携先が増えます。その結果、合意にも時間がかかり、本番が遠のきます。
最初の範囲を絞ることは、納期短縮に最も効果があります。範囲は、成果と事業への影響を基準に選びます。
- 売上・粗利:月次の数値を、商品と店舗の軸で見られるようにする
- マーケティング:施策ごとのCVRを、ひとつの画面で確認できる状態
意思決定に直結するテーマを1つ選び、1〜2のユースケースでPhase 1(MVP)を構築します。対象が絞られるほど、連携するデータソースやデータモデルも限定できます。
3〜6か月で成果を出せれば、社内の理解と予算を得て、Phase 2以降へ進みやすくなります。
全社基盤を一度に作るより、小さく作って早く価値を出し、段階的に育てるほうが、結果として最短になります。
アジャイル・スプリントと段階的ロールアウト
スコープを絞ったうえで、開発・構築を2週間〜1か月単位のスプリントに分け、アジャイルに進めます。短いサイクルは、手戻りを減らすことにつながります。
- 成果の確認:各スプリントの終わりに動くダッシュボードを見せる
- 早期修正:指標定義や必要な切り口のずれを、早い段階で見つけて直すこと
- 段階展開:パイロット部門から始め、対象を広げていくこと
データの取り込みや集計から、ダッシュボード表示、意見収集までを、短い周期で繰り返します。
ウォーターフォール型と比べると、実際の活用の姿をつかみやすく、手戻りも減らせます。
パイロット部門で利用者の意見を集め、運用課題やデータ不整合を確かめます。モデルやダッシュボードを改善してから、対象を広げます。
段階展開は、大きな手戻りや運用トラブルによる遅延を防ぎ、全体の納期を守るための方法です。
納期遅延の典型要因と対策
Redshiftはマネージド構造によって納期短縮に寄与します。一方で、DWH導入には固有の遅延リスクもあります。
遅延の要因を把握して対策を講じておくと、スケジュールの破綻を防げます。
遅延要因のうち発生が多いのは、次の2つです。
データ品質・前処理の見積もり漏れ
Redshift導入で最も多い遅延要因は、元データの品質問題です。
基盤の構築が順調でも、実データを取り込むと、表記ゆれ(同一取引先の別名登録)や重複が見つかります。欠損や形式の不統一が混じることもあります。前処理だけで数か月かかることもあるため、データ整備は見落としやすい大きな山場です。
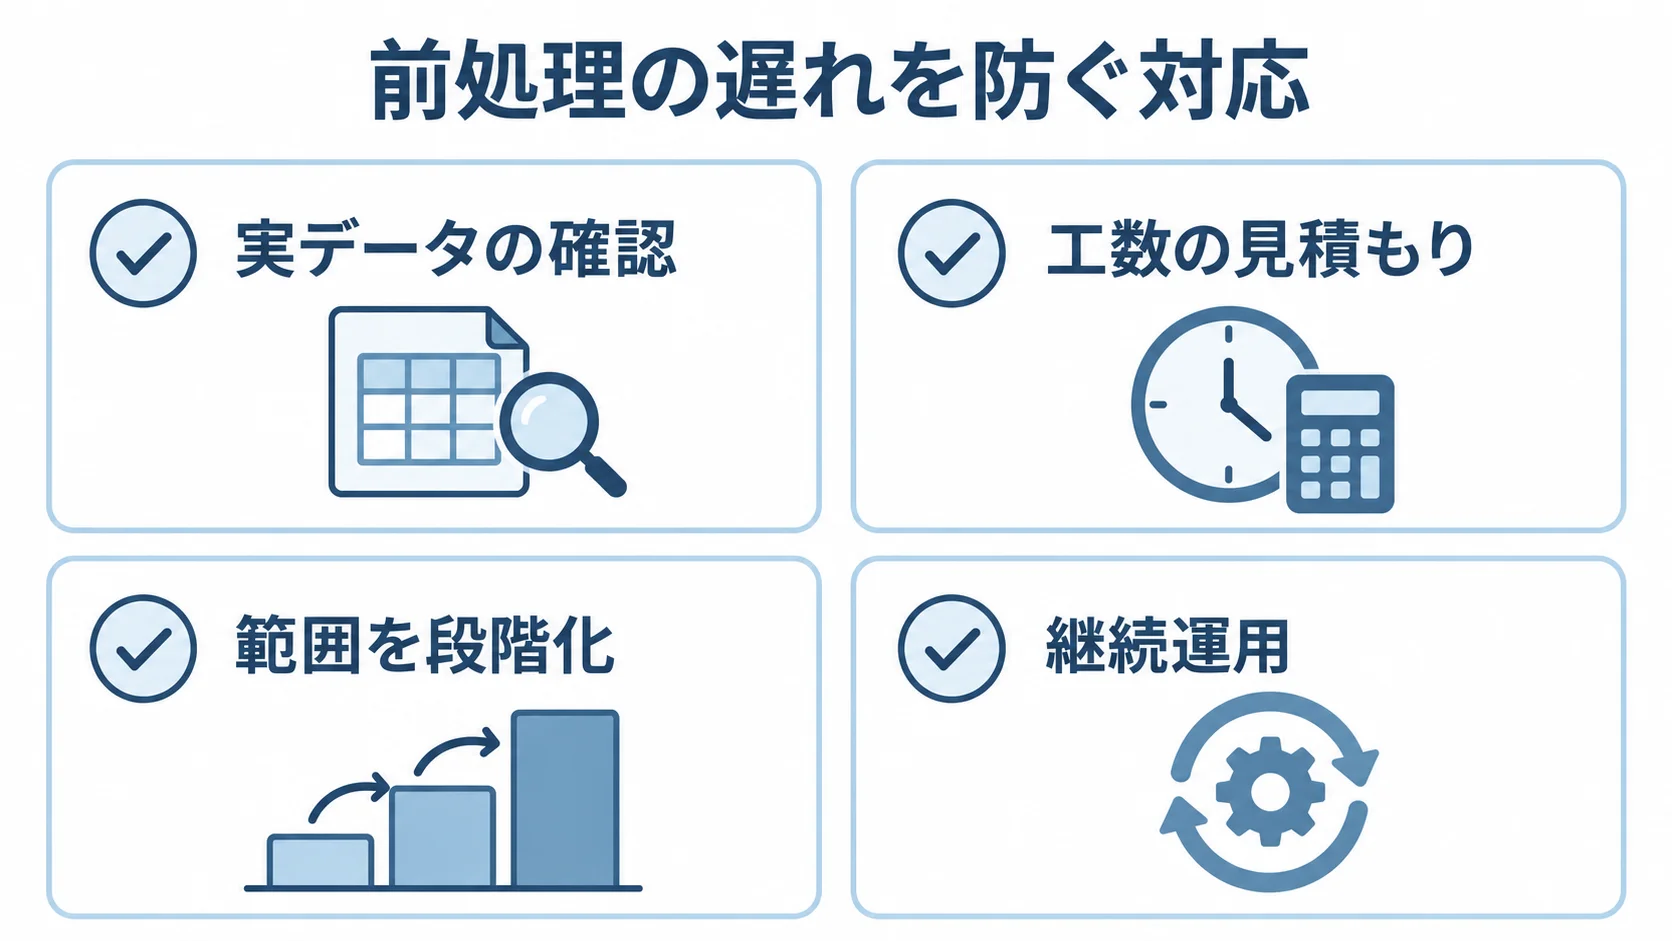
前処理の遅れを防ぐには、データの状態を早い段階で確かめ、その手間を見積もりに入れておくことが大切です。
- 実データの確認:要件定義の段階でサンプルを見て、品質を把握する
- 工数の見積もり:前処理の作業量を含め、データが整っている前提を置かない
- 範囲を段階化:優先するユースケースに必要なデータから整備する
- 継続運用:クレンジングのルールと、それを維持する体制
マスターデータは完璧になるのを待たず、改善を重ねながら進めます。
データ整備が長引かない体制も、遅延の連鎖を防ぐうえで欠かせません。
スコープの拡大と数値検証の工数
要件が膨らむことと、数値検証の見積もりが外れることも、典型的な遅延要因です。完成後に関係者から指標の追加や別の切り口の要望が増えると、データやモデルの手戻りが起きます。そのため、要望の受け付け方と検証の準備を、初回の計画に組み込んでおく必要があります。
- 変更管理:追加要望の影響範囲と工数の見積もり、関係者との合意
- バックログ化:Phase 2以降の要望としての記録と、初回範囲の維持
- 検証準備:サンプルデータと期待値の早めの用意
- テスト期間:集計値の確認に必要な期間の確保
見た目の実装以上に、帳票や既存システムとの数値照合に工数がかかります。
差異が出た場合は、連携と集計ロジックのどちらに原因があるかを切り分けます。
検証を後回しにすると、リリース直前に遅れが表面化します。
まとめ
Amazon Redshiftの導入期間は、小規模で2〜4か月、中規模で4〜9か月、大規模で6〜12か月以上が目安です。計画では、規模に加えてデータの状態も踏まえることが大切です。
工程ごとの期間配分の目安は、要件定義が約10%、設計が約10〜20%です。開発・構築は約40〜60%、テスト・移行は約10〜20%です。
既存AWS環境を流用すればセキュリティ設計を圧縮でき、Redshift Serverlessの即時起動も納期短縮に役立ちます。これらは、他のDWHと比べた期間面での強みです。
1〜2ユースケースのMVP、2週間〜1か月のスプリント、パイロット部門からの段階展開を組み合わせると、価値を出しながら本稼働を目指せます。
データ品質の問題、要件の拡大、数値検証の不足は、いずれも遅延につながります。そのため、実データの早期確認、変更管理、十分なテスト期間を計画に組み込み、自社に合うスケジュールと体制を検討します。
▼全体ガイドの記事
・Amazon Redshift導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。