
Amazon Redshiftは、Amazon Web Services(AWS)が提供するフルマネージドのDWHです。大容量データの高速分析に広く使われ、エンジンは自作せず、周辺を要件に合わせて作り込みながら段階的に広げるのが合理的です。
▼全体ガイドの記事
・Amazon Redshift導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Amazon Redshift導入とフルスクラッチ開発の関係
Amazon Redshiftの導入とフルスクラッチ開発は、組み合わせて使えます。フルスクラッチという言葉には、大きく二つの意味があります。
一つは、既存製品を使わず、DWHエンジンそのものをゼロから開発することです。もう一つは、Redshiftを土台にして、データパイプラインやデータモデル、分析アプリを要件に合わせて作り込むことです。特に、エンジン自作と周辺開発の違いを押さえておくことが、適切な方針を選ぶ出発点になります。
フルスクラッチとパッケージ・マネージドの違い
方式ごとの自由度と負担を比べると、Redshiftを使う位置づけが見えてきます。
- フルスクラッチ:既製品に頼らず、要件に合わせてゼロから構築する方式です。
- パッケージ導入:既製ソフトを設定やカスタマイズで調整して使う形です。
- マネージドサービス:クラウド基盤の運用を任せ、その上で動くロジックを自社で開発する方式です。
フルスクラッチは制約が少なく拡張性に優れますが、コスト(Cost)と導入期間(Duration)の面で負担が大きくなります。一方、パッケージは短期間・低コストで導入できる反面、製品の枠を超える要件には対応しづらい方式です。
マネージドサービスでは、たとえばRedshiftの場合、DWHエンジンを任せ、自社固有のデータ統合や指標設計に開発リソースを集中できます。
この構成なら、フルスクラッチの自由度を必要な範囲で活用できます。マネージド基盤とオーダーメイド開発を組み合わせる点に、合理性があります。
DWHエンジンの自作が現実的でない理由
RedshiftのようなクラウドDWHには、多くの高度な機能が備わっています。DWHエンジンを自作するなら、次のような機能を自前で用意しなければなりません。
- データ処理:列指向ストレージ、大規模並列処理(MPP)、データ圧縮
- クエリと保護:クエリ最適化、自動バックアップ、障害時の自動復旧
- 拡張:ノードの追加・削除によるスケーリング
これらをゼロから実装すると、開発には何年もかかり、費用は数億円規模に膨らみます。さらに、AWSが継続的に積み重ねてきた品質や性能に追いつくことも、ほぼ不可能です。
完成後の保守や機能追加、セキュリティ対応も自社で担うため、運用の負担は計り知れません。世界中で使われ、改良が続く成熟したマネージドDWHを土台にするのが合理的です。
自社が投資すべきなのは、自社データから価値を引き出す分析ロジックや活用の仕組みです。DWHの仕組みそのものは、マネージドサービスに任せられます。そのため、限られた開発リソースを競争力につながる部分へ振り向けます。
Redshift導入における「オーダーメイド」の領域
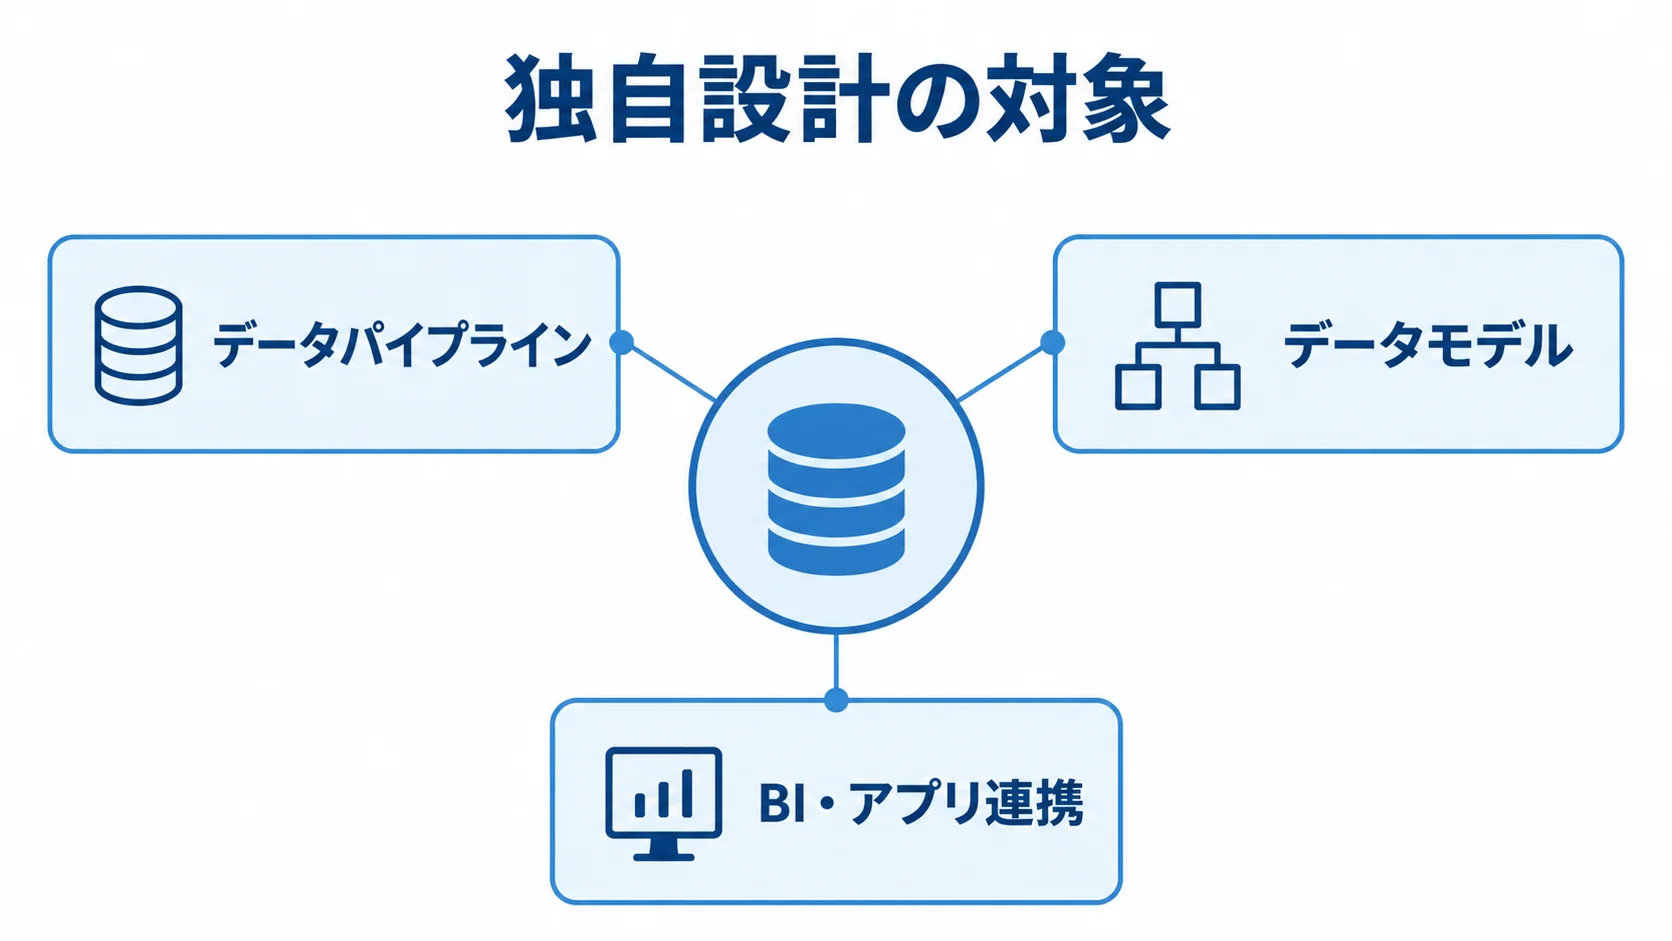
Redshiftを土台にしつつ、自社の業務や分析要件に合わせた独自開発も必要です。主な領域は、データパイプラインと、データモデル・BI・アプリ連携です。
データパイプライン(ETL/ELT)のカスタム開発
データパイプラインは、各ソースからデータを取り込み、分析に使える形に整える処理です。Redshift導入のなかでも、特にオーダーメイド性が高い領域です。
ETL(Extract・Transform・Load)とELT(Extract・Load・Transform)は、データを抽出・変換・読み込む工程です。基幹システムやSaaSのデータ、ログ、外部データを、Redshiftで分析できる形に整えます。
- 抽出・取り込み:ソースからデータをRedshiftへ届けます。
- 整形:名寄せやクレンジング、変換、結合を行います。
- テーブル化:分析に使える粒度でデータを整えます。
ソースの種類やデータの持ち方、業務ルールは企業ごとに異なるため、自社に合わせた処理が必要です。土台にはAWS GlueなどのマネージドETLサービスを、変換管理にはdbt(data build tool)を使い、固有のルールを実装します。
ETL基盤そのものはゼロから作らず、業務フローやデータ構造に固有の部分に絞ります。そうすると、開発コストと保守性のバランスを取りやすくなります。
データモデル設計とBI・アプリ連携
データモデルは、Redshift内でデータを保持するテーブルの構造、粒度、関係性の設計です。分析の使いやすさとクエリ性能を左右します。
スタースキーマやディメンショナルモデルの組み方、指標を集計する粒度は、自社が何をどう見たいかに直結します。特に、要件に沿って設計する価値が高い領域です。
経営ダッシュボードや現場の画面、自社サービスのアプリなどが、Redshiftのデータを使う利用先になります。利用先に応じて連携開発が必要になるため、代表的な連携先を3つ挙げます。
- BI:Amazon QuickSight・Tableau・Power BI・Looker Studioなど
- 社内システム:Redshiftへのクエリ連携
- 機械学習:前処理データの受け渡し
分析結果の表示にはBIツール、機械学習にはAmazon SageMakerなどのマネージドサービスを使えます。サービスを組み合わせ、自社固有の要件を作り込むことで、データ基盤を競争力につなげられます。
フルスクラッチが選ばれる基準とコスト
広範な独自開発が妥当かどうかは、要件によって異なります。
フルスクラッチが妥当なケースの判断基準
Redshiftを土台にしても、どこまで作り込むかは要件によって変わります。独自開発を検討する場面は、2つあります。
- 独自ロジックが競争力になる:業界固有の知識を取り入れる場合
- 外部サービスを使えない:機密性や規制上の制約がある場合
汎用BIや標準集計では差がつかず、独自の分析モデルや処理が事業の優位性を生むなら、その部分に投資する意義があります。また、データを外部のAPIへ渡せず、処理を自社の管理下で完結させる必要がある場合は、独自の構築が避けられません。
こうした理由がないままフルスクラッチを選ぶと、費用対効果の破綻を招くことがあります。たとえば、開発費用が10倍になっても成果は1.2倍にとどまる、といった事態です。
標準製品やマネージドサービスで実現できる部分は任せ、独自開発が必要な範囲を見極めます。作り込みをその範囲に集中させると、投資の無駄を減らせます。
フルスクラッチの費用相場と契約形態
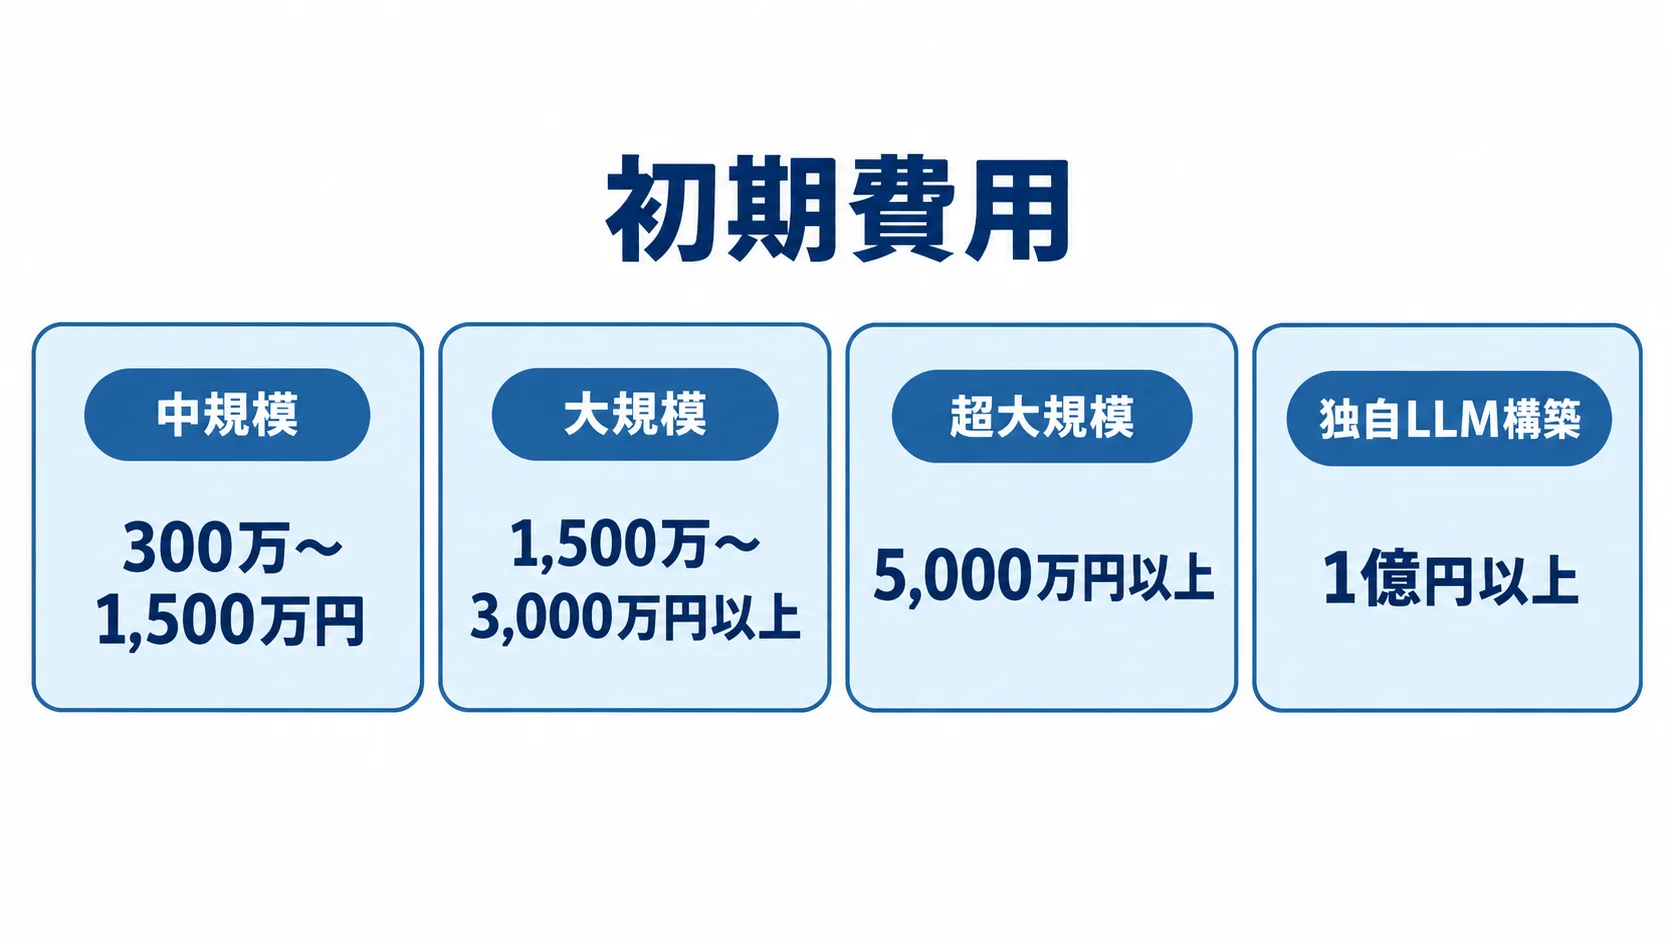
Redshiftを土台にした開発費は、作り込みの範囲によって変わります。初期費用は、規模と、機械学習・AIなどの機能の有無が目安になります。
- 中規模:複数データソースとKPI設計を含み、権限管理と複数ダッシュボードも備える分析基盤。初期開発費は300万〜1,500万円
- 大規模:全社基盤に機械学習やAIを組み合わせ、1,500万〜3,000万円以上
- 超大規模:独自モデル構築まで進める場合は5,000万円以上
- 独自LLM構築:1億円以上に達するケースもある
大規模な開発では、期間が6か月〜2年におよびます。さらに、見積もりでは規模だけでなく、契約形態による費用差も確認しておきます。
請負契約は、完成させる責任を開発会社が負う契約です。仕様変更が起きやすい分析案件では、開発会社がリスクを見積もりに含めるため、実工数で精算する準委任契約と比べて、おおむね1.3〜1.5倍の係数がかかります。
たとえば、準委任で500万円を想定していた案件なら、請負では650万〜750万円になるイメージです。探索的な段階は準委任で進め、要件が確定してから請負に切り替える方法もあり、費用を妥当な水準に保つのに役立ちます。
Redshift活用型オーダーメイド開発の進め方
Redshiftを土台に進めるときは、作り込みすぎない設計が欠かせません。既存サービスの活用と段階的な構成、マネージド製品とカスタム開発の組み合わせが、その中心になります。
「車輪の再発明」を避ける設計思想
Redshift活用型の開発では、「車輪の再発明」を避ける設計が求められます。何もかも自社向けに作ると、コストや期間が膨らみ、保守の負担も増えます。
開発会社は、現在の業務フローとデータ構造を踏まえ、既存製品やサービス、テンプレートを組み合わせます。土台に使えるサービスは役割ごとに異なります。自社固有のルールや分析ロジック以外は、成熟した仕組みに任せます。
- DWH:Redshift
- ETL:AWS Glueなどのマネージドサービス
- 変換管理:dbt
- 分析結果の表示・機械学習:BIツール、SageMaker
作らずに済む部分は既存の仕組みに任せ、必要な部分にリソースを集中させます。そうすると、早く、安く、保守しやすい基盤につながります。
開発会社を選ぶ際は、マネージドサービスに詳しいことに加え、どこまで製品に任せ、どこを作り込むかを現実的に提案できるかを見極めます。
マネージドDWH+カスタム周辺開発のハイブリッド
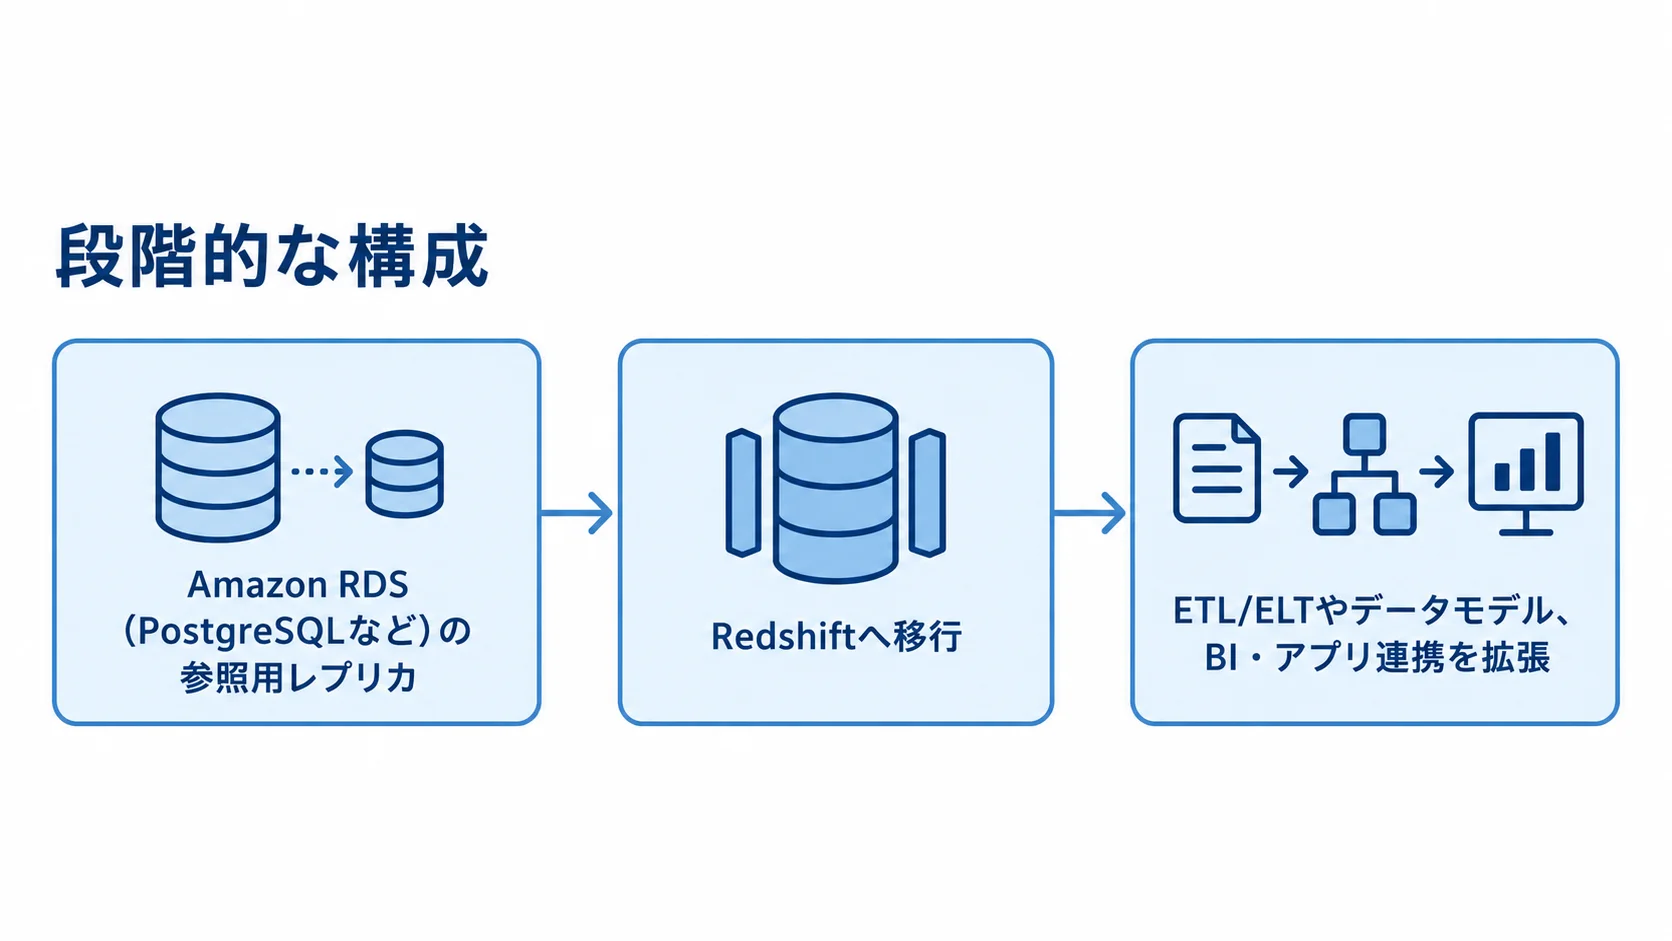
基本は、マネージドDWHを中核に置き、その周辺をカスタム開発する構成です。事業やデータ量に合わせて、小さく始めながら段階的に広げられます。
- データ量が数テラバイト未満で、高度なAI活用を想定しない段階では、Amazon RDS(PostgreSQLなど)の参照用レプリカで低コストに始めます。
- 事業やデータ量が拡大し、AI活用の必要性が高まった時点で、Redshiftへ移行します。
- 移行後は利用者のフィードバックを受け、ETL/ELTやデータモデル、BI・アプリ連携を拡張します。
全社基盤の完成形を最初から一度に作るより、必要な機能を必要な時期に加えていく方が進めやすいです。また、マネージドサービスを土台にすれば、データソースや分析用途が増えたときにも柔軟に対応できます。
このハイブリッド構成なら、フルスクラッチの自由度とマネージド製品の効率性を組み合わせて、無理なくデータ活用を育てられます。
発注時のポイントと失敗回避
Redshiftを土台にした開発を外部に発注する場合、押さえるべき点を確認しておくと、費用の無駄や要件の食い違いを防ぎやすくなります。確認の中心は、開発範囲(スコープ)とコスト対効果です。
スコープ定義と要件概要書
発注時には、開発範囲(スコープ)と前提条件をできる限り明確にしておきます。「データ基盤を作りたい」という伝え方だけだと、会社ごとに見積もりの前提が食い違い、追加費用の原因になります。
比較できる見積もりを得るため、要件概要書には次の情報を記載します。
- データ:連携元の一覧、データ量、更新頻度
- 分析:テーマ、KPI、画面で見たい指標
- 利用条件:利用者規模、権限、既存のAWS利用状況
- 計画:希望予算と時期
また、マネージドサービスに任せる範囲と独自に作り込む範囲を、発注の段階で開発会社とすり合わせておきます。必要な情報を先に揃えておけば、認識違いによるトラブルも防げます。
すべてを一度に決められないときは、PoCや小規模なMVPで検証してから範囲を固める方法もあります。曖昧な要件のまま大規模な請負契約を結ぶより、リスクを抑えられます。
コスト対効果の見極めと失敗パターン
避けたい失敗には、代表的なパターンがあります。
- 過剰な独自開発:必要性を確かめずに作り込む
- 全社基盤の一括構築:最初から要件を膨らませる
こうした失敗を避けるには、独自開発が本当に必要か、マネージドサービスや標準機能で代替できるかを確かめます。得意分野へ誘導して不要な開発を提案する会社もあるため、「作らない選択肢」も並べて考えます。
広範な開発では、費用が10倍になっても成果は1.2倍にとどまり、投資対効果が崩れることがあります。また、全社基盤を一括で目指すと、予算や期間を使い切るおそれもあります。
スコープを絞ったMVPやPoCで始め、成果を確かめてから段階的に広げます。投資は、意思決定の改善やコスト削減、売上向上といった事業価値と照らし合わせ、価値がはっきりしている部分から進めます。
Redshiftを活用しながら、本当に必要なオーダーメイドの部分に投資を集中させることが、後悔のない基盤構築につながります。
まとめ
オーダーメイド開発の中心は、Redshiftを土台にした周辺の仕組みです。列指向ストレージや大規模並列処理といったDWHエンジンの機能はAWSに任せます。エンジンを自作するのは車輪の再発明となり、現実的ではありません。
その分、限られた開発資源を、自社の競争力を生む部分に集中できます。
作り込みの中心は、ETL/ELTやデータモデル、BI連携です。既存ツールを土台にして、自社固有の部分を実装します。
独自開発が妥当なのは、独自アルゴリズムが競争力になる場合や、機密性から外部サービスを使えない場合です。明確な理由がないまま進めると、費用が10倍になっても成果は1.2倍にとどまる、という事態を招きます。
中規模の初期費用は300万〜1,500万円、大規模は1,500万〜3,000万円以上が目安です。請負は準委任のおおむね1.3〜1.5倍となるため、要件に応じて契約形態を選びます。
要件概要書で範囲を定め、PoCやMVPを通じて段階的に広げます。マネージドサービスとカスタム開発を組み合わせ、必要な作り込みに投資を集中させれば、後悔のない基盤構築につながります。
▼全体ガイドの記事
・Amazon Redshift導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。