
Azure Synapse Analytics導入の期間は、数ヶ月から1年超まで幅があり、対象範囲、データソースの数、分析方式によって変わります。
工程は要件定義からリリースまでの流れで進み、遅延は構築作業よりも、データの状態と数字への合意に関わることが多くあります。
▼全体ガイドの記事
・Azure Synapse Analytics導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Azure Synapse Analytics導入の開発期間の全体像
分析基盤全体の構築は、6〜12ヶ月程度が目安です。ただし、対象範囲や連携先の数、分析方式によって期間は変わります。
構想には2週間〜1ヶ月、PoC(概念実証)には1〜3ヶ月かかります。PoCでは、手元のデータで分析できるかを検証します。本開発は2〜12ヶ月かかり、その間にデータパイプライン、データモデリング、Power BIの実装、連携を進めます。
期間を左右する要因の一つは対象範囲です。部門の分析に絞るか、全社横断の基盤を作るかで、扱う範囲が変わります。さらに、既存の基幹システムやExcelに散らばるデータの整備も、期間に影響します。
また、専用SQLプールで本格的なDWHを構築するか、サーバーレスSQLプールでデータレイクを軽く分析するかによっても、期間は変わります。
小規模な部門のダッシュボードなら、数ヶ月で最初の成果を出せます。一方で、全社導入では複数部門のデータを統合し、大規模集計基盤と基幹システムとの双方向連携を行います。このため、1年前後かかることもあります。
期間の大部分は、基盤を組む作業そのものよりも、散在するデータを整えて、信頼できる数字にまとめる作業が占めます。
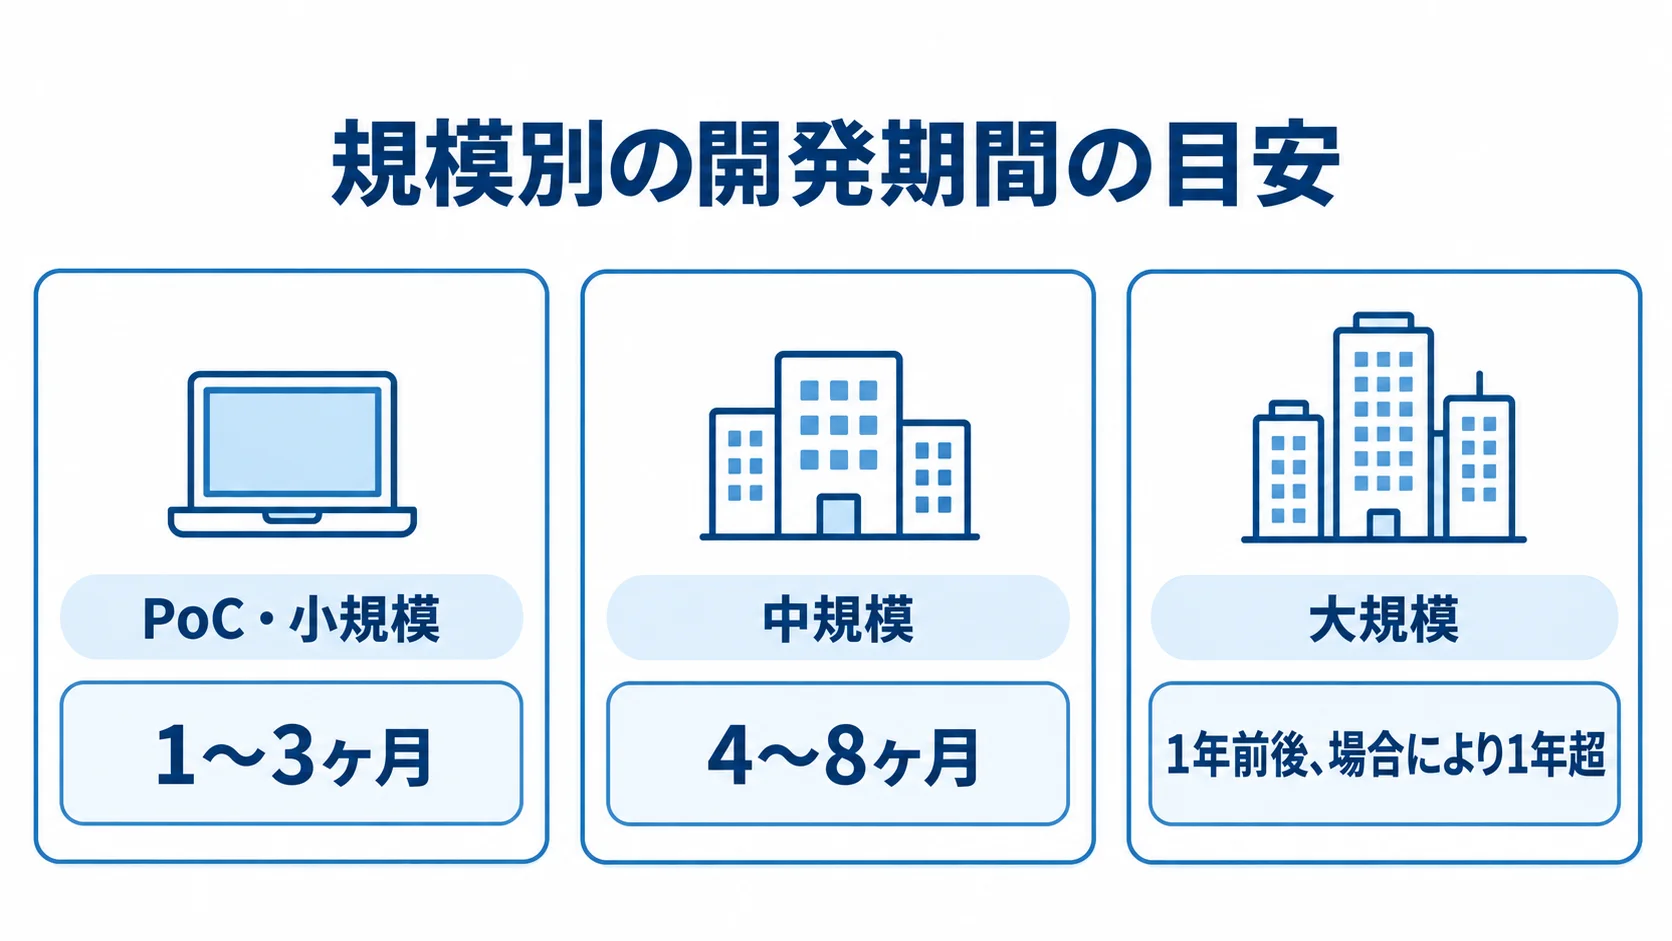
規模別の開発期間の目安
必要な期間は規模によって大きく変わるため、PoC・小規模、中規模、大規模の順に目安を並べておきます。
- PoC・小規模:1〜3ヶ月。1〜2種類のデータを分析し、Power BIで数枚のレポートにまとめる。
- 中規模:4〜8ヶ月。複数部門のデータを統合し、定期更新の仕組みと部門別レポートを整える。
- 大規模:1年前後、場合により1年超。全社の異なるデータ構造を統合する。
PoCでは、販売管理や会計などのデータを取り込み、ADLS(Azure Data Lake Storage Gen2)上のデータをサーバーレスSQLプールで分析します。そのうえで、意思決定に使える粒度と鮮度かどうかを確かめます。データが整っていれば期間を短くできますが、Excelや部門システムに散らばっている場合は、収集と名寄せに時間がかかります。
MVP(Minimum Viable Product)相当の費用は、100万〜300万円程度です。機能は、単一データソースの連携、基本的な集計、簡単な表示に絞ります。
中規模では、スタースキーマなどを設計し、日次・時間単位で更新するパイプラインを組みます。部門別・商品別にドリルダウンできるPower BIレポートも整えます。
全社導入では、事業ごとのデータ構造やコード体系を統合します。要件定義と基盤の設計・整備だけで、数ヶ月かかる場合があります。
最初のゴールをどの段階に置くかで、必要な期間と作業は異なります。自社がどの段階を選ぶかを決めると、現実的な計画を組みやすくなります。
一般的なシステム開発との開発期間の違い
分析基盤では、データを意思決定に使える一貫した数字にまとめる作業が加わります。
- データの不確実性:実データを確認するまで、整備の状況が分からない。
- 拡張への対応:指標やデータソースの追加・変更を前提に、設計を組む。
- プールの選択:課金モデルの異なる実行基盤を使い分ける。
一般的な業務システムは、入力に応じて決まった処理を正確に実行する仕組みです。要件が固まれば、ウォーターフォール型で比較的直線的に進められます。
一方で、分析基盤では複数データの定義や粒度を揃える必要があります。同じ要件書でも、整った基幹システムから取る場合と、定義の異なる複数システムやExcelから取る場合とでは、必要な工数が変わります。
実行基盤の選択は、コストと性能の両方に関わります。さらに、データ整備と基盤設計の時間が上乗せされます。そのため、単純な機能実装だけで比べても、同規模の一般システムより長くなりやすいのが特徴です。
分析基盤は、初期構築の段階から拡張しやすい構造にしておきます。指標やデータソースは、後から増えたり変わったりするためです。
要件定義からリリースまでの工程別スケジュール
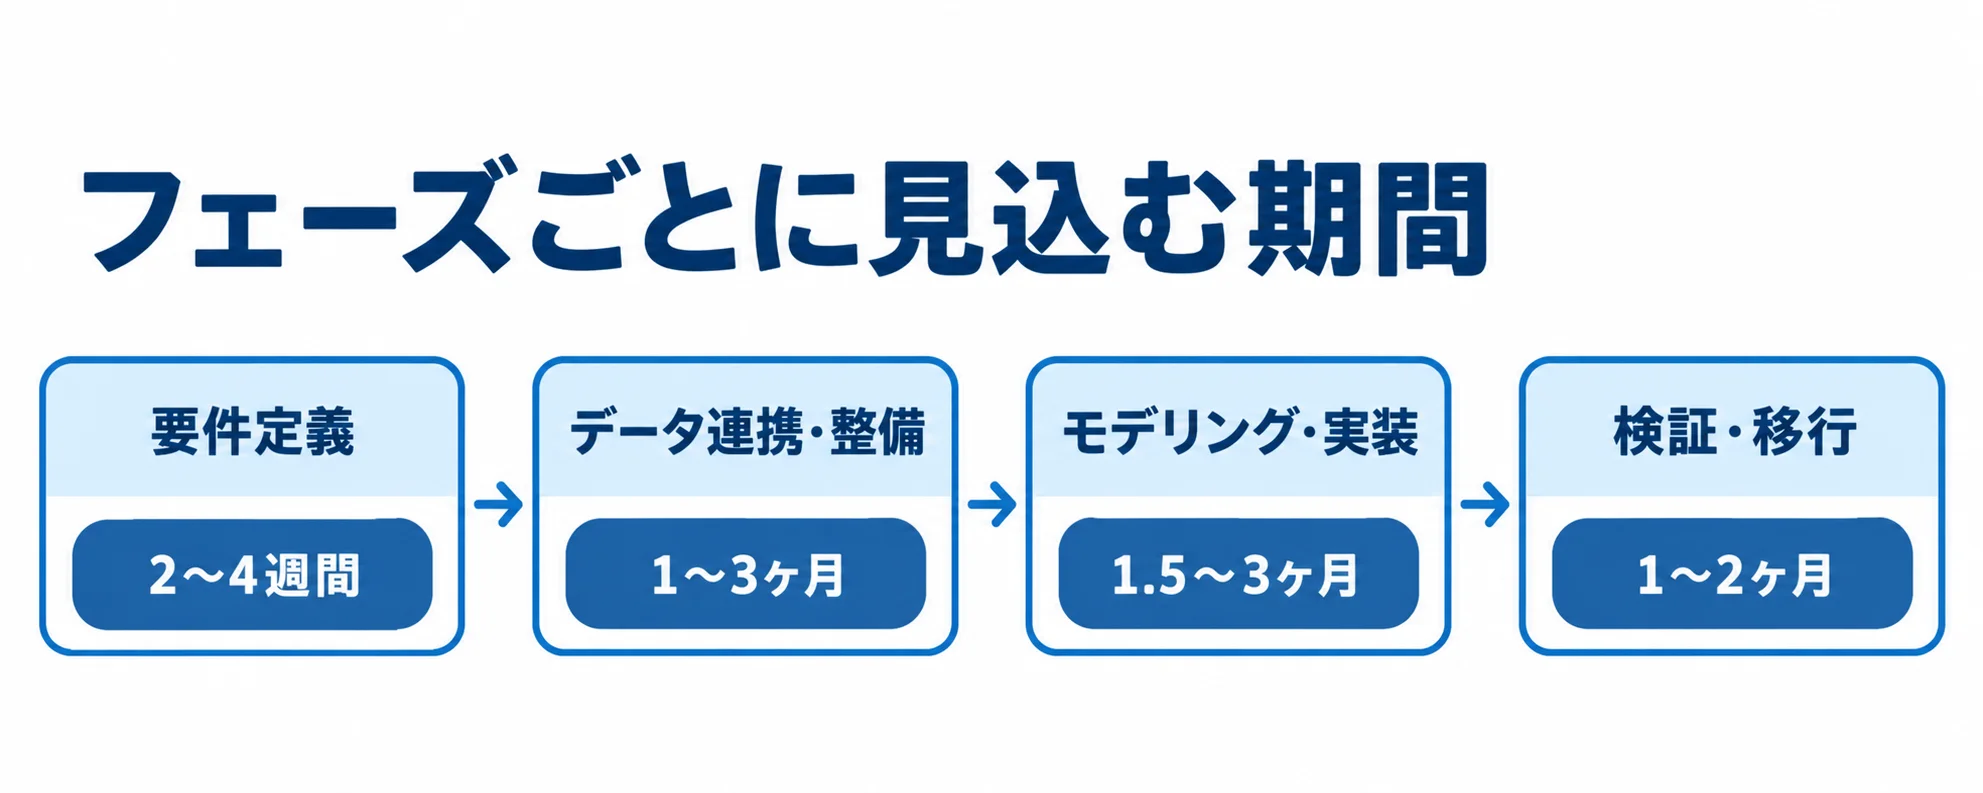
全体は、要件定義と分析要件の整理、データソース連携と整備、モデリングとパイプライン実装の順に進みます。続いて、Power BIダッシュボードの実装と、検証・本番移行を行います。
中規模の全体期間は4〜8ヶ月で、データ連携・整備・モデリングが、その半分以上を占めます。工数配分の目安は、要件定義が全体の10%前後、設計が10〜20%前後です。開発は、データ加工・集計ロジック・ダッシュボード構築を含めて40〜60%前後で、テストは10〜20%前後です。
進捗は画面数ではなく、判断に使えるデータが揃い、正しい数字を出せるかで確かめます。フェーズごとに見込む期間は、順に見ていきます。
要件定義・データソース連携整備フェーズ
初期は、分析要件とデータ元を確認し、関係者の間で数字の定義を合わせます。
- 要件定義:誰が何を、どの粒度と鮮度で見るかを決める。
- データ連携・整備:ソースのデータをADLS Gen2に取り込み、クレンジングする。
経営の月次KPI、営業の日次案件・売上、現場の準リアルタイム状況では、必要なデータが異なります。このため、データの種類に応じて、専用SQLプールとサーバーレスSQLプールの使い分けも変わります。
KPIの税抜・税込、締め日、部門区分は、関係部門で合意しておきます。なお、要件定義には通常2〜4週間かかります。
連携先には、基幹システム、販売管理、会計があります。SFA/CRMや各種SaaS、各部門のExcelも連携先になります。また、ソースごとに、粒度やコード体系、締め時期が異なることがあり、欠損の扱いも違う場合があります。
中規模でも、収集や名寄せ、クレンジングに1〜3ヶ月かかる場合があります。そのため、整備の期間は初めから見込んでおきます。計画の成否は、この期間を十分に確保できるかで分かれます。
モデリング・実装・検証・本番移行フェーズ
取り込み後は、分析用のモデルと更新処理を作り、表示と検証を進めます。
- モデリング・実装:データマートと定期更新の仕組みを作る。
- 検証・移行:数値、権限、性能を確かめて、本番に移す。
データマートは、ファクトテーブルとディメンションテーブルによるスタースキーマなどで設計します。Synapseパイプラインで定期更新し、中規模の設計・実装は1.5〜3ヶ月程度が目安です。
分散方式は、ハッシュ分散、ラウンドロビン、レプリケートから選び、パーティションも設計します。MPP(超並列処理)を活かすチューニングが、品質と性能を左右します。
集計が合わない、または遅い場合は、データモデルを見直します。Power BIでは、KPI一覧、部門・商品別のドリルダウン、期間比較などを実装します。
検証では、Excelや旧レポートと数値を突き合わせ、誰がどのデータを見られるかも確かめます。重い集計が実用的な速度で返るかも、本番移行の前に丁寧に見ておきます。
数字に食い違いがあると、分析基盤は現場に信用されなくなります。そのため、検証に1〜2ヶ月を確保しておけば、本番後の数字への不信感を抑えられます。検証を省くと、各自がExcelで独自集計する状態に戻る可能性があります。
Synapse固有でスケジュールに影響する工程
Synapseでは、実行基盤の使い分けが固有の設計課題になります。専用SQLプールとサーバーレスSQLプールは、課金モデルと性能特性が異なり、処理先の設計はコストと使い勝手に関わります。
Synapseは、Power BIやAzure Machine Learningとネイティブに連携できます。Microsoft Entra ID(旧Azure AD)やMicrosoft Purviewとも連携でき、他のクラウドDWHにはない強みです。
一般的な分析基盤の工程に加えて、こうした設計と連携の作業が必要になります。また、Microsoft 365、Entra ID、Power BIの整備状況も、連携期間を左右します。
SQLプールの選定とデータモデリング
専用SQLプール(Dedicated SQL pool)とサーバーレスSQLプール(Serverless SQL pool)の使い分けは、設計期間を左右します。
- 専用SQLプール:DWUを事前に確保し、大量データを高速集計する。
- サーバーレスSQLプール:ADLS上のファイルをその場で分析する。
専用SQLプールは、本格的なDWHを構築する方式で、大量データを扱う分析に向きます。計算資源の単位はDWU(Data Warehouse Units)で、Gen2ではDW100cのようなcDWU単位で指定します。専用プールは、使わない時間に一時停止して、コンピュート課金を止められます。
サーバーレス側は、ParquetやCSVをインフラなしでSQL分析でき、処理するデータ量に応じた従量課金です。高頻度で重い集計を専用側に置くか、アドホックな分析をサーバーレスで行うかは、判断が難しい場合があります。そのため、データ量とクエリ傾向を見て調整する分、設計に時間がかかることがあります。
専用プールでは、分散キー、パーティション、テーブルの物理設計を考える必要があります。丁寧なモデリングは、性能とコストを安定させます。
設計を軽視すると、集計遅延や想定外のコスト増が起きることがあります。その場合は作り直しが必要になり、手戻りでスケジュールが延びることもあります。
Power BI連携と既存DWHからのデータ移行
Microsoft環境との連携と、既存データの移行が、期間に影響します。
- Microsoft連携:Synapse Studio、Power BI、Entra ID、Purviewを接続。
- 既存データ移行:構造やロジックを確認し、移行後の数値を検証。
Synapse StudioからPower BIワークスペースを連携し、Entra IDで認証と権限を統合できます。Microsoft Purviewでは、データの所在や来歴を管理できます。Microsoft 365やPower BIを使っている企業では、比較的スムーズに進みます。
一方で、既存の認証基盤がない場合やPower BIが初めての場合は、ライセンスや権限の設計が必要です。さらに、レポートの作り方のルールづくりも始めるため、その分の期間を見込んでおきます。
移行元には、オンプレミスSQL Server、旧Azure SQL Data Warehouse、他のDWHがあります。移行では、テーブル構造やデータ型の差を吸収しながら、集計ロジックやビューを移します。移行後の数値検証も必要になり、設計・実行・検証に1〜2ヶ月かかることがあります。
既存資産の量と複雑さは、早い段階で評価しておきます。移行するものと作り直すものを決めておくと、後工程の期間を安定させられます。
納期遅延の典型要因と対策
Synapse導入が予定を超えてしまう原因には、はっきりした傾向があります。特に、遅延は構築作業よりも、データの状態と数字への合意形成に関わることが多くあります。
- データ品質:欠損や定義のずれが、整備と検証を長引かせる。
- 発注側の準備:担当者や段階的な計画が不足すると、調整が進みにくい。
これらを計画に含めておくと、遅延に備えてバッファを置けます。
関係者が数字を信頼して使えるまでの検証と調整も、遅延の要因になります。そのため、計画の段階で時間を見込んでおくと、スケジュールの精度を高められます。
データ品質・数値不一致による手戻り
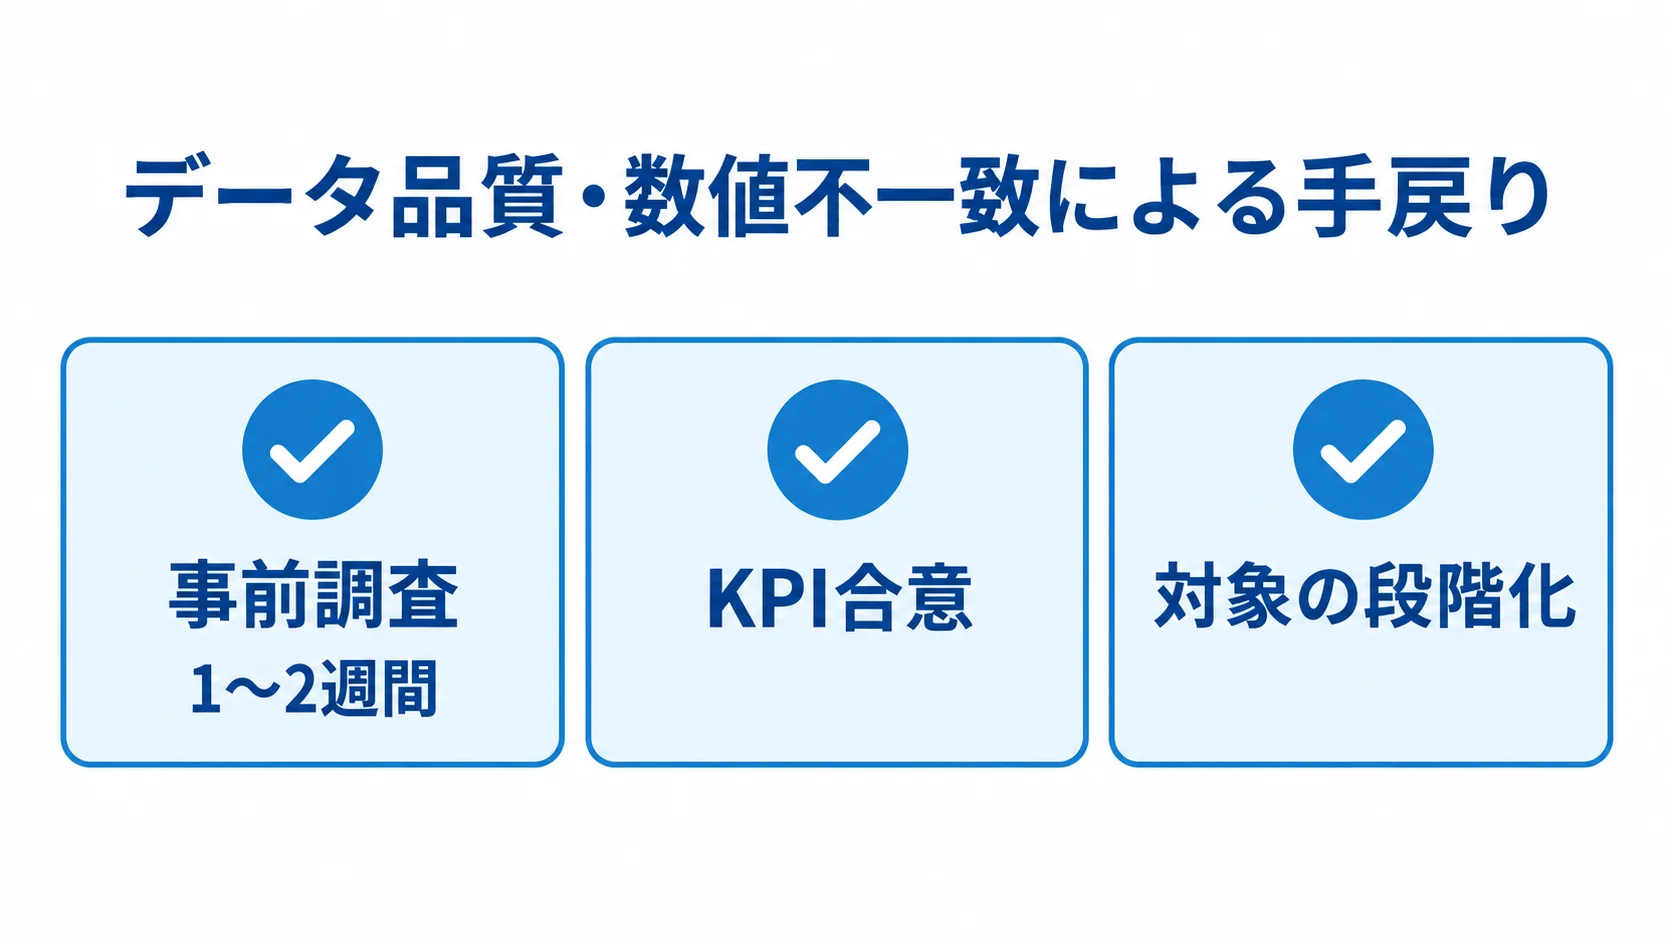
最も多い遅延は、取り込んだデータの品質問題と、既存の数値との不一致による手戻りです。
- 事前調査:データの実在性や品質を、契約・計画の前に確かめる。
- KPI合意:税区分、締め日、部門区分を文書にまとめる。
- 対象の段階化:主要指標から整え、対象を広げていく。
ソースには、欠損や重複、表記ゆれが潜むことがあります。コードの不統一や締め時期のずれが生じることもあります。
問題を放置すると、数字が現場の実感や既存レポートと食い違い、その結果、現場が誤りと判断して利用を止めることもあります。さらに、原因が取り込み、変換、定義のどこにあるかを切り分ける作業にも時間がかかります。
実データの確認には1〜2週間かけ、使えるデータの年数と粒度、定義を見ます。必要な集計ができるかも、あわせて見ておきます。
定義が食い違ったまま進むと、後で手戻りが生じます。要件定義の段階で定義をそろえておけば、この手戻りを防げます。さらに、主要指標から整えてから対象を広げれば、検証範囲を広げる前に食い違いの影響を確かめられます。
現実的なスケジュールを引くための発注側の準備
遅延を防ぐには、開発会社の力量と並んで、発注側の準備と体制が重要です。現場の業務知識やデータの背景がないと、正しい数字や実用性にはつながりません。
- 担当者の明確化:データ提供の窓口と、業務を説明する役を決める。
- 段階的な導入:PoCから始め、主要部門で効果を確かめる。
- 期間の余裕:全体に15〜20%程度のバッファを確保する。
コードの意味、月末締め後に確定するデータ、過去に定義が変わった項目などは、データだけでは分かりません。そのため、まず各ソースの窓口と、業務やデータを説明できる人を初期に決めておきます。
最初から全社・全データを統合せず、段階的に対象を広げます。主要部門で使えるかを確かめてから本格投資を判断する二段構えなら、大きな手戻りを抑えられます。
バッファは、特にデータ整備と数値検証に持たせます。発注側の準備が整っていれば、予定どおりに進みやすくなります。
開発パートナーを選ぶ際は、技術力に加えて、データ整備や段階的な進め方の提案も評価します。
まとめ
分析基盤全体の構築は6〜12ヶ月が目安で、規模が大きいほど期間は長くなります。工程ごとに見ると、構想は2週間〜1ヶ月、PoCは1〜3ヶ月、本開発は2〜12ヶ月です。
工数配分は、要件定義が10%前後、設計が10〜20%前後です。開発は40〜60%前後、テストは10〜20%前後です。
期間を見通しにくいのは、プールの選定やデータモデリングです。さらに、Microsoft連携と既存DWHからの移行も、期間の読みにくい工程です。
遅延対策は、データの事前調査とKPIの合意から始めます。そのうえで、段階的な導入や担当者の配置、15〜20%程度のバッファを組み込みます。
まず主要部門から始め、効果を確かめてから、現実的な計画につなげます。
▼全体ガイドの記事
・Azure Synapse Analytics導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。