
Azure Synapse Analyticsのランニングコストは、月額数万円規模から数百万円規模まで幅があります。その差は、利用するコンポーネントや稼働時間で変わるほか、データ量や運用体制によっても生まれます。
▼全体ガイドの記事
・Azure Synapse Analytics導入の完全ガイド
データ基盤構築の費用の考え方や見積もりの注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Azure Synapse Analytics導入後のランニングコストの全体像
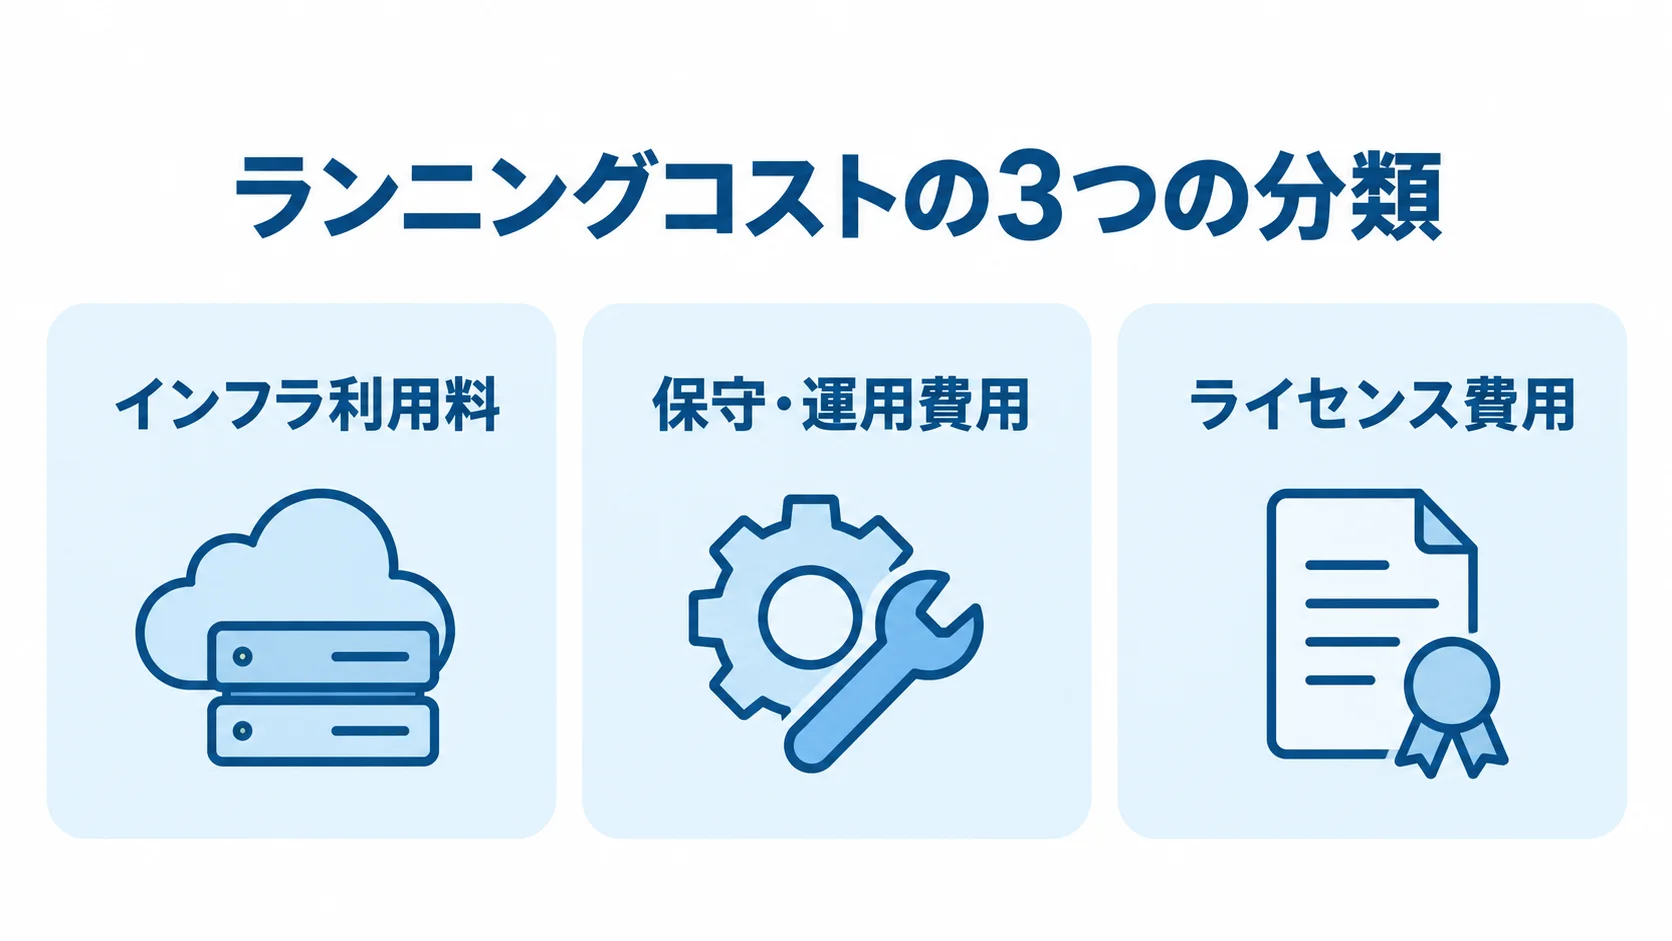
ランニングコストは、大きく3つに分けて考えると整理しやすくなります。まず、Azureのクラウド費用であるインフラ利用料があります。次に、人的な維持・改善コストである保守・運用費用が続き、最後に、BIツールなど周辺サービスのライセンス費用があります。
インフラ利用料は、専用SQLプールやサーバーレスSQLプールの利用量、ストレージなどで構成されます。Sparkプールの実行やデータ転送も、その内訳に入ります。使い方によって、月額数万円規模から数百万円規模まで大きく振れます。
保守・運用費用は、データパイプラインの監視や障害対応、データ品質の維持などにかかります。指標の追加や定義変更、パフォーマンスチューニングにもかかります。内製するか外部委託するかで、金額感が変わります。
ライセンス費用は、Power BIをはじめとするBIツールのほか、ETLやデータカタログ、監視ツールなどのサブスクリプション費用です。そのうえで、分析基盤全体のシステム維持費は、インフラとライセンスを合わせて月額数万円〜数十万円以上が目安です。この金額に、保守・運用のための人的コストを加えて考えておくとよいでしょう。
ランニングコストの3つの分類
ランニングコストは、支出の発生源ごとに分けておくと、見積もりと管理の対象がはっきりします。
- インフラ利用料:Synapseの各コンポーネントの利用量で決まります。
- 保守・運用費用:監視や改善を担う人的コストです。
- ライセンス費用:Power BIなど周辺ツールの費用です。
同じスペックでも、専用SQLプールを24時間365日稼働させるか、業務時間だけ稼働させるかで費用は変わります。夜間・休日に停止する構成にすれば、コンピュート費用を大きく抑えられます。
保守・運用費用は、システムを使える状態に保ち、育て続けるための人的コストです。新しい分析指標の追加や既存指標の定義変更、新規データソースの連携は、継続して発生します。そのため、保守・運用を担う体制を内製か外部委託かで用意しておく必要があります。
保守・運用費の相場は、月額で初期開発費の5〜15%程度が目安です。たとえば、初期構築に1,000万円かけた基盤なら、月額およそ50万〜150万円を見込む計算になります。
ライセンス費用は、Power BIのユーザー単位またはキャパシティ単位の利用料です。ほかのBI・ETL・監視系ツールも、サブスクリプション費用がかかります。さらに、利用部門やユーザーが増えるほど、ライセンス費用は積み上がります。
3つを合算した総保有コスト(TCO)で導入を評価することが、予算超過を防ぐ基本です。
初期費用とランニングコストの考え方
初期費用と稼働後の費用を分けて予算化しておくと、導入後の負担を見通しやすくなります。
- CAPEX:オンプレミスで中心となる初期投資です。
- OPEX:クラウドで毎月支払う運用費です。
- 中長期評価:3年・5年の累計コストで判断します。
オンプレミスのデータウェアハウスでは、サーバーやストレージを最初に購入するのが一般的でした。一方で、Synapseのようなクラウド分析基盤では、費用の重心が使った分を支払う形へ移ります。
クラウド分析基盤は、最初の投資を抑えて小さく始められ、需要に応じてスケールできます。ただし、稼働後のコスト管理を続けないと、費用がいつの間にか膨らみます。
初期構築では、要件定義からデータ整備、モデリング、実装、検証まで、各工程に費用がかかります。初期費用だけで導入を決めると、運用が始まってからクラウド費用と保守費用の負担に気づくことがあります。その結果、予算が逼迫するケースもあります。
クラウド分析基盤は、中長期の累計コストで評価することが欠かせません。特に、専用SQLプールを常時稼働させる構成では、月々のコンピュート費用が固定的に発生します。
そこで、本当に24時間稼働が必要か、業務時間外に停止できないかを導入設計の段階から検討します。ランニングコストを織り込んだ運用モデルを描くことが、無駄な支出を防ぐ第一歩です。
Synapseのインフラ利用料の内訳
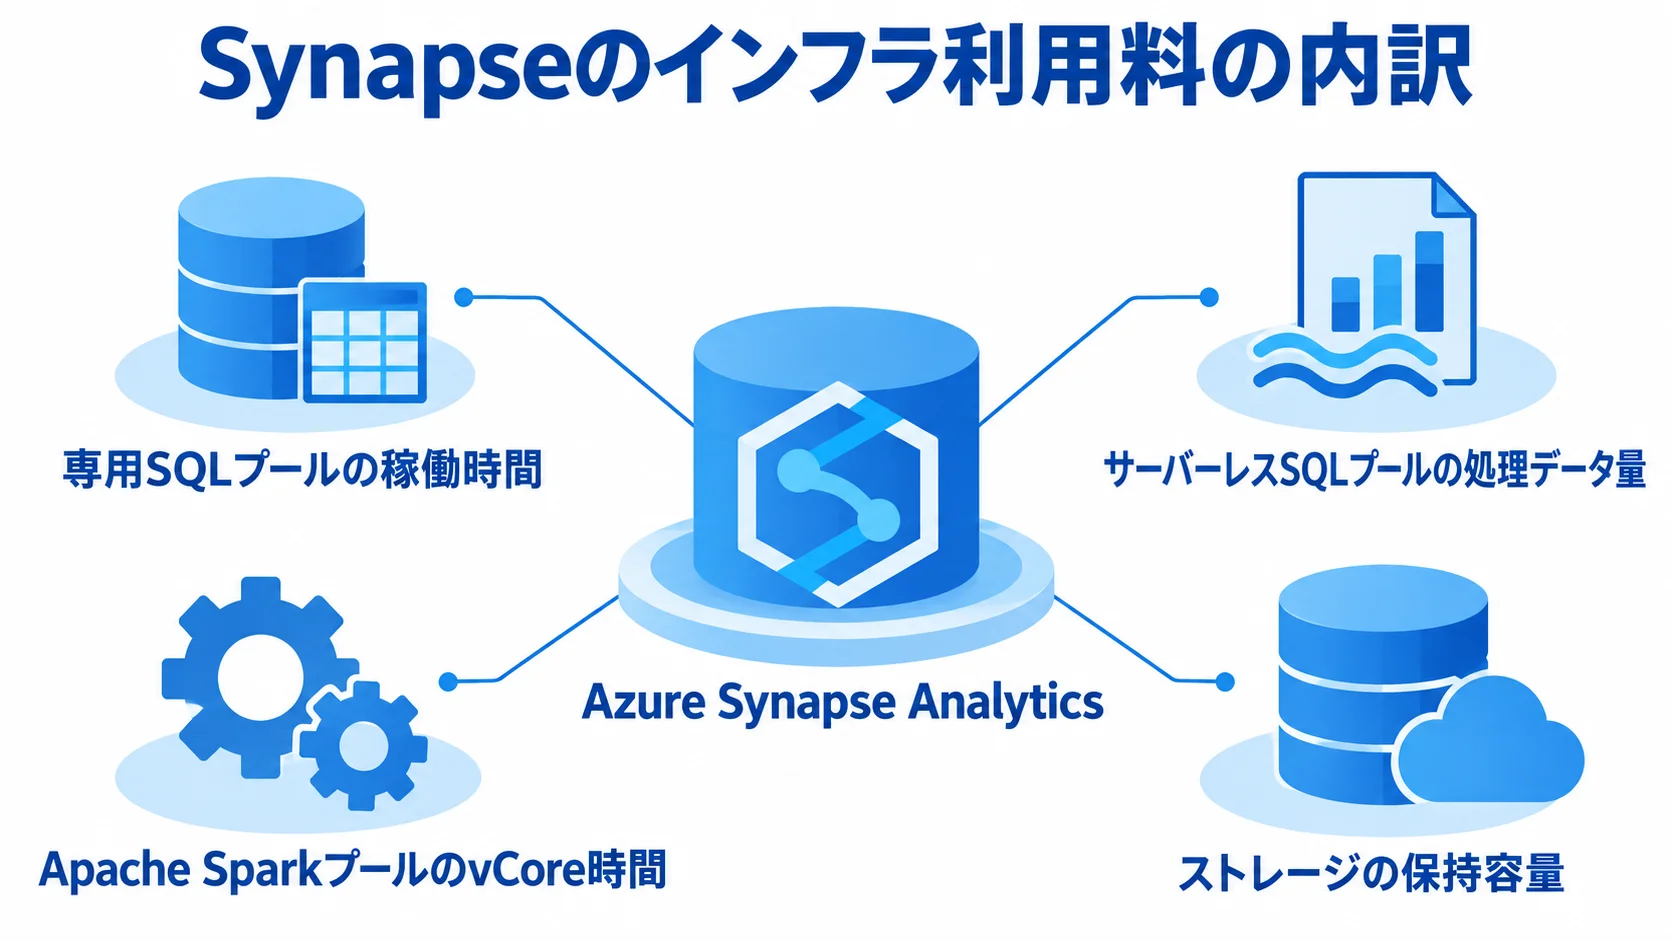
Azure Synapse Analyticsは、利用するコンポーネントごとに課金の考え方が異なります。そのため、課金の仕組みを理解して、コストを予測し最適化することが欠かせません。
専用SQLプールは、割り当てたコンピュートリソースの稼働時間で課金されます。一方で、サーバーレスSQLプールは、クエリが処理したデータ量で課金されます。
Apache Sparkプールは、使用したvCore(仮想コア)の時間で課金されます。また、データを保管するストレージは、保持している容量で課金されます。
同じSynapseでも、使うコンポーネントと利用量によって費用の出方は大きく変わります。そのため、自社の分析ワークロードに合う構成を選ぶことが、コストコントロールの出発点になります。
費用への影響が特に大きいのは、専用SQLプールとサーバーレスSQLプールの2つです。そのため、次の2つの節では、それぞれの課金の仕組みと費用の抑え方を詳しく見ていきます。
専用SQLプールのDWU課金と一時停止・予約容量
専用SQLプールでは、DWUと稼働時間を見ながら、コンピュート費用を管理します。
- DWUサイズ:必要十分なコンピュート量を選びます。
- 一時停止:使わない時間帯の稼働を止めます。
- 予約容量:安定利用分の単価を下げます。
専用SQLプールの費用は、DWU(Data Warehouse Units)という単位で決まります。DWUは、CPU・メモリ・I/Oをまとめて表した性能指標で、Gen2ではDW100c、DW200c、DW500c…DW30000cの刻みで割り当てます。この単位はcDWU(compute DWU)と呼ばれます。
DWUを大きくすると集計は速くなりますが、1時間あたりの単価も上がります。また、コンピュート費用は、稼働している時間に比例して課金されます。
専用SQLプールは、一時停止(pause)できる点が大きな特徴です。分析やレポート更新をしない夜間・休日に停止すれば、その間の課金は発生しません。平日日中だけ稼働させれば、24時間365日のフル稼働よりコンピュート費用を圧縮できます。
なお、ストレージ費用はデータを保持している限り続きます。
常時一定量のコンピュートを使う場合は、予約容量(Reserved Capacity)が有効です。1年または3年の予約容量を購入すると、従量課金より割安な単価が適用されます。
運用ルールに組み込む際は、必要十分なDWUサイズ、停止、予約容量の3点を組み合わせて考えると、専用SQLプールのランニングコストを抑えやすくなります。
サーバーレスSQLプールの従量課金とストレージ費用
サーバーレスSQLプールでは、クエリの処理量とデータの保持量を分けて管理します。
- 従量課金:処理したデータ量に応じて課金されます。
- スキャン削減:形式やパーティションで処理量を抑えます。
- データ保持:古いデータを整理して容量を管理します。
サーバーレスSQLプールは、専用SQLプールのようにリソースを確保する必要がありません。インフラ管理も不要なため、小さく始める段階や探索的な分析に向いています。
ADLS Gen2上のParquet、CSV、JSONは、そのままSQLで分析できます。料金は処理データ1TBあたり数ドル程度で、一般に約5米ドル/TBが目安です。そのため、ときどきアドホックにデータレイクを分析する用途なら、専用プールより安く済みます。
1回のクエリでスキャンするデータ量が、そのまま費用に直結します。たとえば、圧縮されていない巨大なCSVを毎回フルスキャンすると、費用が膨らみます。
そこで、Parquetのような列指向形式で保持し、必要な範囲だけを読む設計にしておきます。パーティションを切る工夫も、スキャン量と費用の削減につながります。
ストレージは、専用SQLプールのデータ保持分、ADLS Gen2の容量、バックアップに課金されます。バックアップには、ジオ冗長などの容量ベースの費用が含まれます。
ストレージ単価はコンピュートより低いものの、不要データを溜めると着実に積み上がります。そこで、保持期間をルール化し、アーカイブを含めてデータのライフサイクル管理に組み込んでおきます。
保守・運用費用の内訳と相場
分析基盤の総コストには、Azureに支払うインフラ利用料に加えて、人的コストも含まれます。基盤を使える状態に保ち、業務の変化に合わせて育てる作業は、継続的に発生します。
保守・運用費用は、内製する場合でも外部委託する場合でも必要になります。保守・運用費の目安は、月額で初期開発費の5〜15%程度です。
一方で、AI・予測モデルを組み込んだ大規模な基盤では、月額50万〜200万円規模の費用がかかるという参考データもあります。この金額には、モデルの再学習、監視、セキュリティ更新まで含まれます。
分析基盤の保守・運用には、壊れたら直す対応に加えて、新しい問いに答えられるよう基盤を拡張し続ける活動も含まれます。
保守運用費の相場と契約の考え方
保守運用費は、基盤の規模と外部委託の範囲によって変わるため、発注側は契約の形ごとに中身を確認します。
- 月額固定型:一定の対応時間と範囲を確保します。
- 準委任型:実際の作業量に応じて支払います。
- ハイブリッド型:軽微な対応を定額にし、大きな追加は都度見積もりにします。
月額で初期開発費の5〜15%という目安を基準にすると、規模別の相場を計算できます。たとえば、初期構築が500万円規模なら月額25万〜75万円程度、1,000万円規模なら月額50万〜150万円程度になります。AIや予測モデルを含む大規模な基盤では、月額50万〜200万円規模を見込みます。
見積もりでは、月額に含まれる対応範囲を確認することが大切です。たとえば、監視だけなのか、障害対応まで含むのか、指標追加などの改善も含むのかを見ておきます。
安く見える契約でも、監視だけで改善対応が別料金になるケースがあります。そのため、範囲外の作業が出たときの追加費用も、契約前に確認しておきます。
指標の追加や定義変更は続くものとして、作った後に育てる予算を運用費に計上しておきます。保守は、障害対応の備えにとどまらず、基盤を成長させる投資と捉えることで活用度が高まります。
監視・チューニング・データ品質維持の運用業務
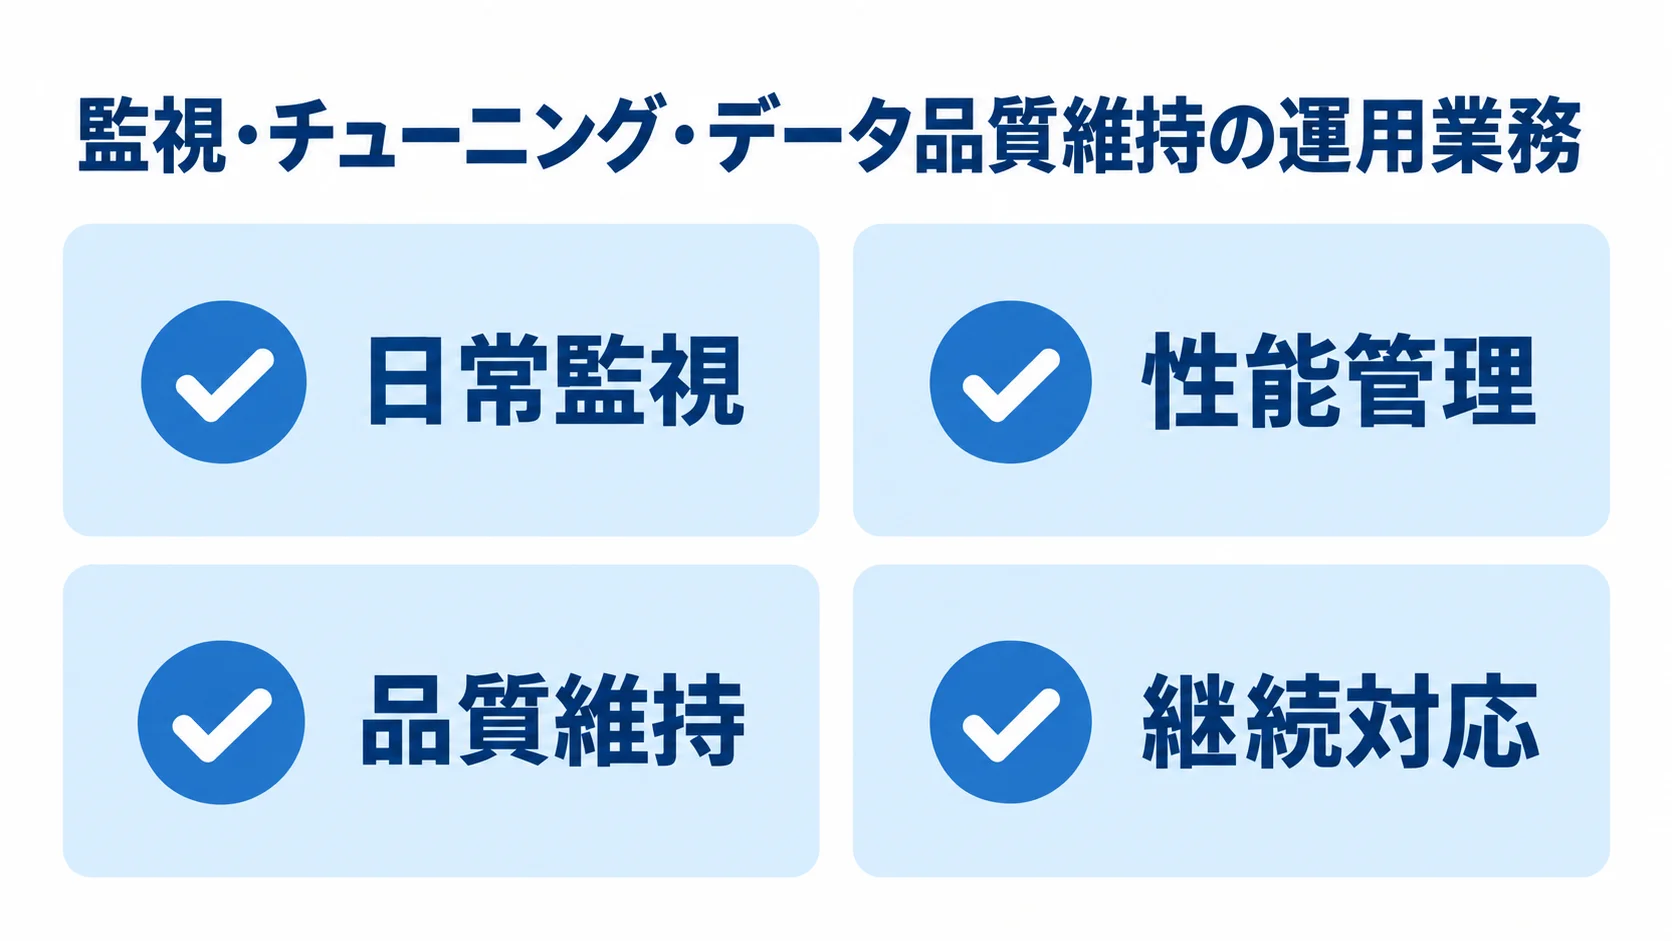
運用業務では、更新状況や性能、データ品質を継続的に確認します。業務要望や権限も、運用の中で見直していきます。
- 日常監視:パイプラインの更新と失敗を確認します。
- 性能管理:クエリやDWUを調整します。
- 品質維持:取り込みと変換の一貫性を保ちます。
- 継続対応:指標追加や権限見直しに対応します。
Synapseパイプラインでは、データの遅延も監視の対象になります。
データが1日でも欠けると、翌朝のレポートの数字が狂うことがあります。その結果、現場の信頼を損ないかねないため、監視と障害時のリカバリが運用の要になります。
専用SQLプールでは、遅いクエリの原因を特定して改善します。原因として、分散設計の不備や統計情報の古さなどが考えられます。また、DWUサイズが過剰か不足になっていないかも見直します。
サーバーレスSQLプールでは、スキャン量の多いクエリを洗い出して最適化します。チューニングを怠ると、性能低下だけでなくクラウド費用の増大にもつながります。
ソースシステムの仕様変更や新規データソースの追加があったときは、取り込みと変換のロジックを更新します。そうすることで、データの数値の一貫性を保てます。新しい分析指標の追加や既存指標の定義変更も、運用の一部です。
セキュリティ面では、Entra IDによる権限の棚卸しを定期的に行い、アクセス範囲も見直し続けます。
これらの業務を安定して回せる体制は、内製でも外部委託でも確保しておく必要があります。それが、分析基盤を作って終わりにせず使い続けてもらうための前提です。
コストを最適化する実践ポイント
Azure Synapse Analyticsのランニングコストは、設計と運用の工夫で大きく変わります。放置すれば膨らみ、管理すれば抑えられるため、継続して回す仕組みが大切です。
コストは、コンピュート側とデータ・ライセンス側の2つの観点で抑えられます。特別なツールを使うより、設計思想と運用ルールを導入時から整えることが、後々の大幅なコスト超過を未然に防ぐ近道です。
停止の自動化とクエリ最適化
コンピュート費用を抑えるには、稼働時間とクエリ効率、利用状況を定期的に見直します。
- 停止の自動化:業務時間外にプールを止めます。
- 予約容量:安定利用分の単価を下げます。
- クエリ最適化:スキャン量や処理負荷を減らします。
- 費用の可視化:ワークロード別にコストを把握します。
手動で止める運用だと担当者の負担になり、止め忘れも常態化しやすいため、業務時間外に自動で停止し、朝の処理前に自動で再開するスケジュールを組みます。
停止を自動化すれば、実際に使う時間分のコンピュート費用だけで済みます。予約容量は、安定的に使う分を1年または3年の期間で購入する形になります。
サーバーレスSQLプールでは、スキャンするデータ量が費用に直結します。そのため、Parquetのような列指向・圧縮形式で保持し、パーティションを適切に切ります。必要な列と期間だけを読むクエリにすると、処理データ量を大幅に削減できます。
専用SQLプールでは、分散キーの見直しや統計情報の更新を行います。不要なフルスキャンを排除できれば、同じ作業をより小さいDWUで賄える場合もあります。
Azure Cost Managementなどで、コストの内訳を定期的に可視化します。どのワークロードがコストを使っているかを把握し、対策を続けることが重要です。
BIライセンスと不要データの管理
データとライセンスは、利用実態と保持期間を定期的に見直すことで管理しやすくなります。
- ライセンス形態:ユーザー数と閲覧実態で選びます。
- レポート棚卸し:使われていない成果物を整理します。
- データ保持:古いデータをアーカイブまたは削除します。
- コストレビュー:費用の増減と原因を確認します。
Power BIなどのBIツールはユーザー課金型が多いため、利用部門やユーザーが増えるほど費用も増えていきます。
全員に個別ライセンスを付けるか、閲覧が中心ならキャパシティ(容量)ベースにするかを検討します。利用実態に合う形へ見直すことで、ライセンス費用を適正化できます。
使われていないレポートやアクセスされていないダッシュボードは、定期的に棚卸しします。不要な成果物を整理すれば、ライセンス費用と運用工数の両方を抑えられます。
中間テーブルや過去の一時データ、古いデータセットは、ストレージ費用を積み上げていきます。そこで、保持期間をルール化し、一定期間を過ぎたデータをアーカイブか削除に回します。こうしたライフサイクル管理を運用に組み込めば、ストレージコストを抑えられます。
非効率なクエリや不要なデータ保持は、クラウド費用を想定以上に膨らませます。だからこそ、定期的なコストレビューを習慣にして、長期的にランニングコストを管理することが大切です。
まとめ
Azure Synapse Analyticsのランニングコストは、インフラ利用料、保守・運用費用、ライセンス費用に分けて考えます。システム維持費は、月額数万円〜数十万円以上が目安です。保守・運用費は、初期開発費の5〜15%程度を月額で予算化します。
AIを含む大規模な基盤では、月額50万〜200万円規模も目安になります。専用SQLプールは、必要十分なDWUサイズ、使わない時間の停止、安定分の予約容量で管理します。サーバーレスSQLプールとストレージは、スキャン量とデータ保持量を抑えます。
BIライセンスのユーザー課金や不要データの蓄積も、放置するとコストを押し上げます。クラウド分析基盤は、初期費用だけでなく中長期のTCOで評価することが重要です。
コスト最適化を継続的に回す運用体制が、投資対効果を確保する鍵になります。正確な費用試算は、MicrosoftのAzure料金計算ツールで行ってください。自社のワークロードに即した見積もりを取ることをお勧めします。
▼全体ガイドの記事
・Azure Synapse Analytics導入の完全ガイド
▼見積依頼前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。