
Azure Synapse Analyticsの導入は、データ資産と利用目的を先に整理してから進めます。費用は、コンポーネントの選定と稼働時間を踏まえて試算し、小規模なPoCで確認してから段階的に展開するのが現実的です。工程は4つに分けると、全体を組み立てやすくなります。
- 要件定義・企画:データ資産とユースケースを整理し、KPIや対象範囲を決めます。
- 設計:データの流れやモデルを描き、ユースケースに合うSynapseコンポーネントを選びます。
- 開発・実装:ワークスペースを構築し、データ取り込みや変換の仕組みをつくります。
- テスト・リリース:データ品質・性能・セキュリティを検証し、段階的に利用を広げます。
Azure Synapse Analytics導入の全体像は、導入の完全ガイドをご覧ください。
データ基盤構築の工程ごとの進め方と注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Azure Synapse Analytics導入の全体像
Azure Synapse Analyticsは、データの取り込み・変換・蓄積・分析・可視化までを担う統合分析プラットフォームです。導入を成功させるには、まず全体像を正確に理解し、そのうえで計画を立てることが欠かせません。
株式会社リコー、集英社、プロテリアル(旧日立金属)などの日本の大手企業が相次いで採用しており、業種を問わずデータ活用基盤の中心に位置づけられています。
主要コンポーネントと特徴
Azure Synapse Analyticsは複数のコンポーネントで構成されており、それぞれが異なる役割を担っています。
専用SQLプール(Dedicated SQL Pool)は従来のデータウェアハウス機能を提供し、大量の構造化データを高速に処理するため、列指向ストレージを採用しています。DWU(Data Warehousing Unit)でコンピューティングリソースを管理し、DW100cから最大DW30000cまでスケールアップできます。
サーバーレスSQLプール(Serverless SQL Pool)は、事前にリソースを確保せず、Azure Data Lake Storage上のデータをSQLで直接クエリできるモデルです。
- サーバーレスSQLプールの用途:クエリごとに処理したデータ量に応じて課金されるため、アドホックな分析用途に最適です。
- Apache Sparkプール:PythonやScalaによるビッグデータのETL処理、機械学習、データ探索に対応します。
Synapseパイプラインは100以上のコネクターを持つデータ統合基盤で、オンプレミスや各種クラウドからのデータ取り込みを自動化できます。
これらのコンポーネントは、Synapse Studioという統合開発環境からまとめて管理できます。この点が、Synapseの最大の特徴といえます。
導入が向いている企業・ユースケース
Azure Synapse Analyticsは、Microsoft Azureを利用中の企業に適しています。また、複数のソースから大量のデータを統合して分析したい場合にも向いています。
- 複数システムに分かれた社内データ:販売データ・生産データ・顧客データを1つのダッシュボードで見たいときに効果を発揮します。
集英社では、紙媒体のデジタルコンテンツと海外市場の販売データが分散していました。そこで、SynapseとPower BIを組み合わせ、この課題を解決しました。
データサイエンティストとデータエンジニアが同じプラットフォーム上でSparkとSQLを使い分けたい場合は、コラボレーション効率が格段に向上します。
一方で、データ量が少なく、シンプルなレポーティングだけが目的なら、Azure SQL DatabaseやPower BI Premiumで十分な場合があります。そのため、目的に合う構成を見極める必要があります。
要件定義・企画フェーズ
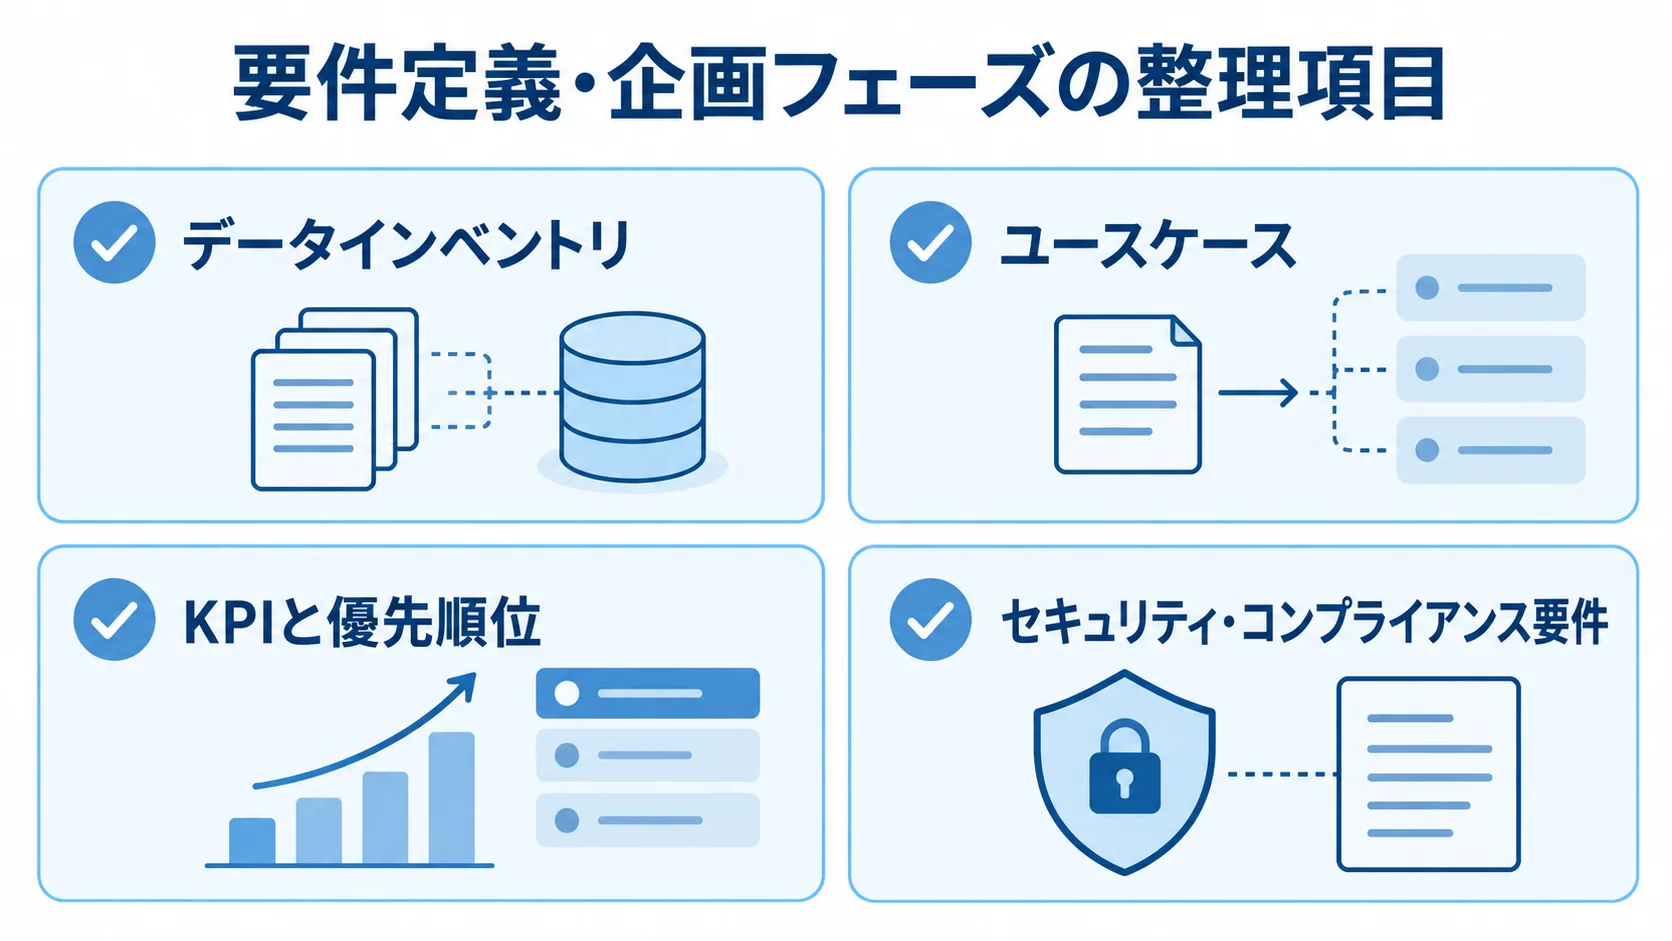
要件定義・企画フェーズは、プロジェクト全体の方向性を決める最も重要な工程です。Microsoftの「設計による実装の成功(Implementation Success by Design)」ガイドラインも、詳細な整理を推奨しています。
整理の対象には、データソース、データコンシューマー、ロール、ユースケースが含まれます。ここでの整理が不足すると後工程で手戻りが増えるため、この工程に丁寧に取り組む必要があります。
データインベントリとユースケースの整理
利用するユースケースを具体化する前に、データの所在と更新状況を整理しておきます。
- 最初の作業:社内にあるデータ資産を洗い出します。
システムごとに保有するデータの種類を整理し、発生頻度(リアルタイム・バッチ・日次など)、データ量(GB〜TB規模)、品質状況(欠損・重複・不整合の有無)も一覧にしておきます。
次に、データを利用するビジネス側のユースケースを具体化します。ユースケースの例には、経営ダッシュボードのリアルタイム更新、過去5年分の売上データの機械学習、製造ラインのセンサーデータの時系列分析があります。
粒度と優先順位を決めておくと、適切なコンポーネントを選びやすくなります。Microsoft Learnの実装ガイドは、既存のデータウェアハウスやビッグデータ環境の詳細仕様も収集の対象にしています。移行の場合は、既存環境を特に詳しく調べます。
KPI設定とスコープの確定
導入の目標と範囲を決めるため、KPIと優先順位を整理します。
- プロジェクトの目標:ユースケースを整理したあとに、成功基準となるKPIを設定します。
たとえば、月次レポート作成を3日から4時間以内に短縮する目標や、Power BIの更新頻度を日次から1時間ごとに高める目標があります。SQLだけで全ての分析ニーズに対応する目標もあります。このように、具体的な目標値を定めておきます。
Phase 1では専用SQLプールによるデータウェアハウス構築を優先し、Phase 2ではSparkプールによる機械学習基盤を追加する進め方もあります。このようにフェーズを分けると、スコープクリープを防げます。さらに、段階的に成果を積み上げることもできます。
セキュリティ・コンプライアンス要件(個人情報保護法への対応、アクセス制御ポリシー、監査ログ要件)も、この段階で確認しておく必要があります。
設計フェーズ:アーキテクチャとデータモデルの構築
設計フェーズでは、要件定義で明確にしたユースケースとKPIをもとに、具体的なシステムアーキテクチャとデータモデルを決めます。この工程で作る設計書があれば、後続の実装フェーズで開発者が迷わず作業を進められます。
アーキテクチャ設計では、データの流れ全体(データソース→取り込み→蓄積→変換→分析→可視化)をダイアグラムに描くことから始めます。
データレイクハウスアーキテクチャの設計
現代のSynapse導入では、「データレイクハウス」アーキテクチャが標準的なアプローチとなっています。その中心には、Azure Data Lake Storage Gen2を据えます。
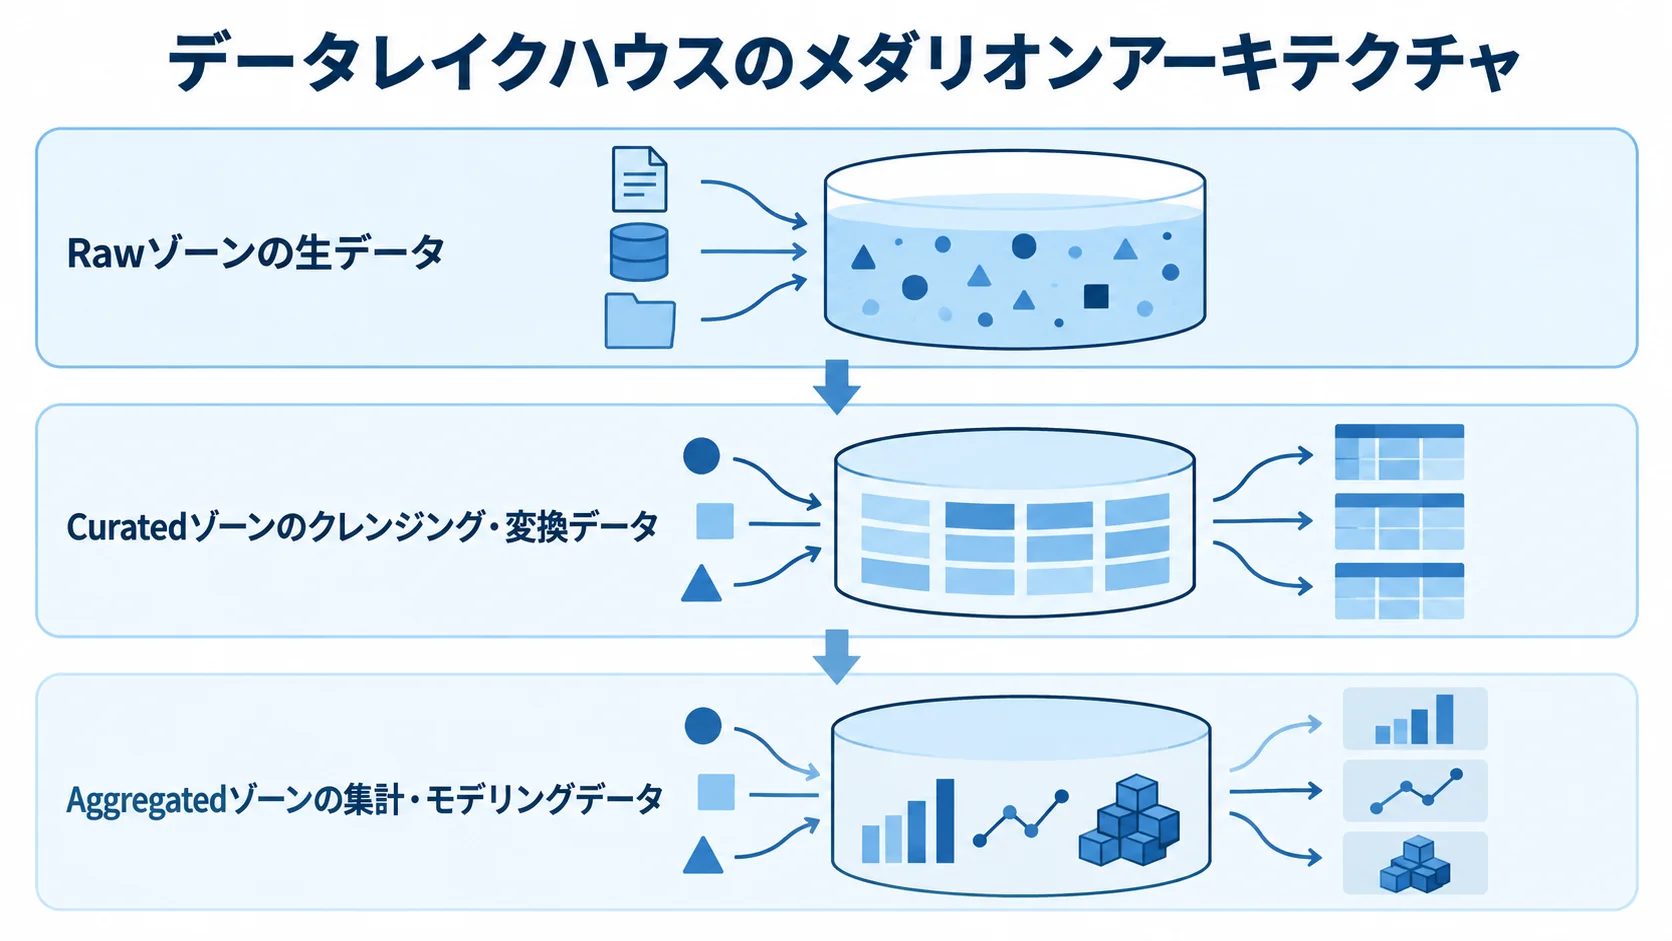
データは、Raw、Curated、Aggregatedの3層で管理します。この方式がメダリオンアーキテクチャです。Rawゾーンには、ソースシステムから取り込んだ生データをそのまま保存し、Curatedゾーンには、Sparkプールでクレンジング・変換したデータを格納します。
- Aggregatedゾーン:専用SQLプールやサーバーレスSQLプールで分析できる形に集計・モデリングしたデータを置きます。
- 原因の追跡:データを変換する前後のすべての状態を保持できるため、品質の問題が起きたときに原因をさかのぼれます。
プロテリアルの事例でも、このアーキテクチャを採用しています。財務情報や売上損益情報を、ETL・データストア・分析・データカタログとして一元管理したことが、成功要因として挙げられています。
コンポーネント選定:専用SQLプール・サーバーレス・Sparkの使い分け
設計では、ユースケースに応じてコンポーネントを選ぶことが大切です。専用SQLプールは常時起動するプロビジョニング型のリソースで、料金は1時間あたり約231円〜です。
- 専用SQLプール:BI向けの高速クエリや定型レポート処理で安定した性能を求める場合に適し、大規模なデータウェアハウスの主力エンジンです。
- サーバーレスSQLプール:処理したデータ量の分だけ課金される従量課金モデルで、1TBあたり約765円です。
- アドホック分析・データ探索:不定期のクエリや探索の段階では、専用プールを常時稼働させるよりコスト効率が高くなります。
- Apache Sparkプール:PythonやScalaによるデータ変換・機械学習・ストリーミング処理に向き、1時間あたり約85円〜で利用できます。
リコーの事例では、Apache Sparkでデータを加工しています。また、Delta Lake形式で保存する方法が採用されており、現在のベストプラクティスとされています。
開発・実装フェーズ
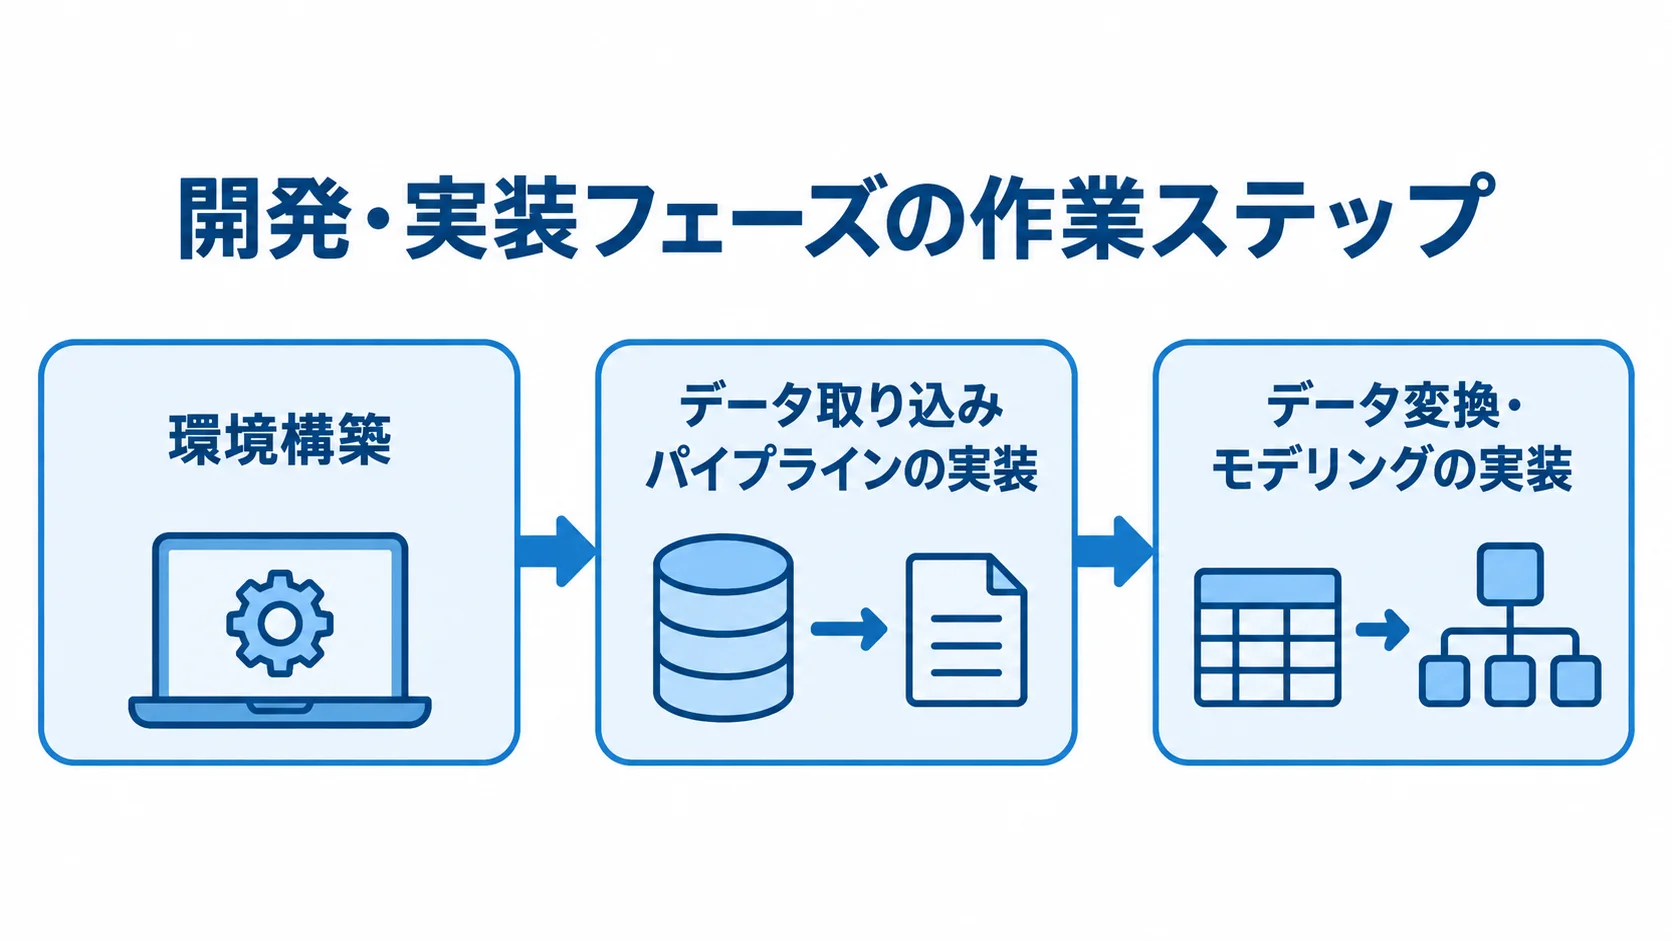
設計フェーズでまとめた設計書をもとに、Azure環境にリソースを構築し、データパイプラインとデータモデルを実装していきます。開発フェーズは、「環境構築」「データ取り込みパイプラインの実装」「データ変換・モデリングの実装」の3つの作業ステップで進めるのが一般的です。
Synapse Studioという統合開発環境を使うと、データエンジニアとデータアナリストが同じ画面上で協働できます。この点が大きなメリットです。
Synapseワークスペースの環境構築
環境構築は、Azureポータルでワークスペースを作成するところから始めます。
- ワークスペースの作成:Azureポータルから、Synapseワークスペースを作成します。
- 作成時の指定項目:リソースグループ、リージョン、Azure Data Lake Storage Gen2のアカウント名とコンテナ名です。
- リージョンの選択:日本国内のデータを扱う場合は、「Japan East」または「Japan West」に設定すると、レイテンシを最小化できます。
- ネットワーク設定:マネージドVNet(仮想ネットワーク)を有効にするかどうかを決めます。
マネージドVNetを有効にすると、データ流出の防止や、プライベートエンドポイントによる安全な接続が可能になります。一方で、専用のホストプールが必要になり、コストが増えます。ただし、セキュリティ要件が高い金融・医療・製造業の企業では、有効化を推奨します。
ワークスペースを作成したら、Synapse Studio(web.azuresynapse.net)にアクセスし、「管理」タブでデータソースをリンクされたサービスとして登録します。登録の対象は、Azure SQL Database、オンプレミスSQL Server、Salesforce、SAP等です。
データ取り込みパイプラインの実装
データ取り込みでは、Synapse Studioからソースとの接続と転送方法を設定します。
- 作成場所:Synapse Studioの「統合」タブから、データ取り込みパイプラインを作成します。
Synapseパイプラインには100以上の組み込みコネクターがあり、「コピーアクティビティ」を使って、ソースからADLS Gen2のRawゾーンへの転送を設定できます。
バッチ処理では、トリガーを使って毎日決まった時刻に自動実行するスケジュールを組むのが一般的です。ほぼリアルタイムの取り込みには、Azure Event HubsやAzure IoT Hubを連携できます。また、Change Data Capture(CDC)を使い、ソースDBの差分だけを転送する方法もあります。
マッピングデータフロー機能を使うと、ノーコード・ローコードでETL処理を視覚的に定義できます。そのため、SQLやPythonの専門知識がないエンジニアも、実装に加われます。
ELT(Extract, Load, Transform)では、まずデータをRawゾーンにロードし、その後にSparkや専用SQLプールで変換します。この流れにより、変換ロジックを柔軟に変更できます。
データモデリングと専用SQLプールの実装
データの利用方法に合わせて、テーブル設計と変換形式を決めます。
- スタースキーマ:BI向けに、ファクトテーブルとディメンションテーブルを組み合わせた形が広く採用されています。
専用SQLプールは、コンピューティングノードへのデータ分散方式として、「ハッシュ分散」「ラウンドロビン分散」「レプリケート」の3つを提供します。テーブルの特性と結合パターンに合わせて選ぶと、クエリ性能を高められます。大規模なファクトテーブルにはハッシュ分散を、小規模なディメンションテーブルにはレプリケートを適用するのが、基本的なベストプラクティスです。
列指向ストレージを活かすため、クラスター化列ストアインデックス(CCI)を使います。さらに、頻繁に使うカラムで結果を絞れるよう、パーティション分割を設計します。
Sparkプールの変換処理では、Synapse StudioでPySpark Notebookを作成して実行し、Notebookにデータのクレンジング・結合・集計ロジックを記述します。
Delta Lake形式では、ACIDトランザクション、タイムトラベル(過去の状態への参照)、スキーマエボリューションを利用できます。これにより、データ品質を保てます。
テスト・リリースフェーズ
テスト・リリースフェーズでは、実装したパイプラインとデータモデルが、要件定義で定めたKPIを達成できているかを多角的に検証します。
データ基盤のテストは通常のアプリケーション開発とは異なり、データ品質、パフォーマンス、セキュリティの3つの観点から行う必要があります。
データ品質テストとパフォーマンス検証
データ品質テストでは、ソースシステムとSynapse上のデータを照合します。件数、合計値、最大値、最小値などを比べるレコードカウント検証も行います。
- ETL処理の途中の確認:意図しないレコードの欠損や重複が起きていないかを確認します。
加えて、Sparkまたは専用SQLプールのSQLで、Null・値域・参照整合性などのルールを実装します。定期的に品質レポートを生成する仕組みも構築します。
パフォーマンステストでは、要件定義で定めたクエリ応答時間のSLAを、実際のデータ量とクエリパターンで達成できているかを検証します。
専用SQLプールのクエリ性能が目標を下回る場合は、DWUをスケールアップします。チューニングの方法には、インデックスの追加、マテリアライズドビューの作成、結果セットキャッシュの有効化もあります。
セキュリティ検証と段階的リリース
セキュリティ検証では、Azure Active Directory(現Microsoft Entra ID)の認証・認可が正しく機能するかを確認します。行レベル・列レベルのセキュリティによって、データアクセスが想定どおりに制限されるかも見ておきます。
- アクセスの監視:Azure MonitorとSynapse監査ログを使い、不正な試みや異常なクエリパターンを検出できるかを確認します。
- 本番リリースの方法:一括での移行を避け、段階的に実施することを強く推奨します。
まず、データエンジニアチームなど一部のユーザーに利用を開放します。問題がないことを確認したら、全社に展開します。この方法なら、リスクを抑えられます。
本番リリース後も2〜4週間は集中モニタリングを行い、コストの急増、パイプラインの失敗、クエリのタイムアウトを早期に検知して対処できる体制を整えます。
費用相場とコストの内訳
Azure Synapse Analyticsの費用は複数の課金要素で構成されており、利用状況によって月額コストが大きく変わります。
小規模なPoC(概念実証)から始める場合と、全社のデータ基盤として本格的に稼働させる場合では、費用の桁が違います。そのため、試算ツールを使って事前に見積もっておくことが欠かせません。
コンポーネント別の費用相場
費用の主な構成要素と相場を、順に見ていきます。
専用SQLプールはDWU(Data Warehousing Unit)単位で課金され、最小のDW100cは約231円/時間です。24時間365日稼働させると、月額で約17万円になります。
専用SQLプールは、業務時間外や週末にDWUをゼロにスケールダウンして一時停止すると、月額コストを30〜50%削減できます。
サーバーレスSQLプールは、処理データ量1TBあたり約765円の従量課金です。アドホック分析が中心なら、月額数千円〜数万円で済むことが多いです。
- Apache Sparkプール:1vCoreあたり約85円/時間で課金され、Sparkクラスターのサイズと稼働時間に応じてコストが変わります。
- ストレージ費用:Azure Data Lake Storage Gen2は、1GBあたり約3.2円/月で、1TBのデータ保存なら月額約3,200円です。
- パイプラインの費用:オーケストレーションは、アクティビティ実行1,000件あたり約93円で、通常の用途なら月額数千円以内に収まります。
小〜中規模企業のSynapse基盤は、月額3万〜15万円程度が目安です。大規模なエンタープライズ環境では、50万円以上になることもあります。
人件費・構築費用とランニングコスト
見積もりでは、初期構築費と運用にかかる費用を分けて考えます。
- 利用料以外の費用:Azureの利用料金とは別に、エンジニアの人件費や外部ベンダーへの委託費用がかかります。
- 構築の委託費用:Synapseの設計・実装を専門ベンダーに委託する場合、要件定義から本番稼働まで3〜6か月で、300万〜1,500万円程度が相場です。
- 大規模・複雑な環境:規模や移行の有無で大きく異なり、データソースが10以上あると、1,000万円を超えることも珍しくありません。
- 保守・運用の人件費:ランニングコストとして忘れがちな費用です。
- 運用工数の目安:監視、障害対応、定期的なパフォーマンスチューニング、スキーマ変更への対応などを含めると、月に10〜30時間程度のエンジニア工数が必要です。
コストを抑える手段として、1年または3年の予約購入(予約容量)を使うと、専用SQLプールのコストを最大65%削減できます。本番稼働が安定した段階で予約購入に切り替えるのが、長期的なコスト管理の定石です。
見積もりを取る際のポイント
Azure Synapse Analyticsの見積もりを正確に取るには、依頼前の準備と発注先の選定が欠かせません。見積もりが不十分なまま開発を始めると、スコープ拡大や認識相違で追加費用が発生する恐れがあります。
要件明確化と仕様書の準備
見積もり依頼の前には、最低限4点の資料を用意します。データソース一覧には、システム名、データ量、更新頻度、接続方式を記載します。
主要ユースケースと分析要件には、誰が何をどの頻度で分析するかをまとめます。現行システムの構成図では、オンプレミス、クラウド、ハイブリッドを区別します。さらに、セキュリティ・コンプライアンス要件も、資料に加えます。
- 準備の効果:資料がそろっていると、ベンダーからの見積もり精度が格段に上がり、後の認識相違も防げます。
- 将来の見通し:特にデータ量は見積もりに大きく影響するため、現在の容量だけでなく、将来3〜5年の成長予測も含めて伝えることをお勧めします。
Azure料金計算ツールは、azure.microsoft.com/pricing/calculatorで利用できます。事前にランニングコストを試算しておくと、ベンダー提案を評価しやすくなります。
複数社比較と発注先の選び方
Azure Synapse Analyticsの導入を外部に委託する場合は、最低でも3社から見積もりを取ることを強く推奨します。
発注先は、Microsoft Azure認定パートナーかどうかを確認します。特に、Data & AI領域でSpecializationを取得している企業かも見ておきます。
- 認定パートナー:Microsoftが認定したパートナーは、Azure専門の技術審査をクリアしており、一定水準以上の技術力が担保されています。
- 事例の近さ:過去の具体的な導入実績を確認し、自社と業種・規模が近い事例があるかを調べます。提案内容の質も、評価の基準になります。
開始前に、詳細なヒアリングを行います。技術的な質問に答えられるエンジニアがいるかも確認します。
専用SQLプールとサーバーレスの使い分けや、予約購入などでコストを抑える方法も、提案に含まれているかを確かめておきましょう。
導入後の運用保守サポート体制(障害時の対応時間・定期レビューの有無)についても、事前に合意しておくことが重要です。
注意すべきリスクと対策
導入プロジェクトでよく見られるリスクとして、まず「コストの予期せぬ増大」があります。特に専用SQLプールを常時稼働させたままにしていると、使っていない時間帯も課金が発生し、月末に想定外の請求が来るケースがあります。
対策として、Azure Cost Managementで予算アラートを設定します。コストが閾値を超えた際に、通知を受け取れます。
次に、第二のリスクとして「データ品質問題による分析結果の信頼失墜」があります。
- ダッシュボードの数値:ソースシステムのデータが不正確だと、Synapseに取り込んだ後のダッシュボードも誤った数値を表示します。
- 事前の合意:PoC段階からデータ品質テストを組み込み、品質基準をビジネス側ユーザーと合意しておく必要があります。
- 第三のリスク(スキルギャップ):社内に技術者が少ないと、外部ベンダーへの依存度が高まります。
- トレーニング計画:導入と並行して、社内エンジニアの研修計画も立てることをお勧めします。
スキルギャップが生じやすいのは、Synapse・Spark・Delta Lakeなどの学習コストが高いためです。
まとめ
要件定義では、データインベントリとユースケースの整理が出発点になります。設計では、メダリオンアーキテクチャによるデータレイクハウスを組み立てます。ユースケースに応じて、専用SQLプール、サーバーレスSQLプール、Sparkプールを使い分けます。
開発では、Synapse Studioでパイプラインとデータモデルを構築します。また、ELTとDelta Lake形式の組み合わせがベストプラクティスです。
テスト・リリースフェーズでは、データ品質・パフォーマンス・セキュリティの3観点で検証したうえで、段階的にリリースします。その結果、安全な本番稼働につながります。
費用面では、Azure利用料は月額3万〜15万円程度が目安で、構築委託費用は数百万円から千数百万円が相場です。予約購入を使えば、ランニングコストを最大65%削減できます。
導入では、小規模なPoCから始めて、ユースケースと費用対効果を検証したうえで、段階的に全社展開する方法が現実的です。専門ベンダーへの相談も積極的に活用しながら、データ活用基盤の整備を進めていきましょう。
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブックもご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。