
Azure Synapse Analyticsの導入は、発注前に目的とデータ要件を整理し、発注範囲を決めたうえで、複数社から提案を取って選ぶ流れで進めます。
各工程で成果を確認すると、見積もりや委託先を判断しやすくなります。リコーや集英社などの導入事例も併せて紹介します。
導入全体をさらに詳しく知りたい場合は、次の記事が役立ちます。
Azure Synapse Analytics導入の完全ガイドをご覧ください。
データ基盤構築を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Azure Synapse Analytics導入の全体像
Azure Synapse Analyticsは、従来のAzure SQL Data Warehouseを進化させた後継サービスです。DWH機能とビッグデータ処理機能を一つのサービスに集約している点が特徴です。
外注・委託する場合は、この特性を理解したうえで発注範囲を明確にすることが出発点になります。
Azure Synapse Analyticsの主な機能と特徴
データの収集から分析までを、単一の基盤に集約できます。ETLやDWHでの保管に加え、BIや機械学習との連携も含みます。
分析エンジンは、用途に応じて次のように使い分けます。
- 専用SQLプール:ペタバイト級のデータを処理できます。
- Apache Spark:大規模な分散処理向けです。
- サーバーレスSQLプール:オンデマンド分析に使えます。
- Data Explorer:ログや時系列データの分析向けです。
Azure Synapseは、Power BI、Azure Machine Learning、Azure Cosmos DBなどのAzureサービスとも連携できます。
リコーでは導入後、従来3時間かかっていたデータ処理が10分以内に短縮された実績があります。
外注・委託が必要になる理由と発注範囲の考え方
Azure Synapseの導入には、クラウドアーキテクチャの設計、ETLの開発、Sparkや専用SQLプールの運用経験が必要です。
社内に経験者がいない場合や、短期間でのリリース、運用保守までの支援を求める場合は、外注・委託が選択肢になります。
発注範囲は、社内のAzure運用経験や必要な支援に応じて、次の二つから検討できます。
- 一括委託:要件定義から運用保守までを任せる形です。
- 一部委託:設計・開発だけを外注し、要件定義と運用は自社で担います。
初めて大規模データ基盤を構築する企業には、一括委託が安全です。一方で、Azureの運用経験がある企業は、一部委託でコストを抑えられる場合があります。
発注前の準備:要件定義と社内体制の整備
Azure Synapse Analyticsの導入を外注する際に最も重要なのは、発注前の準備です。何を実現したいのか、どのデータをどう活用したいのかを自社で整理しないままベンダーに発注すると、要件が二転三転し、プロジェクトが頓挫するリスクが高まります。発注側の準備度合いが、プロジェクトの成否を大きく左右します。
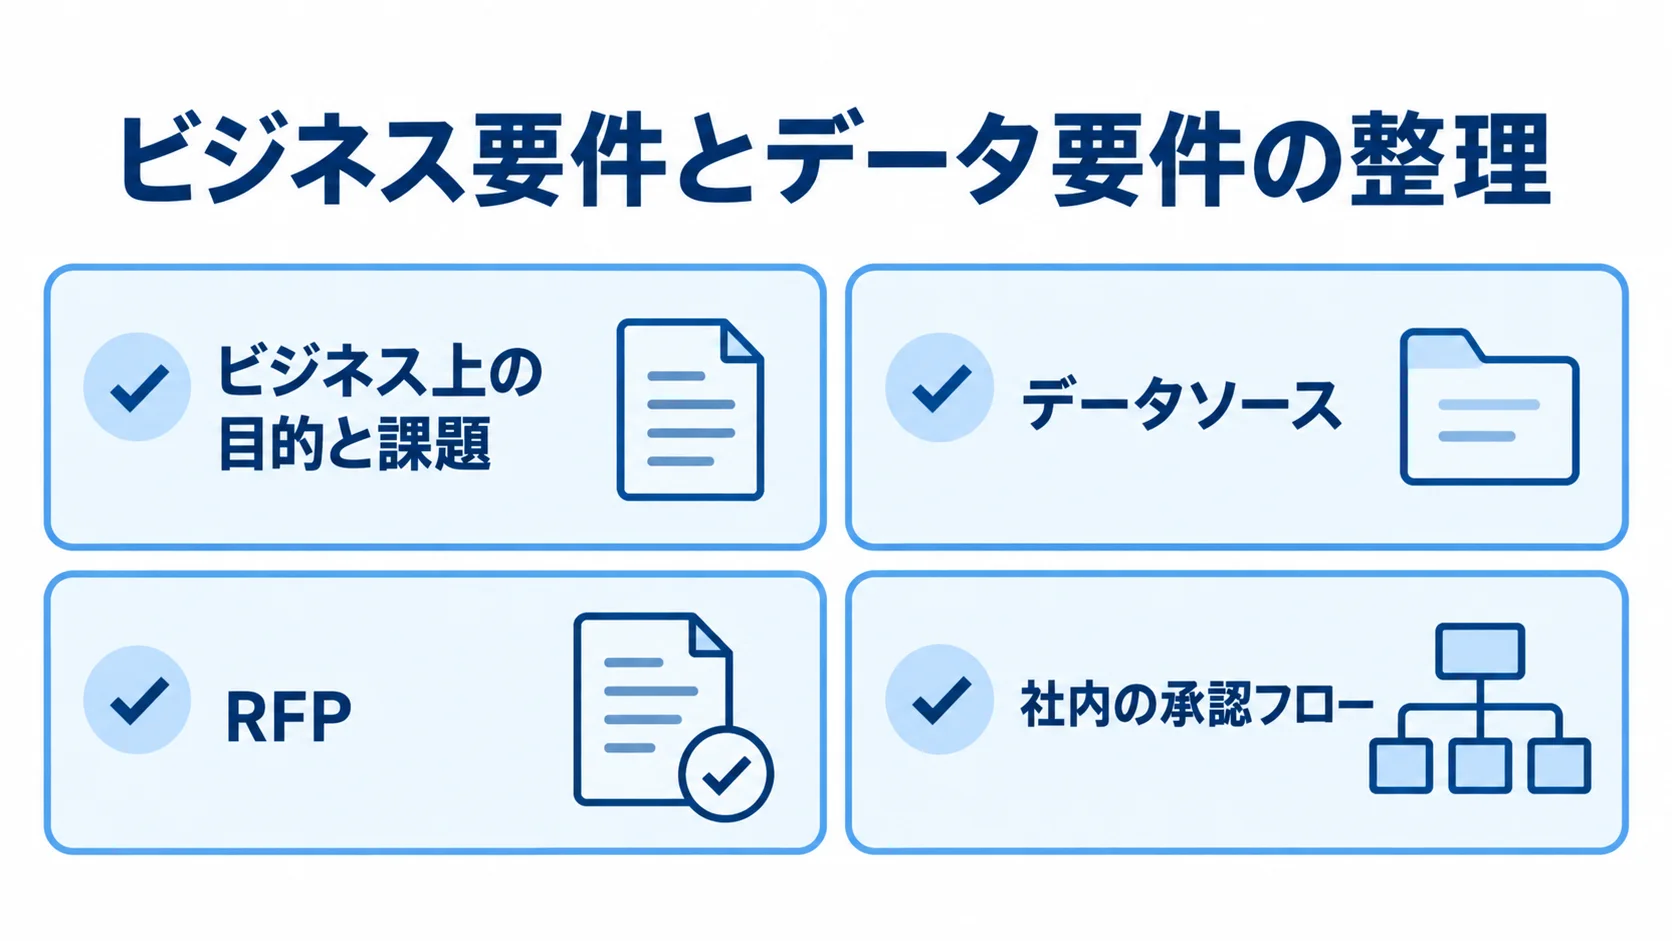
ビジネス要件とデータ要件の整理
要件定義は、ビジネス上の目的と課題を具体化するところから始まります。たとえば、次のような利用目的があります。
- 経営ダッシュボード:複数システムのデータを統合する用途です。
- 販促効果の計測:マーケティングデータのリアルタイム分析。
- 設備の予知保全:工場のセンサーデータを収集・活用します。
次に、取り込むデータソースと、現在と将来のデータ量、更新頻度を整理します。さらに、参照する人とツールも洗い出します。
Microsoftは公式ドキュメントで、実装前にデータソースとデータ利用者、役割、ユースケースを確認するよう推奨しています。こうした点を自社で整理しておけば、ベンダーとの認識の食い違いを防げます。
RFP(提案依頼書)の作成と社内承認体制の整備
RFP(Request for Proposal:提案依頼書)は、ベンダーへ依頼内容を示す文書です。複数社から比べられる提案を得るために作成します。
各社の比較の前提をそろえるため、RFPには次の情報を記載します。
- 背景と目的:プロジェクトの経緯と現状の課題を示します。
- システム要件:機能要件と非機能要件の内容。
- データ:取り込む対象の範囲と、その量を示します。
- 予算・日程:希望スケジュールと上限額。
- 成果物・選定:納品物とその定義、選定基準を示します。
社内の承認には、情報システム部門と、データを使うビジネス部門の責任者が加わります。さらに、予算を持つ経営層や財務部門も巻き込んだ承認フローを事前に整えておくと、途中の方針転換リスクを抑えられます。
Azure Synapse Analytics導入の発注から本番稼働までの流れ
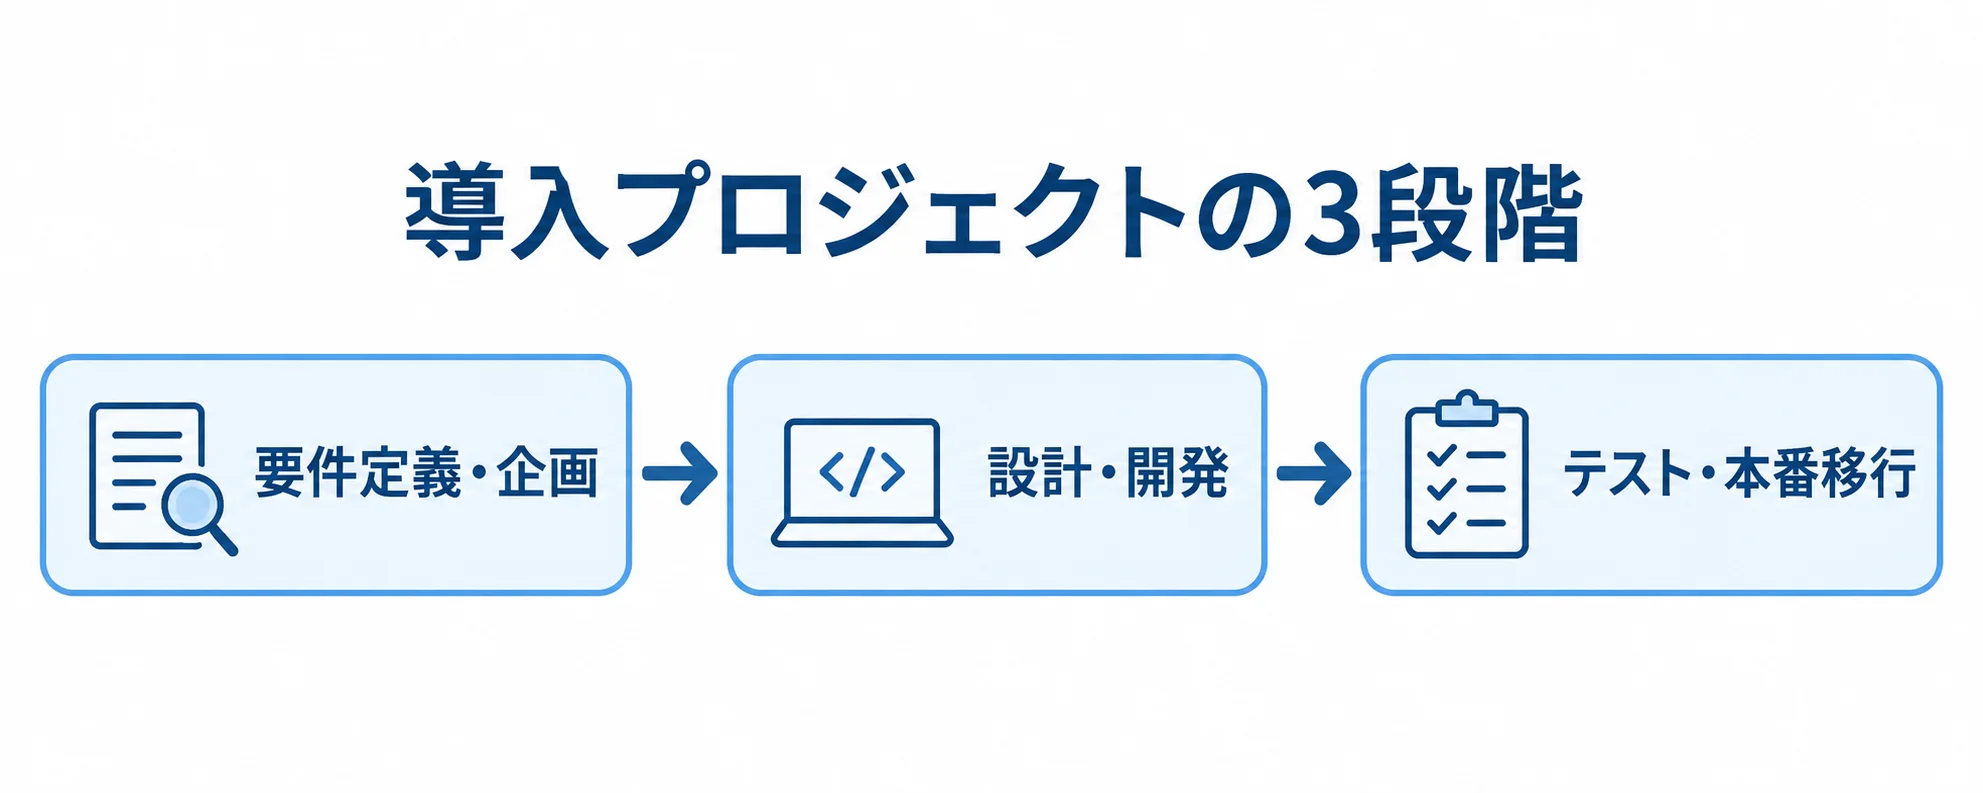
導入プロジェクトは、要件定義・企画、設計・開発、テスト・本番移行の3段階で進みます。そのうえで、発注側が自分の役割を理解しておくと、ベンダーとの協働がスムーズに運びます。
要件定義・企画フェーズ:ベンダー選定と詳細要件の確定
要件定義・企画では、発注側とベンダーが詳細要件を定め、プロジェクト全体の方向性を決めます。
まず、RFPを送ってから選定し、環境と構成を確認したうえで、責任者の承認まで進めます。
- ベンダー選定:提案書の受領と評価を含めて、通常1〜2ヶ月程度かかります。
- 既存環境の洗い出し:オンプレミスDWH、データパイプライン、BIツールの現状を確認します。
- 構成の特定:必要な分析コンポーネントを選び、開発・テスト・本番の環境構成を合意します。
- 設計の承認:要件定義書と基本設計書を責任者が確認し、次工程へ進めるかを判断します。
設計・開発フェーズ:データパイプラインとワークスペース構築
設計・開発では、ベンダーが主体となって、次の構築と実装を進めます。
- ワークスペース:Azure Synapseの環境を構築します。
- データレイク:Azure Data Lake Storage Gen2を設計します。
- データパイプライン:ETL処理を開発します。
- データモデル:設計と実装を行います。
- セキュリティ:行・列のアクセス制御と動的マスキングの設定。
中規模のデータ基盤構築では3〜6ヶ月程度が目安です。ただし、期間は規模によって異なります。
発注側は、週次や隔週などの進捗レビューに参加し、開発が要件に合っているかを継続して確認します。特に、データモデルは後から変更すると手戻りが大きいため、開発初期の設計レビューが重要です。
Power BIとの連携や、Azure Active Directoryを使った権限管理も、このフェーズで設計します。
テスト・本番移行フェーズ:データ品質検証と運用移管
本番稼働までに、テストとデータ確認を行い、移行と運用移管を順に検討します。
移行品質と稼働後の体制を整えるため、次の項目を確認します。
- テスト:単体、結合、ユーザー受け入れ(UAT)の各検証を行います。
- データ品質:移行前後の件数・集計値・欠損率などを突合します。
- 本番移行:データ量を踏まえ、週末や連休を使う計画を立てます。
- 運用移管:ベンダー保守か社内移管かを事前に決めます。
データ突合を丁寧に行うことが、本番稼働後の信頼性を支えます。
たとえば、集英社のように、コンソールから基本的な運用ができる体制を目指すと、開発・運用の工数やコストを抑えやすくなります。
費用相場とコストの内訳
導入費用は、Azureサービスの利用料とベンダーへの構築費用に分かれます。そのため、予算計画では両方を見積もります。
Azureサービス利用料金の内訳と相場
クラウド料金は従量課金制が基本で、主に次の5項目から構成されます。
- 専用SQLプール:計算コストが発生します。
- ストレージ:保存容量に応じて課金されます。
- サーバーレスSQLプール:クエリ処理に応じて課金されます。
- Sparkプール:コンピューティングコストが発生します。
- パイプライン:データ統合の利用料。
専用SQLプールは、DWU(Data Warehouse Unit)と利用時間に応じて課金されます。たとえば、DW100cの最小構成は約231円/時間からです。
Azure Data Lake Gen2で1TBをホット層・ローカル冗長ストレージに保存する場合、月額約3,200円程度です。
サーバーレスSQLプールは、スキャンしたデータ1TBあたり約765円で課金されます。
本番運用では、月額50万〜200万円程度のクラウド費用を見込む企業が多くあります。
1年または3年の予約購入(Reserved Capacity)を使うと、従量課金比で最大65%節約できる場合があります。
Microsoft Azure Pricing Calculatorでは、想定利用量を入力して事前見積もりを作成できます。
ベンダーへの構築費用(人件費・工数)の相場
PoCから大規模案件まで費用幅が広いため、構築規模別の目安を分けて確認します。
- 小規模PoC・単一用途:300万〜800万円程度です。
- 複数データソースの本格構築:1,500万〜5,000万円以上になるケースもあります。
- 大規模エンタープライズ:1億円を超えることもあります。
費用は、プロジェクトマネージャーやアーキテクトなど、各役割の人月単価に工数をかけて算出するのが基本です。人月単価は一般的に80万〜150万円です。
また、要件定義を別途フィーとするベンダーでは、着手金として100万〜300万円を求めるケースがあります。
運用保守費用は月額20万〜100万円程度かかる場合があります。そのため、初期費用だけでなく、3〜5年間のTCO(総保有コスト)で比べます。
見積もりを取る際のポイントと外注先の選び方
外注する際、失敗のリスクが最も高いのは「ベンダー選定」と「見積もりの精度」です。
適切なパートナーを選べれば、プロジェクトの成功確率は大幅に高まります。
要件明確化と仕様書の準備
見積もりの精度は、発注側が提供する情報の質に左右されます。要件が曖昧なままだと、各社が異なる前提で試算することになり、金額を比べにくくなります。
比較条件をそろえるため、依頼前に少なくとも次の情報を文書にまとめます。
- データソース:対象の数と種類(DB、APIログ、ファイルなど)。
- データ量:現在の規模と3年後の見通し。
- 更新頻度:リアルタイム、日次、週次など。
- 利用条件:ユーザー数とPower BI、Excelなどの利用ツール。
- 接続・保護要件:セキュリティ条件と既存インフラとの連携。
これらを要件概要書やデータ要件シートにまとめ、RFPに添付しておくと、各社が同じ前提で見積もりを作成できます。その結果、金額を比べやすくなります。
複数社比較と発注先を選ぶ際の評価基準
発注先は3社以上から提案と見積もりを取り、価格・品質・アプローチを比べます。1〜2社では適正さを判断する基準が得にくいためです。
提案内容では、次の5つの観点を確認します。
- 構築実績:同規模・同業種の実績とAzure資格者の有無。
- データ技術:ETL、データモデリング、Spark最適化の専門性。
- プロジェクト管理:PM経験、進捗・課題管理の方法。
- 運用保守:SLA、対応時間、コスト最適化の継続支援。
- コミュニケーション:質問への対応速度と提案書の分かりやすさ。
構築実績では、MicrosoftのDP-203 Data Engineeringなどの資格保有者がいるかも確認します。
プロテリアルの事例では、6社の提案を、機能・処理性能・運用管理など複数の項目で比べています。
注意すべきリスクと失敗を防ぐ対策
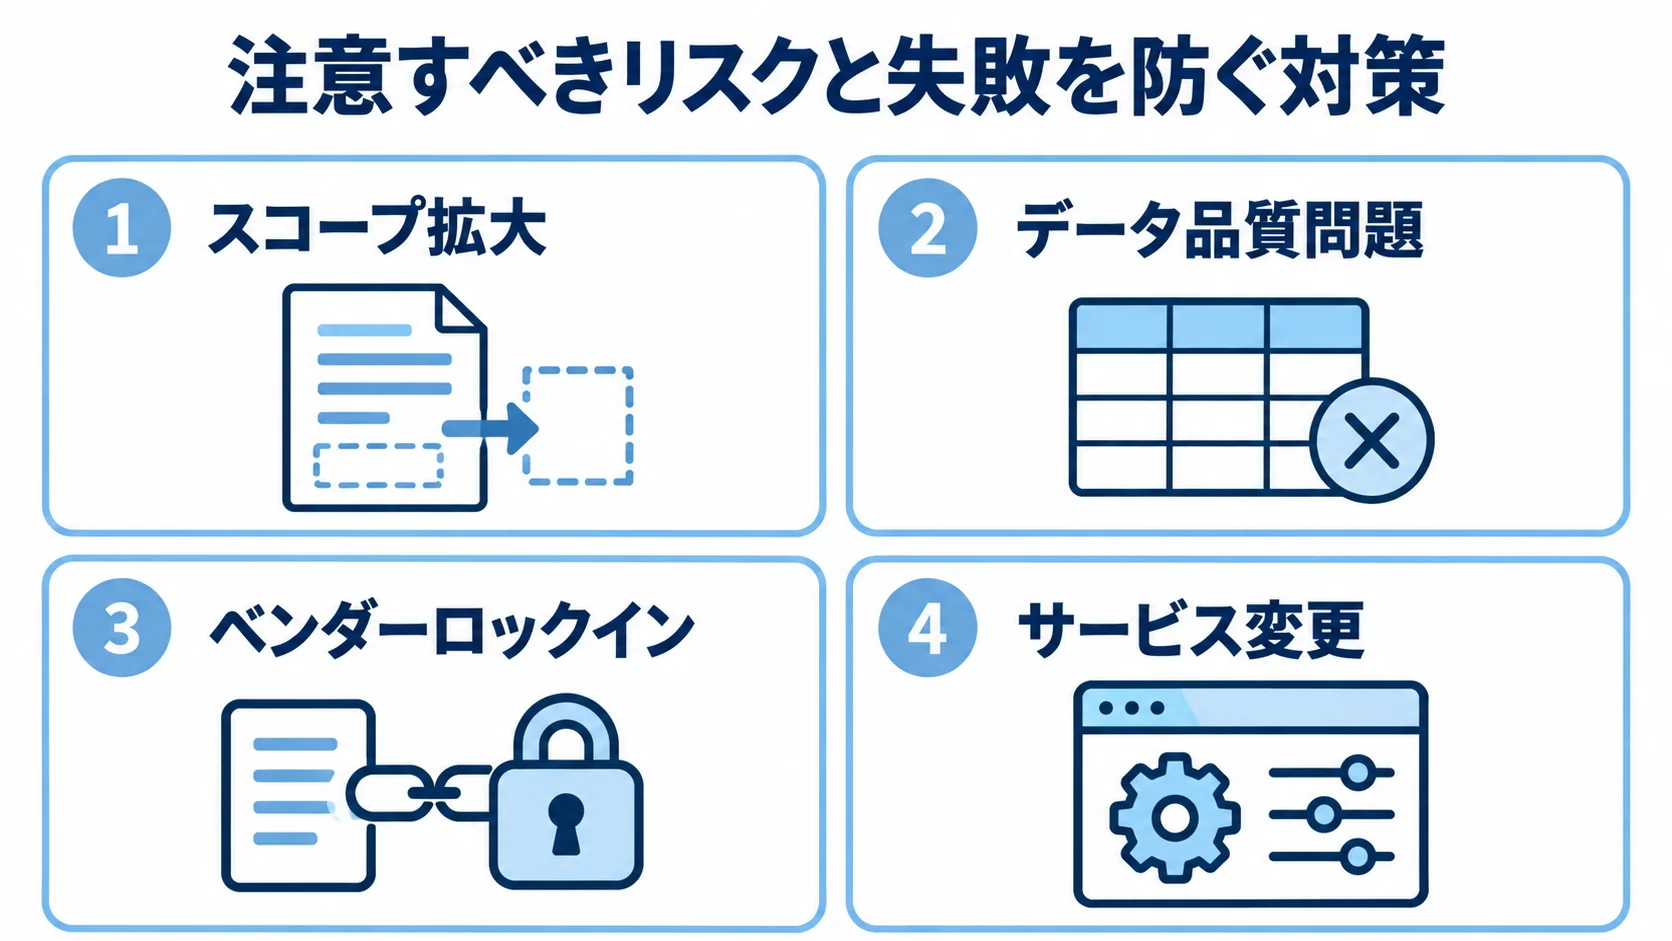
よくある失敗と対策を、契約や要件定義の段階で確認しておくと、外注時のリスクを抑えられます。
- スコープ拡大:費用と日程への影響を都度合意します。
- データ品質問題:クレンジングの工数を見積もりに含めます。
- ベンダーロックイン:設計書やコードの扱いを事前に決めます。
- サービス変更:機能廃止や価格改定に備えた設計を求めます。
要件を追加する場合は、Change Requestの手続きに沿って扱います。また、取り込み元の欠損や不整合は、要件定義段階のデータプロファイリングで調べます。
設計書・ソースコード・設定ファイルを発注側が所有する旨を契約に記載すると、ベンダー変更が可能な状態を保てます。
まとめ
Azure Synapse Analyticsの導入を外注・委託するときは、次の4点を一貫して押さえます。
- 準備:目的とデータ要件を整理し、RFPを作成します。
- 選定:複数社の実績と提案を比べます。
- 進行:各フェーズの成果を確認・承認します。
- コスト:クラウド利用料と構築費用を合わせて管理します。
リコー、集英社、プロテリアルなど、国内大手企業のデータ分析基盤としての採用事例もあります。適切なパートナーと進めることで、業務改善効果が期待できます。発注前にビジネス要件とデータ要件を整理し、構築実績が豊富なベンダーを複数社比べて選べば、プロジェクトを成功に導きやすくなります。
導入を検討している場合は、専門家への相談から始める方法もあります。
RFP作成前に読みたい無料ホワイトペーパーはこちらです。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。