
データ統合・SoD(意思決定支援)の導入では、DWHやダッシュボードを用意して終わらせないために、誰が、いつ、何を根拠に判断するかを決めておくことが欠かせません。そのうえで、必要なデータと運用のループまで一体で設計します。
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
全体像:データ統合と意思決定支援がもたらす変化
成果が出る取り組みは、データを集めること自体をゴールにせず、現場や経営の日々の判断を前に進めることを目指します。特に、在庫の補充や価格改定、配車、要員計画、仕入最適化のように重要な判断ほど、根拠の確かさと判断の速さが業績に響きます。
成果が出る典型パターン(判断のボトルネックの解消)
判断が遅くなる原因は、大きく三つに集約されます。そこで、統合、定義、可視化、判断支援の順に整えると、意思決定の再現性を作りやすくなります。
- 必要な数字が揃わない:システムの分断、データの欠損、手作業の集計。
- 数字を信頼できない:定義がバラバラで、更新タイミングが分からない状態。
- 判断基準が属人化している:ベテランの経験頼みで、引き継げない状態。
失敗しやすいパターン(ダッシュボード止まり)
「見える化したら使われるはず」と考えて運用と判断の設計を後回しにすると、レポートは眺めるだけで終わりがちです。そこで、誰が、いつ、何を見て、何を決めるかまで定義し、意思決定の導線を作っておきます。
導入設計:対象とする判断の決め方
ツールを選ぶ前に、発注側が対象にする判断を決めておきます。ユースケースが曖昧なままだと、必要なデータも設計もぶれてしまい、完成しない基盤になりやすいためです。
上位3つの判断の選定(インパクト×実行可能性)
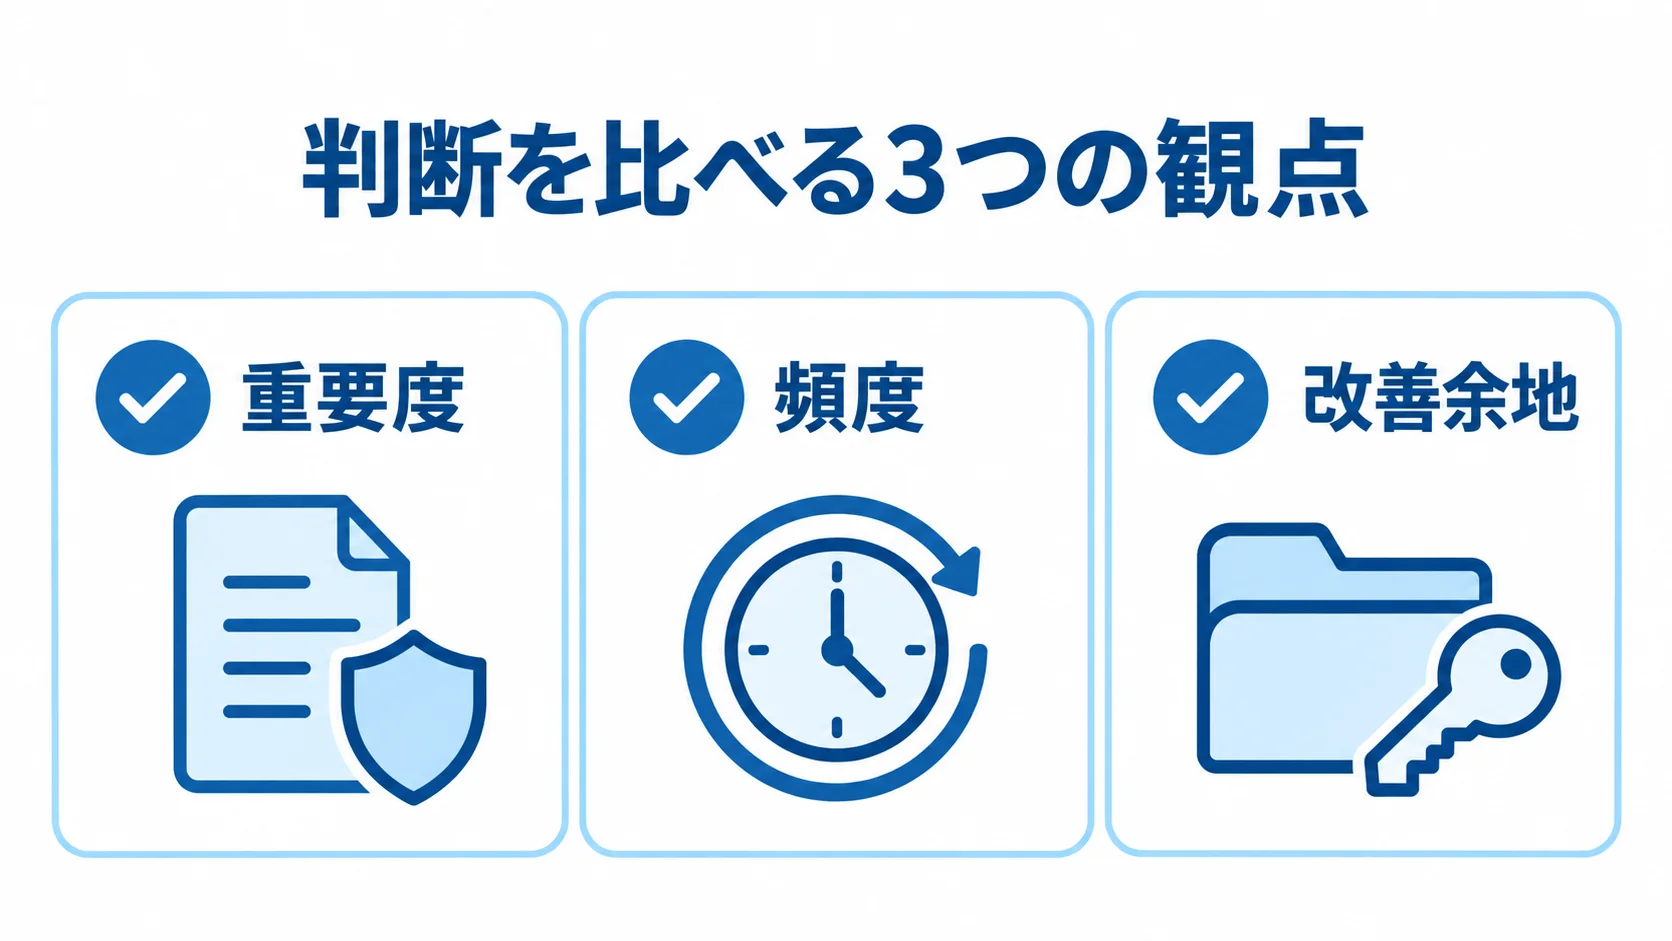
最初に扱う判断は、候補の中から上位3つに絞ります。その際は、重要度、頻度、改善余地の3つの観点で比べると、選びやすくなります。
- 重要度:粗利、欠品、納期、回転率、稼働率など主要KPIに効くか。
- 頻度:毎日・毎週の運用判断で、意思決定の総量が大きいか。
- 改善余地:根拠が弱い、属人的、手作業で遅い状態があるか。
判断の分解と要件化(誰が・いつ・何を・どう決めるか)
判断を要件に落とすには、誰が、いつ、何を根拠に、何を決めるかを一つずつ書き出します。どこか一つでも曖昧なままだと、必要なデータと設計を定めきれません。
- 判断者:現場、マネージャ、経営の誰が意思決定するか。
- 頻度:毎朝、週次会議、月次締めのいつ行うか。
- 入力:売上、在庫、発注残、設備稼働、原価など何を根拠にするか。
- 出力:発注量、配車、値付け、要員、優先順位の何を決めるか。
- 例外:欠損・遅延・異常時に暫定ルールや承認フローをどう適用するか。
データ統合:まず揃えるデータと設計の考え方
意思決定支援の品質は、データ統合の品質でほぼ決まります。まずは対象の判断に必要なデータを、定義・粒度・更新頻度まで揃えることから始めます。ただし、最初から全社のデータを完璧に統合する必要はありません。
最初に揃えるデータ(マスタ・トランザクション・状態)
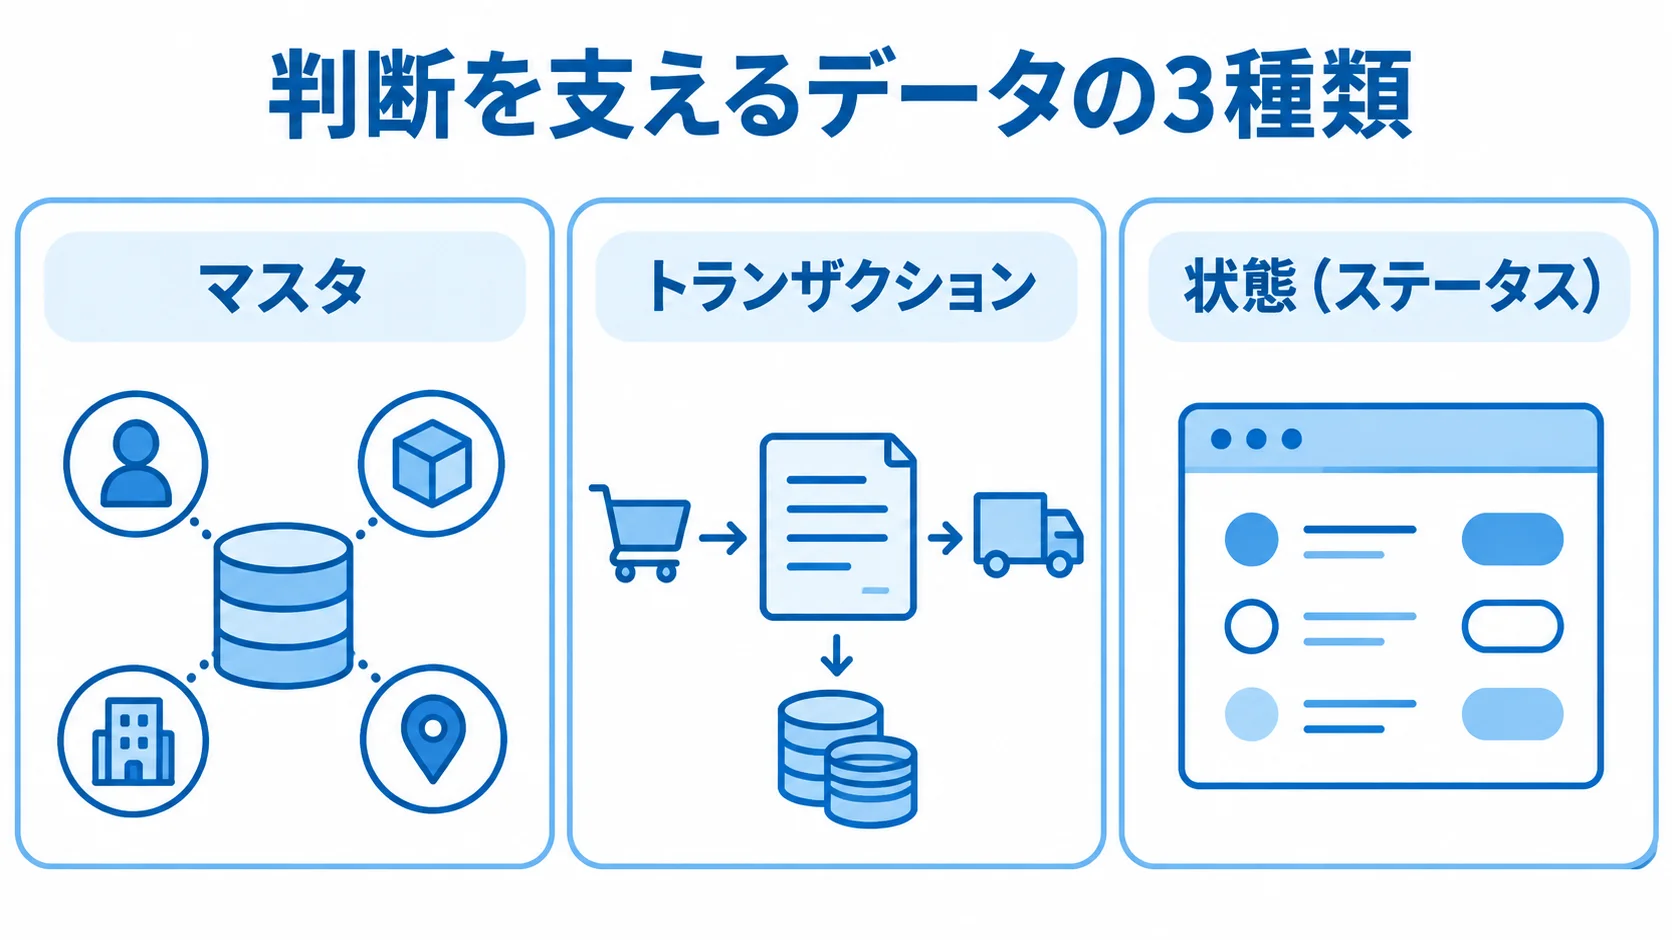
データは役割の違いで三つに分けて考えます。それぞれが、判断の根拠を組み立てる材料になります。
- マスタ:商品、取引先、拠点、顧客、設備など名寄せの基準。
- トランザクション:受発注、入出荷、販売、製造実績などの事実。
- 状態(ステータス):在庫の現在地、進捗、遅延、欠品、異常などのいま。
3種類が揃うと、何が起きているかだけでなく、なぜそうなったかも説明しやすくなります。そこで、判断に必要な範囲から順に整えると、統合を無理なく進められます。
設計で重要なポイント(定義・粒度・更新の揃え方)
定義や粒度、更新の決め方は、データを集める前に揃えておきます。ここがずれると、同じ売上や在庫でも数字が合わなくなります。
- KPI定義:売上、粗利、在庫、欠品、遅延などの計算ルール。
- 粒度:日次・時間・オーダー・SKUのどの単位で分析するか。
- 更新:リアルタイム・日次・週次と、遅延時の暫定値・確定値の扱い。
- ID設計:商品コード・拠点コードの揺れと名寄せの方針。
進め方:PoCで終わらせない実装ステップ
最初から大規模な構築を狙わず、まずは小さく作って現場で使える形にし、そこから段階的に広げていきます。ただし、データ品質や運用、業務への定着を軽く見ると、PoC止まりになりやすいので注意が要ります。
おすすめのフェーズ設計(検証→業務導入→拡張)
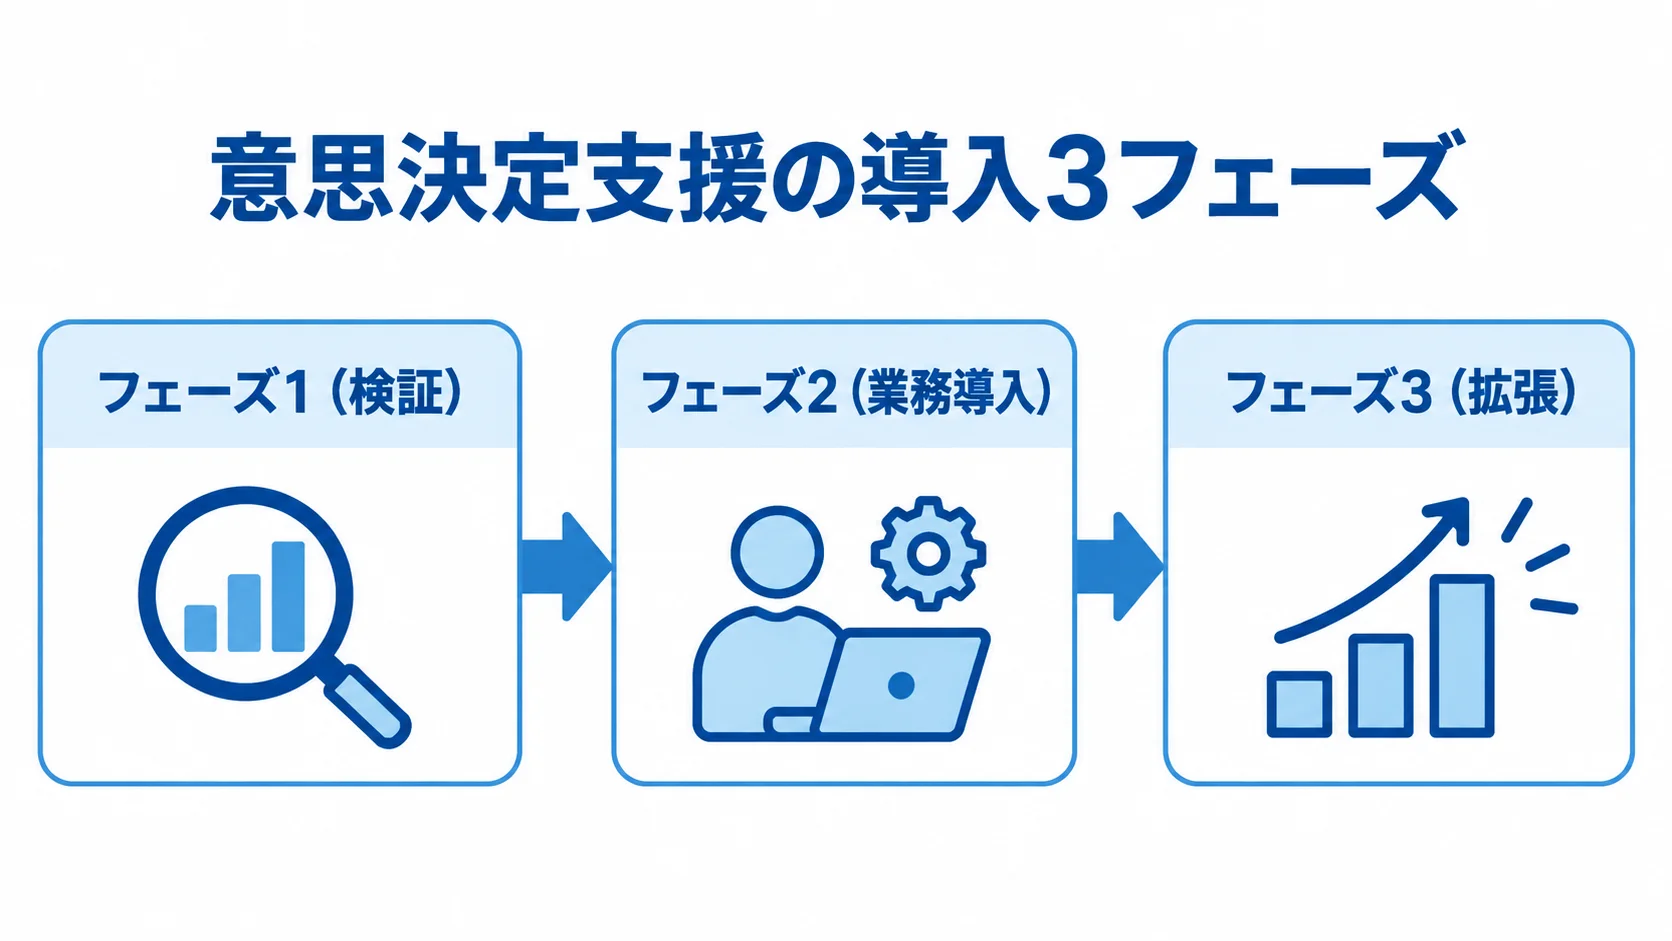
導入は、三つのフェーズに分けて段階的に進めます。フェーズごとに、何を作り、どこまで使える状態にするかを決めておきます。
- フェーズ1(検証):対象判断を絞り、必要データを最小限統合して使える形まで作る。
- フェーズ2(業務導入):更新、例外、権限、監査、教育を整え、継続的に回る状態にする。
- フェーズ3(拡張):判断対象を増やし、推奨(ルール・モデル)や自動化まで広げる。
定着の鍵(運用と意思決定のループの構築)
判断を続けて改善するには、データの更新、意思決定の場、結果の振り返りが回る状態を作る必要があります。
- データ更新:いつ、誰が、何を更新するか。
- 意思決定:会議体、判断者、基準、例外処理。
- 振り返り:結果の検証と、基準やモデルの更新。
費用・予算:見積もりの考え方とコストが増える要因
データ統合と意思決定支援は、不確実性が残りやすく、予算を読みにくい領域です。そのため、総額を一度に決めるより、フェーズごとの設計と成果物の定義を積み重ねて、根拠を作っていきます。
コストの内訳(データ・可視化・運用・推奨)
見積もりは、領域ごとに中身を分けて組み立てます。内訳が見えれば、発注側も費用の根拠を確かめられます。
- データ統合:ETL/ELT、ID統合、定義統一、品質担保、更新設計。
- 可視化:KPI設計、画面設計、権限、ドリルダウン、説明可能性。
- 運用:監視、障害対応、欠損時の暫定運用、教育、変更管理。
- 推奨・自動化:ルール整備、モデル構築、A/B検証、ガバナンス。
費用が膨らむ典型要因(スコープの広げすぎ・定義未確定)
費用が膨らむ場面には、決まった型があります。対象が広がり続けることと、定義が後から決まることが代表的です。
- 対象判断が増え続け、ユースケースが絞れていない。
- KPI定義やマスタ統一が後回しになり、後工程で作り直す。
- 運用設計が最後に乗り、権限・監査・例外で手戻りが起きる。
フェーズごとに成果物と合意ゲートを設け、意思決定の順番を固定しておくと、スコープの膨らみを抑えやすくなります。
外部パートナー活用:選び方と進め方の注意点
外部パートナーを使う場合でも、ユースケース、KPI定義、データ定義は発注側が判断します。特に、ここが曖昧なままだと、比較、契約、進行のすべてがぶれてしまいます。
比較の観点(成果物・体制・進め方・運用の設計)
比べるときは、四つの観点で見ます。契約前に、どこまで含まれるかを確かめておきます。
- 成果物:ユースケース定義、データ定義、KPI、運用設計、移行計画まで含むか。
- 体制:意思決定者の同席頻度と、データ・業務・開発の役割分担。
- 進め方:フェーズ設計、合意ゲート、変更管理、検証手順。
- 運用:監視、保守、改善サイクル、内製化支援。
進行で揉めやすいポイント(責任分界とデータ品質)
進行で揉めやすいのは、誰が何を決めるかがあいまいな場面です。データの提供、定義の承認、追加要望の扱いは、先に担当を決めておけば後の揉め事を減らせます。
- データ提供:誰がどのデータを、いつまでに、どの品質で渡すか。
- 定義の承認:KPIやマスタ統一の最終決裁者は誰か。
- 追加要望:フェーズ外の依頼、変更見積、優先度付けをどう扱うか。
まとめ:「判断の設計」から始める導入
データ統合と意思決定支援は、対象の判断からデータ、運用までを一体で設計するほど、手戻りを減らせます。基準にするのは、ツールや画面ではなく、判断できる状態です。
- 最初はツール選定ではなく、対象にする判断を決める。
- データをマスタ・事実・状態に分け、定義・粒度・更新を揃える。
- 検証→業務導入→拡張の順で、フェーズごとに合意ゲートを作る。
- 予算は統合・可視化・運用・推奨へ分解し、膨張要因を先に潰す。
- 外部パートナーは成果物・運用・責任分界まで含めて比較する。
関連記事
- 意思決定支援システム(SoD)の進め方と事例|構築手順とプロセスを解説
- 意思決定支援システム(SoD)開発の費用・コストは?予算の目安
- 意思決定支援システム(SoD)の外注・発注先選び|委託時の注意点
- 意思決定支援システム(SoD)に強い開発会社・ベンダー・SIer5選
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。