
データレイク構築の開発期間は、小規模で2〜4か月、中規模で4〜9か月、大規模で6〜12か月以上が目安です。構築は、対象データの選定、取り込み・カタログ整備、分析エンジン接続の順に進みます。
データレイクはDWH(データウェアハウス)とは役割が異なります。全体像はデータレイク構築の完全ガイドもご覧ください。
▼全体ガイドの記事
・データレイク構築の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データレイク構築の開発期間の全体像
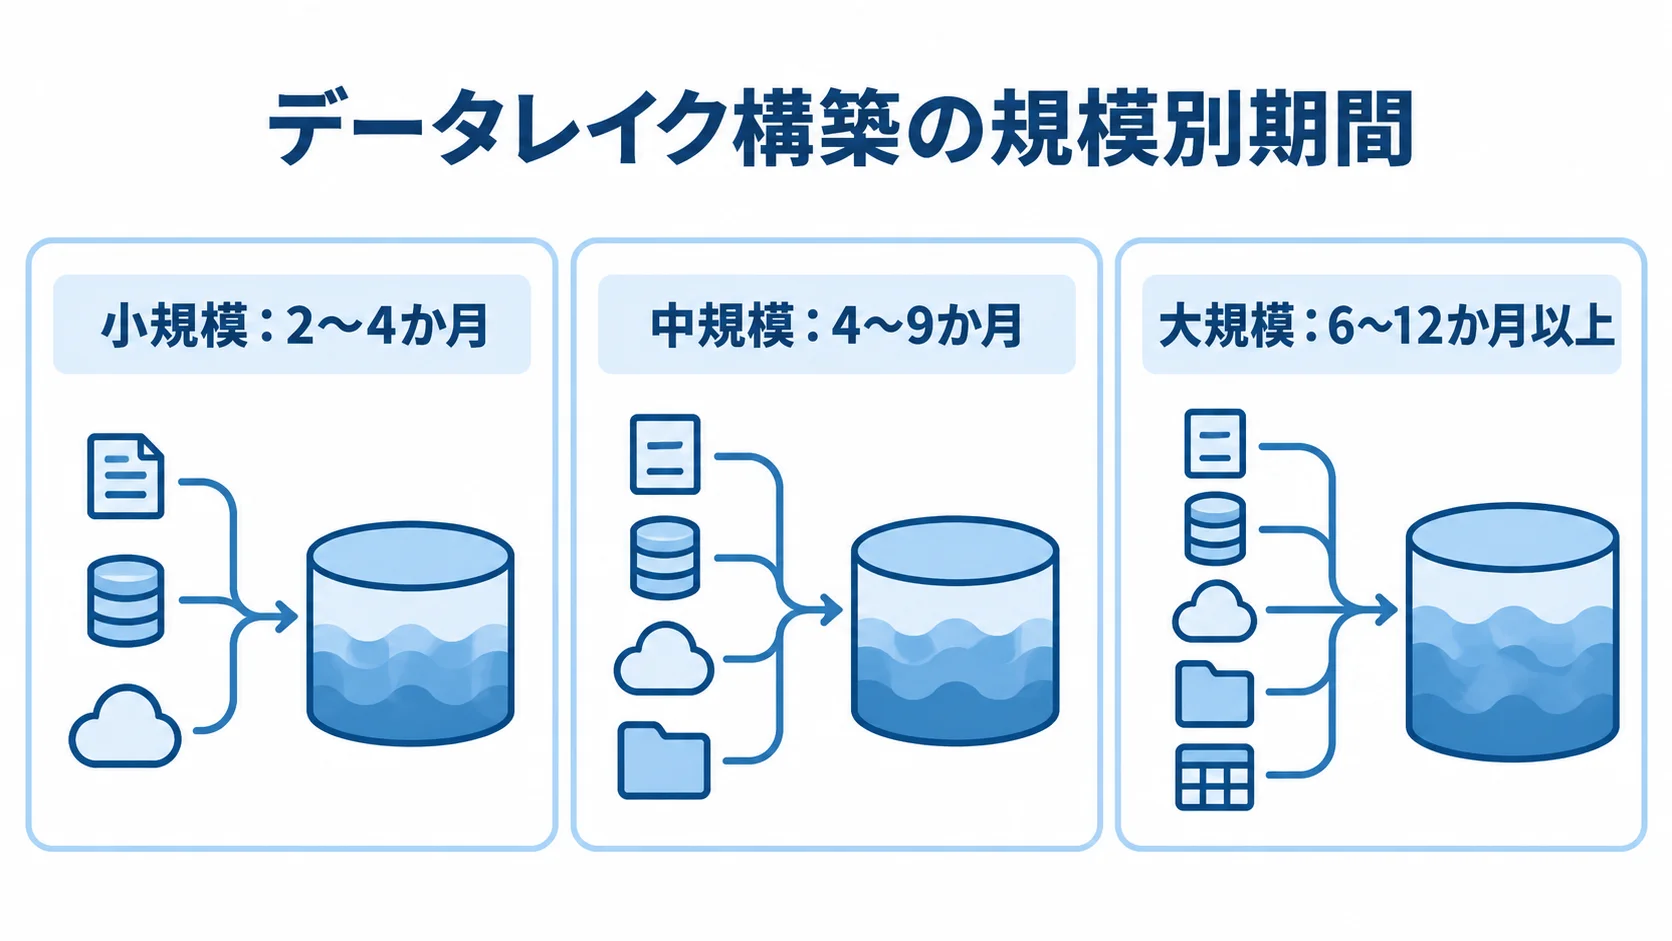
中規模の目安には、複数データソースの取り込み、ゾーン設計、カタログ、分析エンジンへの接続を含みます。構築期間は、データソースの数と種類、データ量によって変わります。カタログとガバナンスの整備範囲や、分析エンジンやBIツールとの連携も期間に影響します。
小規模は2〜4か月、中規模は4〜9か月、大規模は6〜12か月以上が目安です。この規模別の目安を先に把握しておくことが、現実的なスケジュールを描く第一歩になります。
全社のデータを一度に取り込むと、期間が延びるうえ、誰も使わない「データスワンプ(データ沼)」になるおそれがあります。そのため、課題や活用領域を1〜2に絞り、3〜6か月で成果を出すMVP(実用最小限の製品)型の進め方が推奨されます。
クラウドストレージ自体はフルマネージドのため、構築と運用の工数は小さくなります。一方で、期間の多くは、データの取り込みや整理、メタデータ付与、活用への橋渡しに充てられます。
規模別の構築期間と費用の目安
規模の区切りは、取り込むデータの範囲と、整備する機能の広さです。
- 小規模:単一の業務システムやSaaS、ログの蓄積と、簡易カタログによる限定的な参照・分析
- 中規模:複数の基幹システム、SaaS、IoTログ、非構造化データの取り込みと、ゾーンや権限の整備
- 大規模:全社基盤として、AI・機械学習の前処理や厳格なデータガバナンスまで含む構成
期間と初期費用の目安は、小規模が2〜4か月・100万〜300万円程度、中規模が4〜9か月・300万〜1,500万円程度です。大規模は、6〜12か月以上・1,500万〜5,000万円以上が目安になります。
データレイクはストレージの従量課金が中心のため、蓄積だけなら低コストで始められ、スモールスタートに適しています。
中規模では、取り込みパイプラインやガバナンスが中心工程となります。そのうえで、raw・staging・curatedのゾーン設計や、カタログ、メタデータ、アクセス権限を整えます。編成は、データエンジニア、データアーキテクト、プロジェクトマネージャーが標準です。また、AthenaやBigQuery、DWH・BIツールにも接続します。
大規模では、大量データのライフサイクルやデータリネージの管理、段階的な全社展開が必要です。費用と期間は目安であり、クラウドや自社体制によって変わります。そのため、見積もりには余裕(バッファ)を含めておくことが大切です。
構築期間を左右する変数
同じ中規模でも、4か月で済む場合と9か月かかる場合があります。その差を最も大きく左右するのは、取り込むデータソースの数と多様性です。
- データソース:数と種類が増えるほど、パイプラインの設計、実装、テストの量が増えます。
- カタログ:メタデータの設計と検索機能の範囲によって、工数が加わります。
- 活用の深さ:基本参照、DWH・BI連携、AI・機械学習の前処理のどこまでを扱うかで、下流工程が変わります。
- 既存クラウド:AWS・Azure・GCPの利用環境を流用できれば、構築工数を圧縮できます。
メタデータを整えるほど後の活用性は高まりますが、設計と運用の工数も期間に加わります。
多様なデータを生のまま受け入れられる点は、データレイクの強みです。対象には、基幹システム、複数SaaS、IoTログ、非構造化ファイルなどがあります。
生データを蓄積するだけでは、所在が分からないデータスワンプに陥るおそれがあります。これを防ぐには、既存環境の認証やネットワークを使えるかも含めて、これらの変数を要件定義で洗い出しておくことが、精度の高い納期見積もりにつながります。
工程別のスケジュールと期間配分
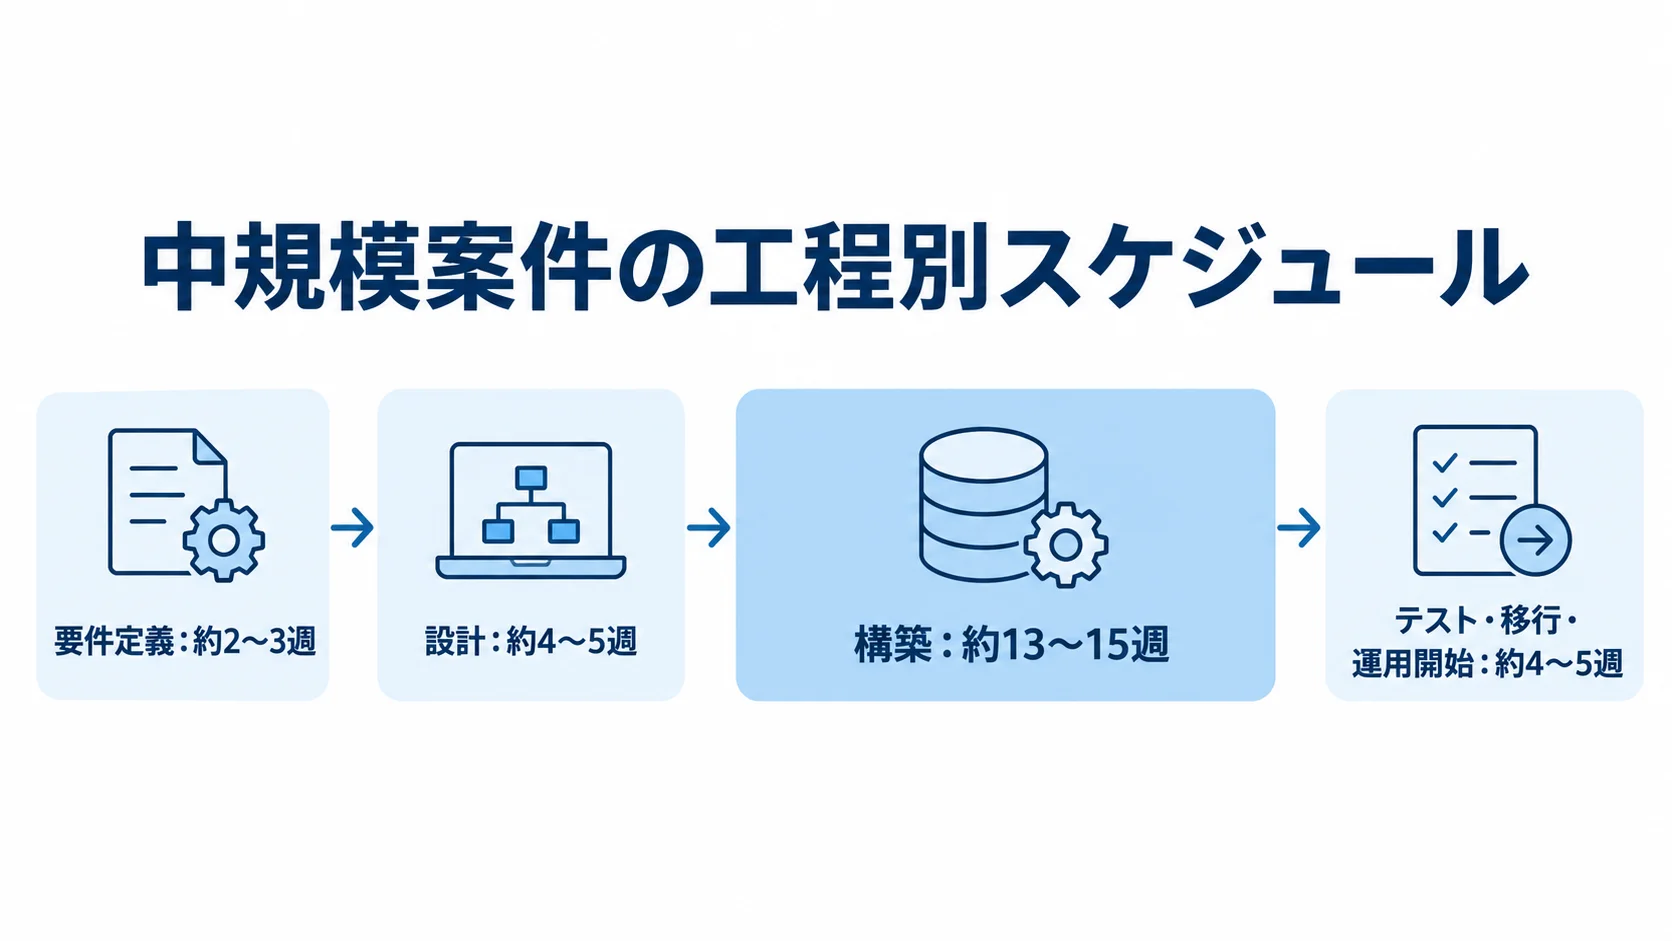
期間の大半は開発・構築に使われ、要件定義と設計、テスト・移行がそれぞれ全体の1〜2割を占めます。
- 要件定義:全体の約10%
- 設計:全体の約10〜20%
- 開発・構築:取り込み、ゾーン、カタログ整備の作業で、約40〜60%
- テスト・移行:全体の約10〜20%
6か月(約26週)の中規模案件では、要件定義約2〜3週、設計約4〜5週、構築約13〜15週、テスト・移行・運用開始約4〜5週が目安です。特に、開発・構築フェーズが最も工数の大きい山場になります。
蓄積設計では、どのデータをどのゾーンに置き、どのメタデータを付け、どう活用するかを決めておく必要があります。ここが曖昧なままだと、後工程で手戻りが増えます。
上流に十分な時間を確保することが、構築工数と使いやすさを左右します。生データの蓄積だけなら早く済みますが、使える状態にする設計こそが期間配分の要です。
要件定義・設計フェーズ(全体の約20〜30%)
要件定義・設計は、データレイク構築の成否を左右する工程です。「とりあえず全部蓄積する」という発想は、データスワンプ化の入口になります。
発注側と開発会社が、事業課題や活用シナリオから逆算して、対象データとメタデータの方針を決めます。
- 対象データ:ソース、発生量、更新頻度、構造化・半構造化・非構造化の形式の確認
- ゾーンと基盤:raw・staging・curatedの構成と、Amazon S3・ADLS・GCSの選択
- 管理方針:カタログ・メタデータ、アクセス権限、個人情報のマスキング、データ来歴の設計
- 下流連携:分析エンジンやDWH・BIツールへの接続方針
設計の内容を文書に残しておけば、後工程の手戻りを防げます。上流工程には、全体の約20〜30%を充てるのが現実的です。
開発会社と相談して、ストレージは既存のクラウド利用状況やデータの所在をもとに選びます。上流設計を省くと、後から使えない基盤になりかねません。
取り込み・カタログ構築・テストフェーズ(全体の約50〜70%)
構築工程は全体の5〜7割を占めます。開発会社が、ストレージ、ネットワーク、セキュリティを設定し、取り込みパイプラインを実装します。
- 取り込みと加工:日次・時次のバッチか、逐次流すストリーミングかの選択(鮮度要件に応じて)
- ゾーンとカタログ:rawへの蓄積、curatedへの加工、メタデータ登録の組み込み
- 反復開発:2週間〜1か月単位のスプリントによる成果の確認
- テスト:欠損・重複、メタデータ、権限、分析エンジンからのクエリの検証
DWHはスキーマオンライトで、書き込み時に構造を固めます。そのため、厳密なデータモデルと変換ロジックを、取り込み時に作ります。
データレイクはスキーマオンリードです。読み取り時に構造を当てるので、まず生データを蓄積しておき、活用時に解釈できます。
初期の取り込みは比較的軽く始められます。一方で、後から活用しやすくするメタデータの整備が工程の要になります。
ストレージはマネージドサービスのため、サーバーのプロビジョニングやパッチ適用、冗長化をクラウド事業者に任せられます。その分、開発チームは取り込みとカタログに集中できます。
中規模では、構築とテストに13〜16週程度を見込みます。上の配分では、構築に約13〜15週を割り当てています。
データレイクならではの期間に関わる特性
DWHをフルスクラッチで作る場合と比べると、データレイクはストレージ層を速く立ち上げられます。一方で、分析まで完結させるには、分析エンジンなどとの組み合わせが必要です。
データレイクは生データを蓄積する土台です。分析エンジンやカタログと組み合わせて価値を生む点が、DWH単体との違いです。
期間に影響する特性は、立ち上げの速さと、分析に必要な構成の2つに分けて見ていきます。
マネージドストレージによる立ち上げの速さ
クラウドとオンプレミスでは、ストレージの準備にかかる時間と運用の方法が異なります。
- クラウドの準備:フルマネージドのサービス
- オンプレミスの準備:機器の選定・調達に数週間、設置・設定・冗長化にさらに数週間から数か月
- 容量と料金:作成直後から実質無制限に近い容量を、使った分だけの課金で使える仕組み
- 初期蓄積:生データだけなら、要件定義と並行して数日から数週間で蓄積を開始できる
Amazon S3、Azure Data Lake Storage、Google Cloud Storageの各サービスは、コンソールからバケットやコンテナを短時間で用意でき、物理的な準備も不要です。
Amazon S3はデータレイクのデファクトスタンダードとして広く使われています。ライフサイクル管理は、アクセス頻度の低い古いデータを安価な階層へ自動で移す仕組みで、ストレージクラスと合わせて使うと、コストの最適化につなげられます。
厳密なデータモデルを先に固めずに始められるため、実データを集めて活用を検討する時期を前倒しできます。すぐに、安く、大量に蓄積できる性質が、初期の立ち上げを速め、構築のリードタイム短縮につながります。
カタログ整備と分析エンジン接続の工数
データレイクは蓄積の場所で、分析には別途、分析エンジンが必要です。そのため、構築期間には、蓄積したデータを利用できる状態にする工程も含めて考えます。
- 分析エンジン:Amazon AthenaやGoogle BigQueryなどの組み合わせ
- 接続設計:分析エンジンやDWH・BIツールへの接続を、設計から実装まで
- カタログ:データ内容、取り込み時期・場所、品質、利用権限の記録と、検索できる状態の確保
DWHは蓄積から分析までを1製品で完結でき、レイクハウスはストレージと分析エンジンを統合しています。一方で、データレイクでは下流連携の作り込みが相応の工数を占めます。
データカタログとメタデータ管理の整備も、構築期間を大きく左右します。これを軽視すると、データがあっても使えない状態になりかねません。
データレイク構築で納期を短縮する具体的な方法
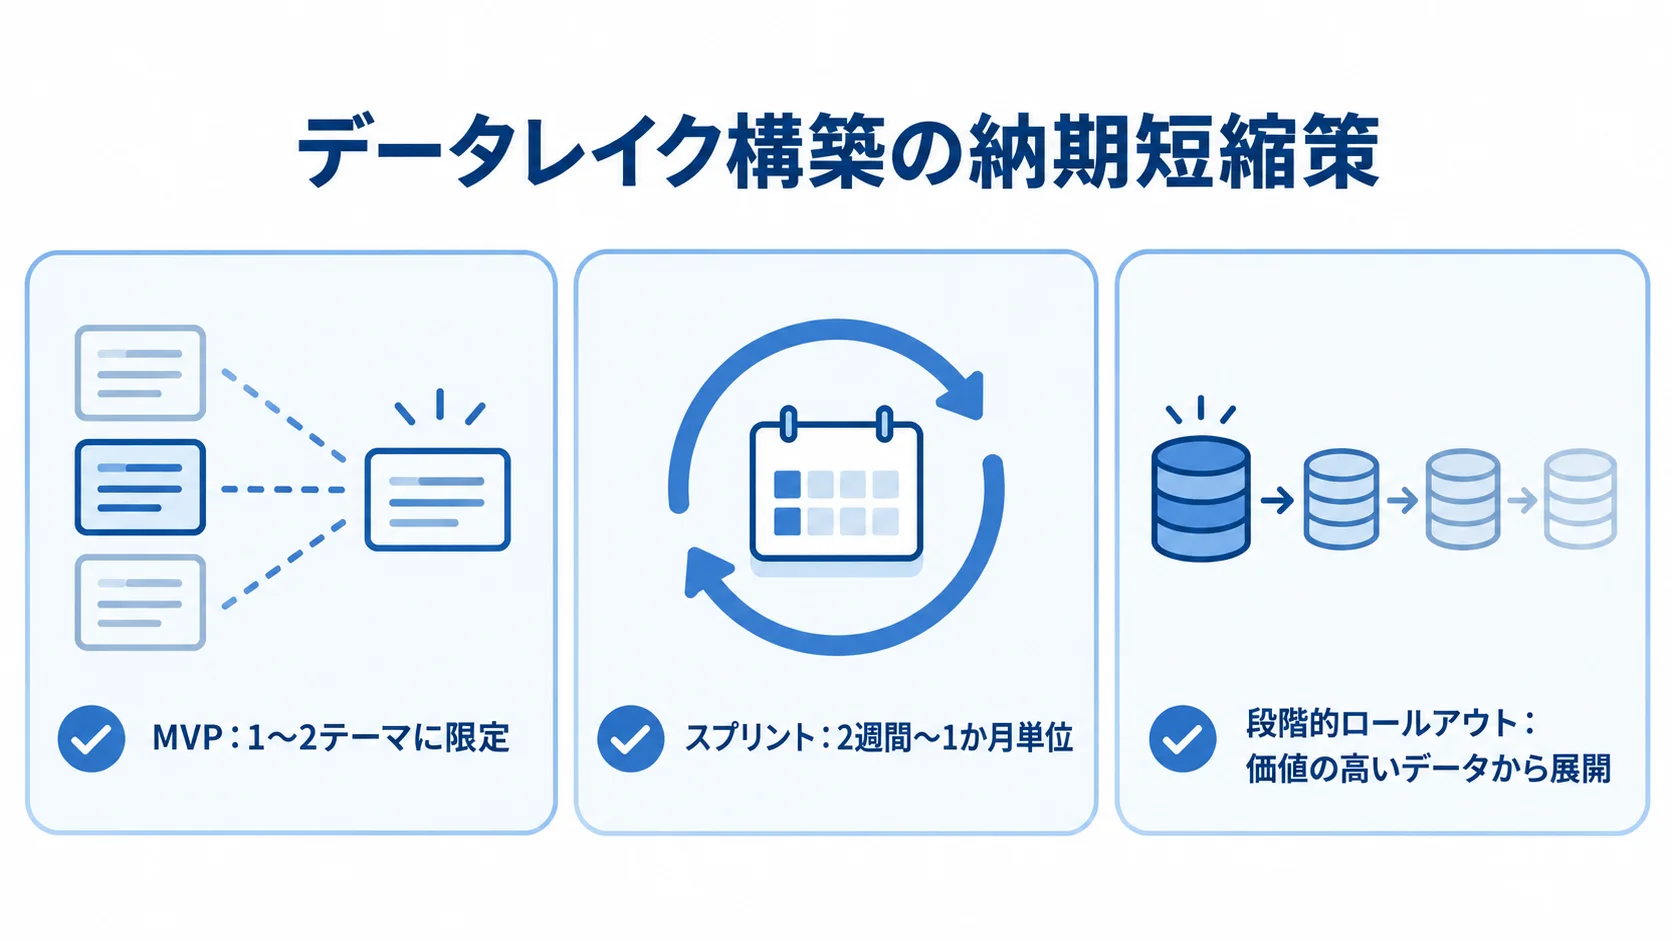
マネージドストレージの利点に加えて、MVPとアジャイル開発・段階的ロールアウトを使えば、納期を短縮できます。特に、蓄積するデータと活用方法を絞ることが、短期間で価値を出す鍵です。
1〜2の活用テーマに絞ったMVPアプローチ
納期短縮に最も効果的なのは、最初のリリース範囲を厳しく絞ることです。成果と現場・経営への影響が大きいテーマを、発注側と開発会社で選びます。
- 対象を限定:1〜2テーマでPhase 1(MVP)を構築し、データソースやカタログ整備、合意形成の範囲を抑えます。
- 活用例:Webアクセスログと購買データによる顧客行動の分析、または工場のセンサーデータのAI開発用の蓄積
- 段階的に拡張:1領域で成果を得て社内の理解と予算につなげ、Phase 2以降にデータやDWH・AI連携を広げます。
まず、発注側が明確な活用シナリオを決めることが出発点です。対象を絞れば、データソース、ゾーン設計、カタログがシンプルになり、3〜6か月で成果を出せます。
全社を網羅する基盤を最初から作るより、価値のあるデータを活用できる形で小さく蓄積して育てるほうが、結果的に最短ルートになります。
アジャイル・スプリントと段階的ロールアウト
構築を2週間〜1か月単位のスプリントに区切ると、短いサイクルで確認できます。要件をすべて最初に固めるウォーターフォール型と比べて、活用の実像を見ながら手戻りを減らせます。
- データの取り込み
- カタログへの登録
- 分析エンジンからの参照
- 関係者からのフィードバック
スキーマオンリードで柔軟に取り込めるため、使いながら整える反復開発と相性があります。各スプリントの終わりに関係者がデータを確認すれば、追加データや不足メタデータへの認識のずれを早期に修正できます。
本番展開は、一斉取り込みではなく、価値の高いデータソースから段階的に進めます。そのうえで、一部で活用を確かめ、カタログやガバナンスの課題を洗い出してから対象を広げます。この進め方は、手戻りやデータスワンプ化による停滞を防ぎ、全体の納期を守ることにつながります。
納期遅延の典型要因と対策
クラウドストレージは速く立ち上げられますが、データレイクには固有の遅延リスクがあります。特に多いのは、データ品質・前処理の見積もり漏れと、データスワンプ化とスコープの膨張です。
データ品質・前処理の見積もり漏れ
生データの取り込みが順調でも、活用時に品質問題が見つかる場合があります。表記ゆれ、重複、欠損、形式の不統一により、名寄せやクレンジングに数か月かかることがあります。
データ基盤の現場では、名寄せとクレンジングだけで半年かかった例も珍しくありません。前処理の遅れを防ぐため、次のように備えます。
- 早期確認:要件定義の段階で実データのサンプルを見て、品質を把握
- 工数確保:「データはきれい」と仮定せず、活用時の前処理を見積もりに含める
- 段階的な整備:rawは加工せず保持し、staging・curatedで優先テーマに必要な範囲から品質を高める
- 継続運用:クレンジングルールを運用する体制の設計
完璧なデータ整備を待たずに活用を始めることが、遅延の連鎖を防ぎます。
データスワンプ化とスコープの膨張
設計方針のない蓄積や追加要望は、データの混乱とプロジェクトの停滞につながります。
- データスワンプ:所在や信頼性が分からず、目的のデータ探しや棚卸しに時間がかかる状態
- サイロ化:S3・Excel・DWHにデータが散らばり、基盤の外で手作業のマージが続くこと
- 利用停滞:高価な基盤があっても、現場のExcel利用が続き「高級なデータ置き場」になること
- 追加要望:Phase 1の範囲の明確化と、追加分の影響・工数を見積もったうえでの合意
要件定義の段階でカタログとメタデータの方針を決めておくと、取り込み時に所定の情報を付けるルールを運用しやすくなります。
追加要望は、Phase 2以降のバックログに記録して、初回リリースの範囲を保ちます。
データを秩序立てて蓄積する設計と運用が、遅延を抑え、使われ続ける基盤につながります。
まとめ
期間の目安は、小規模が2〜4か月、中規模が4〜9か月、大規模が6〜12か月以上です。工程配分は、要件定義約10%、設計約10〜20%、開発約40〜60%、テスト・移行約10〜20%が目安になります。
Amazon S3・ADLS・GCSはフルマネージドで、データを速く蓄積できます。一方で、分析エンジン接続とカタログ整備も必要なため、蓄積だけでなく下流工程も納期に含めて考えます。
1〜2の活用テーマに絞るMVP、2週間〜1か月のスプリント、段階的なロールアウトを組み合わせれば、小さく立ち上げられます。あわせて、データ品質の前処理やデータスワンプ化、範囲の膨張を防ぐ準備も欠かせません。
DWHの前段としてデータを集約し、将来のAI・機械学習にも使う土台だからこそ、秩序を保って育てる計画を立てましょう。
▼全体ガイドの記事
・データレイク構築の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。