
データレイク構築は、要件定義、環境設計、データ収集を順に進め、ガバナンスを整えることで、機械学習やBI分析などの活用につながります。
IoTセンサーのログ、SNSのテキスト、業務システムの取引データなど、企業データは種類も量も年々増えています。進め方や費用、開発会社の選び方、発注の流れまでを一つのガイドにまとめました。
▼データレイク構築に関する詳細記事
・データレイク構築/開発の進め方/やり方・プロセスを徹底解説
・データレイク構築でおすすめの開発会社6選・比較ポイント
・データレイク構築の見積相場や費用・コスト内訳を徹底解説
・データレイク構築の発注/外注方法・手順と注意点
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データレイク構築の進め方
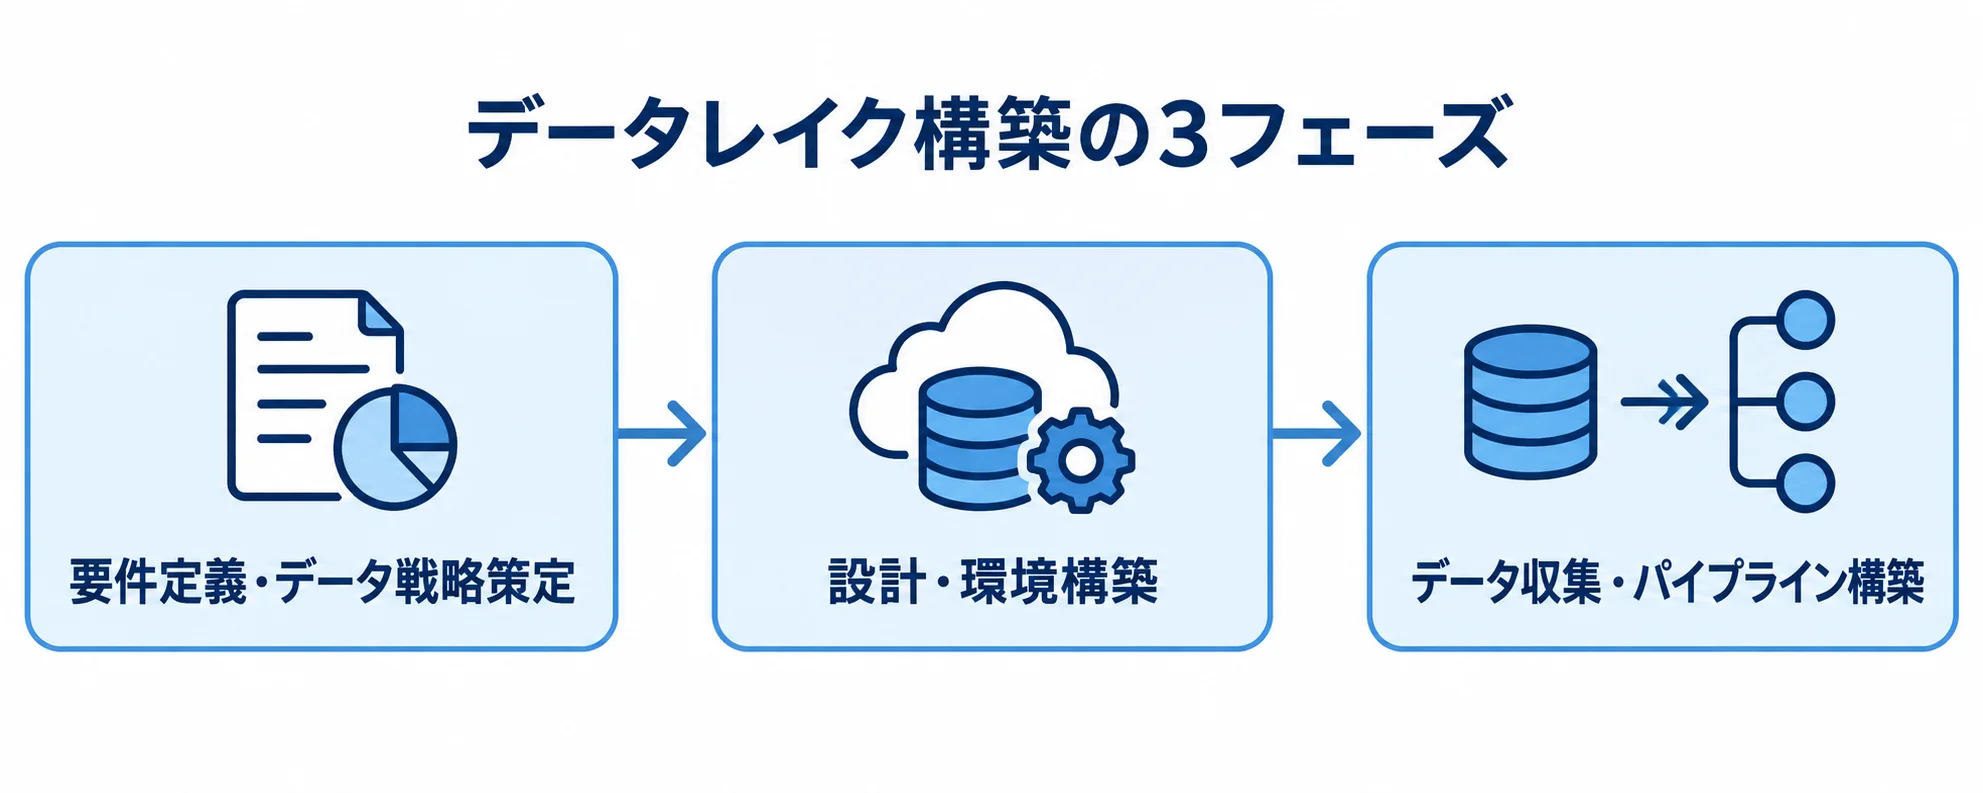
データレイク構築は、要件定義・データ戦略策定、設計・環境構築、データ収集・パイプライン構築の3フェーズを順に進めるのが基本です。各フェーズで成果物をまとめ、関係者の合意を取りながら進めると、手戻りのリスクを最小化できます。
要件定義・データ戦略策定フェーズ
要件定義では、データレイクを活用する目的と、基盤の設計方針を具体化します。この段階で決めた内容は、後の設計と開発の前提になります。
- 利用要件:目的、対象データソース、利用者とそのシナリオを明確にします。
- 非機能要件:セキュリティ、可用性、パフォーマンスなどの条件を定義します。
- 基盤と管理方針:AWS・Azure・GCPからクラウドを選び、Bronze/Silver/Gold層のゾーニング、データカタログ、ガバナンスを決めます。
- ビジネス価値:ビジネス部門とIT部門が実現したい価値を整理し、技術要件に落とし込みます。
要件定義フェーズは全体工程の20〜30%を占めるうえ、この段階の質が後工程の品質と生産性を大きく左右します。
設計・環境構築フェーズ
この段階では、開発会社が中心になって基盤の構成を決めます。
- ストレージと形式:バケットやディレクトリの設計、Parquet・ORCなどのデータ形式を定めます。
- ネットワーク・権限・安全性:VPC・セキュリティグループ、IAMとアクセス制御、暗号化・監査ログを設計します。
- 環境構築:Terraform・CloudFormation・BicepなどのIaCツールを使い、再現性の高い環境を作ります。
- 環境の分離:本番・ステージング・開発の3環境を分け、変更管理プロセスを明確にします。
- ライフサイクル管理:ホット・コールド・アーカイブ層への自動移行を設計に組み込みます。
データライフサイクル管理を設計の段階で組み込んでおけば、長期的に費用を抑えられます。
データ収集・パイプライン構築フェーズ
このフェーズでは、各データソースからデータレイクへ取り込むパイプライン(インジェスト)を実装します。取り込みの頻度や即時性に応じて、バッチ処理とリアルタイム処理を使い分けます。
- バッチ処理:AWS Glue・Azure Data Factory・Apache Airflowなどを活用します。
- リアルタイム処理:Apache Kafka・AWS Kinesis・Azure Event Hubsなどを組み合わせます。
各パイプラインには、Great ExpectationsやdbtのTestsを使った品質チェックを組み込みます。さらに、基準を満たさないデータを隔離して通知する仕組みも設けます。
また、Apache SparkやDatabricksによる大規模データの変換処理と、データカタログへのメタデータ自動登録も実装します。
テストでは、データの整合性・性能・セキュリティを検証します。そのうえで、本番相当のデータ量を使った負荷テストも実施します。
▶ 詳細はこちら:データレイク構築の進め方・プロセス詳細
データレイク構築でおすすめの開発会社
パートナーは、技術力・実績・業務理解力を備えているかを確認して選びます。適切なパートナーと組むと、構築期間の短縮や技術リスクの低減、ノウハウの組織内移転につながります。選定のポイントを示したうえで、おすすめの開発会社6社を紹介します。
パートナー選定のポイント
選定時は、各社の提案を同じ基準で比べると、総合的な評価がしやすくなります。
- 類似プロジェクトの実績:業界・規模・技術スタックが近い案件を手がけているかを確認します。
- 技術力:クラウド認定資格やデータエンジニアリングツールでの実装経験の有無です。
- ガバナンスと品質管理:データの品質を保つノウハウがあるかどうかを確かめます。
- コミュニケーションと相性:やり取りの進め方やカルチャーフィットを見ます。
- 構築後の支援:運用保守と内製化支援の体制を確認します。
要件定義の段階から伴走できるか、データスワンプを防ぐガバナンス設計の知見があるかは、長期的な成功に関わります。これらを見極めるためにも、複数社の技術提案や費用、体制を比べて選びます。
おすすめ開発会社6選
データレイク構築を手がける開発会社・コンサルティング会社を6社紹介します。それぞれの特徴を比べるときの参考にしてください。
- 株式会社ripla:データ戦略コンサルから開発・運用まで一貫して対応します。中堅・大手企業向けのクラウドネイティブなデータ基盤構築に実績があります。
- アクセンチュア:グローバルなデータ戦略コンサルとクラウド実装を組み合わせます。DatabricksやSnowflakeの大規模導入実績があります。
- NTTデータ:大規模エンタープライズ向けのシステム開発に実績があります。レガシーシステムとの連携・移行が得意分野です。
- 富士通:データプラットフォーム構築の総合力があり、製造・流通分野の業務知識を備えています。
- 電通国際情報サービス(ISID):CDPやDMPと連携するマーケティングデータ基盤の構築に強みがあります。
- TIS株式会社:クラウドネイティブなデータ基盤構築とモダンデータスタックへの対応力が特徴です。
▶ 詳細はこちら:データレイク構築でおすすめの開発会社6選・比較ポイント
データレイク構築の費用相場
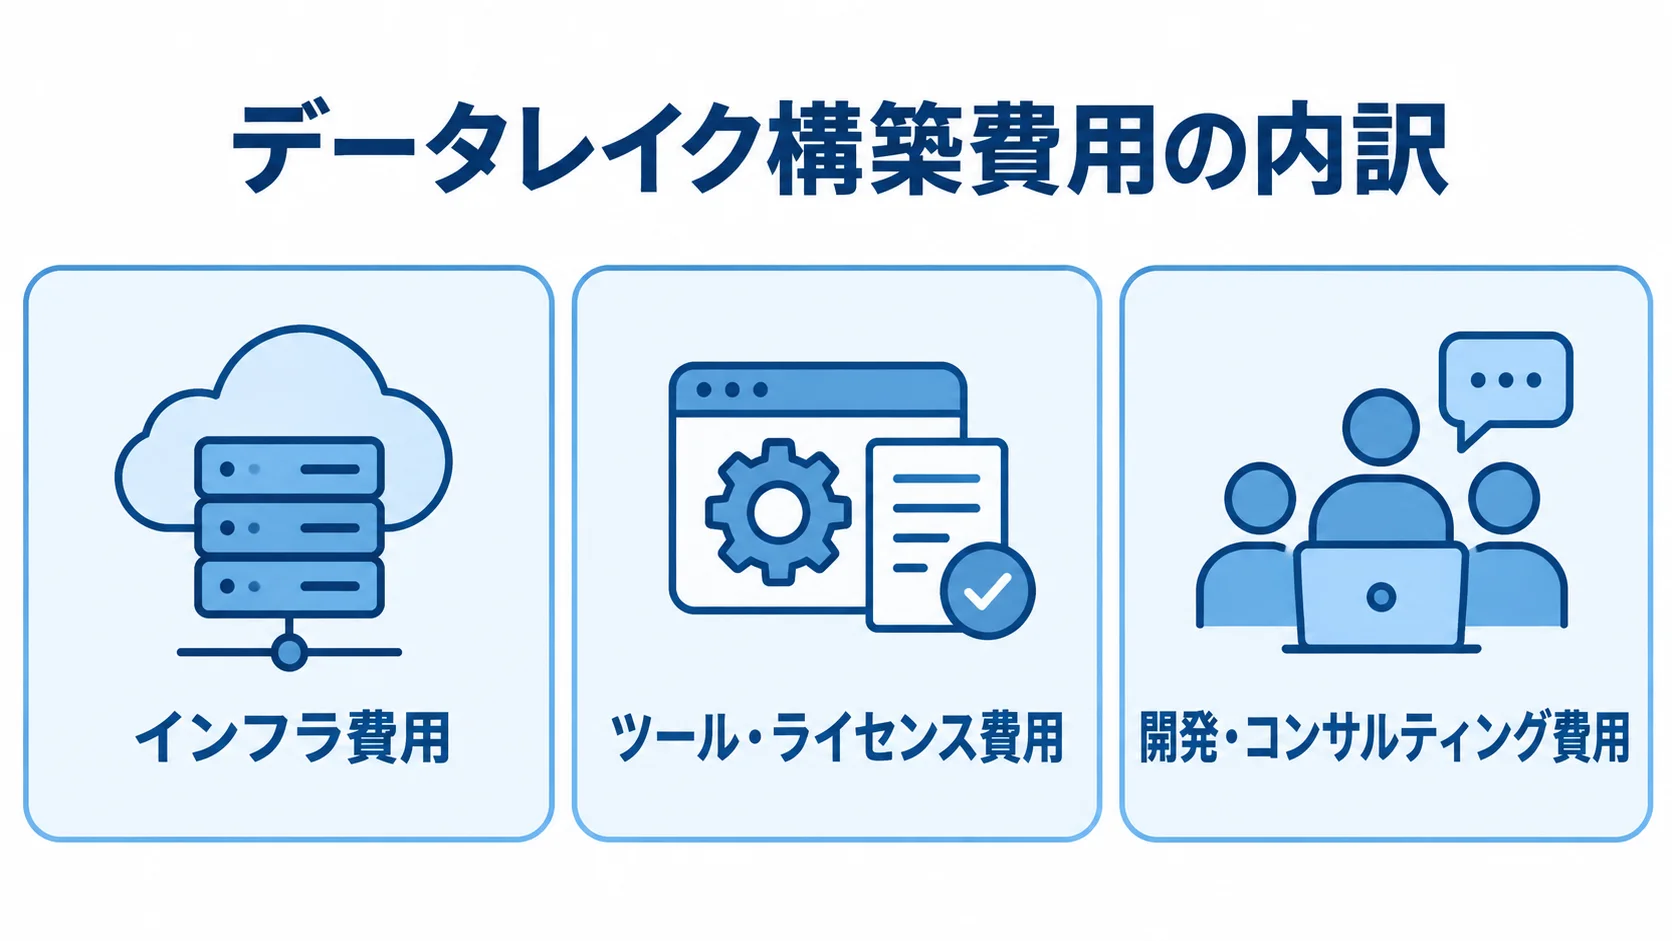
構築費用は、プロジェクトの規模や複雑さ、採用するクラウドサービスやツールによって変わります。そのため、初期費用と運用費の両方を含むTCO(総保有コスト)で評価します。以下では、規模別の費用目安と費用の内訳を示します。
規模別の費用目安
初期費用と月額のランニングコストは、構築規模と処理要件によって変わります。
- 小規模:データエンジニア1〜2人、数テラバイト規模。初期費用は100万〜500万円、月額は5万〜30万円程度です。
- 中規模:複数部門のデータ統合、10〜30本のパイプライン。初期費用は500万〜2,000万円、月額は30万〜200万円です。
- 大規模エンタープライズ:全社横断、100本以上のパイプライン、リアルタイム処理を含む規模です。
大規模では、初期費用が2,000万〜1億円以上、月額が200万円以上になるケースもあります。さらに、Databricksやコンサルティングファームを活用すると、費用はいっそう高くなることがあります。一方で、MVPから始めて段階的に拡張すれば、初期投資を抑えながらリスクを低減できます。
費用の内訳
費用は、インフラ、ツール・ライセンス、開発・コンサルティングの3つに大別されます。
- インフラ費用:AWS S3($0.023/GB/月)・Glue・EMR・Athenaなどのクラウドサービス利用料です。
- ツール・ライセンス費用:Databricks(月50万〜300万円)・Snowflake・dbt Cloud・Collibraなどです。
- 開発・コンサルティング費用:総コストの50〜70%を占めることが多く、データエンジニアの市場単価は月80万〜150万円程度です。
ツール費用は、Apache Atlas・DataHub・Great ExpectationsなどのOSSを活用すれば、負担を軽くできます。
インフラ費用は、Reserved Instancesやスポットインスタンスを使う方法、パーティション設計の見直しでも抑えられます。また、コストを定期的に見直すことも有効です。
▶ 詳細はこちら:データレイク構築の見積相場や費用・コスト内訳を徹底解説
データレイク構築の外注・発注方法
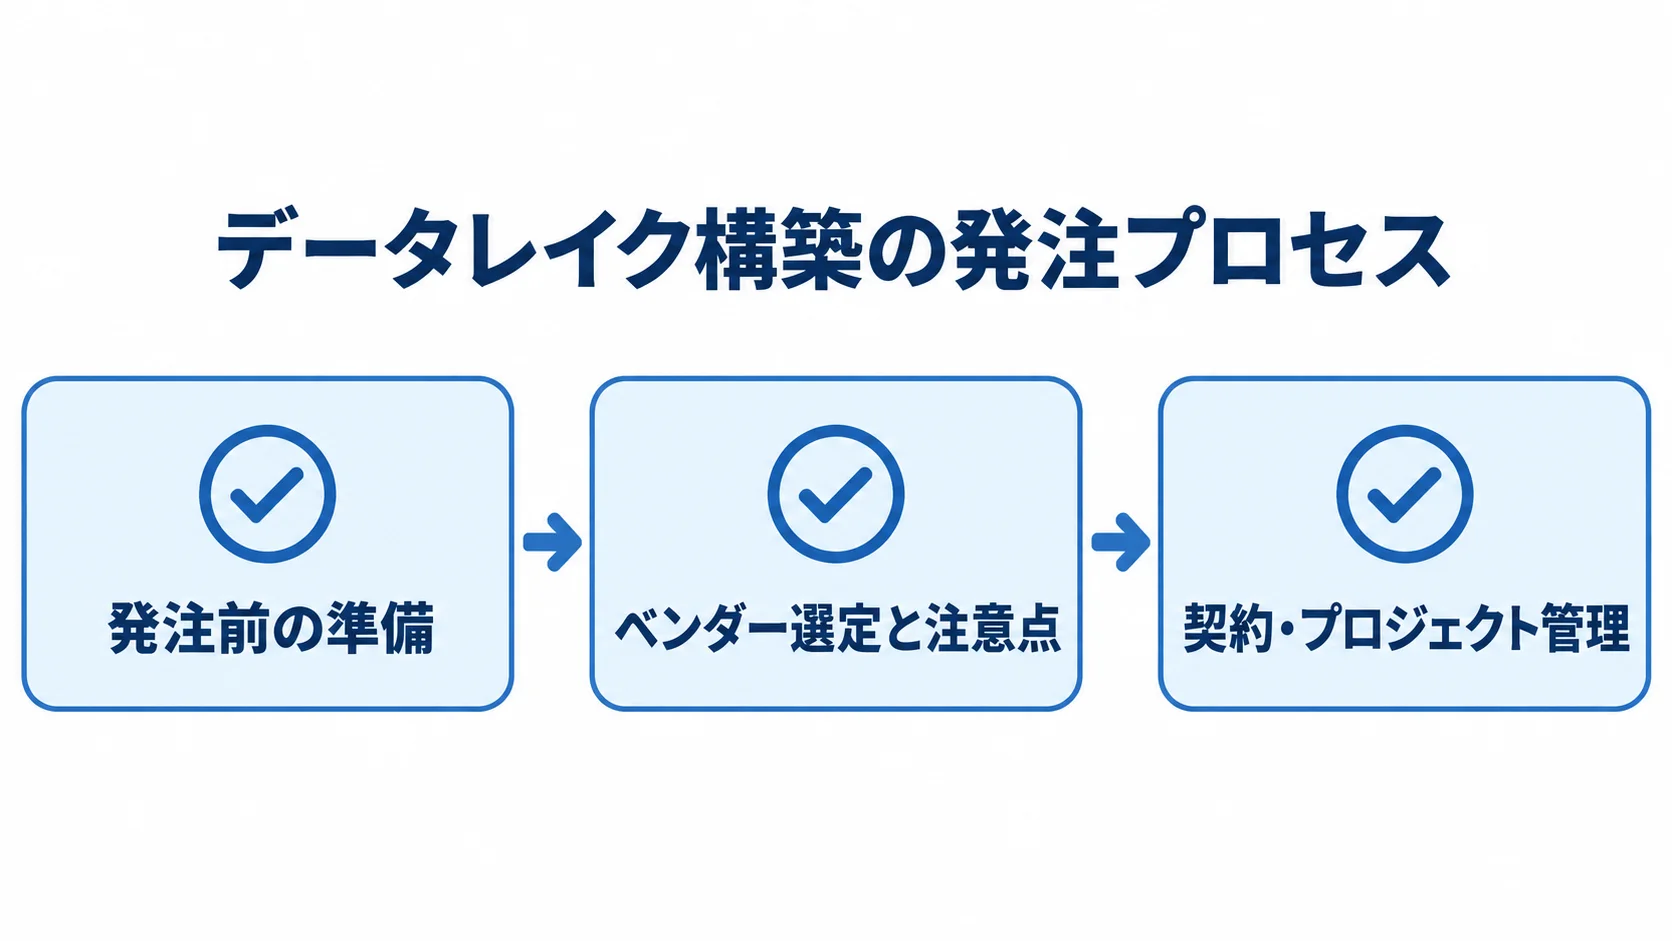
データレイク構築を外部パートナーに依頼するときは、準備、ベンダー選定・見積もり比較、契約・プロジェクト管理の3段階で進めます。
発注の進め方はプロジェクトの成否に関わるため、各段階を丁寧に進めます。
発注前の準備
発注前には、精度の高いRFP(提案依頼書)を作り、社内で要件を合意しておきます。
- 背景・対象・利用環境:背景・目的、対象データソース、利用者とユースケース、現在の技術環境を記載します。
- 計画と要件:スケジュール、予算規模、セキュリティの条件を具体的に示します。
- 内外製の範囲:外注する範囲と内製する範囲を分け、ベンダーとの認識のずれを防ぎます。
- 社内合意:IT・事業・法務・情報セキュリティなどの部門から要件を集め、RFPに反映します。
- データソース一覧:ソース名、データ型、データ量、更新頻度、接続方式を記載します。
RFPに具体的な情報があるほど、見積もりの精度が上がり、後のトラブルも防げます。
ベンダー選定と注意点
3〜5社に提案を依頼し、技術提案と費用を中心に評価します。体制とスケジュールも合わせて比べます。価格だけで選ぶと、技術力不足や品質問題を招くおそれがあります。
選定や契約の段階では、見落としやすいリスクを押さえておくことが大切です。
- 要件定義の不足:後工程で手戻りが起きることがあります。
- データ品質の問題:構築後にデータを活用しにくくなる場合があります。
- スコープ外の追加費用:想定を超えるコストにつながることがあります。
- ベンダーロックイン:特定ベンダーへ過度に依存する状態です。
対策としては、変更の進め方を明確にし、データ品質管理もスコープに含めます。特定のベンダーに偏らないよう、マルチベンダーに対応した設計や段階的な構築も有効です。
契約では、どこまでを作業範囲とするか、何を納めるかを明確にします。変更の手続き、知的財産権、データの取り扱いも定めます。
▶ 詳細はこちら:データレイク構築の発注/外注方法・手順と注意点
まとめ
ここまで、データレイク構築の進め方、開発会社、費用相場、発注方法を順に見てきました。データレイクは、構造化・半構造化・非構造化のデータを原形のまま大規模に蓄積し、機械学習やBI、リアルタイム分析に活用できるデータ基盤の中核です。
AWS S3・Azure Data Lake Storage・Google Cloud Storageを使うクラウドネイティブな構成が主流です。また、Apache Spark・Kafka・Databricksなどを組み合わせると、高度なデータパイプラインを構築できます。
成功には、データガバナンスを早い段階で整え、「データスワンプ(データ沼)」化を防ぐことが欠かせません。適切なパートナーと組むことは、構築リスクを抑えることにもつながります。
riplaでは、コンサルティングから開発・運用まで一貫して対応しています。各詳細記事もあわせてご覧ください。
▼データレイク構築に関する詳細記事
・データレイク構築/開発の進め方/やり方・プロセスを徹底解説
・データレイク構築でおすすめの開発会社6選・比較ポイント
・データレイク構築の見積相場や費用・コスト内訳を徹底解説
・データレイク構築の発注/外注方法・手順と注意点
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。