
データレイク構築のランニングコストは、月額数万円から200万円以上まで、データ量、分析頻度、運用体制によって変わります。
データレイクは、クラウドストレージを基盤に、構造化・半構造化・非構造化データを生のまま蓄積する仕組みです。費用は、この蓄積と分析の両方にかかります。
▼全体ガイドの記事
・データレイク構築の完全ガイド
データ基盤構築の費用の考え方や見積もりの注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
▼見積依頼前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
データレイク構築のランニングコストの全体像
ランニングコストは、システム維持費と保守・運用費用に分けて考えると整理できます。システム維持費はストレージや分析エンジンなどの利用料、保守・運用費用は人件費や改善費用にあたります。
システム維持費には、Amazon S3やAzure Data Lake Storage(ADLS)、Google Cloud Storage(GCS)などのクラウドストレージの料金が含まれます。ほかに、データ転送、分析エンジン、データカタログやガバナンスツールの利用料も、ここに入ります。
生データを蓄積するだけなら、ストレージ費用は月額数万円から始まるケースも多く、DWHと比べるとコスト面の利点があります。一方、分析にはAmazon AthenaやGoogle BigQueryなど別の分析エンジンが必要です。そのため、データレイクでは「溜めるコスト」と「使うコスト」を分けて見積もります。
保守・運用では、データソースの追加、メタデータ整備、ゾーン構成の見直しといった作業が続きます。さらに、アクセス権限やガバナンスの運用、障害対応も、リリース後に発生する作業です。
保守・運用費は、一般に初期開発費の5〜15%程度が月額の目安とされます。たとえば、初期構築に1,000万円かかった場合は、月額50万〜150万円程度になります。ただし、金額は規模や活用の深さで変わるため、この数字は幅のあるレンジとして捉えるのが適切です。
データレイクは、使い続けて育てる基盤です。持続的に活用するには、リリース後の費用も初期構築費と合わせて予算に組み込む必要があります。
「溜めるコスト」と「使うコスト」の分け方
データレイクでは、蓄積と分析が一体のDWHとは異なり、費用が2種類に分かれます。
- 溜めるコスト:データの保存にかかる費用で、主にクラウドストレージの容量課金です。
- 使うコスト:分析エンジンでクエリを実行するたびに発生します。
溜める費用の面では、Amazon S3のライフサイクル管理が役立ちます。低頻度で古いデータを安価な階層へ自動で移すため、大量に蓄積しても費用を抑えられます。
使う費用の面では、従量課金型の分析エンジンは、クエリがスキャンしたデータ量に応じて課金されます。大量のデータを頻繁に、または非効率にスキャンすると、分析費用がストレージ費を上回ることがあります。
設計段階からストレージ単価と分析費をあわせて見積もり、溜める費用と使う費用の両方を管理します。溜める費用を抑えつつ、使う費用も制御します。この視点がコスト管理の出発点です。この構造を把握しておくと、どちらを優先して抑えるかを決める材料になります。
規模別のランニングコストの目安
規模によって、システム維持費と必要な運用体制の目安は異なります。
- 小規模:データソースが1つで分析も限定的な場合、システム維持費は月額数万円〜十数万円程度です。
- 中規模:複数のデータソースを扱い、ゾーン設計を含む場合、システム維持費は月額十数万円〜数十万円です。
- 大規模:全社基盤やAI前処理を含む場合、システム維持費は月額数十万円〜数百万円です。
小規模ではストレージ費が安く、分析も限られるため、低コストの利点を得られます。中規模になると、保守・運用費として初期開発費の5〜15%が加わり、月額数十万円規模になります。分析エンジンの利用が増えるほど、クエリ課金も積み上がります。
大規模では、カタログやガバナンスツール、専任人材を含めると、月額50万〜200万円以上になる場合もあります。費用幅を見積もる際は、データ量や分析頻度、活用の深さを先に見通しておきます。また、安く溜められるからといってデータを増やし続けると、ストレージ費と分析費の両方が膨らみます。
ランニングコストの費用構造の内訳
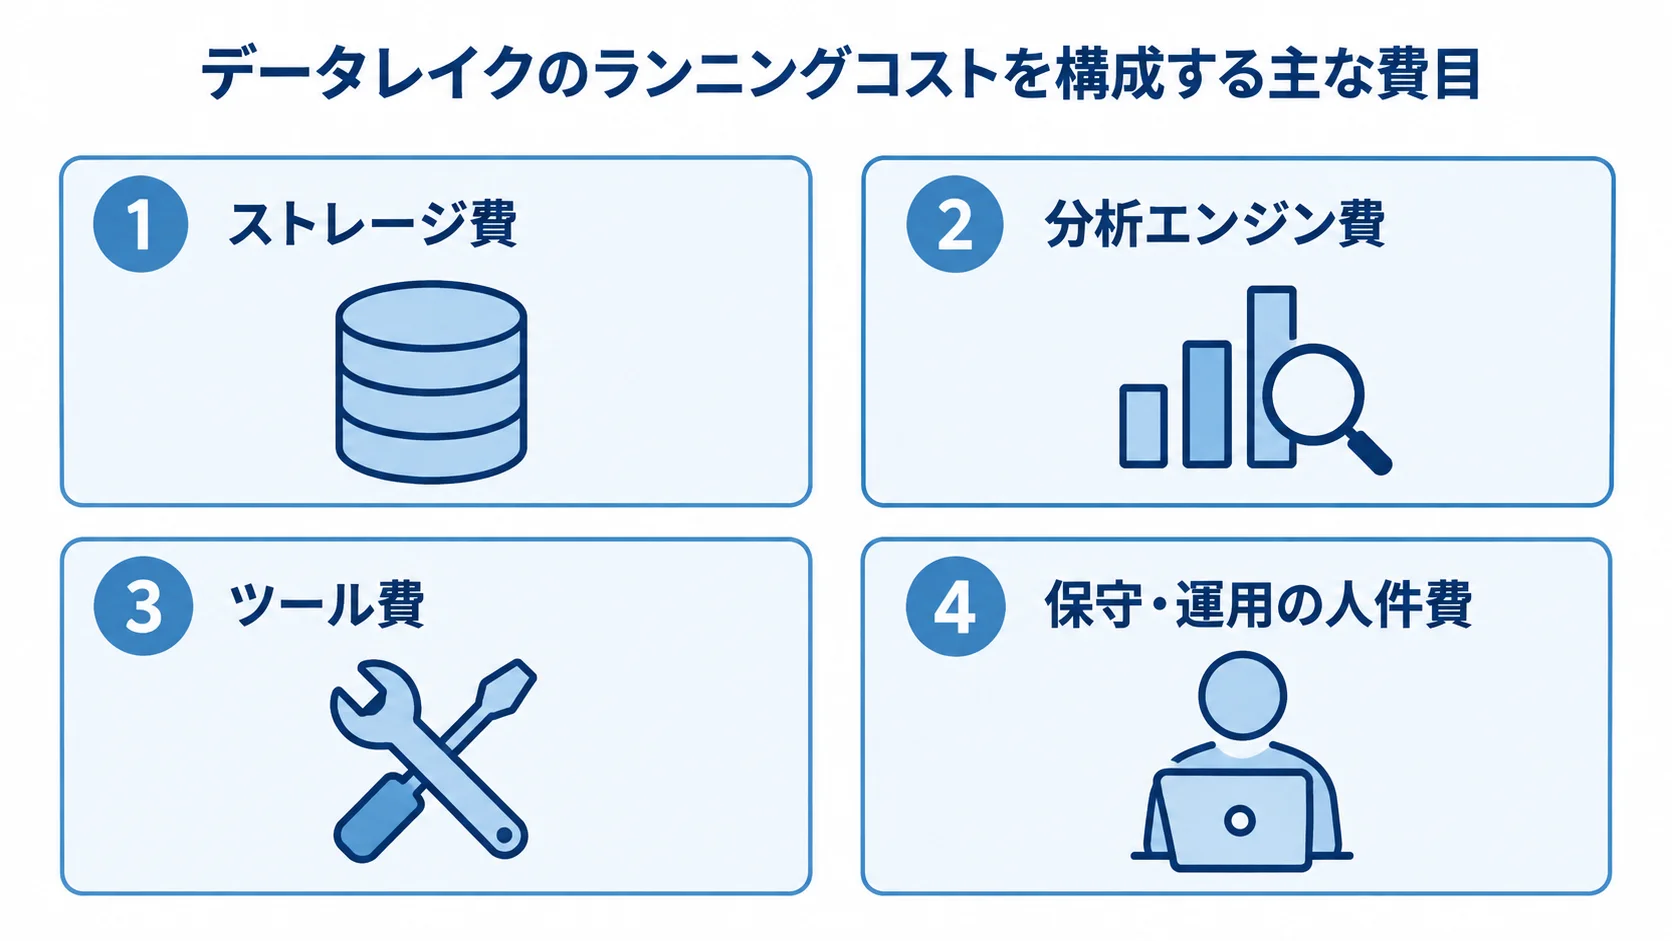
費用は、ストレージと分析エンジン、カタログ・ツール、保守・運用の人件費に分けて捉えられます。費目ごとの増減要因を押さえておくと、どこを見直せばよいか、つまり最適化の打ち手が見えやすくなります。ストレージと分析エンジンが分かれているデータレイクでは、この費目の分け方がそのまま管理の単位になります。
ストレージ費・分析エンジン費・ツール費
見積もりでは、ストレージと分析エンジンを別々に見ます。データ転送や管理ツールの費用も、同じように分けて捉えます。
- ストレージ費:容量課金に加え、読み書きやAPIリクエストにも費用がかかります。
- 分析エンジン費:データの分析やクエリ実行に使うエンジンの利用料です。
- データ転送料:クラウド間やリージョン間でデータを移動するときに発生します。
- ツール費:カタログやメタデータ管理、品質監視、ガバナンス機能の利用料です。
ストレージの単価は安くても、生データの保持量が増えるほど費用は積み上がります。そのため、保持する期間と量を決めておくことが、この費用を左右します。また、アクセス頻度に応じてクラスを使い分け、古いデータを安価な階層へ自動で移す設定にすると、保存費を最適化できます。
Amazon AthenaやGoogle BigQueryのような従量課金型は、スキャンしたデータ量に応じて料金が決まります。非効率なクエリや大量データの頻繁な読み込みは、想定を超える請求につながります。
転送費を抑えるには、設計の段階からデータの移動そのものを減らす工夫が必要です。管理ツールは、データレイクを使える状態に保つ役割を担います。ただし、機能を増やすほど費用も増えます。
したがって、要件定義の段階で、データ量と分析頻度、必要な管理機能を見通して予算を立てておきます。
保守・運用の人件費(初期費の5〜15%)
リリース後も基盤を手入れし続けるため、保守・運用には人的なコストがかかります。
- データ管理:新しいデータの取り込み追加、カタログ整備、ゾーン構成の見直しを担います。
- 品質と接続:データ品質の確認やクレンジング、分析エンジンとの接続の保守です。
- 権限と統制:個人情報のマスキングや来歴管理を含め、ガバナンスを運用します。
月額の目安は初期開発費の5〜15%程度ですが、その幅は、取り込むデータの種類と量、活用の活発さで決まります。頻繁にデータを追加する組織ほど、上限に近づきやすくなります。
データを溜めるだけなら人手はかからない、と考えるのは誤解です。データを探せて信頼して使える状態を保つには、メタデータ管理とガバナンスが欠かせず、それが基盤の価値を左右します。
運用を怠ると、活用されないまま費用だけがかかる「データの墓場」になりかねません。予算には、基盤の保守に加えて、データを整理・カタログ化し、現場で使える状態を保つ工数も見込んでおきます。
データレイクならではのコストの特徴
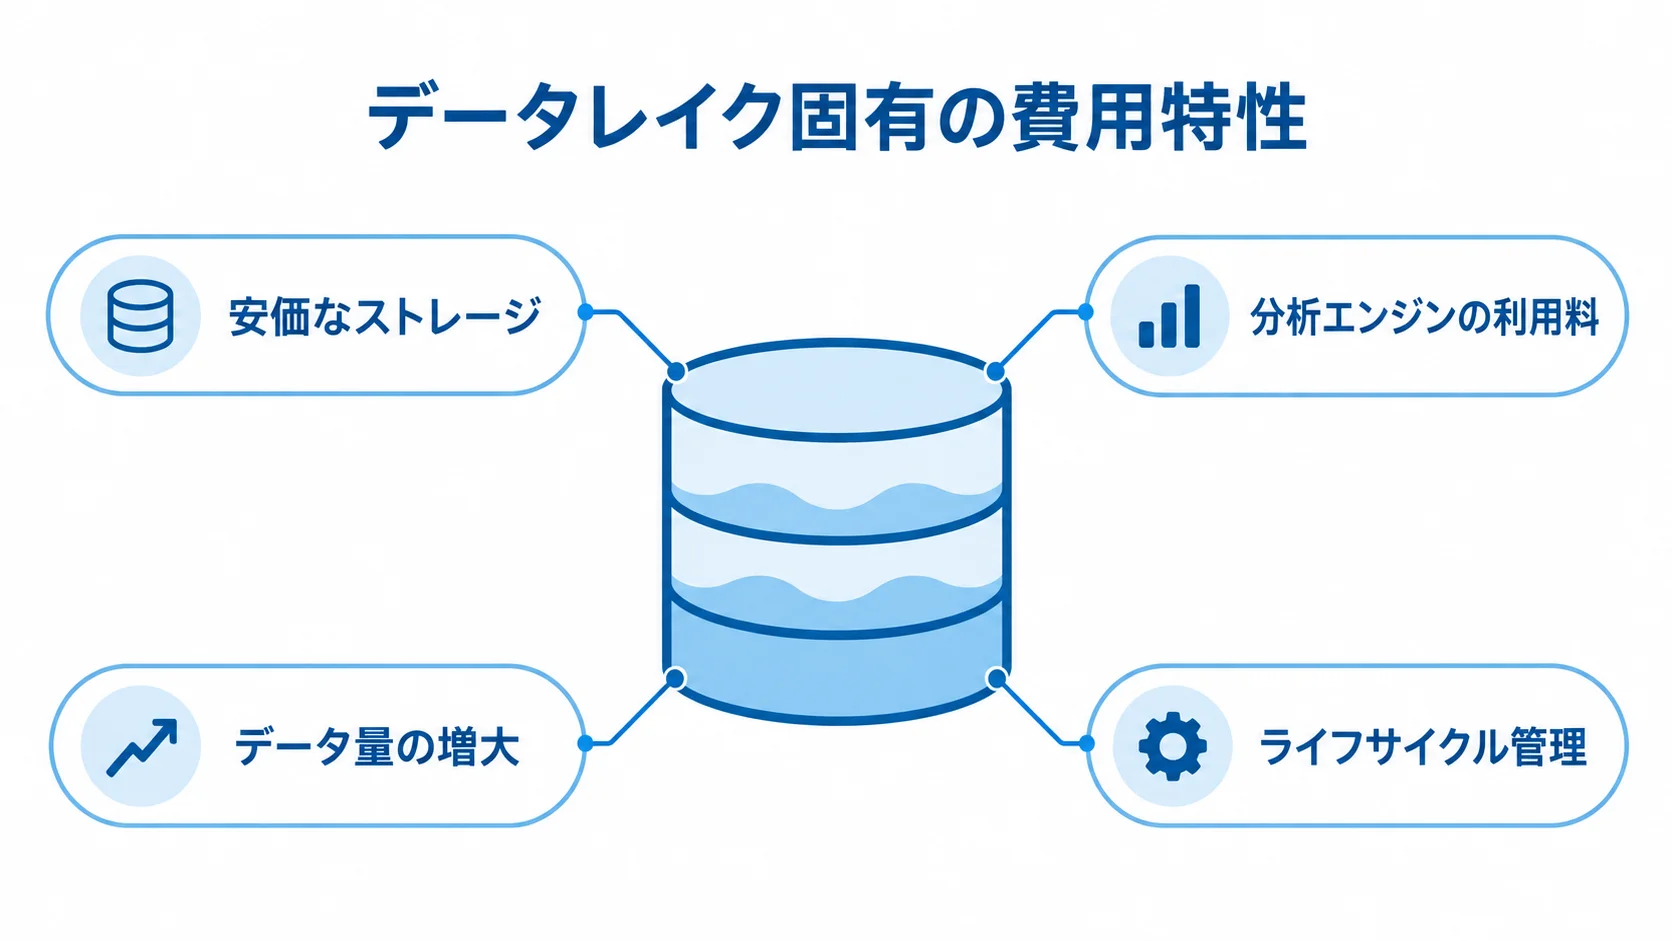
DWHやレイクハウスとは違う、データレイク固有の費用構造を理解しておくことが大切です。主な特徴は、ストレージが安くても分析に課金されることと、データ量が増えやすいことです。この2点を押さえることが、コストを健全に保つ鍵になります。
ストレージの安さと分析エンジンの課金
データレイクの費用は、安価なストレージと、別に必要になる分析エンジンの利用料に分かれます。
- 基盤の違い:DWHは蓄積と分析が一体で、レイクハウス(Databricksなど)は両者を一つに統合した基盤です。
- 分析方法:データレイクは蓄積の場所で、分析はAthenaやBigQueryなどを組み合わせて行います。
- 課金の仕組み:従量課金型では、クエリがスキャンしたデータ量に応じて費用がかかります。
- 膨張リスク:非効率なクエリや無制限の自動更新は、請求を押し上げます。
- 抑制策:Parquetのような列指向の保存形式、パーティション設計、費用監視、スキャン量の上限設定などが有効です。
ストレージが安くても、費用の中心は分析側になることがあります。分析は使うたびに費用が積み上がるため、利用が増えるほど請求額も大きくなります。
読み込む範囲を狭める工夫は、スキャン量そのものを減らすため、分析費の抑制に直結します。たとえば、日付やカテゴリでパーティションを分けておけば、必要な範囲だけを読めます。
運用の開始時点から費用を見ておけば、想定外の請求にも早く気づけます。スキャン量の上限を決め、ダッシュボードの自動更新頻度も業務上必要な範囲に抑えておくと、請求の膨らみを防げます。
データ量の増大とライフサイクル管理
データレイクは安く溜められるぶん、データ量が際限なく増えやすい基盤です。だからこそ、DWHとの違いを踏まえて、保持と削除のルールを決めておく必要があります。
- 蓄積の違い:DWHは整形済みのデータが中心ですが、データレイクは生データを何でも溜めやすい特徴があります。
- 増加による費用:使われないデータも残るため、テラバイト・ペタバイト級になると保存費とスキャン費が増えます。
- 階層化:Amazon S3などでは、よく使うデータを高速な標準階層に、古いデータを安価な階層に自動で移せます。
- 不要データの洗い出し:活用の見込みがないデータを削除するか、アーカイブします。
「溜めるのは簡単、捨てるのは難しい」状況では、使われないデータが残り続けがちです。そこで、取り込みから保持、アーカイブ、削除までの流れを設計の段階で決めておくと、データ増加に歯止めをかけられます。
ランニングコストが膨張する要因と抑制策
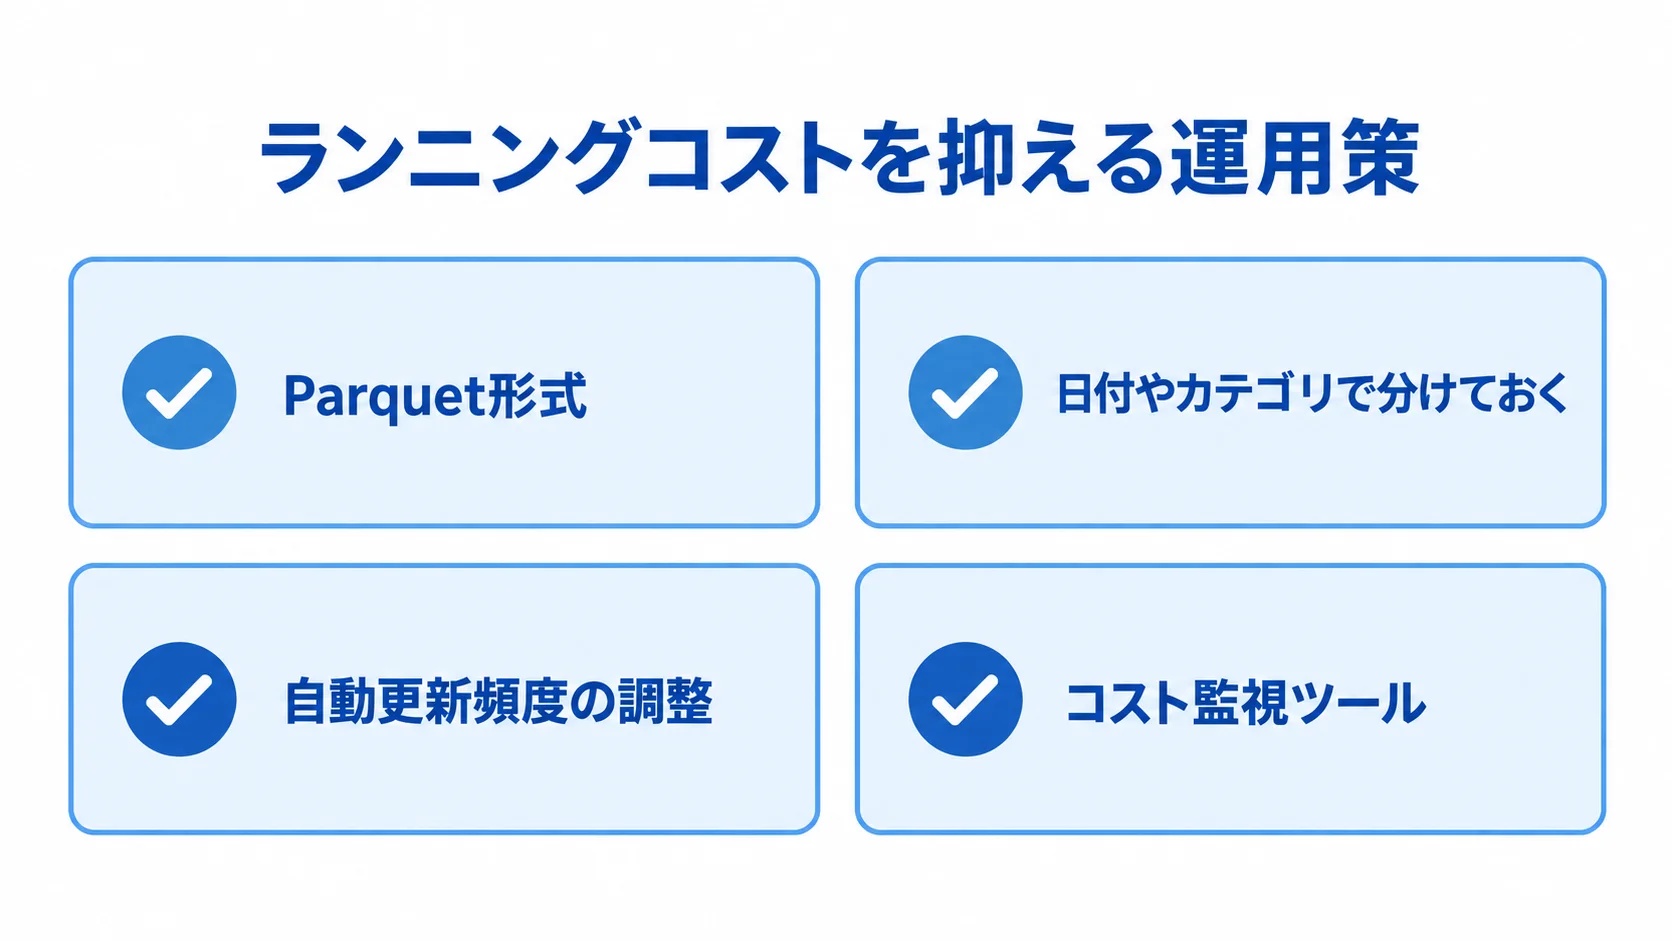
運用が始まってから、コストが想定より膨らむ背景には、非効率なクエリとデータの際限ない蓄積があります。いずれも、運用の開始時点で対策を組み込んでおくと効果的です。
非効率クエリと不要データの蓄積
主な膨張要因は、非効率な分析クエリと、活用されないデータの蓄積です。従量課金型エンジンで必要以上の範囲を繰り返し読むと、費用が増えます。本来は直近1か月分でよいのに、毎回データレイク全体を読むダッシュボードを多数の利用者が頻繁に開くと、費用が一気に跳ね上がります。
- 読み込みを減らす:Parquet形式で保存し、必要な列だけを読める状態にします。
- 範囲を絞る:日付やカテゴリで分けておき、必要な範囲だけをスキャンできるようにします。
- 更新を調整する:ダッシュボードの自動更新を、業務で必要な頻度に抑えます。
何でも溜められるという性質が裏目に出ると、使われないデータがストレージを圧迫し、分析時に読む範囲も広がります。低頻度のデータは安価な階層へ自動で移し、未使用のデータセットは定期的に洗い出して、アーカイブか削除を決めておきます。
クラウド事業者のコスト監視ツールを使うと、クエリやデータセットごとの費用が見えるようになります。異常時にアラートが出る設定にしておけば、想定外の請求を早く見つけられます。データレイクは、蓄積側と利用側の両方で費用が膨らむため、双方を見ておく必要があります。
データスワンプ化による見えないコスト
データスワンプ(データ沼)化も、見えにくいコストを膨らませる要因です。メタデータやカタログがないままデータを増やすと、どこに何があるか、そのデータを信頼してよいかが分からなくなります。
- 探索の手間:目的のデータを探すために、担当者の時間が取られます。
- 重複と誤分析:同じデータを重複して保存すると保存・分析費が無駄になり、信頼できないデータは誤分析や機会損失を招きます。
- 後からの整理:秩序を失った基盤を後から整理するには、追加の工数がかかります。
Amazon S3やExcel、DWHにデータが散らばり、基盤の外で手作業の統合が続くことがあります。高価な基盤を用意しても、現場でのExcel利用が変わらなければ、単なるデータ置き場になる場合もあります。
こうした手間を減らすには、取り込み時に内容や取得日時・場所をメタデータとして付けるルールを徹底します。品質やアクセス権限も同じように記録し、カタログから検索できる状態を保つことが欠かせません。
データレイクの費用は、利用料だけでなく、データの秩序を保てているかによっても変わります。そのため、整備と運用の費用もコスト設計に含めておきます。
運用体制と内製・外注の考え方
保守・運用の人件費はランニングコストの大きな部分を占めるため、内製にするか外注にするかで費用の性質が変わります。データレイク特有のガバナンス体制も検討しておく必要があります。
内製と外注のコスト構造の違い
内製と外注では、費用の種類も利点も異なります。自社に合う運用体制を、両方を比べて選ぶ必要があります。
- 内製の費用:エンジニアやアーキテクトの採用費・育成費と、固定の人件費です。
- 内製の利点と課題:長期的には理想とされ、活用が根付きやすい一方で、専門人材の採用は容易ではありません。
- 外注の費用と利点:開発パートナーと月額で契約し、専門人材を抱えずに必要な工数を確保する形です。
- 外注の課題:社内に知識が残りにくく、細かな改善のたびに依頼と調整が必要になります。
- 分担方法:保守は外部に任せ、企画や分析は社内で担う形です。段階的に内製へ移す進め方もあります。
内製では、クラウドストレージや分析エンジンの知識に加えて、取り込みやカタログの知識も求められます。
DWHに比べると、ストレージ運用の負荷は軽いものの、メタデータやガバナンスには継続的な手間がかかります。運用の担い手をどう確保するかが、費用水準を左右します。
ガバナンス運用の体制とTCOの視点
データレイクには多様なデータが集まるため、個人情報や機密情報が含まれることもあります。その管理体制がなければ、データスワンプ化に加えて、情報漏洩やコンプライアンス違反のリスクも生じます。
- アクセス制御:閲覧できる人や権限を管理します。
- 個人情報の保護:必要に応じて、個人情報をマスキングする仕組みです。
- 来歴管理:データの取得元と更新時期を追跡できる状態にします。
専用ツールを使えば作業は効率化できますが、ツール費に加えて、ルールを決めて運用する人件費がかかります。総保有コスト(TCO)で見るなら、目に見える利用料に運用の人件費を加え、さらにメタデータ管理や統制、データスワンプ化を防ぐための整備費も含めます。
ストレージの安さだけで選ぶと、体制が不足したときに見えない費用が膨らむことがあります。初期費、ストレージと分析の費用、統制の人件費を含めた月額の総額を、自社の体制に照らして見ておく必要があります。
導入前に現実的な運用予算を見積もり、それを支える体制が社内にあるかを確かめておくことが大切です。
まとめ
システム維持費は月額数万円から数百万円、保守・運用費は初期開発費の5〜15%程度が月額の目安です。
費用は、データ量、分析頻度、活用の深さで変動します。ストレージが安価でも、AthenaやBigQueryなどの分析エンジン利用料は別途発生します。
非効率なクエリやデータの増加に備えて、ライフサイクル管理と不要データの洗い出しを続けることが大切です。
列指向の保存形式や分割設計は、スキャン量を減らす点でコスト抑制に役立ちます。メタデータ管理と費用監視も、費用を抑える助けになります。
月額のTCOには、ストレージと分析の費用に加えて統制の運用人件費も含め、自社の体制に合わせて評価します。
▼全体ガイドの記事
・データレイク構築の完全ガイド
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。