
データレイク構築のPoCは、検証する範囲を1〜2件の活用テーマに絞り、成功基準を事前に決めたうえで、実データで確かめて本番導入の判断につなげる進め方です。
本番投資の前に小さく試し、技術と業務の両面で判断材料をそろえるための検証です。DWHやレイクハウスとの役割の違いも意識しつつ、関連記事もご覧ください。
▼全体ガイドの記事
・データレイク構築の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データレイク構築でPoCが重要な理由
データ活用では「溜めてみないと成果が読めない」という不確実性があるため、PoCが重要になります。たとえば、要件定義では問題がなくても、データ不足や品質不良、分析結果が意思決定に役立たないといった問題が後から見つかることがあります。
本格導入に数千万円を投じた後で問題が分かると、損失が大きくなります。そのため、PoCは本番投資の前に小さなコストでリスクを洗い出す実験です。
クラウドストレージは従量課金のため、少量のデータなら安価に試せます。その範囲なら、数十万円から数百万円、1〜3か月で、データ蓄積からカタログ付与、分析エンジンからの参照までを検証できます。
この一連の流れで、対象データをどの形で蓄積し、どの分析や意思決定、AI活用に役立てられるかを確かめたうえで、本番の投資を判断できます。
多様な生データを扱うデータレイクでは、前処理の難しさや分析できる状態にするまでの手間が、実作業で初めて分かることがあります。だからこそ、机上の検討だけで本番構築へ進まず、小さく試す工程を挟むことが成功確率を高めます。
PoCの目的は「技術検証」と「業務成果検証」の両輪
PoCで検証する目的は、技術的な実現性と業務上の成果を両輪で確かめることです。
- 技術的な実現性:取り込み、蓄積、分析エンジンからの参照の可否
- 業務上の成果:意思決定や業務改善、コスト削減、売上向上への寄与
- AI活用の可能性:将来のAI・機械学習の学習データとして使える品質
分析結果で現場が判断できるかも、あわせて確かめる必要があります。成功条件は、PoCの計画時に業務の言葉で定めておきます。
たとえば、Webアクセスログと購買データを集約して顧客行動を横断分析し、施策改善の示唆を得られる状態を目指します。溜めるだけの技術検証で終わらないよう、成功と言える条件を関係者で決めておくことが欠かせません。
PoC・プロトタイプ・モックアップの違い
データレイク構築では、PoC・プロトタイプ・モックアップを目的に応じて使い分けます。それぞれの違いを押さえると、検証の目的に合う手法を選びやすくなります。
- モックアップ:ダミーデータで完成イメージを示す見た目の試作
- プロトタイプ:限定した実データを取り込んで動かす試作
- PoC:技術と業務成果を確かめ、本番導入の投資を判断する検証
モックアップでは、ダッシュボードやデータカタログの画面イメージを作り、要件定義の初期に活用方法のゴールを合意します。これにより、関係者の認識のずれを防ぎます。
プロトタイプでは、単一のデータソースをクラウドストレージへ蓄積し、簡易なメタデータを付けて分析エンジンから参照します。取り込みの接続性やデータの見え方を確かめるためです。
段階的に進めるなら、まずモックアップでゴールを合意し、次にプロトタイプで取り込みと参照を試します。そのうえで、PoCの成功基準に照らして投資を判断します。
いずれも「小さく作って早く確かめる」という考え方が共通しています。安く速く試せるデータレイクは、こうした段階的な検証と相性がよい基盤です。
PoCのスコープ設計
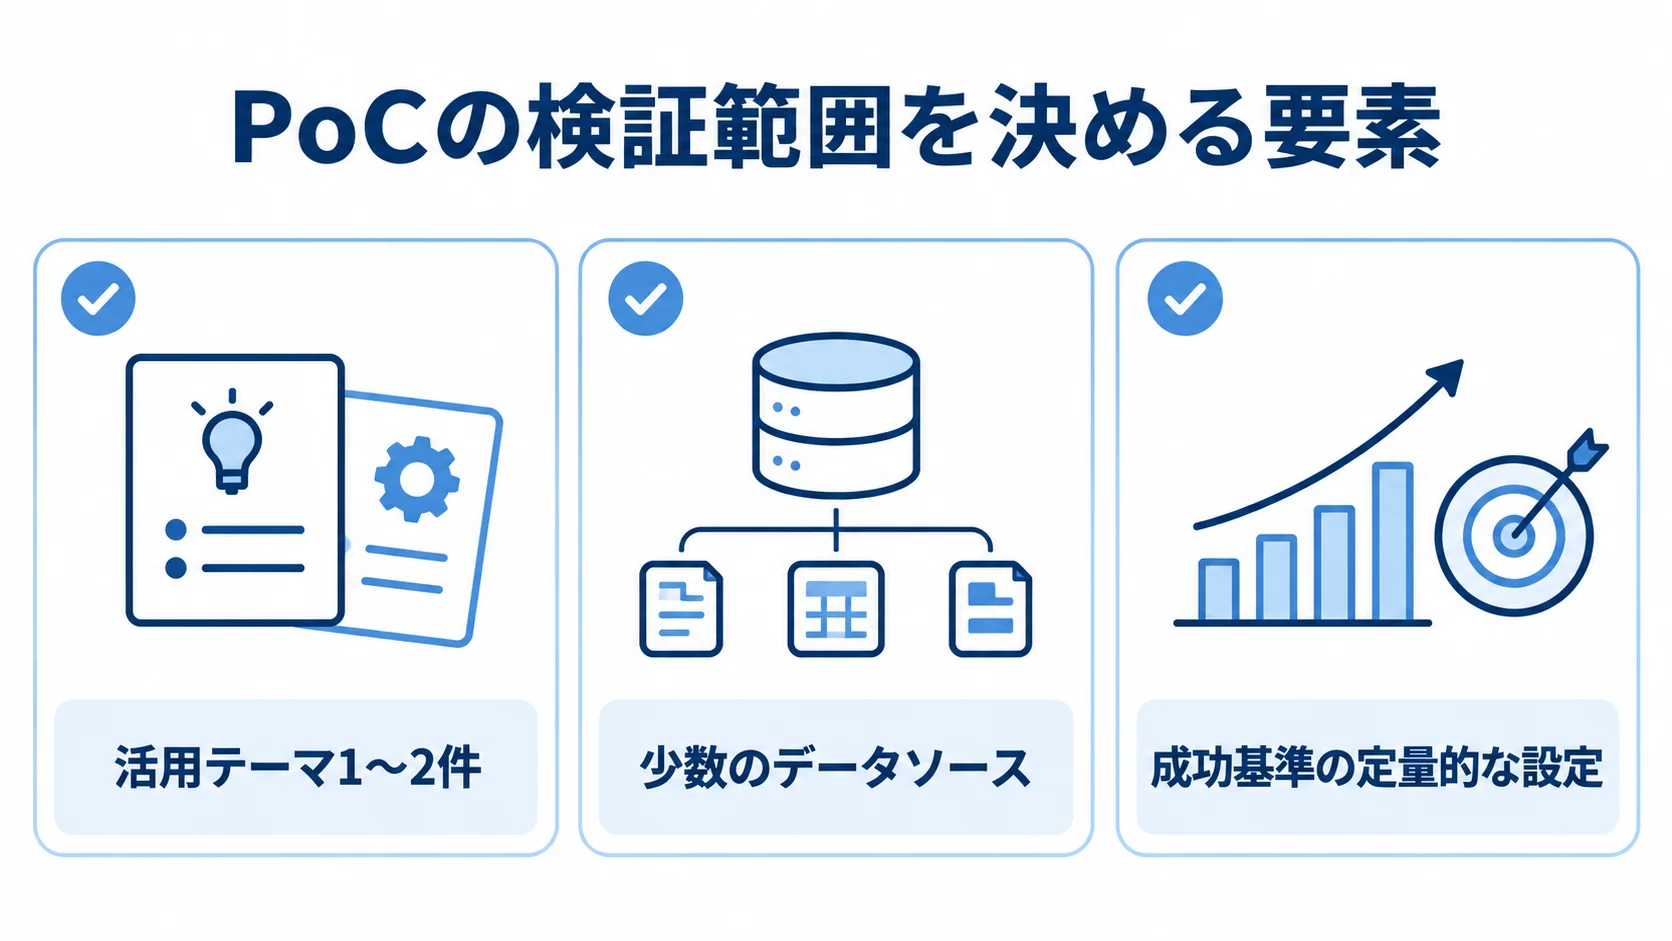
PoCの成否を左右するのは、検証範囲の設計です。範囲を広げすぎると結論が出ないまま、時間と費用が消えてしまうことが典型的な失敗です。
データレイクは多様なデータを蓄積できるぶん、PoCでも対象が広がりやすい特徴があります。そこで、範囲を絞る観点を2つ決めておきます。1つは活用テーマとデータソースの絞り込み、もう1つは成功基準の定量的な設定です。
1〜2の活用テーマと少数のデータソースへの絞り込み
検証する活用テーマは1〜2件に絞り、扱うデータソースも最小限にします。テーマを選ぶ際は、成果が出やすく、経営や現場への影響が大きいものを優先します。
- 顧客行動の分析:Webアクセスログと購買データの集約
- 異常検知AIへの活用:工場のセンサーデータの蓄積
全社のデータを一度に集めず、まず1つのデータ領域で価値を示すことを目指します。取り込み対象も多数のシステムへ広げず、単一または少数のデータソースから始めます。
対象を絞ると、工数を抑えられるだけでなく、取り込みパイプラインの複雑さも減らして短期間で動くものを作れます。そのため、「このデータ領域で、この分析ができれば成功」と判断しやすくなります。
一点突破の実績は、社内の理解と予算を得て、本番導入や取り込み対象の横展開を進める力になります。逆に、欲張って取り込みだけで力尽きると、活用成果を示せずに立ち消えるおそれがあります。
データレイクの自由度に流されず、あえて範囲を絞ることが、PoC成功のコツです。
成功基準の定量的な設定
スコープを決めるのと同時に、PoCを始める前に成功基準を定量的に定めます。基準が曖昧なままだと、検証後も感覚的な評価に流れ、本番の投資判断に進めないことがあります。
- 分析準備の短縮:手作業で3日かかる突き合わせを翌日に分析できる状態
- 準備工数の削減:月20時間の作業を5時間以下に抑える目標
- 予測モデルの試作:蓄積データによる精度80%以上の見込み
数値で基準を定めておけば、結果を客観的に評価できます。基準を満たせば本番へ進み、満たさなければ撤退か方針の見直しを判断できます。
成功基準は関係者全員で事前に合意しておきます。そうすれば、検証後に「思っていたのと違う」という認識のずれが起きにくくなります。
データレイクは、データを溜めること自体は容易です。そのため、成功基準には活用後の価値を定めます。技術検証だけで終わらないよう、明確な目標に向けて検証する意識を全員で共有します。
PoCで検証すべきポイント
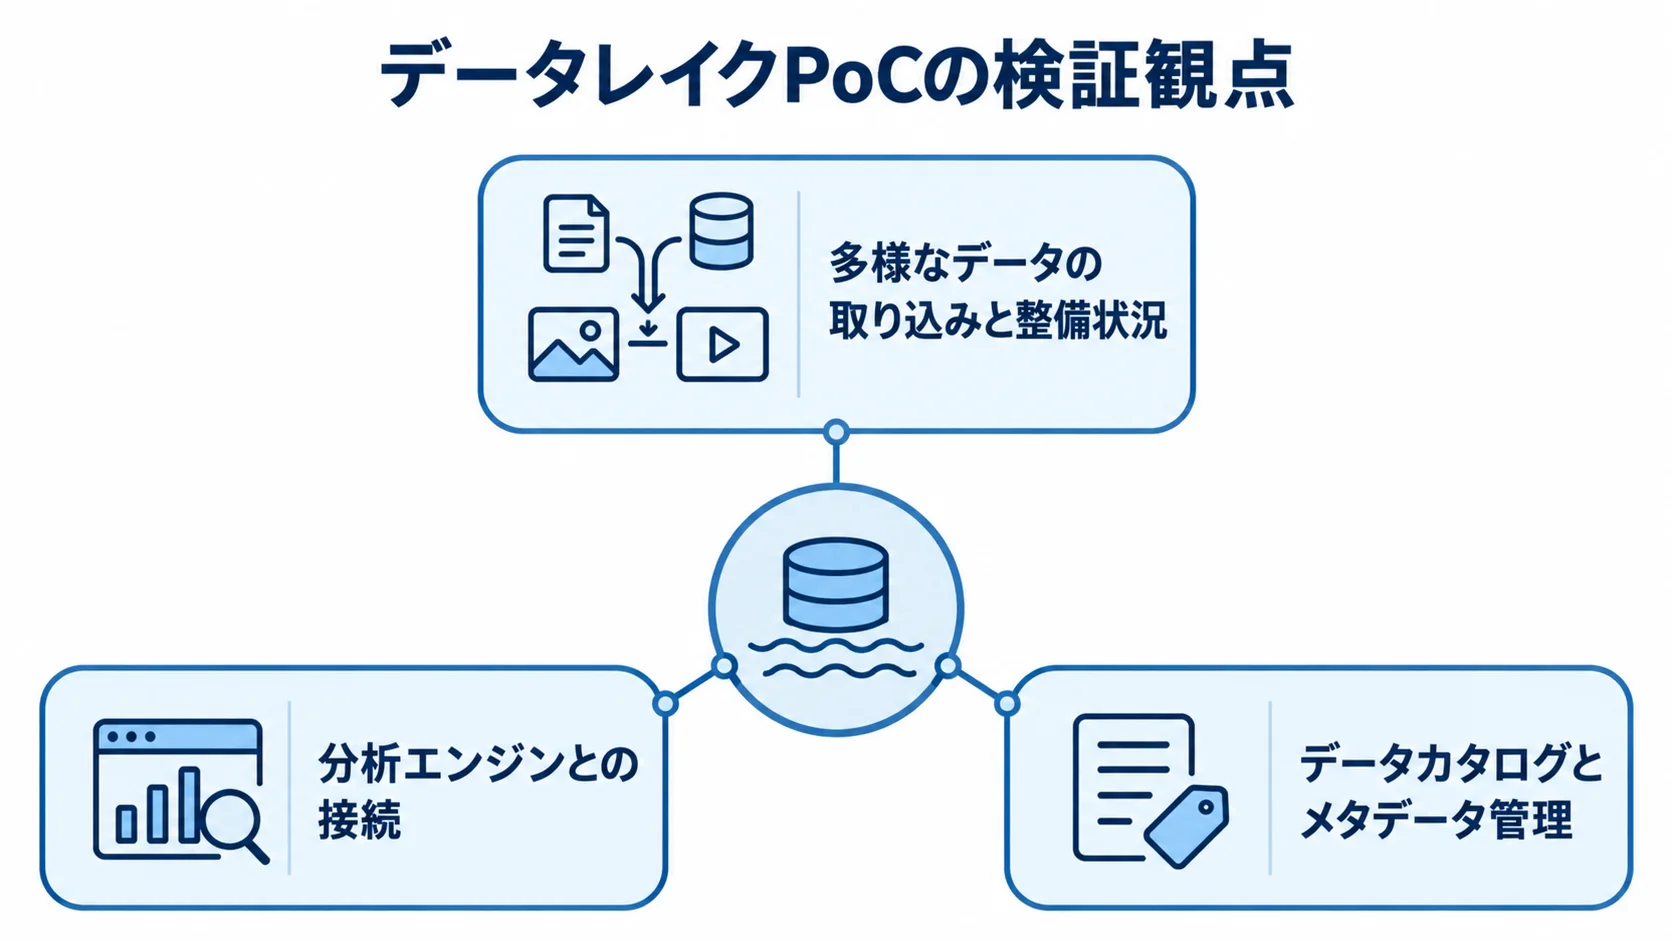
スコープと成功基準が決まったら、実データで確かめる項目を決めます。確かめる観点は、取り込みと整備、分析エンジンとの接続、活用を保つ仕組みです。いずれも、机上の検討だけでは見えにくく、実データで手を動かして初めて分かる論点です。
多様なデータの取り込みと整備状況
最初に重視するのは、多様なデータの取り込みと整備状況です。データ分析をすぐ始められるとは限らず、名寄せやクレンジングに半年かかる場合もあります。
データレイクは生データをそのまま蓄積できるため、取り込みは進めやすい一方で、活用の段階で品質問題が表面化しがちです。
- 取り込み可否:構造化・半構造化・非構造化データの扱い
- 品質の確認:表記ゆれ、重複、欠損の程度
- データ間の整合:更新時期のずれによる不整合の有無
取り込み対象の例には、JSONやログ、画像やPDFなども含まれます。実データをクラウドストレージへ取り込み、前処理の負荷を早期に把握します。
データがきれいに揃うという前提が崩れることは珍しくありません。本番投資の前に把握できること自体が、PoCの価値です。さらに、前処理の工数を見積もれれば、本番プロジェクトの期間と費用の精度を高められます。
データ整備は継続的な作業です。そのため、生データ(raw)ゾーンを保持しながら、品質を段階的に高めるゾーン設計と、継続的なクレンジング運用も検討します。
分析エンジン接続と「使える状態」の検証
2つ目の検証は、分析エンジンとの接続です。データレイクはストレージ層なので、蓄積したデータを分析するには分析エンジンが欠かせません。
PoCでは、Amazon AthenaやGoogle BigQueryとの組み合わせが自社の要件で機能するかを確かめます。
- 性能:想定データ量でのクエリの応答速度
- 形式:JSONやParquetなどの読み込み
- 分析コスト:従量課金で、実クエリの費用が想定内に収まるか
小規模でも実際に動かし、ストレージと分析エンジンの使い勝手を投資判断の前に確認します。カタログスペックだけでは分かりにくい点も、試せば見えてきます。
3つ目の検証は、見落とされがちなデータ活用の仕組み、つまりデータカタログとメタデータ管理です。場所も内容も分からず、信頼性も判断できないデータは、活用につながりません。
取り込んだデータにメタデータを付け、カタログで検索・発見できるようにします。そのうえで、現場の利用者に、必要なデータをすぐ探せるか、どんな意思決定に使えるかを試してもらいます。
取り込み、分析エンジン、カタログの3観点を小さな実験で偏りなく検証しておくと、本番導入後の定着につながります。
PoCの費用・期間の目安
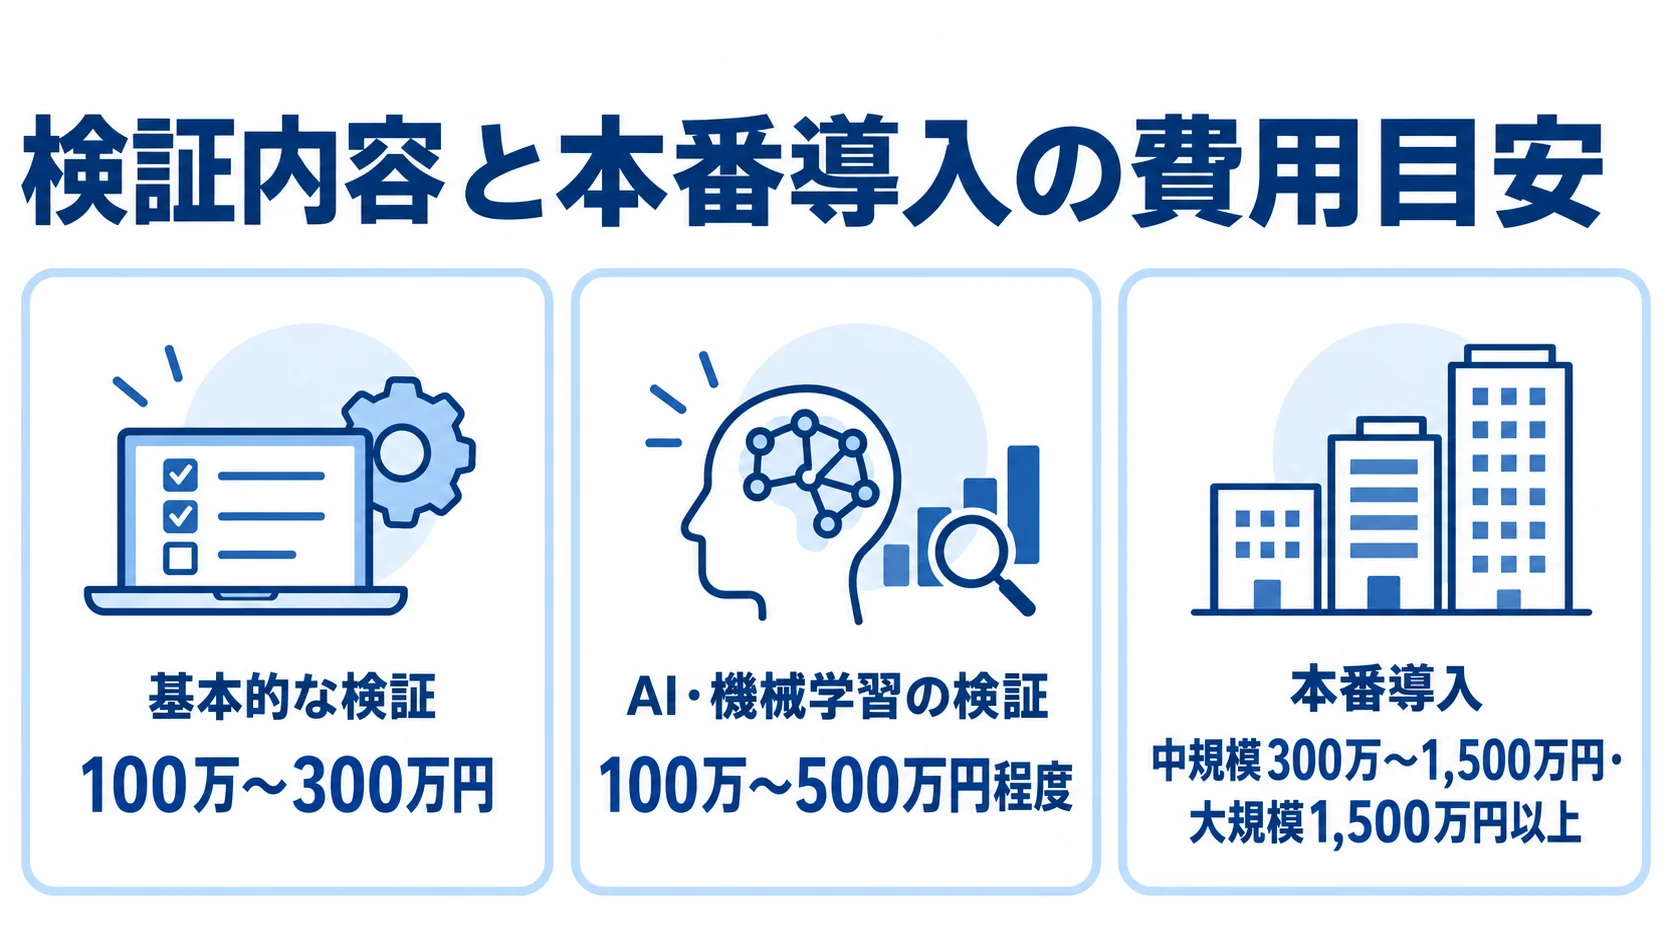
費用と期間は、検証範囲や選ぶクラウドによって変わります。そのため、示す金額や期間は一般的な目安です。また、クラウドストレージを活用すれば、インフラ費用も抑えられます。
PoCの費用相場と期間
検証範囲やモデル開発の有無によって、PoCの費用と期間、本番導入との差が変わります。
- 基本的な検証:単一または少数データソースと簡易カタログ、基本参照に絞る場合、100万〜300万円、1〜3か月が目安
- AI・機械学習の検証:需要予測や異常検知の試作は、モデル開発工数やGPU・API利用料が加わり、100万〜500万円程度、1〜3か月が目安
- 本番導入:中規模は300万〜1,500万円、大規模は1,500万円以上
基本的な検証を外部の開発パートナーに委託すれば、本番導入より小さな投資で、データ活用の可能性を確かめられます。PoCは、本番投資の失敗リスクを下げるための小規模な検証投資と考えます。
データレイクのPoCでは、クラウドストレージのインフラ費用が安いため、費用の大半を人的工数が占めます。その工数には、取り込みパイプラインの実装、カタログ整備、分析検証などが含まれます。
PoC費用は、本番とは別枠の検証投資として位置づけ、経営層の理解を得ておきます。本番費用と混同すると、検証だけで費用がかかったという不満につながる場合があります。大きな失敗を避けるための必要な投資だと、関係者の認識をそろえておくことが大切です。
スモールスタートによるPoCコストの抑制
従量課金のクラウドストレージを使い、少ないデータ量から始めれば、PoCのコストを抑えられます。環境は数分で立ち上がり、使った容量分だけ課金されます。
- ストレージ:短期間・少量の検証ならインフラ費用を小さくできる
- 検証後:環境を停止・削除すれば固定費を抑えられる
- 分析エンジン:AthenaやBigQueryなら実行クエリ分の支払いで済む
従量課金型の分析エンジンなら、常時稼働のサーバーを抱えずに検証できます。安く、速く、小さく試せる点は、データレイクの利点です。
データ量がまだ小さく、多様な形式を扱う必要が当面ない場合は、本格的なデータレイクを組まずに試す方法もあります。既存のクラウドストレージに数種類のデータを置き、分析エンジンから参照する形です。
この最小構成でデータ集約の成果を確かめてから、本番ではゾーン設計、カタログ、ガバナンスを備えたデータレイクへ発展させます。段階的に進めると、キャッシュアウトを抑えながら前進できます。
小さく試して成果を確かめてから投資を広げる進め方は、費用設計の面でも合っています。低コストで始められるため、段階的な検証を進めやすい基盤です。
「PoC死」を避けて本番導入へつなげる進め方
PoCに取り組むプロジェクトの一定数は、検証だけで終わり本番に進まない「PoC死」に陥ると言われます。
避けるための鍵は、期限を切ることと、本番への移行を最初から設計しておくことです。
3か月以内での結論判断
PoC死を避けるうえで最も効果的なのは、3か月以内に結論を出すよう期限を区切ることです。3か月以内に結論を出したケースは成功率が高い一方で、6か月を超えたケースは成功率が大きく下がる傾向にあるとされます。
- 期限を定める:3か月後に、事前の成功基準で本番移行か撤退かを判断
- 範囲を絞る:判断材料が不足する場合の検証対象の見直し
- 実データで試す:後半に本番に近い状態のデータを取り込む
検証が長引くと、目的が曖昧になり、関係者の熱量も下がります。特にデータレイクは対象データを広げやすいため、期限を守る規律が重要です。
期限は、必要な検証に集中して結論を出すために設けます。範囲が広すぎるか、成功基準が曖昧だと、期限内に結論が出にくくなります。
多様な生データでは想定外の問題が起きやすく、早めに確認しておかないと、後の手戻りが大きくなります。
PoCから本番導入への移行設計
PoCを始める時点で、成功した場合の次の行動まで含めた本番導入のロードマップを、粗くても描いておきます。検証が成功しても、その後の行動が決まっていなければ、本番へ進めない場合があります。
- 本番の対象範囲:広げるデータ領域と部門
- 基盤の規模と費用:本番に必要な規模と概算費用
- 体制と期間:ゾーン設計、カタログ、ガバナンスを含めた見通し
取り込みパイプラインやメタデータ、分析エンジンとの接続は、本番でも活かせるよう設計します。PoCで蓄積したデータを引き継げるよう、ストレージ構成やメタデータの付与ルールも本番を見据えて決めます。
段階的には、1つの活用テーマを検証するPoCから、そのテーマを本番運用するPhase 1へ進みます。Phase 2以降は対象を横展開し、全社データ基盤化やAI活用へ発展させます。
PoCを使い捨ての実験にせず、本番へ地続きにつなぐ設計が、投資を成果に変える決め手になります。
まとめ
データレイク構築のPoCやプロトタイプは、本格導入の前に技術的な実現性と業務成果を小さく検証する工程です。まずは活用テーマを1〜2件に絞り、データソースも少数に限ります。
成功基準は事前に定めます。たとえば、データ準備工数を月20時間から5時間へ減らす目標を置きます。
実データで確かめる項目は、取り込みと整備、分析エンジンとの接続、カタログで活用を保つ仕組みです。
費用は通常100万〜300万円で、AIを含む場合は最大500万円程度です。期間はいずれも1〜3か月が目安です。
従量課金と少量データからの開始により、インフラ費用を抑えられます。さらに、期限を3か月以内に定め、本番への移行を計画の段階から設計することが、PoC死を避けるうえで重要です。
データレイクは自由度が高く、検証範囲が広がりやすい基盤です。小さく試して成果を確かめ、本番へつなげる進め方が、大きな投資を成功に導く道筋になります。
▼全体ガイドの記事
・データレイク構築の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。