
データレイク構築は、要件定義・データ戦略策定、設計・環境構築、データ収集・テストの順に進めます。工程ごとの決定を次の工程へ引き継ぐと、手戻りを抑えやすくなります。
フェーズごとの作業内容、費用の目安、成功させるための条件を、順に見ていきます。
▼全体ガイドの記事
・データレイク構築の完全ガイド
データ基盤構築の工程ごとの進め方と注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データレイク構築の全体像
構築は、要件定義とデータ戦略の策定から始まります。その後、設計・環境構築、データ収集、テストを経て、運用へ進みます。
クラウド基盤とツールを選ぶ前に、データウェアハウスとの違いや対象データを明確にしておきます。
データレイクとは何か・特徴
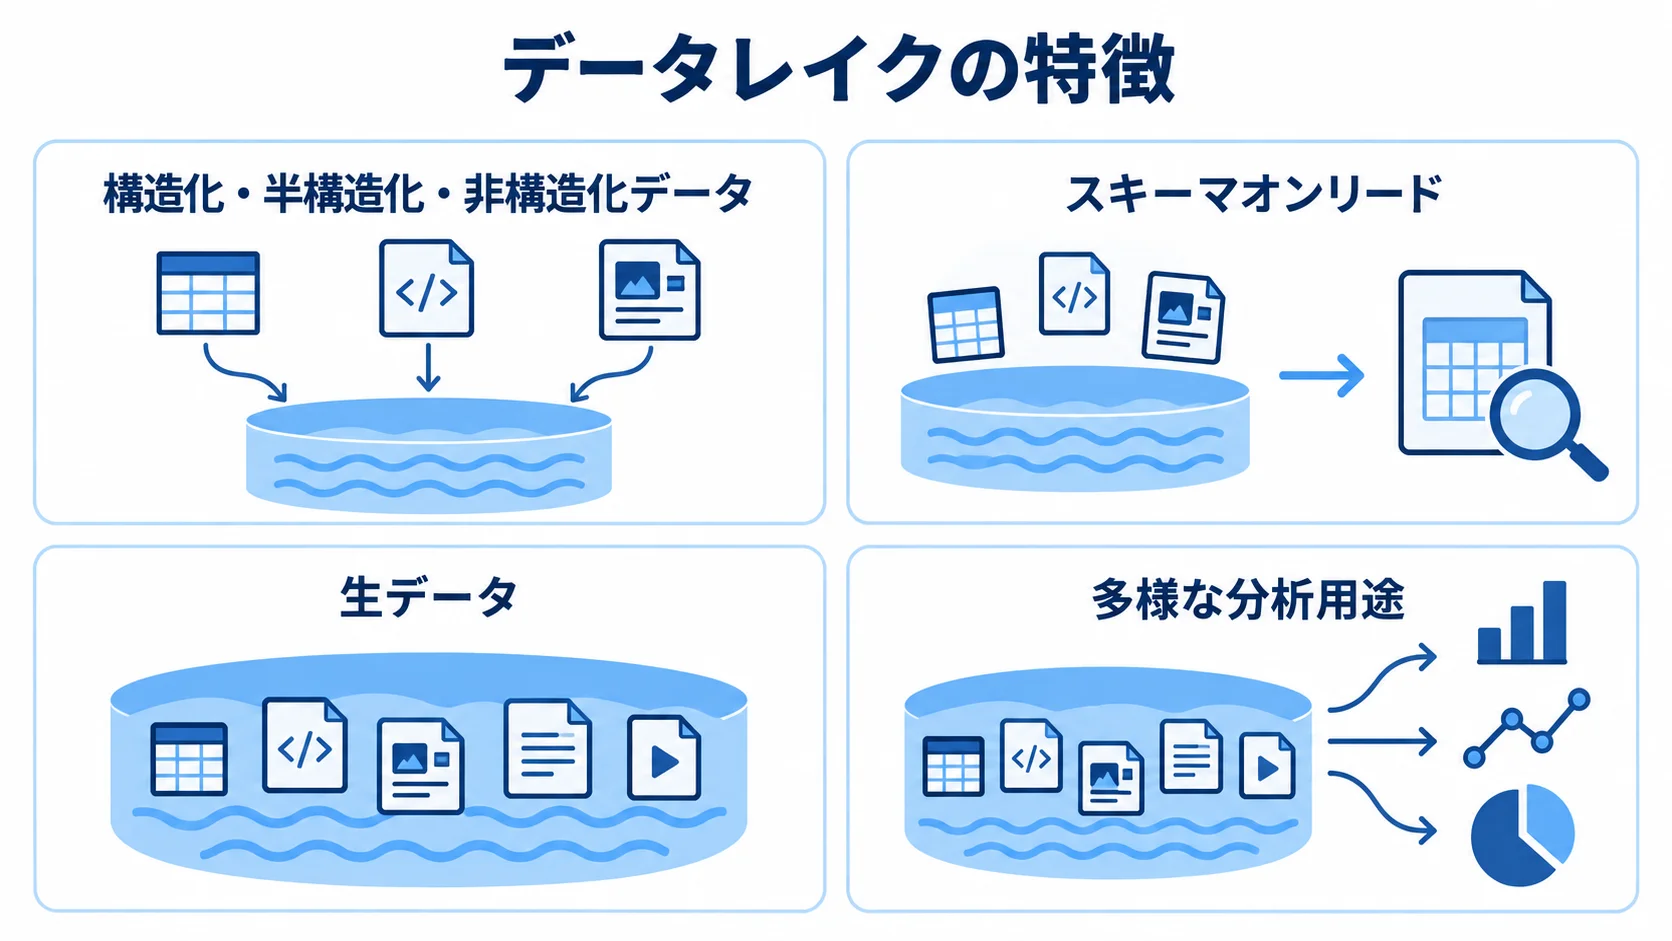
データレイクは、さまざまな形式のデータを原形のまま大規模に蓄積するストレージ基盤です。
- 形式を問わず保存:構造化・半構造化・非構造化データを扱えます。
- スキーマオンリード:蓄積したあとに、必要なときにスキーマを当てはめる方式です。
- 分析に柔軟:生データを残しておくので、後から用途に合わせて使えます。
リレーショナルデータベースと違い、保存する前にスキーマを定めなくて構いません。ログや画像・動画、センサー、テキストなど、用途がまだ決まっていないデータも保存できます。
データウェアハウス(DWH)は、事前に整形・構造化する「スキーマオンライト」を採用しています。一方、データレイクは生データを格納するため、後から多様な分析用途に対応できます。
データレイクが選ばれる理由
多くの企業がデータレイクを選ぶ最大の理由は、拡張性とコスト効率の高さです。
- 大容量に対応:ペタバイト規模の保存にも対応できます。
- 多様なデータを活用:非構造化データも保存して分析の対象にできます。
- 処理方式が広い:リアルタイム処理からバッチ処理まで組めます。
AWS S3、Azure Data Lake Storage、Google Cloud Storageなどのオブジェクトストレージは、低コストで保存できます。加えて、容量の上限を気にせずデータを蓄積できます。
また、機械学習・AIで使う画像や音声、テキストログも保存して活用できます。Apache SparkやApache Kafkaとも組み合わせやすく、幅広いデータパイプラインを作れます。
DXを進める企業にとって、データレイクは将来のデータ活用の幅を広げる基盤として、欠かせない存在になっています。
データレイク構築の進め方
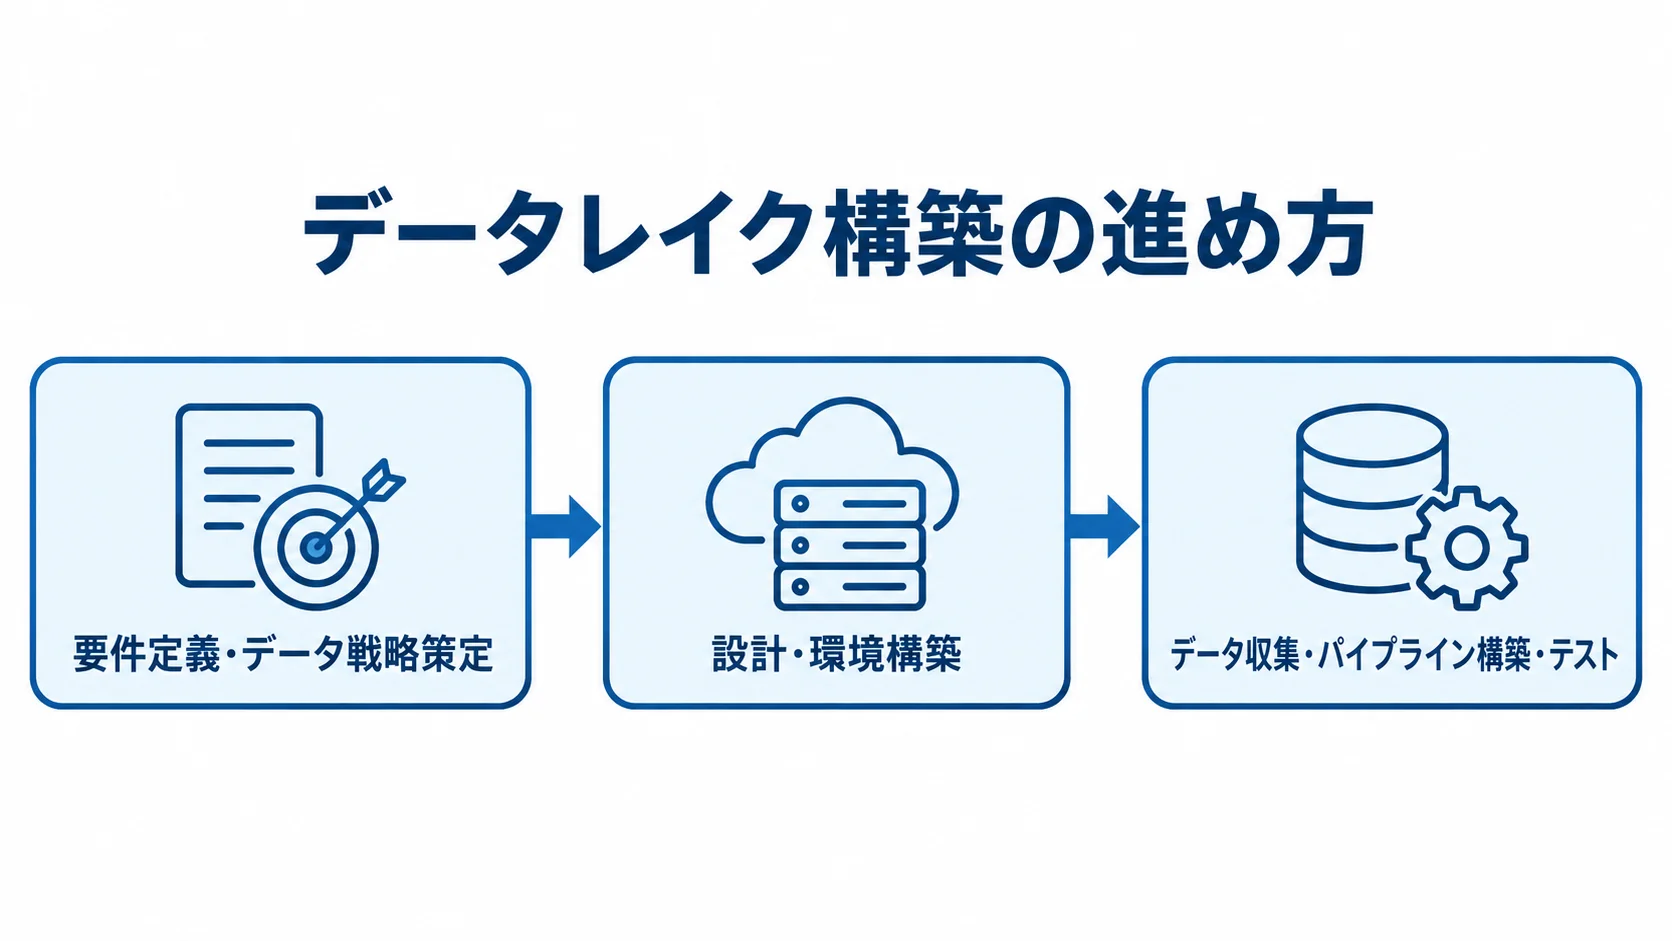
構築は、要件定義・戦略策定、設計・環境構築、データ収集・テストの3フェーズで進めます。各フェーズは、前のフェーズの結果を次のフェーズへつなぐ形で進みます。また、各フェーズの成果物をレビューしておくと、意思決定の精度が上がり、手戻りを抑えられます。
要件定義・データ戦略策定フェーズ
要件定義では、まずデータレイクで解決したいビジネス課題を整理します。
- データソース:蓄積の対象となるデータを洗い出します。
- 利用者と用途:誰が何の目的で使うかを決めます。
- 規模と更新頻度:想定するデータ量と、データを更新する頻度。
達成したい目標が曖昧なままだと、後工程で手戻りが起きやすくなります。そのため、ビジネス部門とIT部門が連携し、利用目的を含めて要件を固めることが欠かせません。
データ戦略では、AWS・Azure・GCPのどれを使うかを選びます。あわせて、Raw層・Curated層・Refined層などのゾーニングも決めます。
データカタログとアクセス制御の方針は、この段階で決めておきます。既存のDWHやBIツールとの連携も検討します。
このフェーズは通常4〜8週間で、要件定義書、データソース一覧、データフロー概念図を作成します。
クラウド選定の根拠も、成果物に含めます。要件定義の品質は後続工程の生産性を左右するため、要件定義には十分な時間を確保します。
設計・環境構築フェーズ
設計では、要件定義で決めた方針に沿って、詳細なアーキテクチャを作成します。
- 基盤設計:ストレージの構造、データ形式、ネットワークを決めます。
- 保護設計:IAM、アクセス制御、暗号化、監査ログの方針。
- ゾーニング:データの加工段階ごとに領域を分けます。
ストレージ構造では、バケット設計とディレクトリ設計を行います。データ形式は、Parquet・ORC・Avroなどから選ぶ必要があります。ネットワークでは、VPC・サブネット・セキュリティグループを設計します。
データレイクは一般に3層構造です。Bronze層(Raw層)は生データを保存し、Silver層(Curated層)はクレンジングや標準化を済ませたデータを置きます。Gold層(Refined層)は分析用途に合わせて整えた領域で、この3層構造は広く採用されています。
環境構築では、設計に沿ってクラウド環境を用意します。その際、Terraform、AWS CloudFormation、Azure BicepなどのIaC(Infrastructure as Code)ツールを活用できます。IaCを使えば、再現性が高く管理しやすい環境を効率よく構築できます。
AWS環境では、S3バケット、IAMロール・ポリシー、Glueデータカタログ、EMRクラスターを設定します。Databricksでは、ワークスペース、クラスター、Unity Catalogを用意します。
環境構築フェーズは通常4〜8週間を要します。本番・ステージング・開発の各環境は分離して構築し、運用品質の維持につなげます。
データ収集・パイプライン構築・テストフェーズ
パイプライン構築では、各データソースからデータレイクへ取り込む処理(インジェスト)を実装します。
- バッチ処理:まとめて取り込むETL/ELTジョブを作成します。
- リアルタイム処理:ストリーミングの仕組みを作ります。
- 品質確認:不正データが下流へ流れない仕組み。
バッチ処理では、AWS Glue、Azure Data Factory、Google Cloud Composerなどを使えます。リアルタイム処理では、Apache Kafka、AWS Kinesis、Azure Event Hubsなどを使えます。
各データソースでは、型の整合性、NULL値の有無、重複の排除などを確認します。
テストでは、データの整合性、性能、セキュリティを多角的に検証します。特にデータ量が多い場合は、本番相当の量で性能を確かめておくと、稼働後の問題を事前に見つけやすくなります。
障害が起きたときに備えて、バックアップからの復元やパイプラインの再実行といった復旧手順も確かめておきます。
テストが終わったら、データソースを段階的に本番へ接続し、全パイプラインが動く状態でサービスインします。データ収集・テストフェーズは通常4〜8週間を見込みます。
データレイク構築の費用相場とコスト内訳
構築費は、規模や複雑さ、採用するクラウドサービスやツールによって変わります。
規模別の相場と費用の内訳を把握しておくと、現実的な予算を立てやすくなります。
規模別の費用目安
初期費用は、データエンジニアの人数やパイプラインの本数、対象部門の広がりによって変わります。
- 小規模:データエンジニア1〜2人、データソース数本程度の場合で、初期費用は100万〜500万円程度が目安です。構築は2〜3ヶ月と比較的短期間で可能です。
- 中規模:複数部門、10〜20本のパイプラインの規模で、500万〜2,000万円です。
- 大規模:全社横断の統合、100本以上のパイプライン、リアルタイム処理を含む場合は、1,000万〜5,000万円以上となることがあります。
小規模では、S3+GlueやAzure Data Lake Storage+Data Factoryの構成がよく採用されます。
ランニングコストは、クラウドサービス利用料、ライセンス費用、運用保守費用で構成されます。クラウドサービスの月額利用料は、規模によって幅があり、小規模で5万〜30万円、中規模で30万〜200万円、大規模で200万円以上になる場合があります。
DatabricksやSnowflakeなど高機能なプラットフォームでは、ライセンス費用も相応にかかります。そのため、初期費用だけでなく3〜5年間のTCO(総保有コスト)で評価することをおすすめします。また、社内のデータエンジニアの育成や教育にかかる費用も、見落としやすいコストです。
インフラ・ツール・開発費の内訳
構築費は、インフラ費用、ツール費用、開発費用に分けて考えます。
- インフラ費用:ストレージ、計算資源、ネットワーク転送が対象です。
- ツール費用:分析基盤やカタログ、BIなどの料金がかかります。
- 開発費用:外部委託する場合の設計・実装・テストの工数です。
たとえば、AWS S3のオブジェクトストレージ料金は$0.023/GB/月です。インフラ費には、EMRやSparkクラスターなどの計算資源に加えて、ネットワーク転送も含まれます。
データ量が増えるにつれて、インフラ費用も線形に増加します。そこで、アクセス頻度の低いデータはGlacierなどの低コストストレージへ移すと、費用を抑えられます。
ツール費には、Databricksのワークスペース料金が含まれ、規模によって月数十万〜数百万円かかります。Apache Airflowのマネージドサービス(MWAA等)も、費用の対象になります。カタログにはCollibra・Alation、BIツールにはTableau・Power BIなどがあり、それぞれ利用料がかかります。
外部委託の場合、データエンジニアの月額単価は、市場相場で80万〜150万円程度です。プロジェクト全体では、費用の50〜70%を開発費が占めるケースが多くあります。
コスト管理では、要件定義の精度を高めて手戻りを防ぐことが欠かせません。
データレイク構築を成功させるポイント
失敗の多くは、技術よりも設計方針の曖昧さやデータガバナンスの不足に起因します。そのため、データを集めても活用されない「データスワンプ(データ沼)」を防ぐ対策が必要です。
設計時の注意点
設計では、拡張性、計算資源、ライフサイクルの観点から考えます。
- 拡張性:データソースや分析ツールの追加に備えます。
- 計算資源:ストレージと処理基盤を分離した構成。
- ライフサイクル:利用頻度と保存要件に応じたデータの移動。
初期から大規模にする必要はありません。拡張しやすい設計にしておけば、データ量の増加や分析ツールの変更に対応でき、長期の運用コストを抑えられます。
ストレージと計算を分けておくと、S3+EMRのように処理量に合わせて計算資源を拡張・縮小できます。
年・月・日・時間単位のパーティション設計は、クエリ性能とストレージ費用に影響します。そのため、利用シナリオを踏まえて、パーティションを慎重に決めます。
すべてのデータを無期限に高コストのストレージへ置き続けるのは非効率です。そこで利用頻度に応じて移すライフサイクルポリシーを定め、法的な保存要件も考慮します。
例として、直近3ヶ月は高速層に置き、3ヶ月〜2年は低コスト層へ移します。それ以上古いデータは、長期アーカイブ層へ自動で移す方法が一般的です。
データの削除ポリシーは、個人情報保護法やGDPRなどの法令に従って設計します。削除の要求に備えて、対応の流れも事前に整えておきます。
データ品質とガバナンスのポイント
データスワンプを防ぐには、データガバナンスを確立することが欠かせません。
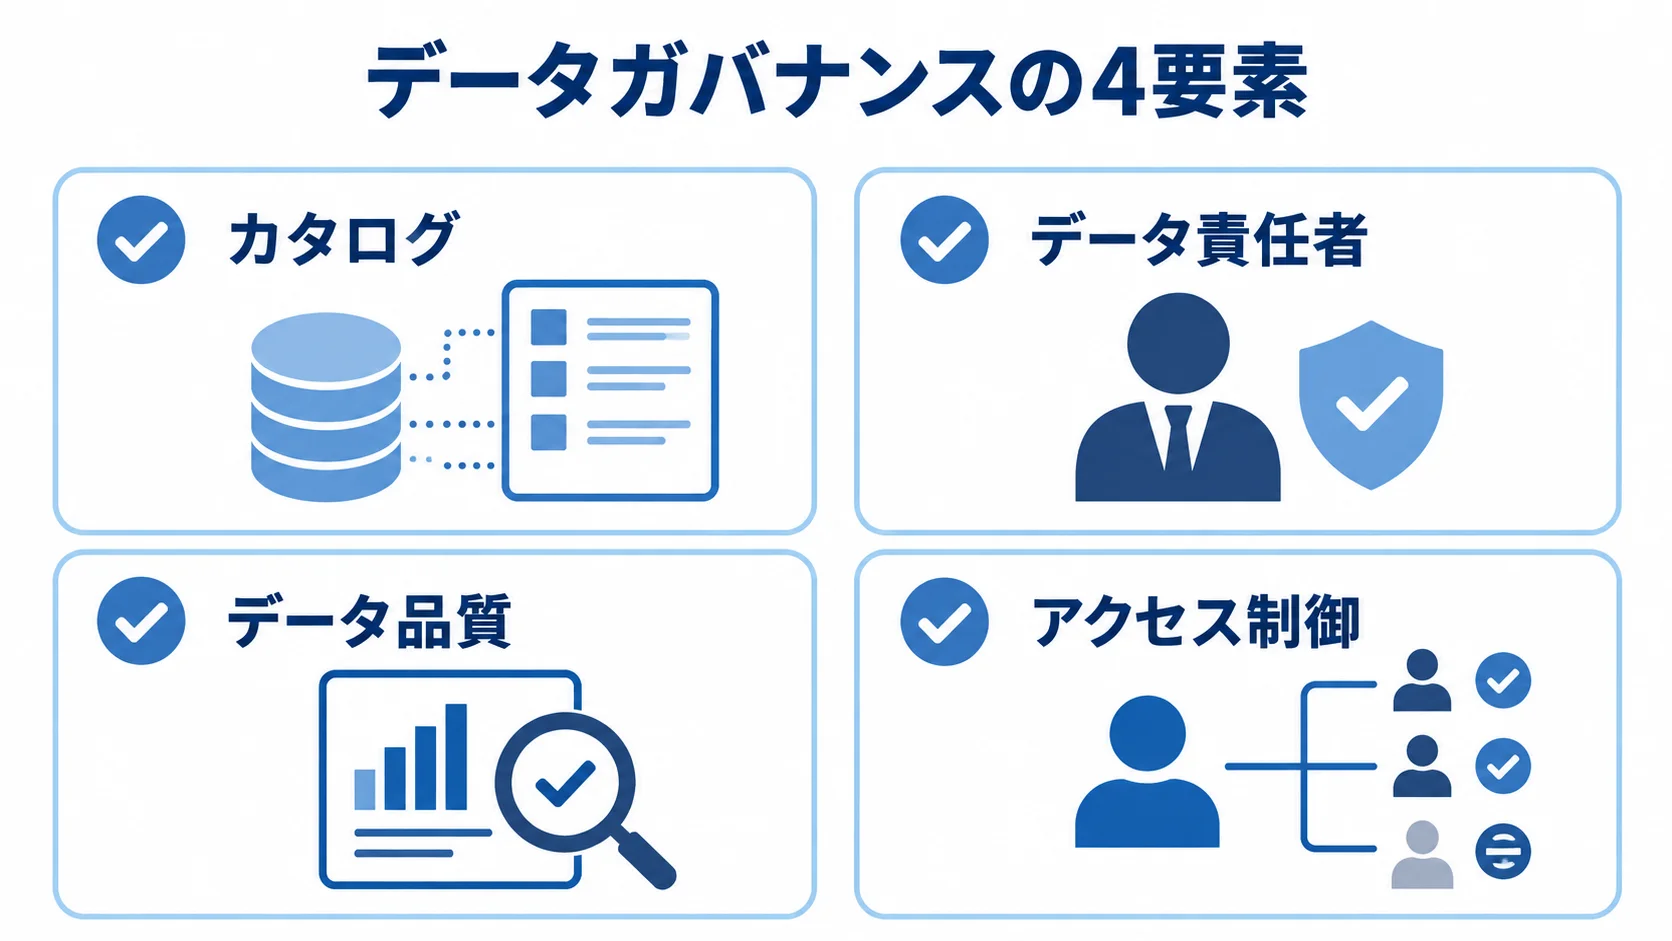
ガバナンスは、データの所在や管理者、品質基準を組織として管理する仕組みです。その要素は、データカタログ、オーナーシップ、品質ルール、アクセス制御の4つです。
- カタログ:データの所在をメタデータで管理します。
- データ責任者:各データの責任部門を決め、責任者を特定します。
- データ品質:完全性・正確性・一貫性の基準。
- アクセス制御:誰がどのデータを使えるかを決めておく仕組みです。
品質管理には、Great Expectations、dbt(data build tool)、AWS Deequ、Apache Griffinなどが使われます。
パイプラインの各ステージで、品質チェックを自動で実行します。基準から外れたデータを隔離・通知すれば、下流の分析や機械学習への悪影響を防げます。
データリネージは、データの発生源から加工、利用までの流れを追跡できる機能です。これを整えておくと、問題の原因や影響範囲を特定しやすくなります。Apache Atlas、OpenLineage、DataHubなどのリネージツールも、導入の候補になります。
パートナー選定のポイント
外部パートナーには、技術力と業務理解力の両方が求められます。システム構築だけでなく、データ活用の観点から相談できるかを確かめます。データ活用までコンサルティングできるパートナーは、より高い価値を提供できます。
- 技術経験:クラウドや主要ツールの実装実績を確かめます。
- 業務理解:データ活用まで相談できる力。
- 支援範囲:運用保守や内製化支援の有無。
AWS・Azure・GCPの認定資格を持つエンジニアが在籍しているかを確かめます。あわせて、Apache Spark、Kafka、Databricksの実装経験や、データエンジニアリング・ガバナンスの知見も見ておきます。
過去の類似プロジェクトの実績と事例は、必ず確かめておきます。近い業界での構築経験があれば、業界特有の要件やデータ特性を踏まえた提案が期待できます。その理解が、プロジェクトの品質向上につながります。
契約形態も選定の材料です。固定価格の請負と時間単価のコンサルティングを組み合わせられるものが理想です。
まとめ
データレイクは、構造化・非構造化データを蓄積し、機械学習・BI・リアルタイム分析に使う基盤です。データ活用の環境を整えると、DXの推進や競争力の強化につながります。
成功には、要件定義の精度、早期のガバナンス確立、適切なパートナーとの連携が欠かせません。
進め方・費用・成功の条件を踏まえ、自社の構築計画を立てましょう。初めての場合は、小規模なPoCから始めて段階的に拡張する方法もあります。
構築から運用まで一貫した支援を求める場合は、riplaにご相談ください。
▼全体ガイドの記事
・データレイク構築の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。