
データ統合基盤の構築は、3つのフェーズを順に進めると手戻りを抑えて品質を高められます。最初は現状分析と要件定義、次は設計とツール選定、最後は構築・データ連携・テストです。
基盤の全体像は、データ統合基盤構築の完全ガイドでも確認できます。各フェーズの作業、費用の目安、成功のポイントは、このあとの節で説明します。
▼全体ガイドの記事
・データ統合基盤構築の完全ガイド
データ基盤構築の工程ごとの進め方と注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データ統合基盤構築の全体像
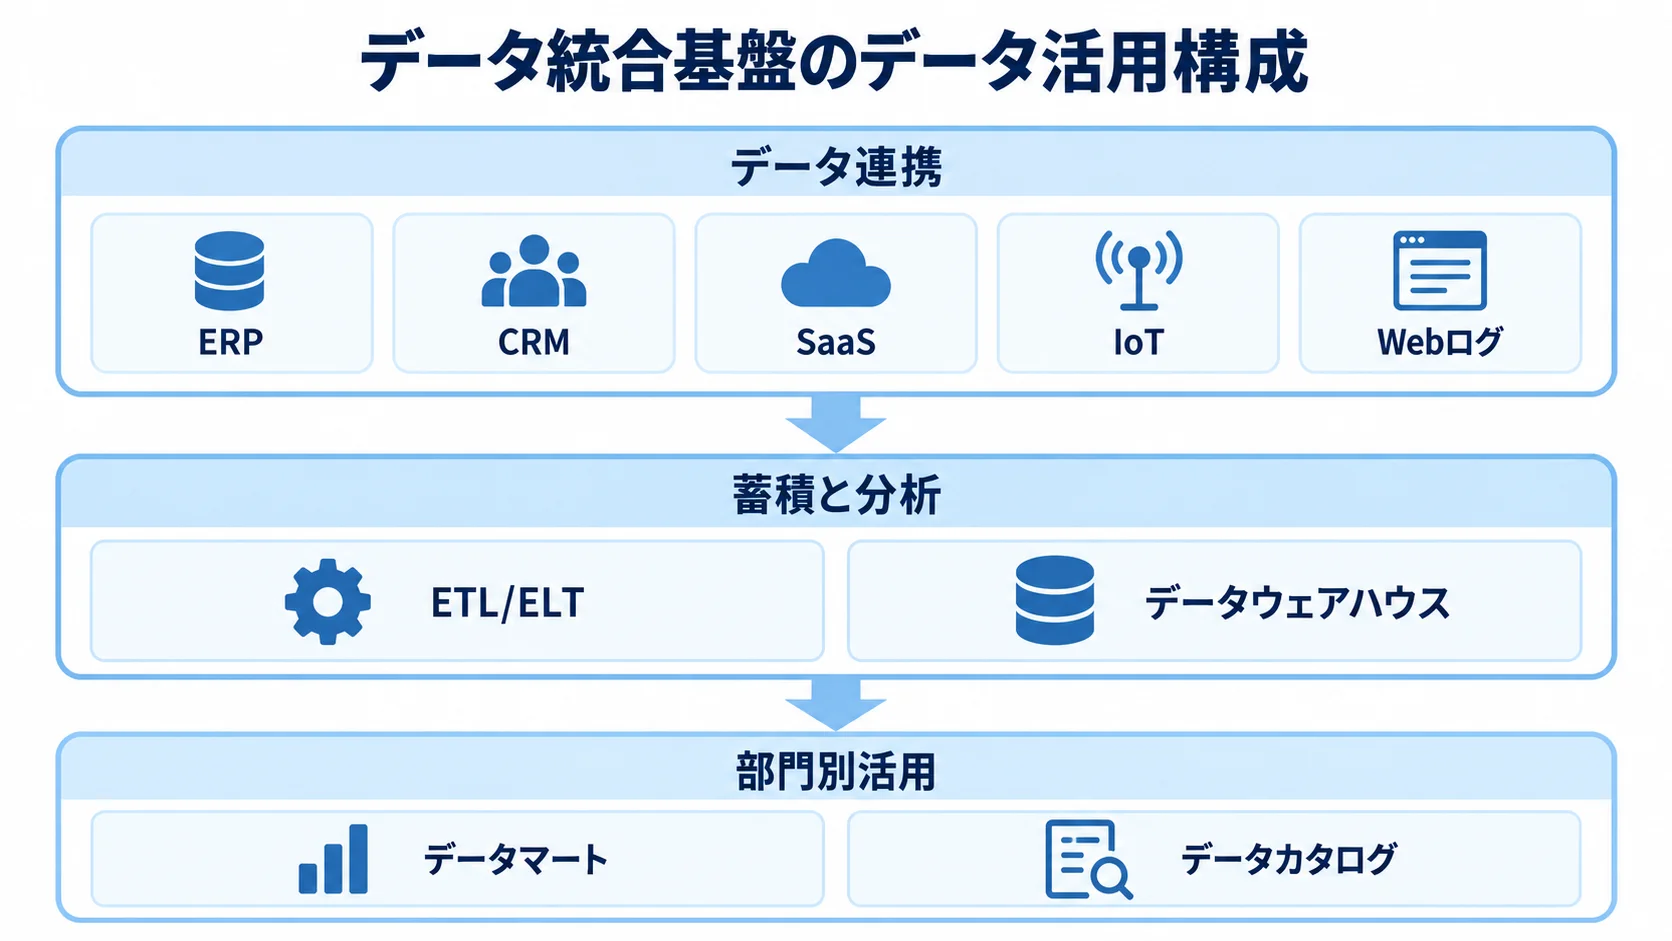
データ統合基盤は、社内外に散らばるデータを集めて変換・蓄積し、活用するシステム基盤です。ETL/ELTやデータウェアハウス、データマートなどのほか、データカタログも統合します。
基盤は、ビジネスインテリジェンスやAI・機械学習を支える土台になります。構築では、各フェーズの目的と、そこで作るものを決めながら進めます。
データ統合基盤とは何か・特徴
データ統合基盤は、企業の内外にある多様なデータをまとめて管理し、活用できる状態に整える技術基盤です。
- データ連携:ERP(基幹業務システム)、CRM(顧客管理システム)、SaaS、IoT、Webログなどから、データを集めます。
- 蓄積と分析:ETL(Extract・Transform・Load)またはELTで変換し、データウェアハウスに保存します。
- 部門別活用:データマートとデータカタログを組み合わせ、部門ごとの分析や、データの所在・品質の管理を支える仕組みです。
データウェアハウスには、Snowflake、BigQuery、Amazon Redshiftなどがあります。こうした要素が連携すると、全社のデータを一貫したルールで使えるようになります。
基盤は収集だけでなく、品質、ガバナンス、セキュリティまでを一体で管理します。たとえば、データリネージュで変換経路を追跡し、MDMで顧客・商品情報を統一します。また、アクセス権限も管理します。
バッチ処理に加えて、Apache Kafkaなどのリアルタイム処理も組み合わせると、即時性の高いデータ活用ができます。
データ統合基盤が必要とされる背景
デジタルトランスフォーメーション(DX)の進展により、データの量・種類・発生速度は急激に増大しています。
- 発生源の多様化:ERPのほか、CRM、MA、EC、IoT、SNS、コールセンターなどにもデータが発生します。
- データサイロ:独自の形式やストレージによって情報が孤立し、部門横断の活用が難しくなっています。
データが各システムに分かれているため、経営判断や業務効率化に必要なデータを横断して使いにくくなっています。
AI・機械学習では、高品質な学習データを大量に用意する必要があります。データが分散したままだと、集めて整えるだけで時間とコストがかかり、価値の実現も遅れます。
統合基盤は、必要なデータを必要な形で届けることで、「データの民主化」とデータドリブン経営を支えます。
2024年以降は、個人情報保護法の改正やGDPRなど、強まるプライバシー規制への対応も重要です。こうした背景から、データの所在と流れをまとめて管理できる統合基盤の必要性は、高まり続けています。
データ統合基盤構築の進め方
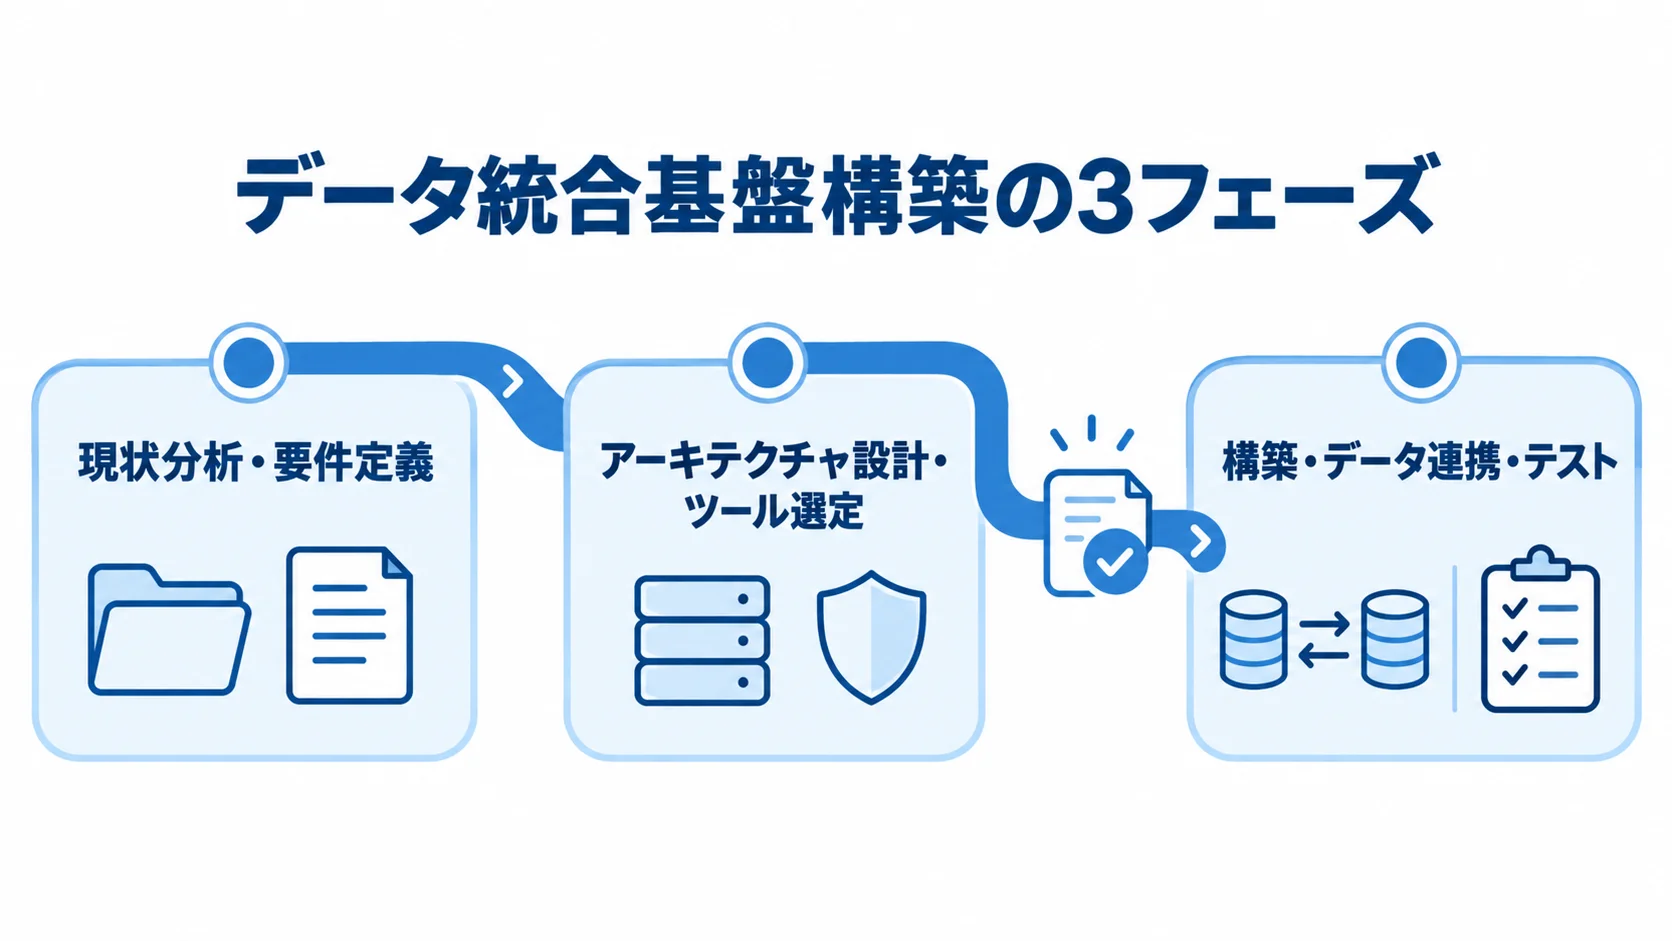
構築は3フェーズで進みます。最初は現状分析と要件定義、次は設計とツール選定、最後は構築・連携・テストです。
各段階の成果物と承認の流れをはっきりさせて段階的に進めると、手戻りを抑え、品質と効率を高められます。
現状分析・要件定義フェーズ
最初に、社内のデータ全体を調べて、データマップを作ります。
- データソース:各システムにあるデータの種類と所在を、一覧にまとめます。
- データ特性:発生頻度・量・形式を調べ、構造化・非構造化・半構造化に分類します。
- 連携状況:既存のETLバッチや、手作業によるCSV連携などを確認します。
業務部門へのヒアリングとIT部門のシステム調査を並行して進めます。現状把握が不足すると適切に設計できず、後工程で大きな手戻りにつながります。
要件定義では、ビジネス側のニーズとIT側の技術要件を分けて整理します。ビジネス要件では、部門の分析ニーズやリアルタイムで把握したいKPI、実現したい業務改善を明確にします。
技術要件では、データ量やソース数、更新頻度を定めます。加えて、保持期間、接続方式、性能・可用性(SLA)も決めておきます。また、セキュリティとコンプライアンスの条件も確認します。
要件定義書は、関係者全員でレビューして承認を得てから、次のフェーズへ進みます。
アーキテクチャ設計・ツール選定フェーズ
要件定義のあとは、基盤全体の構成と使うツールを決めます。
- データ構成:データレイク、データウェアハウス、データマートのそれぞれの役割を設計します。
- 連携と管理:ETL/ELTとデータカタログ、メタデータ管理、アクセス制御の方法を決めます。
- 配置方式:AWS・GCP・Azureのクラウド、オンプレミスとのハイブリッド、マルチクラウドから選びます。
各レイヤーに合うツールを選ぶ際には、既存環境との接続性やチームのスキルを確かめます。
オーケストレーションにはApache AirflowやPrefectがあり、ETL/ELTにはTalendやInformaticaがあります。また、AWS GlueやAzure Data Factoryなども、ETL/ELTの選択肢になります。
保存先はSnowflake、BigQuery、Amazon Redshiftなどです。データカタログはApache Atlas、Alation、DataHubなどから検討します。
ライセンス費用とベンダーサポートの品質も、総合評価に含めます。特にETLツールでは、コネクタの豊富さと変換の柔軟性が運用効率を左右します。
将来データ量が増えたり新しいデータソースが加わったりしても対応できるよう、拡張性を確保しておく必要があります。
構築・データ連携・テストフェーズ
構築では、設計書に沿って環境を用意し、データ処理を実装します。
- 環境構築:クラウド資源のプロビジョニング、ネットワーク、セキュリティグループを設定します。
- 実装:データウェアハウスのスキーマを作り、ETL/ELTパイプラインを組み上げます。
- 段階的な拡大:優先度の高いデータソースから検証を始め、対象を広げていきます。
段階的に進めるには、アジャイル開発の方法が効果的です。
各パイプラインを実装したら、ソースと連携先で件数と合計値を照合します。あわせて、NULL値と重複のチェックも必ず行い、データ品質を確認します。
テストは複数の観点から順に行い、本番移行の準備を整えます。
まず単体テストで個別のパイプラインを確認します。次に統合テストで、複数のパイプラインを組み合わせ、エンドツーエンドで検証します。
性能テストでは、大量のデータを処理する際の処理時間とリソース使用量を確認します。また、データ品質テストでは、業務ルールに照らしてデータの整合性を検証します。加えて、稼働後の監視体制も準備します。
ヒストリカルデータの初期ロードは、データが大量になるほど時間がかかります。そのため、初期ロードの計画と切り戻し手順を事前に詳しく決めておき、稼働後は実行状況、エラー、処理時間を監視します。
データ統合基盤構築の費用相場
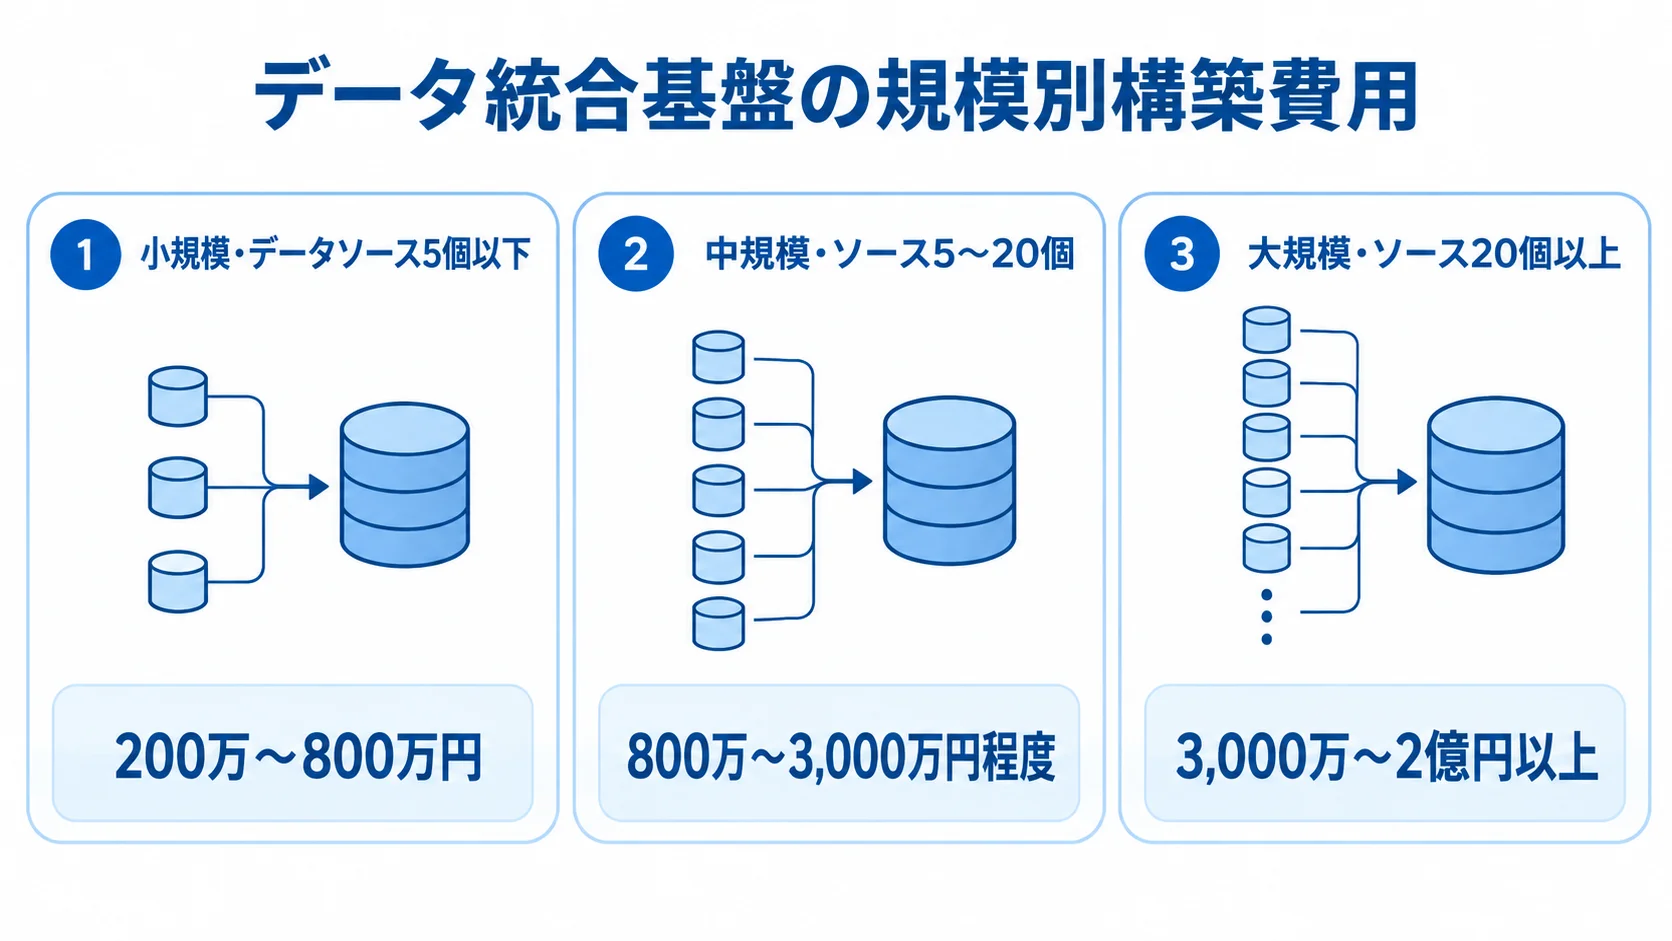
費用は、データソースの数や量、処理方式(バッチかリアルタイムか)によって大きく変わります。ツールやクラウドサービス、開発チームの構成も費用を左右します。そのため、投資対効果(ROI)を見ながら、規模に合った計画を立てます。
規模別の費用目安
規模ごとの構成と費用の目安を照らし合わせると、必要な投資を見積もれます。
- 小規模:データソース5個以下、クラウドSaaS中心、バッチ処理中心の構成で、200万〜800万円が目安です。
- 中規模:ソース5〜20個、複数のオンプレミスとクラウド、一部リアルタイム処理の組み合わせで、800万〜3,000万円程度です。
- 大規模:ソース20個以上、グループ全体の統合、ストリーミング処理の構成で、3,000万〜2億円以上になることがあります。
小規模では、AWS GlueやAzure Data Factoryなどと、Snowflakeの小規模プランを組み合わせられます。体制は2〜3名・3〜6ヶ月が目安で、人月単価は80万〜150万円程度です。
大規模では、Informaticaのエンタープライズライセンスが必要になることがあり、その費用は年間で数百万〜数千万円です。さらに、データアーキテクトを含む大規模なチームも、費用を押し上げます。
コスト内訳と注意点
費用の内訳と、構築後まで続く支出を分けて押さえておきます。
- ツール・ライセンス:オープンソース版は初期費用を抑えられる一方、企業版は年数百万円かかることがあります。
- インフラ・クラウド:AWS Glueは$0.44/DPU-hourで、処理データ量の増加に応じて費用も増えます。
- 開発・コンサルティング:この費用が全体コストの50〜70%を占めることが多いです。
オープンソース版の例には、TalendやPentahoがあります。また、AWS Glueのような従量課金の仕組みでは、事前に処理データ量を詳しく試算しておく必要があります。
構築後も、新規データソースの追加や要件変更に伴う改修、ツールの更新などで保守費用が続きます。年間の運用保守費用は、初期構築費用の15〜25%程度を見込みます。
過去データの初期ロードは、想定以上に工数と費用がかかることがあります。そのため、工数と費用は事前に確保しておくことが大切です。
データ統合基盤構築を成功させるポイント
成功のためには、技術設計に加えて、プロジェクト管理と関係者の合意形成が欠かせません。設計、ガバナンス・セキュリティ、パートナー選定は、それぞれ具体的に詰めていきます。
設計フェーズでの重要ポイント
将来の拡張性を設計に含めておくと、データの増加や変更にも対応できます。
- 拡張性:クラウドネイティブを前提に、データのレイヤーを疎結合に設計します。
- データモデル:インモン方式(エンタープライズDWH)とキンボール方式(データマート指向)のどちらかを選びます。
- 再実行性:冪等性を確保し、失敗後も同じ処理を安全にやり直せる状態を保ちます。
現時点の要件だけで構築すると、1〜2年後にデータソースや量の増加に対応できず、再構築が必要になることがあります。
データモデリングでは、長期的な活用に耐える構造を選ぶ必要があります。パイプラインの依存関係をはっきりさせ、Apache Airflowなどで見えるように管理すると、信頼性を高められます。
データガバナンスとセキュリティ
組織全体で基盤を使えるようにするには、構築と並行してガバナンスを整えます。
- 定義と責任:データ辞書に、各項目の定義と責任者を記載します。
- 品質と統一:MDMで顧客や商品のコードをそろえます。
- 流れの把握:データの発生から利用までを追跡し、どこで何が起きたかをいつでも追える状態にします。
データ品質のルールとして、NULL制約、値域チェック、参照整合性を定め、自動チェックを組み込みます。データガバナンスとは、定義・品質・アクセス権限・ライフサイクルを組織横断で扱う方針、プロセス、体制のことです。
セキュリティ面では、役割ベース(RBAC)で権限を細かく制御します。個人情報や機密情報は、保存時と転送時の両方で暗号化します。
GDPRや個人情報保護法に沿った扱いを定めたうえで、アクセスログは完全に記録し、監査します。また、テスト環境では、本番の個人情報を匿名化して、漏洩のリスクを抑えます。
セキュリティ要件は初期段階で定め、設計に組み込んでおきます。これは「セキュリティ・バイ・デザイン」と呼ばれ、標準とされるやり方です。
パートナー選定のポイント
外部パートナーに依頼する場合は、相手の力量によって成果が左右されます。実績、技術人材、事業理解、継続支援の4つの面から、候補を確かめます。
- 類似実績:同規模・同業種の経験と、課題を解決した具体的な成果を確認します。
- 技術人材:ETLやDWHの認定資格と、データエンジニアやアーキテクトの在籍状況を確認します。
- 事業理解:データ統合によるビジネス価値を、一緒に考えられるかどうかを確認します。
- 継続支援:運用保守・機能拡張の体制と、問題発生時の対応スピードや品質を確認します。
Snowflake、AWS、GCPなど、基盤に使うプラットフォームへの知見も、あわせて確かめます。また、ビジネスのニーズを基盤設計に反映するコンサルティング力も大切です。
発注側は、複数のベンダーからRFP(提案依頼書)に基づく提案を受け、技術、費用、サポートを比べます。
まとめ
データ統合基盤は、ERP・CRM・SaaS・IoTなどのデータを一つにまとめ、データドリブン化を支えます。現状分析から構築まで、3フェーズを一つずつ丁寧に進めます。最初は現状分析と要件定義、次は設計と選定、最後は構築・連携・テストです。
費用は規模によって大きく異なります。小規模で200万〜800万円、大規模では3,000万〜2億円以上になることがあります。
拡張性、ガバナンス、セキュリティを設計に含め、信頼できるパートナーと協働することが成功の鍵になります。
自社だけで進めるのが難しい場合は、専門知識を持つ開発会社に相談できます。コンサルティングから構築、運用まで一貫して依頼すると、リスクを抑えながら成果を目指せます。
この記事が、データ統合基盤構築の計画と推進に役立てば幸いです。
▼全体ガイドの記事
・データ統合基盤構築の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。