
DXでデータに基づく経営を進めるには、ERP・CRM・SaaS・IoT・Webログなどに散らばるデータを、一元的に統合・管理・活用できる基盤が欠かせません。
ETL/ELTで取り込み、データウェアハウスに集め、カタログとガバナンスで管理します。詳しくは下記の関連記事もご覧ください。
▼データ統合基盤構築に関する詳細記事
・データ統合基盤構築/開発の進め方/やり方/流れや方法/手法/工程/手順
・データ統合基盤構築でおすすめの開発会社/ベンダー6選と選び方
・データ統合基盤構築の見積相場や費用/コスト/値段について
・データ統合基盤構築の発注/外注/依頼/委託方法について
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データ統合基盤構築の進め方
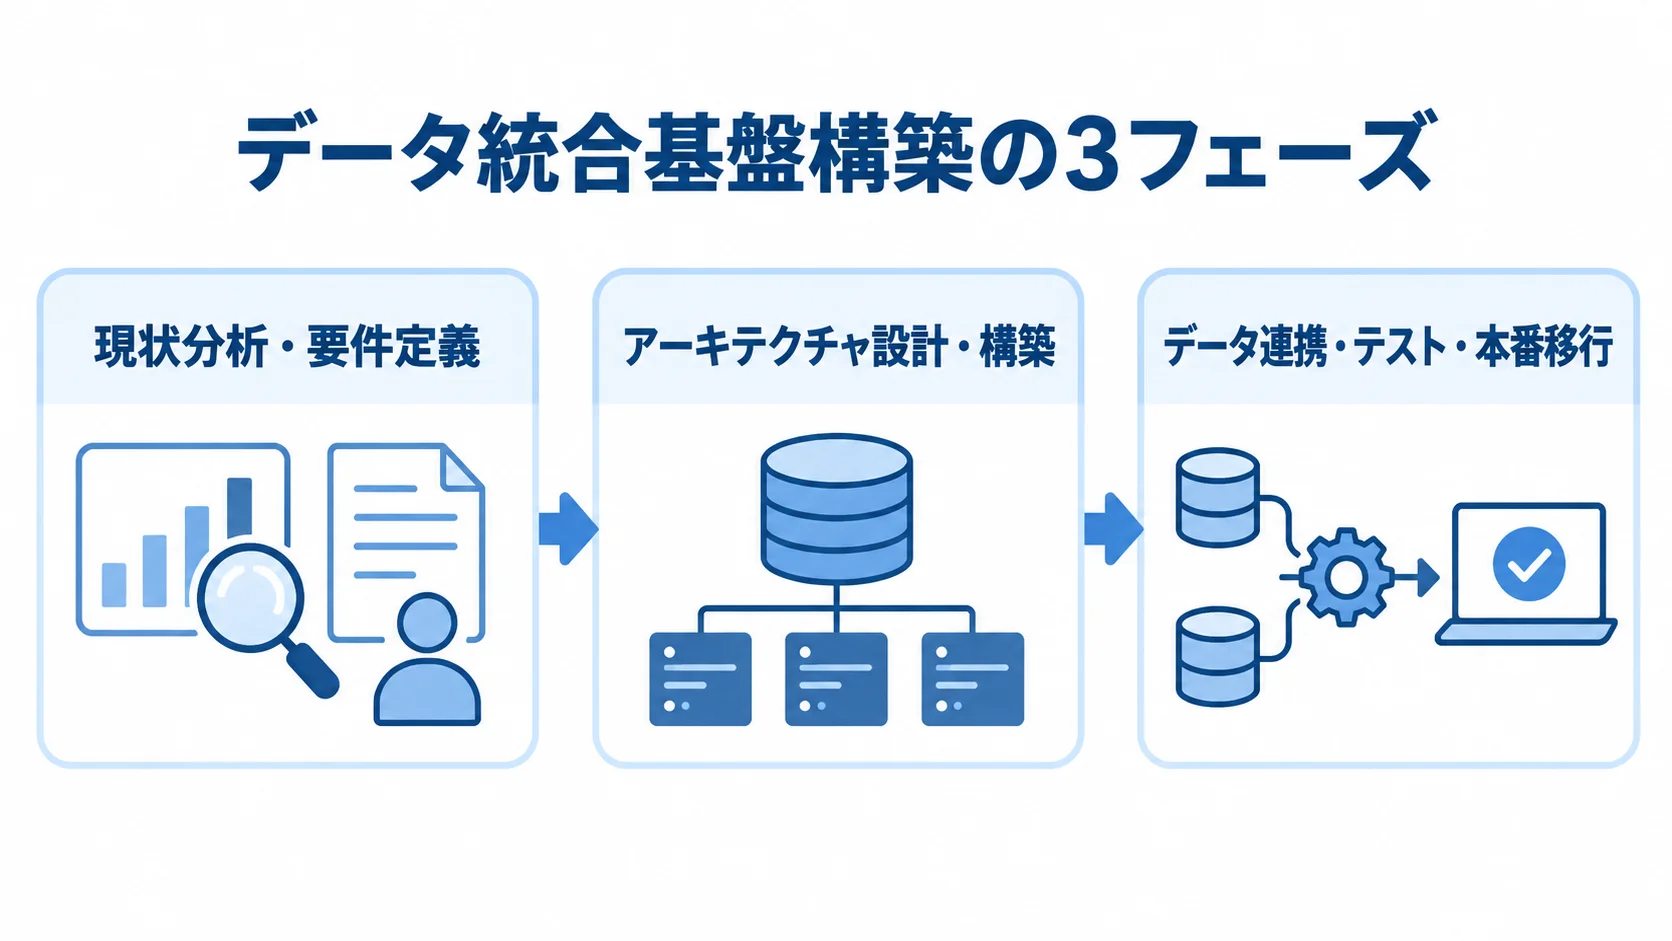
構築は3つのフェーズに分けて進めます。最初は社内のデータ環境と業務ニーズを押さえ、次に基盤を設計・構築し、最後に連携やテストを経て本番へ移します。各段階で成果物と承認の流れを決めておくと、手戻りを抑えながら品質を保てます。プロジェクトの規模や複雑さを問わず、この3フェーズを基本に計画します。
現状分析・要件定義フェーズ
まずは、社内のデータ環境と業務上のニーズを把握します。
- データ環境:データ品質と既存の連携状況の確認
- ビジネス要件:分析ニーズと、リアルタイムで把握したいKPIの決定
- 技術要件:対象データソース数・データ量・更新頻度、処理方式、セキュリティ要件、SLAの決定
データソースインベントリで、各システムのデータ所在を確認します。既存のETLバッチや手作業によるCSV連携のほか、NULL率、重複、フォーマット不統一も調べます。この把握がなければ、適切な基盤を設計できません。
業務部門とIT部門への調査は並行して進め、データマップに全体像をまとめます。また、性能・可用性・セキュリティ・拡張性などの非機能要件も、この段階で定義します。定義が遅れると、設計後に要件が加わり、手戻りが大きくなる可能性があります。
要件定義書は関係者全員でレビュー・承認してから次の段階へ進みます。
アーキテクチャ設計・構築フェーズ
要件定義が終わったら、基盤全体のアーキテクチャを設計し、ツールを選定します。構築は、その設計書に沿って進めます。
- データ構成:レイク、ウェアハウス、マートの設計
- 連携・管理:ETL/ELT、カタログ、メタデータ管理の設計
- 制御・拡張:セキュリティ、アクセス制御、将来の拡張性の設計
ツールには、オーケストレーションならApache Airflow、ETL/ELTならTalend、Informatica、AWS Glue、Azure Data Factoryなどがあります。データウェアハウスには、Snowflake、BigQuery、Redshiftなどがあり、各層に適したものを選びます。拡張できる設計にしておけば、長期的な運用コストを抑えることにつながります。
構築では、クラウド資源を用意したうえで、ウェアハウスのスキーマを設計・作成し、パイプラインを実装します。実装と検証は、優先度の高いデータソースから始め、段階的に対象を広げる方法が効果的です。
実装後は、レコード件数や合計値を照合し、NULL値と重複をチェックします。そのうえで、各パイプラインが品質基準を満たしているかを確かめます。
データ連携・テスト・本番移行フェーズ
本番移行前には、パイプラインの動作と連携、性能、データ品質を段階的に検証します。
- 単体・統合テスト:個別の動作と、複数パイプラインにまたがる一連の処理の確認
- 性能テスト:大量データ処理時の処理時間とリソース使用量の確認
- 品質テスト:業務ルールに基づくデータ整合性の検証
初期データロードでは履歴データを移行します。データ量が多いと想定以上に時間がかかるため、事前の検証と計画が欠かせません。
本番ではカナリアリリースやブルーグリーンデプロイメントを使い、段階的に切り替えます。問題が起きた場合に備えて、切り戻しの手順も事前に整えておきます。
稼働後は、CloudWatchやDataDogなどで実行状況、エラー、処理時間を監視します。アラートも設定し、問題を早期に検知できる体制を整えます。
本番運用と並行して、データカタログの整備とデータオーナーの設定を進めます。データ品質ルールの自動チェックも、あわせて用意します。
データガバナンスを整えることは、信頼できる基盤を定着させ、長期的な成功につなげるうえで欠かせません。
▶ 詳細はこちら:データ統合基盤構築/開発の進め方/やり方/流れや方法/手法/工程/手順
データ統合基盤構築でおすすめの開発会社
外部パートナーは、技術力・実績・サポート体制を総合的に評価して選びます。この選定が、成否を左右します。
ETL/ELTパイプラインの設計、データウェアハウスの構築、データガバナンスの整備には、幅広い専門知識が必要です。そのため、類似案件での豊富な実績に加えて、ビジネス要件を深く理解するコンサルティング力も備えた相手を選びます。
パートナー選定のポイント
パートナーは、類似案件の有無から提案の質やチーム経験まで、4つの観点で比べます。
- 類似案件:最も重視する実績で、同規模・同業種・同ツール構成の案件の有無
- 技術力:クラウド認定と担当者のデータ関連資格
- 提案力:設計理由と事業価値を論理的に説明できるか
- 比較評価:提案の質、費用の透明性、チーム経験
「実績がある」という答えに加えて、業種や構成、統合したソース数まで尋ねます。例として、Snowflake+Azure Data Factoryで20ソースを統合した案件の有無を確認できます。
認定の例には、Snowflake Elite PartnerやAWS Data & Analytics Competency、Google Cloud Partner Advantageがあります。担当者については、AWS Certified Data AnalyticsやSnowflake SnowPro Coreなどの資格も評価します。
RFPに基づく提案を複数社から受け、条件をそろえて検討します。そのうえで、技術力をビジネス課題に結びつけて説明できるか、コンサルティング力も確認します。
おすすめ開発会社6選
ここで取り上げる6社は、それぞれ得意とする領域や実績が異なります。
- 株式会社ripla:データ戦略から構築・運用までを支援し、Snowflake、BigQueryに対応
- 株式会社野村総合研究所(NRI):金融・保険・流通などでの数百TB規模の実績
- アクセンチュア株式会社:データメッシュ・データファブリックの導入実績が豊富で、AI基盤連携を含む大規模DXに強み
- 日本IBM株式会社:IBM DataStage、InfoSphere MDMを用いた大企業の統合支援
- 株式会社TIS:AWS・GCPのプレミアパートナーで、高効率なデータウェアハウスとリアルタイム基盤の構築実績
- 株式会社電通国際情報サービス(ISID):CDPやCRM・広告データの統合に詳しい
riplaは中堅から大企業まで実績があり、データガバナンスの整備も得意としています。NRIは日本最大級のITサービス企業で、エンタープライズ向けの標準技術にも知見があります。
アクセンチュアはグローバルなDXの知見があり、大規模なデジタル変革を支援します。日本IBMは、レガシー統合やハイブリッドクラウド環境での構築を支援します。
TISはクラウドネイティブ基盤の構築に強みを持ち、ISIDはデータドリブンマーケティングの支援に実績があります。
▶ 詳細はこちら:データ統合基盤構築でおすすめの開発会社/ベンダー6選と選び方
データ統合基盤構築の費用相場
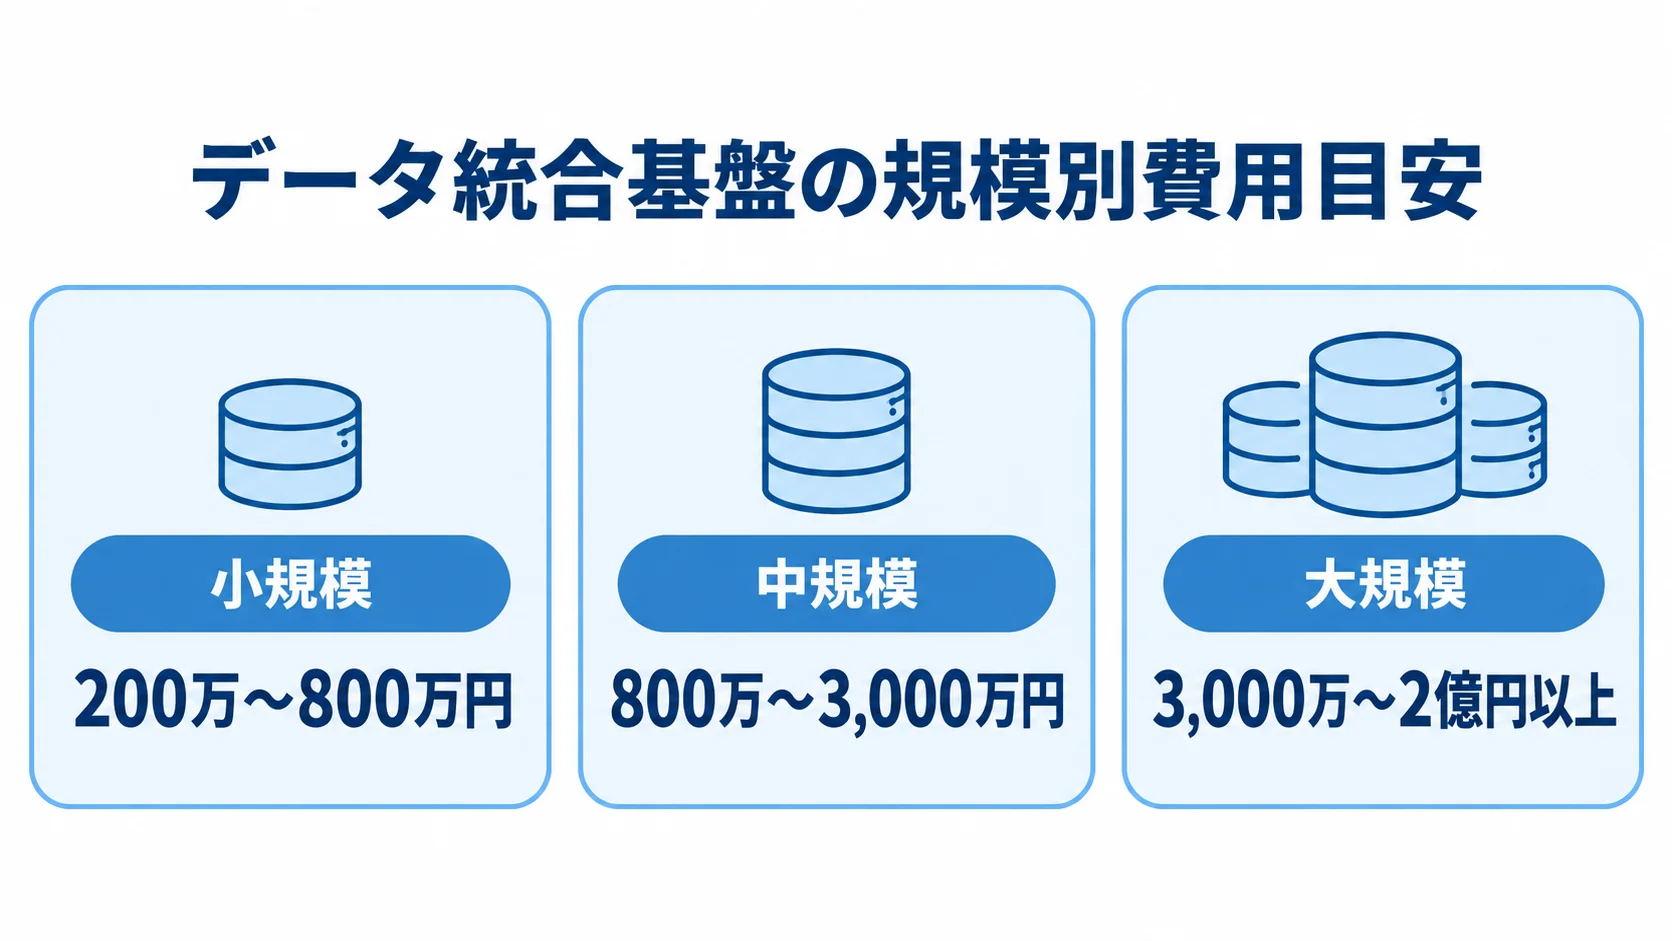
費用は、データソース数・データ量・処理の複雑さ、使うツールや開発チームの構成によって変わります。そのため、規模別の相場とコスト内訳を把握したうえで、複数社の詳細な見積もりを比べて予算を立てます。さらに、段階構築、OSS活用、クラウド費用の最適化を組み合わせる方法もあります。
規模別の費用目安
費用は規模と処理方式によって幅があるため、自社の条件に合わせて相場を確認します。
- 小規模:200万〜800万円
- 中規模:800万〜3,000万円
- 大規模:3,000万〜2億円以上
小規模は、データソースが5個未満で、バッチ処理が中心、クラウドSaaSとの連携が主体の場合です。AWS GlueやAzure Data FactoryとSnowflakeの最小構成で実現できます。また、期間は3〜6ヶ月、チームはデータエンジニア2〜3名程度が一般的です。
中規模は5〜20ソースで、オンプレミスを含み、一部でリアルタイム処理を行います。一方、大規模は20ソース以上で、グループ横断や複雑な変換、ストリーミング処理が対象です。
コストは、ツール・ライセンス、インフラ・クラウド、開発・コンサルティングに分かれます。例えば、Informaticaは年間数百万〜数千万円、TalendのオープンソースCore版は無償です。
インフラ・クラウド費用では、AWS Glueは$0.44/DPU-hourで、Snowflakeは計算資源とストレージに費用がかかります。BigQueryは、クエリ課金の$5/TBに加えて、ストレージが$0.02/GB/月かかります。
開発・コンサルティング費は全体の50〜70%を占め、エンジニアの人月単価は80万〜150万円です。運用保守には、初期構築費用の年15〜25%程度を見込んでおきます。
費用内訳とコスト最適化
見積もりは、初期費用だけでなく、工程別の内訳と5年間の総額で比べます。
- 同条件で見積もる:RFPを複数のベンダーに提示
- 内訳を確認する:工程別・人員別の費用
- TCOで比べる:導入後にかかる費用も含めた総額
内訳のない「一式○○円」の見積もりでは、後から追加費用が生じるおそれがあります。TCO(総所有コスト)には、年間ライセンス更新、運用保守、機能拡張費を含めます。
コストを抑える方法は、段階構築、OSS、クエリ最適化、割引契約、保管管理です。OSSでは、Apache Airflowやdbt Coreを活用します。段階構築では、優先度の高いソースから構築します。クエリ最適化では、パーティショニングやクラスタリングで、ウェアハウスの計算費用を削減します。
割引契約では、Reserved InstancesやCommitted Use Discountsで、最大40〜60%の割引があります。保管管理では、データのライフサイクル管理ポリシーでストレージ費用を最適化します。さらに、定期的な費用レビューを続け、コストを見直していきます。
▶ 詳細はこちら:データ統合基盤構築の見積相場や費用/コスト/値段について
データ統合基盤の外注・発注方法
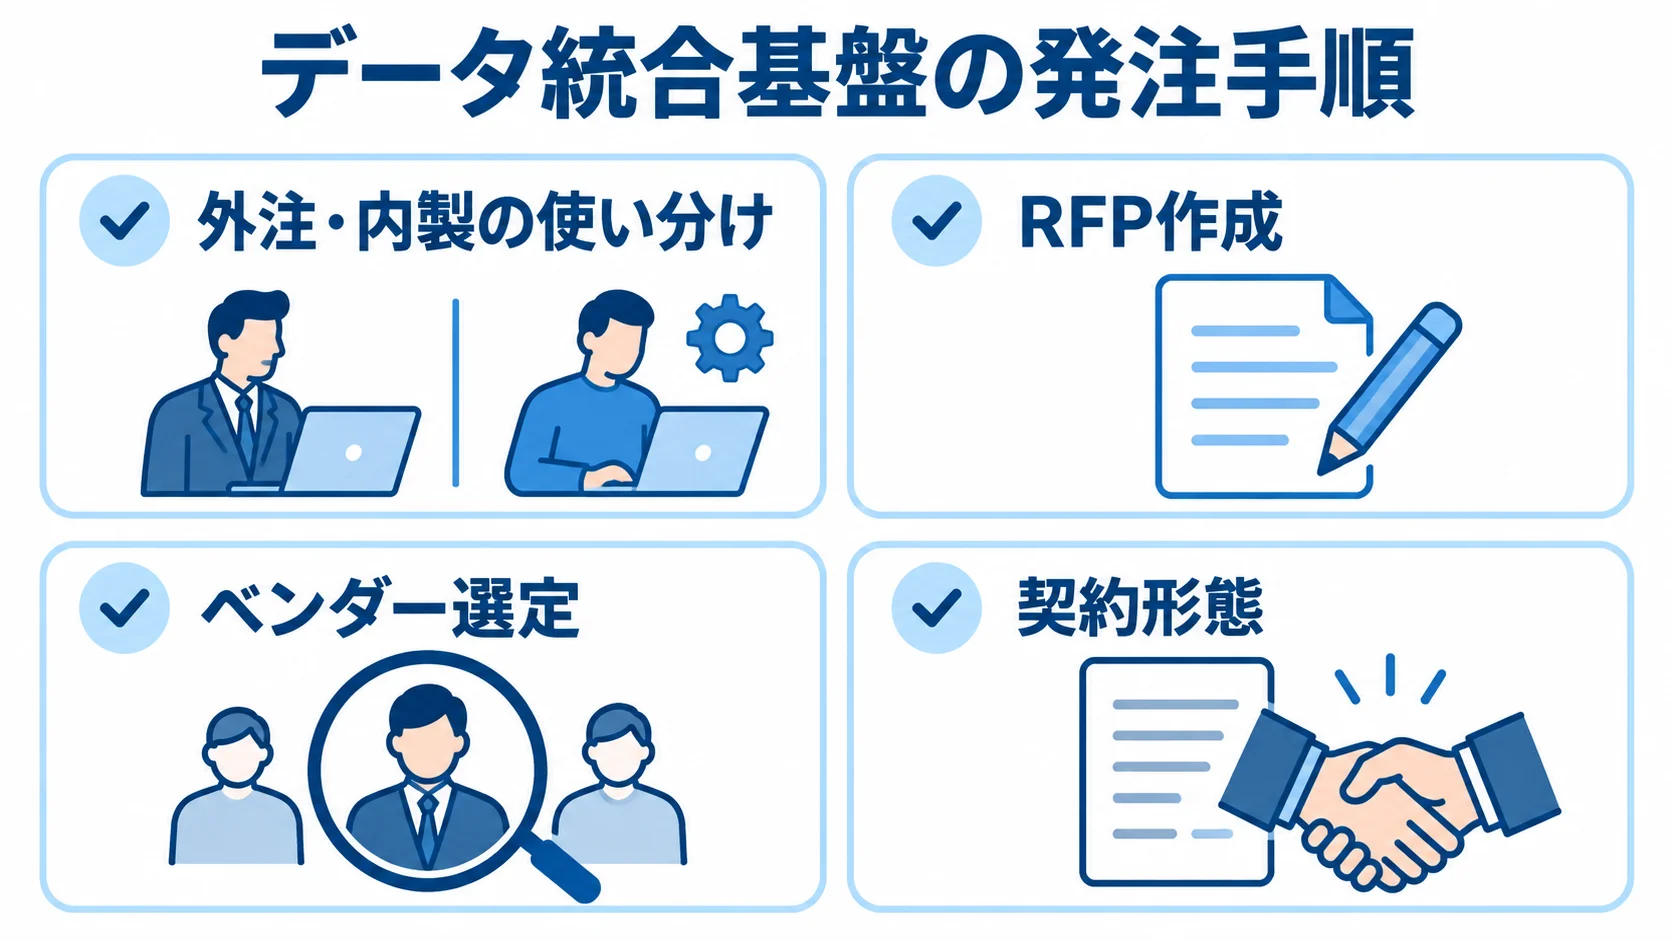
発注は、自社の体制に応じて外注と内製を使い分けたうえで、RFPを作成し、ベンダーを選定し、契約形態を選ぶ順に進めます。各段階で条件を整理しておくと、進行を見通しやすくなります。
発注前の準備とRFP作成
発注前には、データソース一覧やデータ量、連携状況と課題を整理し、構築後に実現したい活用像も言葉にしておきます。RFP(提案依頼書)には、背景や目的から評価基準まで、発注先に伝える条件を書き込みます。
- 背景と目的
- 対象データソース
- 機能・非機能要件
- スケジュール・予算上限
- 提案形式・評価基準
作成したRFPは、3〜5社へ同じ条件で配布します。RFPの作成が難しい場合は、先にRFI(情報提供依頼書)を使い、技術的な助言を求めることもできます。
外注か内製かは、社内のIT技術力や予算、時間の制約を踏まえて決めます。専門の人材がいない場合や、短期間での構築が必要な場合には、外注が適しています。
初期構築は外注し、その後の運用や改善を内製する方法も現実的です。この場合は、知識の移転に向けたドキュメント整備や技術研修を、契約に含めておきます。
発注先には、実装を重視するSIer、戦略や設計を重視するコンサル、クラウドインテグレーターがあります。自社の要件に応じて、発注先の種類を選びます。
ベンダー選定の注意点
提案の具体性と論理性を見て、契約や進行のリスクを確かめます。
- 提案:要件を聞かずに標準案を出す会社には注意
- 実績:可能であれば、過去の顧客への参照確認
- 契約:スコープ、成果物の品質基準、知財帰属、技術ドキュメント整備義務の明記
よくある失敗は、要件が不足したまま進んで仕様が変わることや、データソースの調査が足りず工数が追加されることです。独自実装に頼りすぎたり、文書が不足したりすると、内製への移行で困難が生じることもあります。
要件が確定した実装やテストには請負契約が適しており、請負契約では成果物の完成責任を負います。一方、要件定義や設計、アジャイル開発など要件が流動的な段階には準委任契約が適しています。準委任契約では業務遂行義務を負いますが、実務では段階に応じて両者を併用する例も多くあります。
週次で進捗会議を開き、各段階の成果物の確認には業務部門も加わります。これは、技術的には動いても業務で使われない事態を防ぐためです。
▶ 詳細はこちら:データ統合基盤構築の発注/外注/依頼/委託方法について
まとめ
構築は3フェーズで進みます。現状分析と要件定義から始まり、設計と構築を経て、データ連携とテストを行ったうえで本番移行に至ります。開発会社は、実績と提案力を見て選びます。
費用相場は、小規模で200万〜800万円、中規模で800万〜3,000万円、大規模で3,000万〜2億円以上です。発注では、RFP、ベンダー評価、契約形態の順に検討し、要件に合う方法を選びます。
データ統合基盤は、企業のデータドリブン経営を支えるインフラです。ETL/ELTやウェアハウス(Snowflake・BigQuery・Redshiftなど)、カタログ、ガバナンスを整えることが大切です。成功を支えるのは、技術設計とビジネス要件の理解、パートナー選定、継続的なガバナンスです。
▼データ統合基盤構築に関する詳細記事
・データ統合基盤構築/開発の進め方/やり方/流れや方法/手法/工程/手順
・データ統合基盤構築でおすすめの開発会社/ベンダー6選と選び方
・データ統合基盤構築の見積相場や費用/コスト/値段について
・データ統合基盤構築の発注/外注/依頼/委託方法について
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。