
Databricks導入は、目的と要件の整理から始めて発注や費用管理まで順に進めると、データ・AI活用の基盤づくりに役立ちます。
進め方・費用・発注先に悩む担当者もいます。そこで、特徴から発注までを順に見ていきます。各テーマの詳細は、各章末尾のリンク先記事もご覧ください。
▼関連記事一覧
・Databricks導入の進め方/やり方/流れや方法/手法/工程/手順
・Databricks導入でおすすめの開発会社/ベンダー6選と選び方
・Databricks導入の見積相場や費用/コスト/値段について
・Databricks導入の発注/外注/依頼/委託方法について
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Databricksとは何か・導入する意義
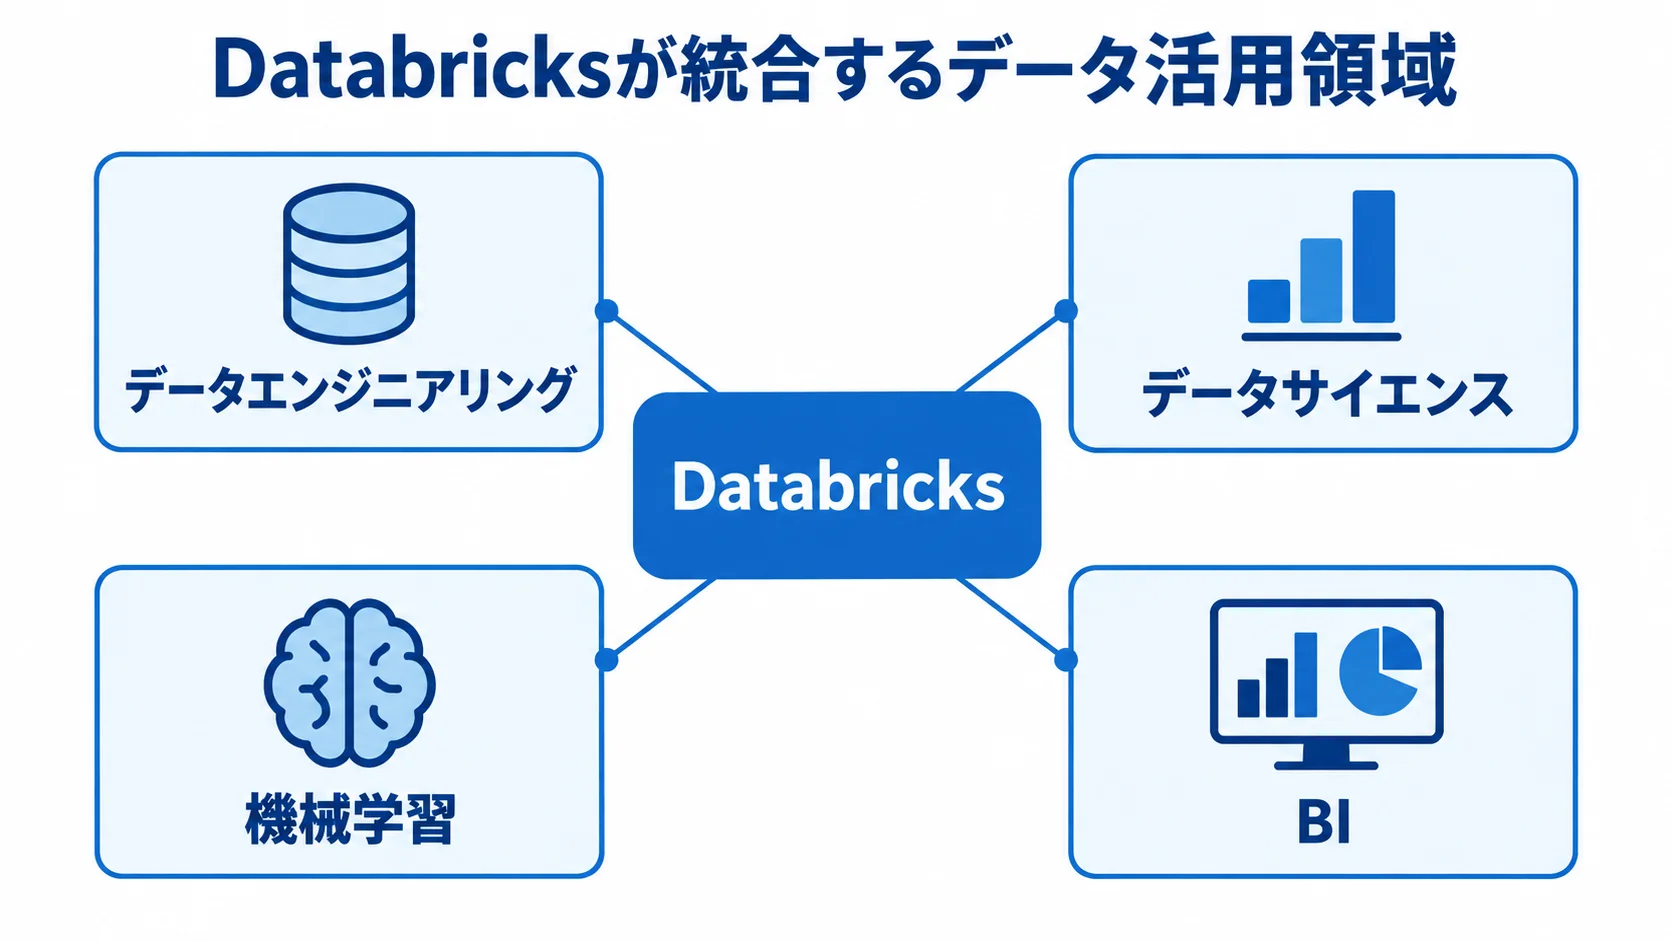
Databricksは、データエンジニアリングとデータサイエンス、機械学習、BIを一つにまとめた、クラウドネイティブなデータ・AIプラットフォームです。
Apache Sparkをベースに開発されているため、大規模データの処理や分析を効率的に行えます。対応するクラウドは、AWS、Azure、Google Cloudの主要3つです。
提供元のDatabricks社は、2013年にカリフォルニア大学バークレー校の研究者が創業した会社です。世界で10,000社以上が採用しており、この数値は2024年時点のものです。
製造、金融、小売、ヘルスケアなど、データ活用が重要な業界で普及が進んでいます。
Databricksの主な機能と特徴
Databricksの機能は役割ごとに分かれており、データの統合から機械学習の運用まで、一つの基盤の中で扱えます。
- Lakehouse Architecture:データレイクとデータウェアハウスを統合する、Delta Lakeの仕組みです。
- MLflow:機械学習モデルの管理、追跡、デプロイ。
- Unity Catalog:データとAIのガバナンスを統合管理する機能。
- Databricks SQL:標準SQLに対応する高速なBIクエリエンジン。
- AutoML:機械学習モデルを自動で構築する機能。
従来は別々のツールで構築していた、データパイプライン、分析、機械学習の環境を、一つのプラットフォームにまとめられます。その結果、データエンジニアとデータサイエンティストの協業が進み、開発の速度と品質が向上します。
データレイクは大量の非構造化データを安価に保存する場所で、データウェアハウスは構造化データを高速にクエリする役割を担います。
Delta Lakeはオープンフォーマットのストレージ層で、ACIDトランザクション、スキーマ管理、データのバージョン管理を備えているため、信頼性の高い基盤を構築できます。
Databricks導入で期待できる効果と活用場面
Databricksは、データ処理から機械学習まで、次のような用途で活用できます。
- データパイプライン:大規模データのETL/ELT処理の高速化
- ストリーミング分析:データのリアルタイムな処理
- 機械学習:モデルの開発から本番環境へのデプロイまで
- Lakehouse構築:全社のデータ基盤の統合
複数システムのデータを一つにまとめられるため、データサイエンスチームと分析チームが同じ環境で協業できます。この点は、他のツールにはない強みです。
国内導入企業では、従来の分析基盤に比べてデータ処理コストを50〜70%削減した事例があり、モデル開発サイクルを3分の1に短縮したケースも報告されています。こうした点から、導入は企業のデータ・AI活用を高める戦略的な投資といえます。
Databricks導入の進め方
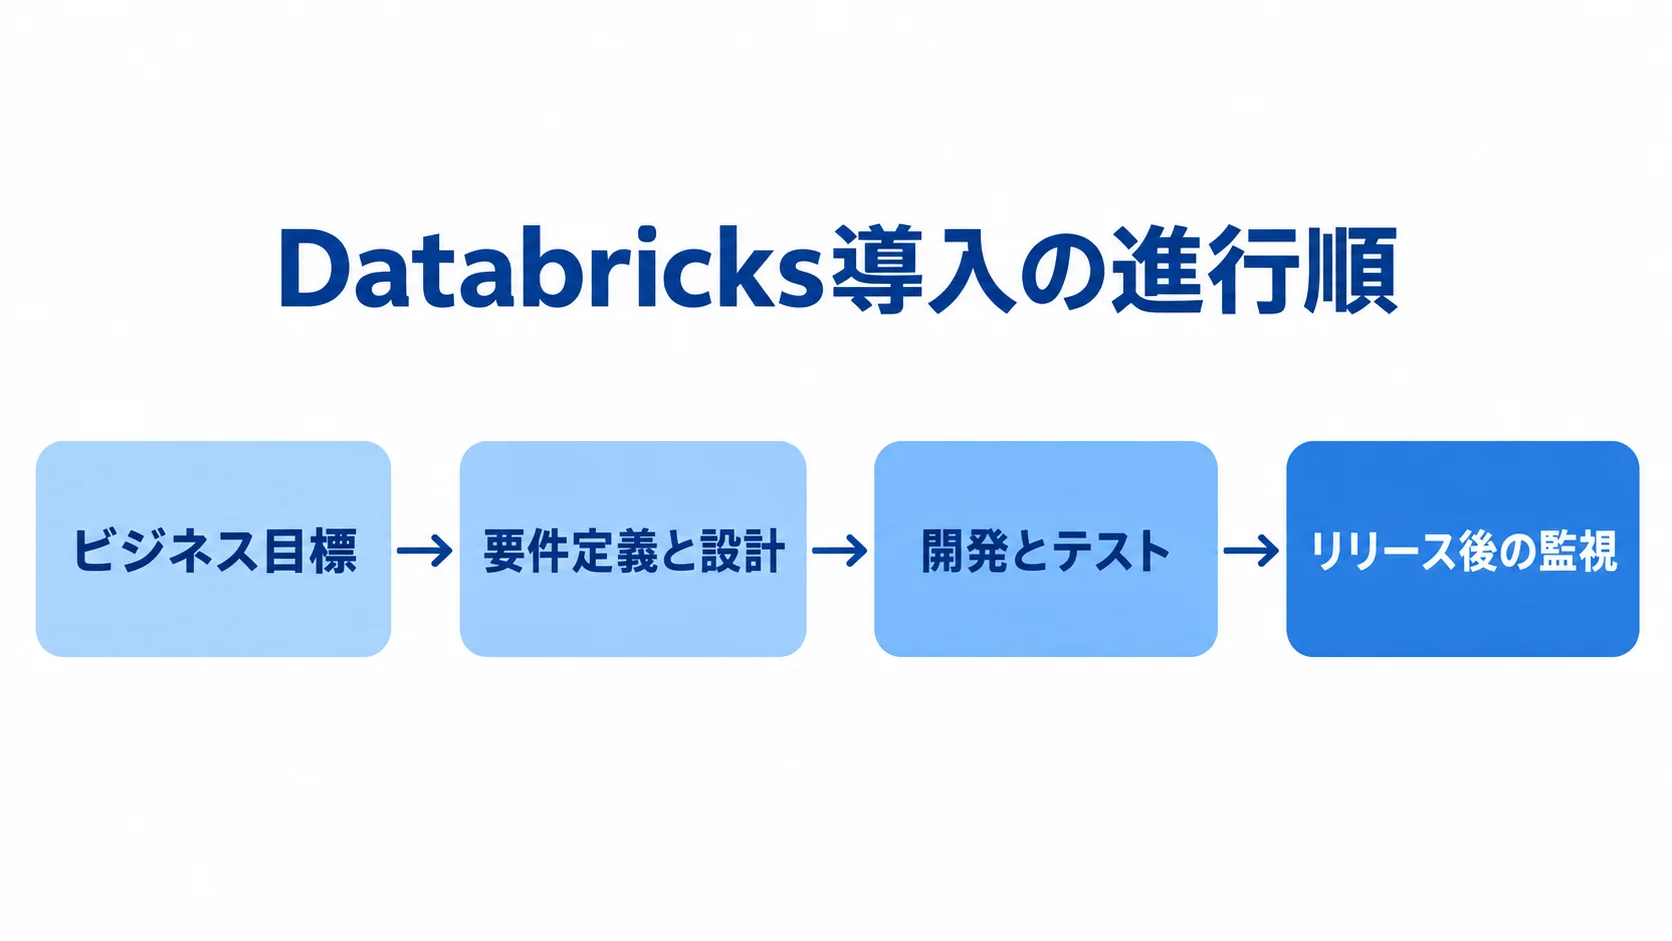
導入では、技術の設定だけでなく、ビジネス目標を定めるところから始めます。そのうえで、要件定義と設計を経て、開発とテストに進みます。
要件定義・企画フェーズでの目的の整理
最初に、Databricksを導入して実現したいビジネス目標を定め、技術を選ぶより先に明確にしておくことが大切です。
目的には、データ分析基盤の刷新、機械学習基盤の構築、既存のデータレイクとデータウェアハウスの統合などがあります。目的が決まったら、取り込むシステムとデータを整理します。
- データの内容:対象システムと、明細・集計のどちらの粒度か。
- 利用者:SQLアナリストか、データサイエンティストか。
- 処理方式:リアルタイム処理が必要か、バッチ処理で足りるか。
主なユースケースは3種類で、ETLパイプラインによるデータエンジニアリング、Databricks SQLによるアナリティクスとBI、MLflowを使う機械学習・AI開発があります。
機械学習・AI開発では、実験の管理から本番へのデプロイまで一貫して行えます。ステークホルダーとの合意は、後工程の手戻りを防ぐ点で特に大切です。
設計・開発からテスト・リリースまでの流れ
設計では、データレイヤの定義やクラスタ構成、権限とセキュリティを決めます。そのうえで、テストとリリースに進み、リリース後も監視を続けます。
- Raw・Curated・Feature・Martなどのデータレイヤ構成の定義
- Delta Lakeの運用方針の決定
- Sparkクラスタ構成とオートスケールの設計
- Unity Catalogによるデータアクセス制御など、権限とセキュリティの設計
- クラウドプロバイダーの選定
- 想定データ量でのオートスケール、クエリ応答時間、費用のテスト
- リリース後の監視と、必要に応じた構成の調整
- 少数のパワーユーザーで試験運用し、意見を集めてから全体展開することで、失敗リスクを抑える。
クラウドプロバイダーを比べると、Azureは、Microsoftのファーストパーティサービスとして、他のAzureサービスとの統合に優れています。一方、AWSはDatabricks公式パートナーで、統合オプションが最も豊富です。
テストとリリースは、この設計をもとに進めます。テストでは、要件を満たすか、費用が予算内に収まるかを照らし合わせて確認します。リリース後も、コスト、性能、データ品質の状態を継続して見ながら、必要に応じてクラスタ設定やパイプライン設計を見直すと、安定運用につながります。
▶ 詳細はこちら:Databricks導入の進め方/やり方/流れや方法/手法/工程/手順
Databricks導入でおすすめの開発会社・ベンダー
Databricksは機能の自由度が高いぶん、適切なアーキテクチャ設計なしに導入すると、設計負債や費用の膨張につながります。
設計思想や運用方針が曖昧だと、ETLが乱立して品質管理が難しくなるほか、クラスタの設定ミスで月次費用が想定の数倍に増えることもあります。
構築した基盤を現場が使いこなせず、放置されることもあります。さらに、Databricksは2〜3ヶ月ごとに機能が更新される、進化の速い基盤です。
認定パートナーは、最新機能や推奨される進め方の情報をDatabricks社から優先的に得られるため、技術判断に生かせます。
株式会社ripla|ビジネス起点の設計で定着まで一気通貫
riplaは、コンサルティングから開発まで一気通貫で支援する企業です。IT事業会社として社内DXを推進した経験を活かします。
ビジネス成果の創出と、システムの定着支援に強みがあります。「データ活用でどの業務判断を変えるか」を起点に、設計を進めます。
クライアントの課題を理解したうえでDatabricksのソリューションを設計し、コンサルティングから開発、定着までを一貫したチームで対応します。
riplaでは、フェーズ間で情報が途切れにくい体制を整えており、プロジェクト全体の品質を保ちやすくしています。
- 基盤構築:Databricksを使ったデータレイクハウスの設計・構築
- システム連携:既存のデータウェアハウスや社内システムとの接続設計
- 活用・統制:ダッシュボード開発、データガバナンス、セキュリティ設計の支援
パートナー選びで確認すべき評価ポイント
発注先は、価格だけでなく複数の観点から総合的に評価します。
- 認定資格:Databricks公式認定資格を持つエンジニアの人数
- 導入実績:類似の業種や規模に近い案件の有無
- 対応範囲:構築後も継続して支援できるかどうか
クラスメソッド株式会社は、AWSを中心とするクラウド統合に強く、「Databricks on AWS」の実績があります。一方、大手SIerには、エンタープライズ実績を持つ企業もあります。
発注前には、既存基盤の状況や主な利用者を整理し、予算上限と必達スケジュールも決めておきます。
主な利用者がSQLアナリスト中心か、Pythonエンジニアも含むかを特定しておくと、具体的な提案を得やすくなります。
データ基盤の構築に加え、現場へのトレーニングや活用の定着まで一貫して支援できる会社は、投資対効果の最大化につながります。
▶ 詳細はこちら:Databricks導入でおすすめの開発会社/ベンダー6選と選び方
Databricks導入の費用相場
費用は、初期導入費用(構築費)とランニングコスト(運用費)に分かれます。初期費用は、外部のSIerや開発会社への依頼費と、Databricksの利用開始費用から成ります。
ランニングコストは、処理能力の単位であるDBU(Databricks Unit)の使用量に応じた従量課金が中心です。
さらに、仮想マシン、ストレージ、ネットワークなどのクラウド基盤の費用も発生します。費用の構造が複雑なため、正確な見積もりは難しい面があります。
DBU費用だけで見積もると、基盤費用や社内工数を見落とし、予算超過につながるため注意が必要です。
開発規模別の費用目安とシミュレーション
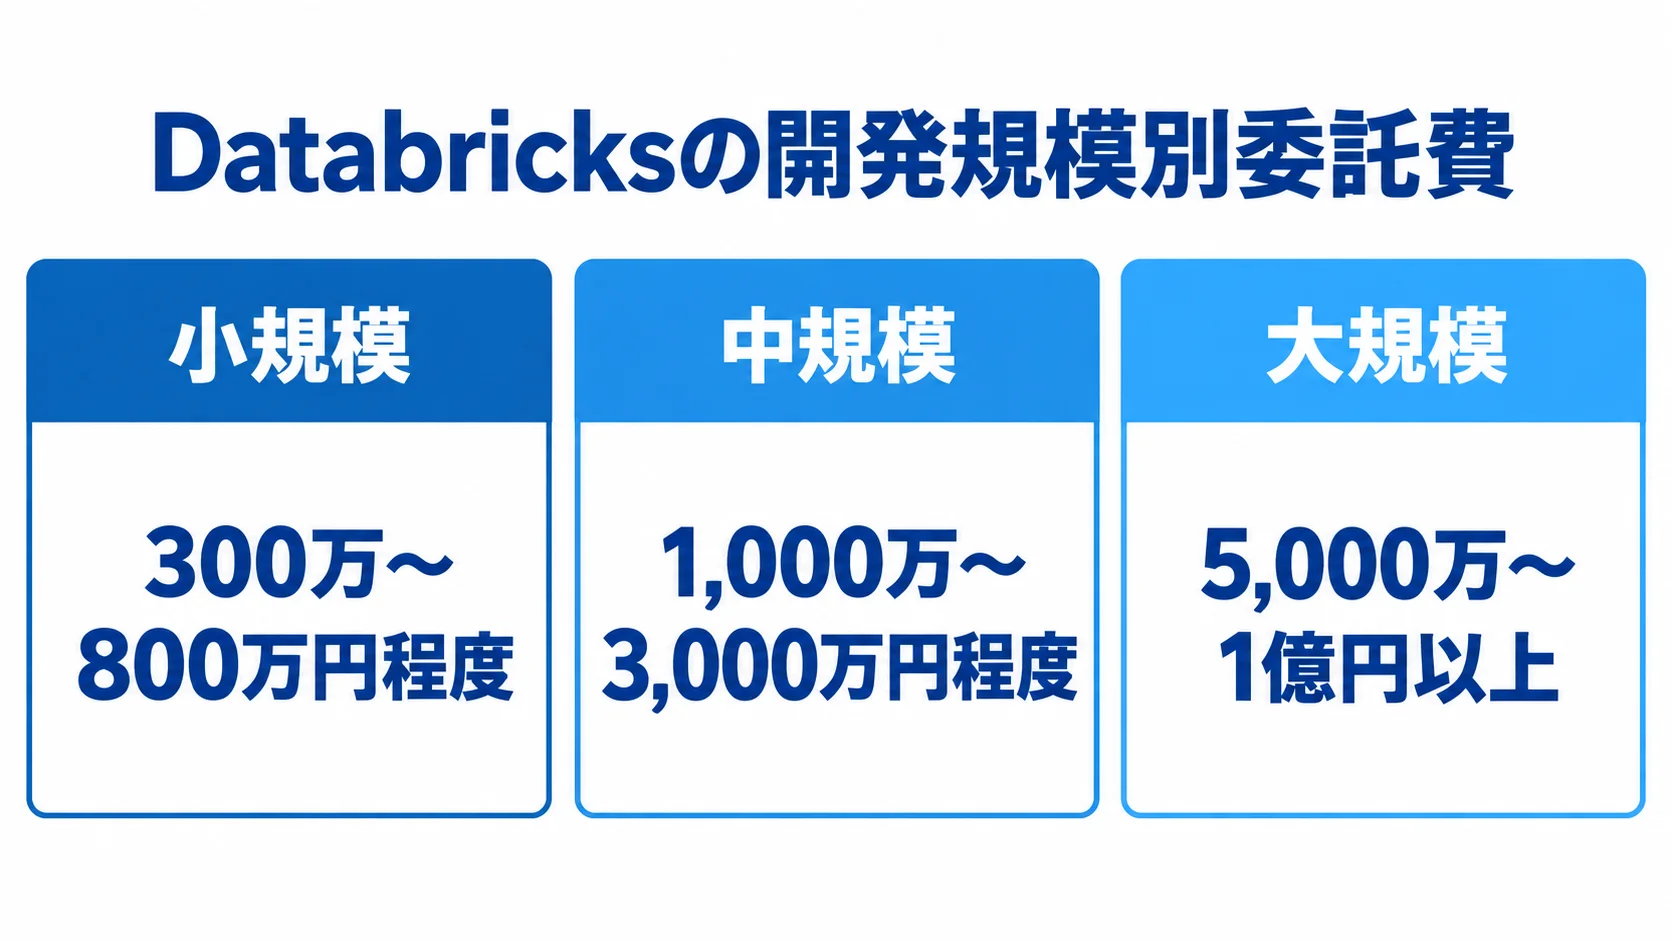
委託費を想定するときは、導入規模と対象ユーザー数に加え、各規模で整備する基盤の範囲を照らし合わせます。
- 小規模:部門向けの基本的なパイプラインとBI、10〜30名程度で300万〜800万円程度。
- 中規模:全社的なデータ基盤の統合、ETLパイプライン、機械学習基盤を含み、50〜200名程度で1,000万〜3,000万円程度。
- 大規模:複数部門・複数システムをまたぐレイクハウス構築とAI/ML基盤の整備で、5,000万〜1億円以上の例もあります。
中堅製造業の生産データ基盤では、構築費が約1,500万円、月額費用が約80万円でした。初年度の総費用は約2,460万円です。
金融機関のデータウェアハウス刷新とML基盤構築では、構築費が約6,000万円、月額費用が約250万円でした。初年度の総費用は約9,000万円です。
スタートアップの小規模導入では、構築費が約400万円、月額費用が約15万円でした。初年度の総費用は約580万円です。このように、Databricks導入の費用は規模によって大きく異なります。
ランニングコストを抑えるための実践的アプローチ
コスト管理では、契約の仕方と運用の設定に工夫を加えることが役立ちます。
- DBCUの活用:Databricks Commit Units(DBCU)を1年または3年単位で事前購入すると、従量課金より最大37%削減できます。
- 自動終了:未使用時に10〜30分で終了するポリシーの設定。
- クラスタの使い分け:インタラクティブクラスタはノートブック用、ジョブクラスタは自動化用です。ジョブには安価なJobsコンピュートを使います。
月次総費用は、小規模環境で30万〜80万円程度、中規模環境で100万〜300万円程度が一般的な水準です。
この水準を予算計画の目安にし、定期的にコストを見直すことが、長期的な費用管理には欠かせません。なお、見積もりの比較では、SIerにDBU計算の前提を開示してもらい、自社の想定と照らし合わせます。
▶ 詳細はこちら:Databricks導入の見積相場や費用/コスト/値段について
Databricks導入の外注・発注方法
導入には高度な技術知識が必要なため、多くの企業にとって社内だけで完結させるのは現実的ではありません。
Databricks、Apache Spark、Delta Lakeの知識を持つ人材がいない場合や、短期間で完遂したい場合は、外注が選択肢になります。
高品質なアーキテクチャ設計を求める場合も、外注が適しています。一方、データエンジニアやMLエンジニアが複数名いて基礎知識があれば、内製も可能です。
また、初回の導入は外注し、その後の運用拡張を内製する方法もあります。外注を通じて知識を吸収しながら段階的に内製へ移す、ハイブリッド型です。
発注先は4種類に分けられます。大手SIerと専門インテグレーターに加え、中小SIer・コンサルティングファーム、フリーランスがあります。
大手SIerにはNTTデータやSCSKなど、専門インテグレーターにはクラスメソッドやナレッジコミュニケーションなどがあります。
RFP作成と発注先の選定手順
発注は、準備から契約まで順に進めます。RFPは、選定プロセス全体の品質を左右する重要な文書です。
- 発注前の準備
- 4〜10ページ程度を目安にしたRFPの作成
- 候補先への打診と、3〜5社へのRFP送付
- 提案内容のヒアリング
- 比較による発注先の決定と、契約後のプロジェクト開始
RFPには、背景と目的、現状環境、要求事項を書きます。制約条件と提案に含める事項も、あわせて盛り込みます。
現状環境には既存データシステム構成、データ量、利用ツールを含めます。要求事項には機能要件と非機能要件を記載します。
制約条件には予算上限、スケジュール、クラウドプロバイダー指定を記載します。提案事項には、費用内訳と体制に加えて、過去事例や認定資格者数も含めます。
候補各社は4つの観点で比べ、費用と技術アプローチに加えて、体制とスケジュールも見ます。
ヒアリングでは、類似導入の経験やリスク管理について聞き、認定エンジニアの参加体制と保守運用への移行計画も確認します。なお、提案書では見えにくい企業の実力や姿勢も、ヒアリングで把握できます。
契約形態とプロジェクト管理のポイント
契約と運用管理では、責任の範囲を決めるほか、費用を把握できる形にし、知識移転の方法もあらかじめ定めます。
- 契約形態:要件が不確実な場合、要件定義・基本設計は準委任、詳細設計・開発は請負とする組み合わせも有効です。
- フェーズ発注:成果物を確かめてから次の工程に進むと、リスクを段階的に管理できます。
- 契約内容:成果物、受け入れ基準、NDA、瑕疵担保責任の範囲と期間を確認します。コードや設計文書は、自社資産への帰属が一般的です。
- 費用管理:発注先にコストダッシュボードを設定してもらい、週次または月次のレポートで超過を早期に検知します。
- 知識移転:構築したシステムを自社で理解・運用できるよう、技術説明会やハンズオン研修を契約に含めます。
▶ 詳細はこちら:Databricks導入の発注/外注/依頼/委託方法について
まとめ
Databricks導入の進め方、会社選び、費用相場、外注・発注方法の4つのテーマを横断して見てきました。
導入を成功させるには、ビジネス目標を明確にして要件定義を進めることと、認定パートナーを中心に発注先を慎重に選ぶことが大切です。
DBU課金とクラウド基盤費用を含めた総額で予算を立て、コスト超過や技術負債、組織への定着といったリスクには、導入の初期から手を打ちます。
初期構築費と運用費を3年や5年の単位で試算し、投資対効果(ROI)から導入の意義を評価しておくと、経営層への説明に役立ちます。
適切に活用できれば、既存基盤と比べた処理コストの大幅な削減や、分析スピードの向上が期待できます。
各テーマの詳細は、関連記事をご覧ください。
▼関連記事一覧
・Databricks導入の進め方/やり方/流れや方法/手法/工程/手順
・Databricks導入でおすすめの開発会社/ベンダー6選と選び方
・Databricks導入の見積相場や費用/コスト/値段について
・Databricks導入の発注/外注/依頼/委託方法について
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。