
Databricks導入は、ビジネス目標と要件を決めるところから始め、設計・開発、テスト・リリースの順に進めるのが基本です。費用はDBU利用料とクラウド基盤費を合わせて見積もり、支援内容も比べます。
導入全体の背景は、次の完全ガイドをご覧ください。
▼全体ガイドの記事
・Databricks導入の完全ガイド
データ基盤構築の工程ごとの進め方と注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Databricks導入の全体像
Databricksは、2013年にカリフォルニア大学バークレー校の研究者たちが創業したデータ・AI企業が提供するプラットフォームです。Apache Sparkをベースに開発されており、データエンジニアリングからデータサイエンス、機械学習、ビジネスインテリジェンスまでを、単一の統合環境で扱えます。
AWS・Azure・Google Cloudの主要3大クラウドに対応しており、2026年時点で世界10,000社以上の企業が採用しています。国内では、NTTデータや伊藤忠テクノソリューションズなどの大手SIerが公式パートナーとして支援しています。また、金融・製造・小売・医療など幅広い業種で導入が進んでいます。
レイクハウスアーキテクチャの特徴
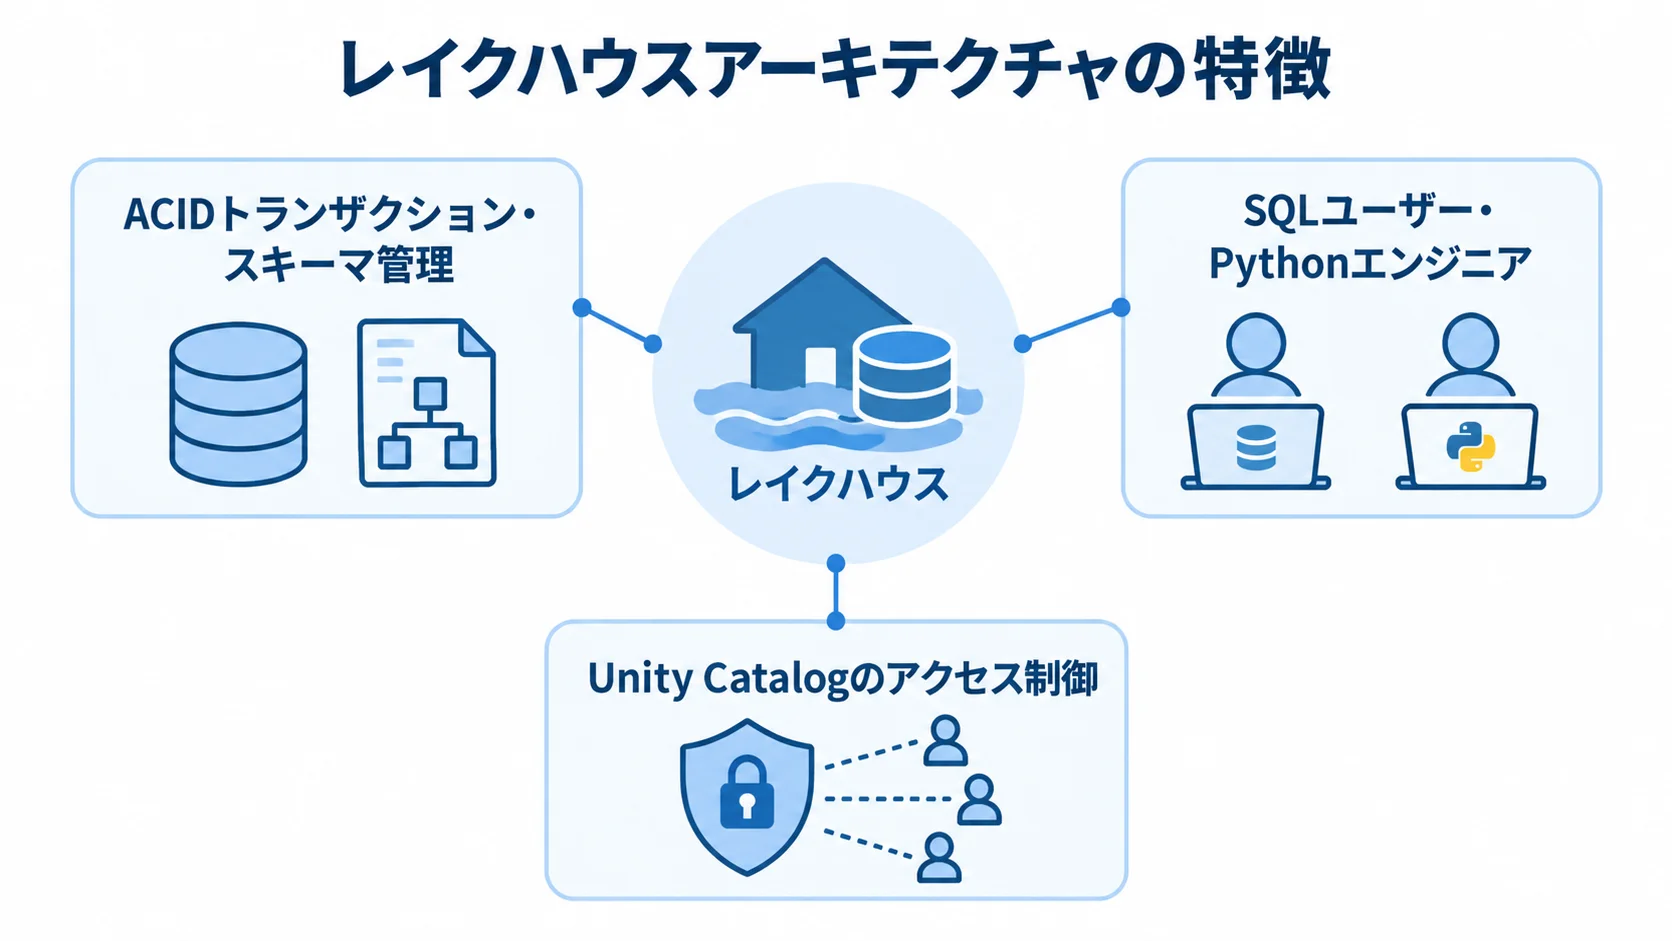
レイクハウスは、データレイクとデータウェアハウスを統合するDatabricksの基盤です。
- 信頼性:Delta LakeでACIDトランザクション、スキーマ管理、データのバージョン管理を行います。
- 共通環境:SQLユーザーやPythonエンジニア、データサイエンティストが、同じ基盤で作業できます。
- ガバナンス:Unity Catalogでデータへのアクセスを制御し、コンプライアンス要件に応えます。
Databricksが活躍する主なユースケース
Databricksをどの業務で使うかを先に整理しておくと、導入計画で必要な機能や体制を検討しやすくなります。
- データエンジニアリング:複数システムのデータを収集・変換・統合するETLパイプラインで使います。
- アナリティクス・BI:Databricks SQLで、分析やダッシュボードを作成します。
- 機械学習・AI開発:MLflowで実験、バージョン管理、本番デプロイを行い、RAGなどにも使います。
導入計画では、これらの用途を前提にします。
Databricks導入の進め方
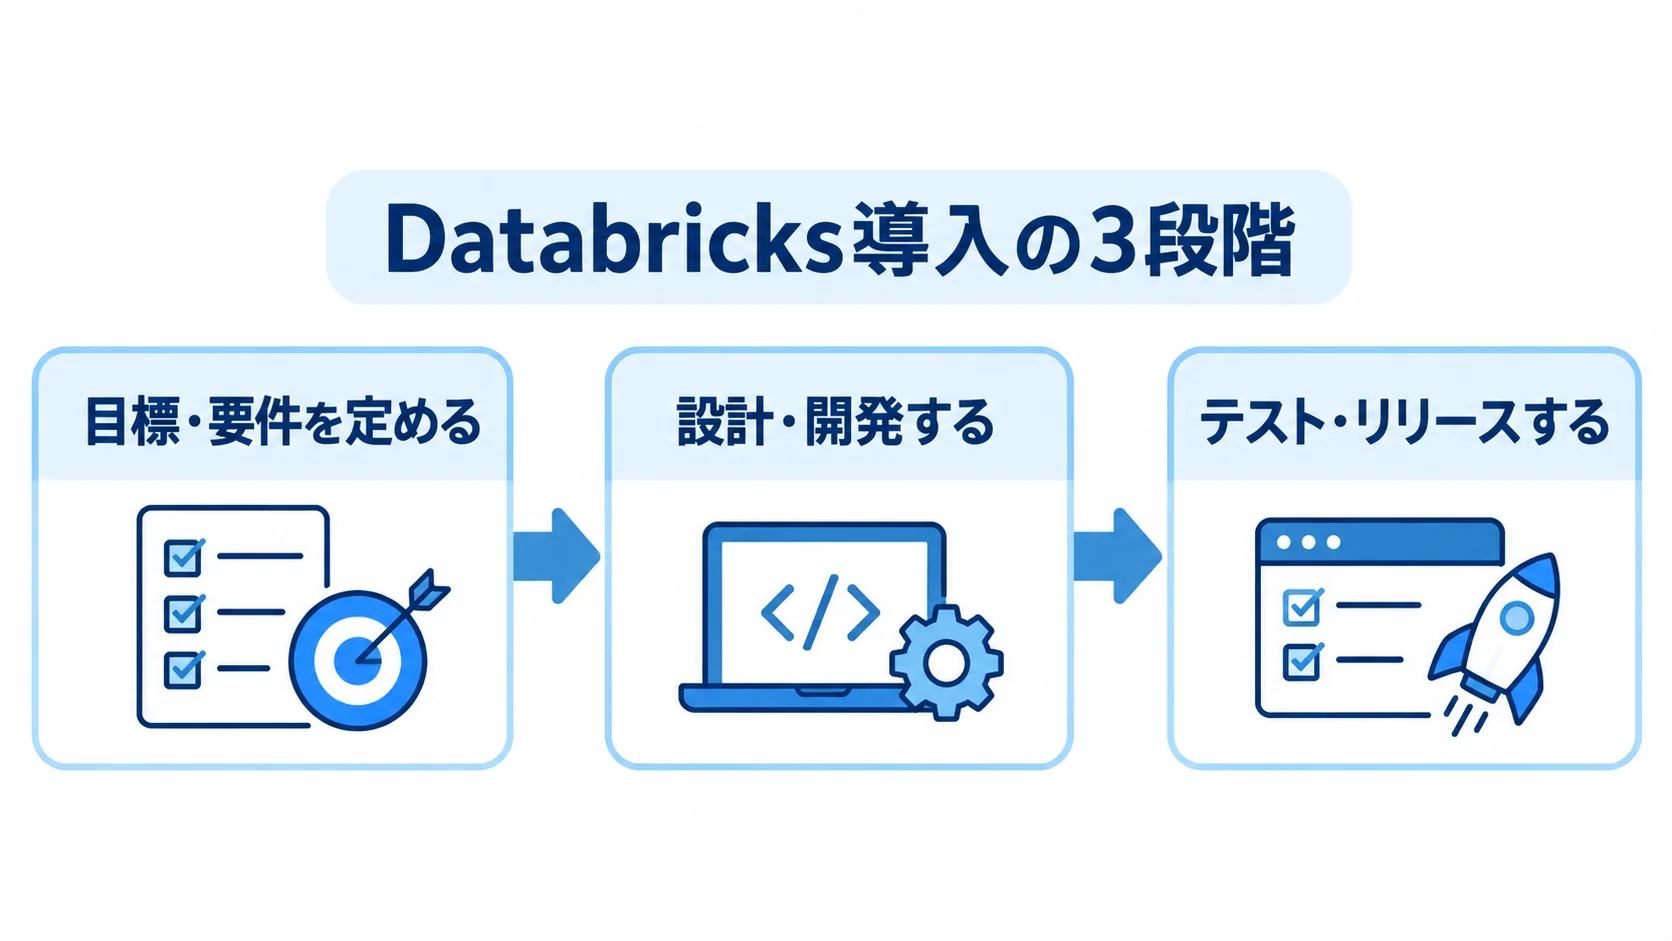
導入は、ビジネス目標から運用までを段階に分けて計画します。技術の設定から入ると、何のための基盤かが曖昧になりやすいため、目標を先に決めます。
- 目標・要件を定める:ビジネス目標を決め、必要なデータや利用者、処理方式を整理します。
- 設計・開発する:要件に沿って基盤を設計し、パイプラインやノートブックを開発します。
- テスト・リリースする:性能やデータ品質を確認し、段階的に利用を広げます。
各段階で検討する内容を、順に見ていきます。
要件定義・企画フェーズ
企画の段階では、発注側がまず導入の目的を決めます。そのうえで、関係者どうしが同じ前提で話せるよう、必要な条件を整理します。
- 導入目的:分析基盤の刷新、機械学習基盤の構築、既存基盤の統合などのうち、どれを狙うかを明確にします。
- データ要件:取り込むシステム、データの粒度、処理方式(リアルタイムかバッチか)。
- 利用者:SQLアナリストやデータサイエンティストなど、どんな人が使うかを整理します。
- 推進体制:関係者との合意を取り、プロジェクトスポンサーとなる経営層の関与を取り付けます。
要件定義の精度は導入全体に影響するため、この段階で関係者の認識をそろえます。
設計・開発フェーズ
要件が固まったら、発注側と開発会社がデータの流れと運用方法を決めてから、実装に進みます。
- データとストレージ:Raw・Curated・Feature・Martのレイヤ構成、Delta Lakeのスキーマ管理、品質確認、バキューム方針。
- 計算環境:Sparkクラスタの構成とオートスケールの設定。
- 権限と連携:Unity Catalogでのアクセス制御、BIツールやML基盤との接続。
- クラウド:Azure・AWS・GCPそれぞれとの連携方法。
- 開発・レビュー:パイプライン、ノートブック、ジョブの作成と、社内外の体制で行う週次の確認。
Azureは、Microsoftのファーストパーティサービスであることから、他のAzureサービスとの統合に優れます。AWSは統合オプションが豊富で、GCPはBigQueryとの連携が候補になります。
テスト・リリースフェーズ
リリース前には、処理が正しく動くかだけでなく、本番を想定した負荷や運用の条件も確かめます。
- テスト:単体、結合、性能、ユーザー受け入れ(UAT)の各段階で確かめます。
- 性能と費用:想定データ量でのオートスケール、クエリの応答、予算内に収まるコスト。
- データ品質:Delta Lakeの品質チェックで、パイプラインが期待どおりの品質を保つかを検証します。
- 段階的な展開:少数のパワーユーザーでパイロットを始め、フィードバックを受けてから全体に広げます。
リリース後も、コスト・性能・データ品質の監視を続け、クラスタ設定やパイプラインを調整します。
費用相場とコストの内訳
Databricks導入のコストは、「Databricksのライセンス・利用費用」と「導入支援(コンサルティング・構築)の費用」の2つで構成されます。
Databricksの利用費は使用量に応じた従量課金のため、事前に正確な金額を算出するのは難しい面があります。そのため、予算計画では金額に幅を持たせて見ておく必要があります。
人件費と工数
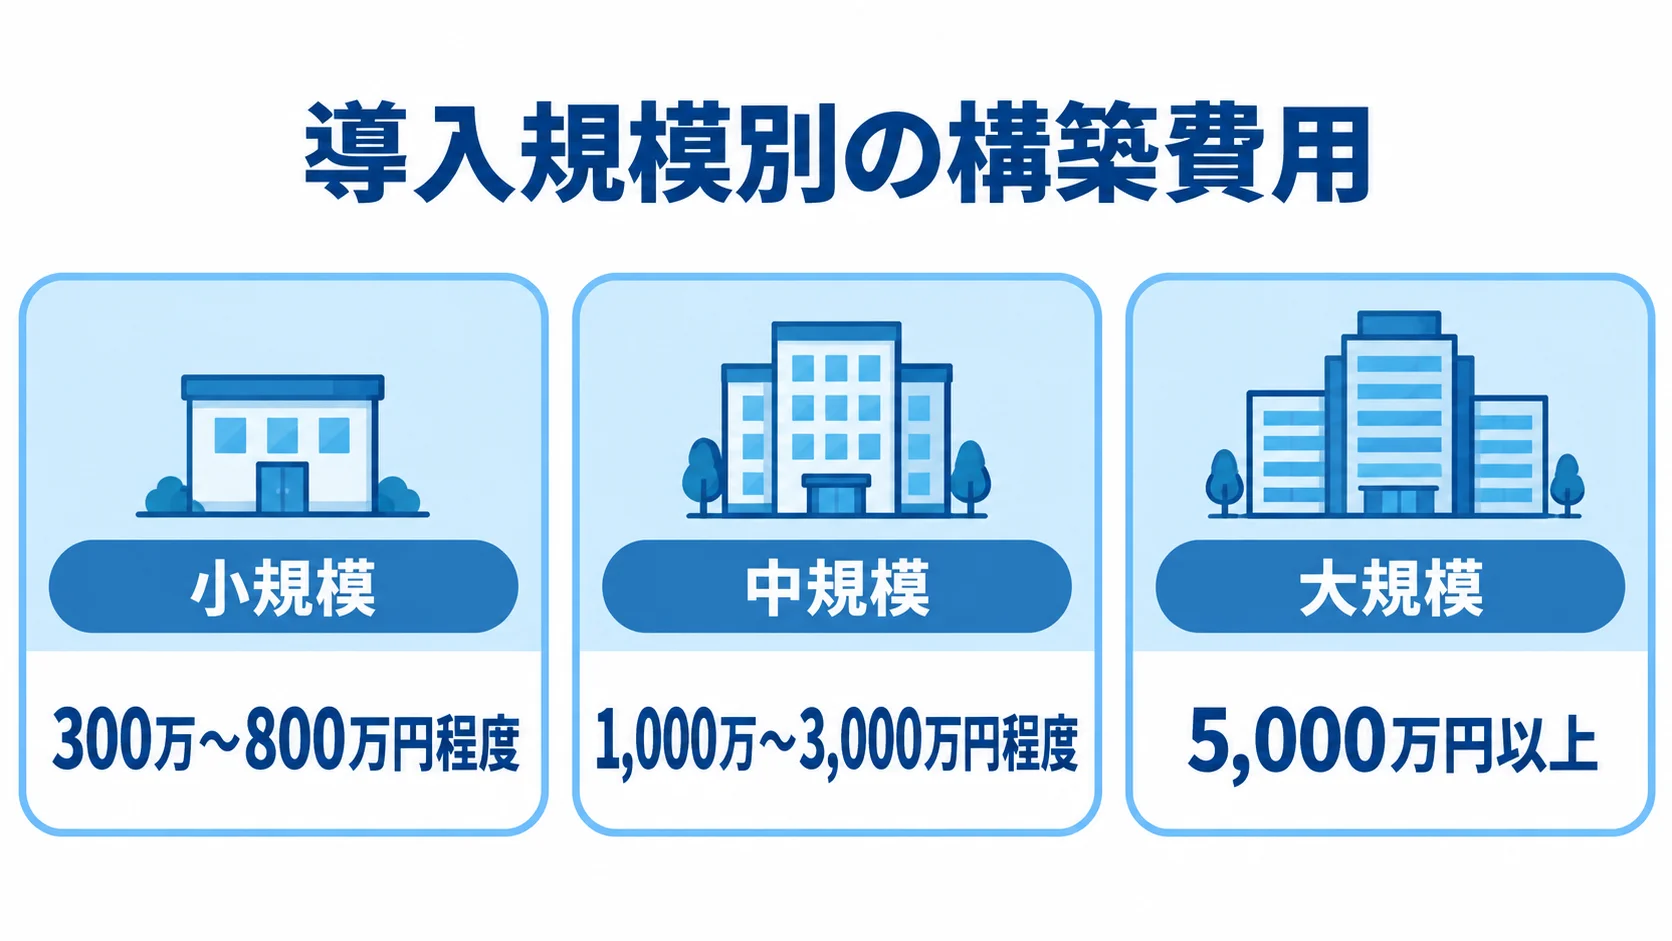
外部のSIerに発注する場合、費用は導入規模によって幅があります。
- 小規模:数名のアナリスト向けの基盤で、300万〜800万円程度です。
- 中規模:ETL・BI・機械学習基盤を含む全社構築の場合、1,000万〜3,000万円程度です。
- 大規模:複数部門・システムを統合する案件では、5,000万円以上になることもあります。
工数の目安は、要件定義・基本設計に20〜30%、詳細設計・開発に40〜50%、テスト・リリースに20〜30%です。社内の人件費を含めると、総コストはさらに増えます。
期間の目安は、小規模で3〜6ヶ月、中規模で6〜12ヶ月です。なお、大規模案件では1年〜2年程度を見込みます。
初期費用以外のランニングコスト
月々の費用は、従量課金の単価と利用時間、クラウド側の費用を合わせて見積もります。
- DBU利用料:クラスタの種類と、Standard・Premium・Enterpriseのプランによって単価が異なります。
- クラウド基盤費:仮想マシン、ストレージ、ネットワークにかかる分で、別途発生します。
- 月額の目安:小規模な開発・検証環境で5万円〜20万円程度、中規模な本番環境で50万円〜200万円程度です。
DBUとクラウド費用の両方がかかるため、初期の見積もりを超えることもあります。
Databricks Commit Units(DBCU)を1年または3年単位で事前に購入すると、従量課金と比べて最大37%削減できるとされています。また、未使用クラスタの自動終了、サーバレス利用、クラスタサイズの調整も、コスト管理の手段になります。
見積もりを取る際のポイント
見積もりの前提がずれたまま発注すると、後から追加費用が発生したり、品質が期待を下回ったりするおそれがあります。そのため見積もりは、価格だけで比べず、支援の質・範囲・実績を合わせて評価します。
要件明確化と仕様書の準備
見積もりの前提をそろえるため、RFPや要件定義書には利用条件を具体的に記載します。
- 目的と成果:何のための案件か、どんな結果を期待するか。
- データ:取り扱う量や種類、発生頻度、接続先。
- 利用者と性能:ユーザーの種類と人数、レスポンスや処理レイテンシの要件。
- セキュリティ:認証方式、アクセス制御、暗号化の要件。
- クラウド:採用する基盤、または選定の基準。
前提が曖昧だと、各社の見積もり条件がばらばらになり、比べにくくなります。そこで、質疑応答の機会を設けて、認識の違いを早めに解消します。
複数社比較と発注先の選び方
複数社の提案を同じ軸で比べると、価格と支援内容の違いが見えてきます。発注前は最低3社から見積もりを取り、資格・実績・支援範囲を同じ条件で比較します。
- 資格と実績:Databricks認定資格を持つエンジニアの数や、類似案件を手がけた経験を見ます。
- 提案内容:技術力、業務理解、アーキテクチャ設計の示し方を比べます。
- 導入後の支援:保守・運用サポートの範囲と費用。
- 体制と価格:プロジェクト管理の進め方を確かめ、極端に安い提案では、範囲や品質面の条件を確認します。
- パートナー体制:Databricksとの正式な契約関係、トレーニングや最新情報の支援。
発注先は、価格だけでなく、必要な支援を含めた費用対効果で選びます。
注意すべきリスクと対策
導入後のトラブルを防ぐため、コスト、保守性、利用定着を並行して見ておきます。
- コスト超過:クラスタ設定や非効率なクエリで費用が増えるおそれがあり、上限アラート、自動終了、定期レビューで備えます。
- 技術的負債:設計が足りないままパイプラインを増やすと保守が難しくなるため、スキーマ管理とデータ品質確認を初期から組み込みます。
- 組織への定着:利用が広がらないと投資対効果は得られないため、トレーニングや社内エバンジェリストの育成に取り組みます。
まとめ
Databricks導入は、ビジネス目標を明確にすることから始めて、段階を追って進めるのが基本です。
要件定義・企画では、「何のためにDatabricksを使うのか」を掘り下げます。設計・開発では、レイクハウスの原則に沿って基盤を構築します。テスト・リリースでは段階的に展開し、リスクを抑えます。
費用面では、Databricks利用費(DBU課金)とインフラ費用の両方を予算に含めます。さらに、コスト管理の仕組みも導入の当初から組み込みます。
見積もりを取る前に、要件を具体化した仕様書を準備しておきます。そのうえで、Databricks認定パートナー企業を中心に複数社から提案を受けると、条件を比べやすくなります。
Databricksはデータ活用とAI活用の基盤になりますが、その力を十分に生かすには、適切なパートナーとともに戦略的に導入を進めることが欠かせません。
▼全体ガイドの記事
・Databricks導入の完全ガイド
関連する検討資料として、次の無料ホワイトペーパーもご覧ください。
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
検討の参考にしてください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。