
Databricks導入は3段階で進みます。最初は要件定義と技術選定を行い、次に設計・構築・テストを進めます。最後が移行と運用開始です。期間は規模によって異なり、小規模で2〜4か月、中規模で4〜9か月、大規模で6〜12か月以上が目安です。
▼全体ガイドの記事
・Databricks導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Databricks導入の開発期間の全体像
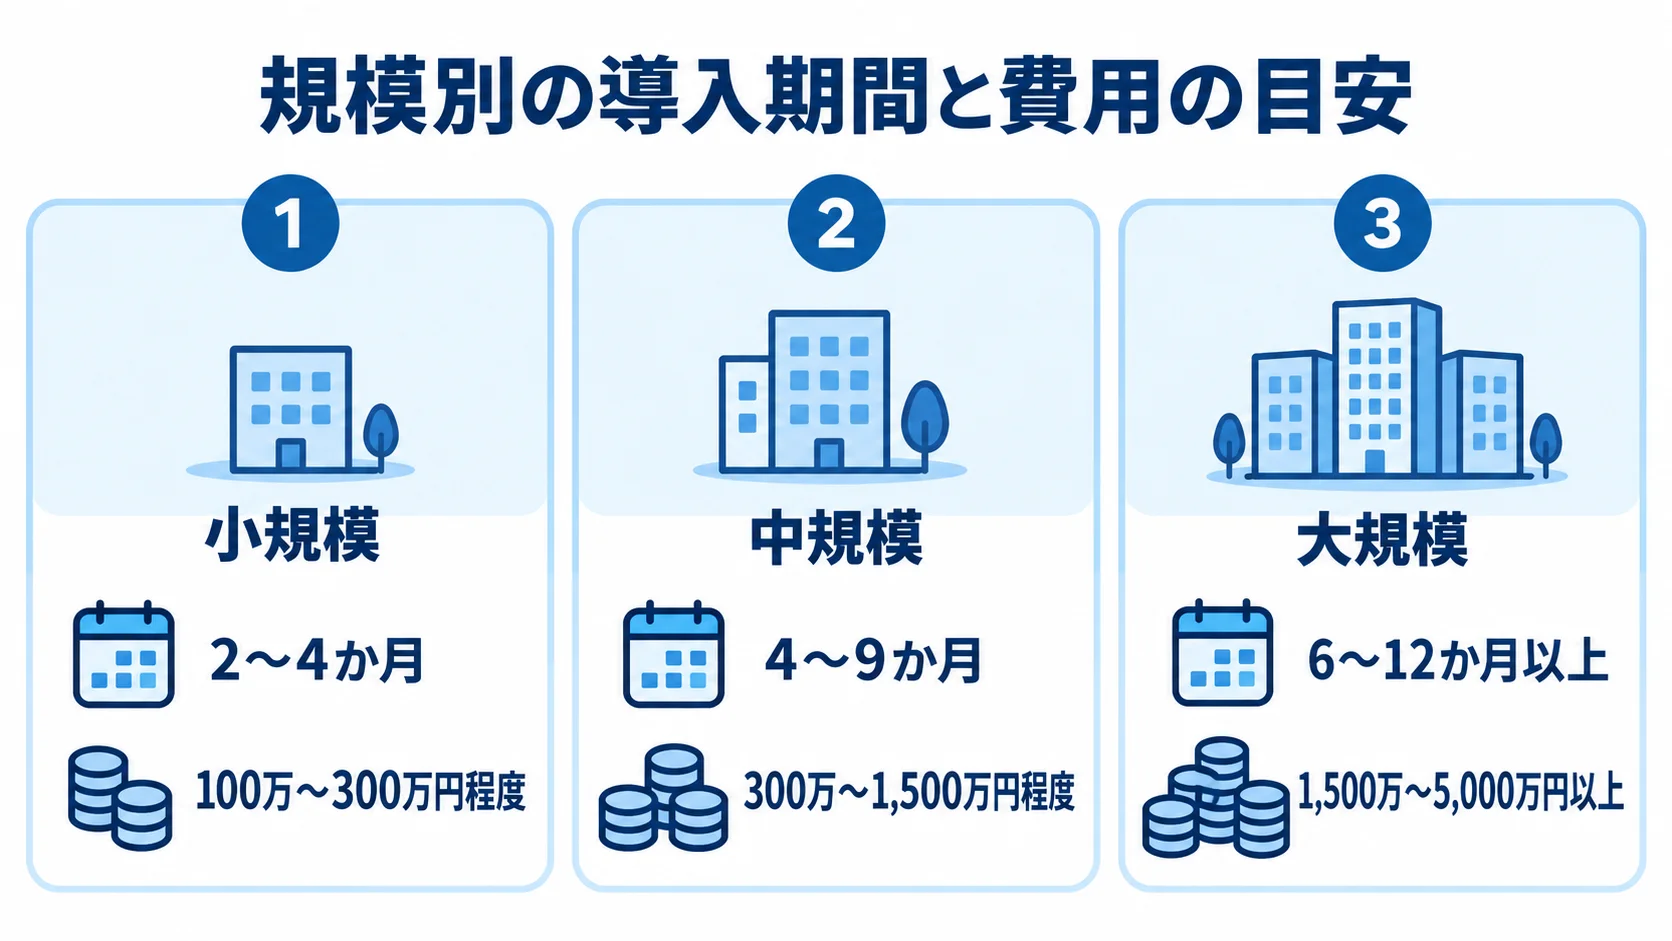
導入期間は、対象データ量、連携する既存システム数、活用の深さによって大きく変動します。活用をBI分析までにとどめるか、機械学習・生成AIまで含めるかによっても、期間は異なります。
規模別の目安を把握することは、現実的な計画の第一歩です。ただし、全社のデータや分析を一度に網羅すると、期間が延び、計画が頓挫することもあります。そのため、事業課題に直結する1〜2のユースケースに絞り、3〜6か月で成果を出すMVP(実用最小限の製品)型が推奨されます。
Databricksは、Apache Sparkの開発者らが創業した企業が提供するレイクハウスプラットフォームです。データレイクの柔軟性とデータウェアハウス(DWH)の分析性能を統合します。従来は、データレイクとDWHを別々に構築し、パイプラインで接続していました。
一方、Databricksは、Delta Lakeというストレージレイヤ上にデータをまとめ、同じ基盤でETL/ELTからBI分析、機械学習(ML)・生成AIまでを扱えます。基盤構築・運用の工数は相対的に小さいため、作業の中心はデータ集約・加工・モデリング・可視化・ML実装になります。この特性が、納期見積もりの前提になります。
規模別の導入期間と費用の目安
規模別の期間と初期費用は、連携対象や機能の範囲によって変わります。ここに示すのは一般的な相場で、実際の費用は要件定義後に個別に算出します。
- 小規模:単一業務システムやSaaSのデータを集約し、限定テーマのダッシュボードを作る場合、2〜4か月、100万〜300万円程度。
- 中規模:複数システムやログを統合し、部門横断KPIや権限管理を備える場合、4〜9か月、300万〜1,500万円程度。
- 大規模:全社基盤に機械学習・生成AIを含める場合、6〜12か月以上、1,500万〜5,000万円以上。
小規模では、サーバーレスやトライアルを使い、ノートブック上の簡易なETLで始められます。中規模では、ブロンズ・シルバー・ゴールドの層で構成するメダリオンアーキテクチャのデータモデルを設計します。
そのうえで、ETL/ELTパイプラインを整備し、複数のダッシュボードを構築します。チームはデータエンジニア・BIエンジニア・PMで組むのが標準です。
大規模では、大量データの性能設計、Unity Catalogによる厳格なガバナンス、段階的な全社展開が必要です。また、見積もりには十分なバッファを含めます。
導入期間を左右する変数
同じ中規模でも、4か月で済む場合と9か月かかる場合があります。その差を生む条件は、見積もりの前に発注側と開発会社で確認しておきます。
- データ品質(最大要因):同じ取引先の別名登録や重複、欠損、形式の不統一が多いと、前処理に数か月かかることがあります。
- 活用の深さ:BIは比較的短期ですが、需要予測・異常検知のMLでは、特徴量作成、学習・評価、精度検証が加わるため長期化します。
- エンジニア体制:PythonやSparkの人材を社内またはパートナーで確保できるかが、立ち上がりを左右する要素です。
- 既存クラウド:AWS・Azure・GCPの利用環境を流用できれば、ネットワークや認証設計の工数を圧縮できます。
Databricksは機械学習に強みを持つ基盤で、初期スコープにどこまで含めるかの線引きも期間を左右します。そこで、データ品質や人材、既存クラウドなどの条件を要件定義で洗い出しておくと、見積もりの精度を高められます。
工程別のスケジュールと期間配分
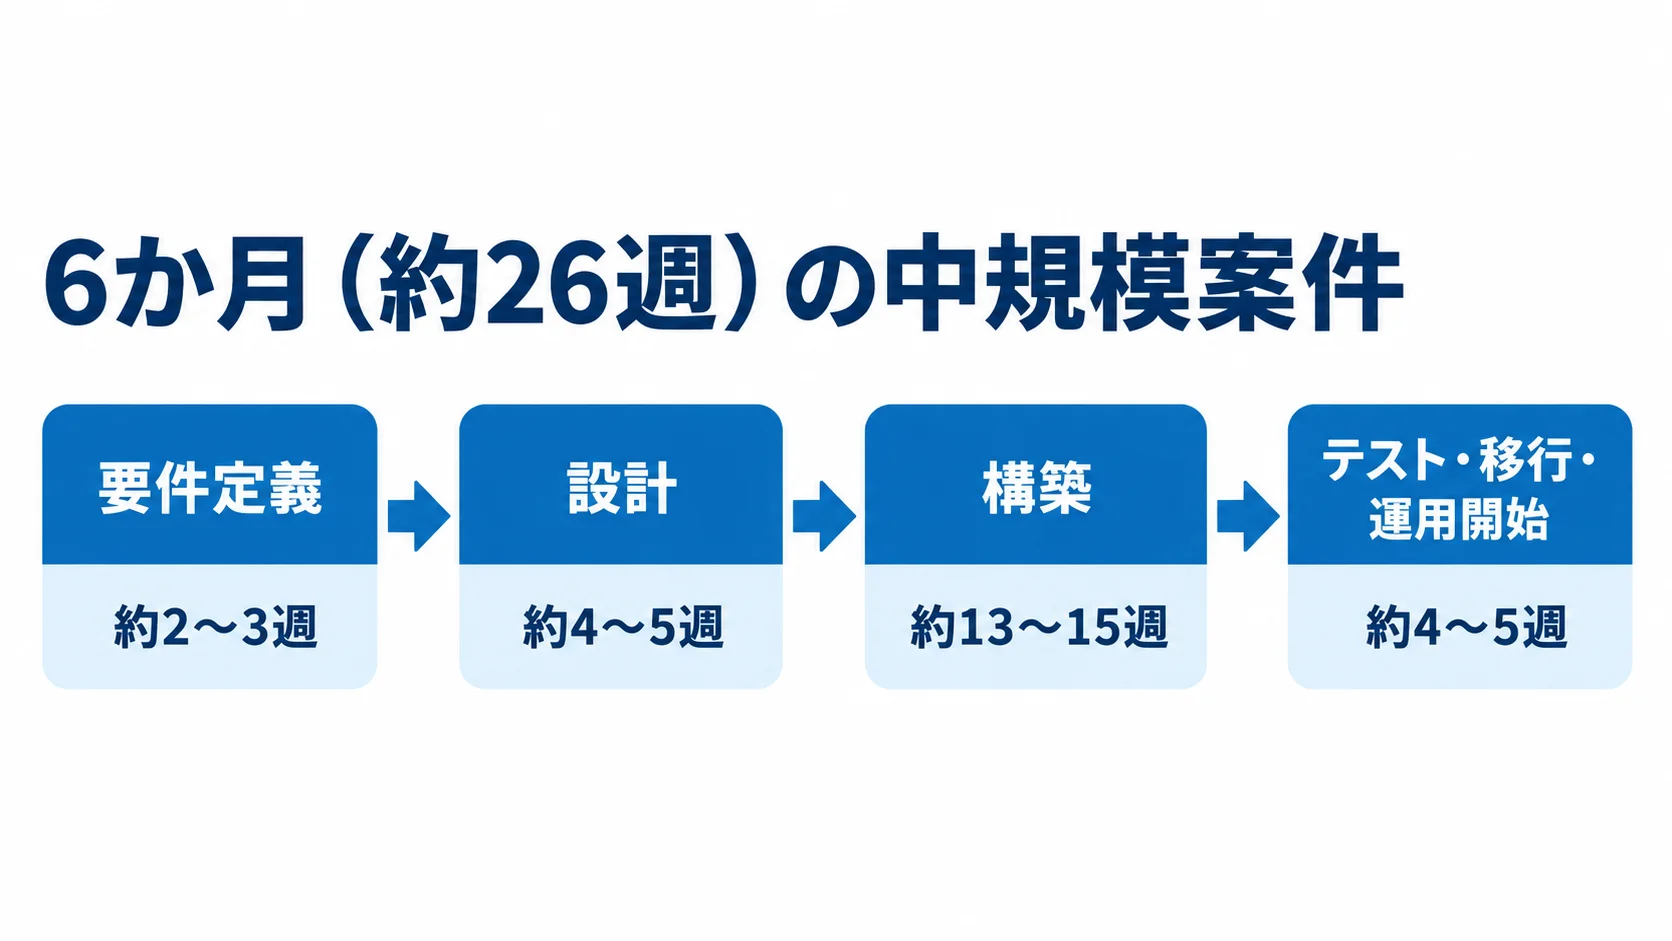
全体は3段階に分けて考えます。最初は要件定義と技術選定、次は設計と構築で、最後にテスト、移行、運用開始を行います。各工程の配分を把握しておくと、現実的な計画を立てやすくなります。
一般的な工数配分では、開発が最も大きな比重を占めます。これはレイクハウス導入プロジェクトの特徴でもあります。
- 要件定義:全体の約10%。
- 設計:全体の約10〜20%。
- 開発:データ加工・集計・ダッシュボード・MLパイプラインを含み、約40〜60%。
- テスト・移行:全体の約10〜20%。
6か月(約26週)の中規模案件では、要件定義に約2〜3週、設計に約4〜5週、構築に約13〜15週、テスト・移行・運用開始に約4〜5週を充てます。
データをブロンズ・シルバー・ゴールドのどの層で加工し、指標やモデルにつなげるかは、早めに決めたい論点です。データ設計とKPI設計は、要件定義と設計で扱う主な論点になります。
上流の判断は、構築工数と成果物の実用性を左右します。そのため、上流に十分な時間を確保することが、納期遵守につながります。
要件定義・技術選定フェーズ(全体の約10%)
要件定義は導入の成否を左右します。そのため、「話題だからDatabricksで作ろう」と技術を先に決めることは避け、事業課題から活用範囲を定めます。
- 活用要件:対象業務のKPI、分析・ML要件、利用者と意思決定、必要データを整理します。
- データ把握:データソース、発生量、更新頻度を洗い出します。
- 基盤選定:既存の利用状況とデータの所在に合わせて、AWS・Azure・GCPから環境を選びます。
- 構成方針:コンピュート種別やDBU消費、Unity Catalogの権限を決め、BIツール、ETL/ELT、ワークスペースやカタログの方針も定めます。
コンピュートは、対話開発用のAll-Purposeを中心に、定期実行ジョブ用やサーバーレスも検討します。検討結果を文書に残しておくことは、後工程の手戻りを防ぐ予防策になります。
この工程の期間の目安は1〜3週間です。BIでは、Databricks SQLのダッシュボード、Tableau、Power BIなどの役割分担も決めます。
設計・構築・テストフェーズ(全体の約60〜80%)
設計・構築・テストは、全体の約60〜80%を占める工程です。中規模の場合は、この工程に18〜22週程度を見込みます。
- 設計:データの層(ブロンズ・シルバー・ゴールド)やテーブル、KPI、ダッシュボードを設計し、Unity Catalogの権限とガバナンスも決めます。
- 構築:ワークスペースやネットワーク・認証の設定に続き、Delta Lakeの初期ロードや差分連携、変換処理、BI接続を実装します。
- ML対応:必要に応じてモデルを構築し、MLflowで実験を管理します。
- テスト:既存帳票との数値検証、想定データ量での性能テスト、権限のアクセス制御テストを行います。
マネージド基盤では、クラスターの用意や拡張、保守をサービス側が担います。そのため、開発チームは加工ロジックとモデリングに集中できます。
構築は2週間〜1か月のスプリントに区切り、成果物を定期的に確認しながらアジャイルに進めます。また、ノートブックやSQL、dbtなどをコードとして管理し、レビューとテストも組み込みます。
Databricksならではの期間に関わる特性
Databricksは、データレイクとDWHを別々にフルスクラッチ構築する場合と比べて、導入を進めやすい基盤です。データ処理・BI・機械学習を一つのレイクハウスに統合し、運用の大部分をマネージド化しているためです。
一方で、レイクハウスや機械学習基盤ならではの要素もあります。期間の見積もりでは、こうした特性も含めて考えます。
マネージド基盤とマルチクラウドによる立ち上げ加速
Databricksはフルマネージドで、AWS・Azure・GCP上で稼働します。これに対して、オンプレミス基盤では、機器の調達に数週間、設定と調整にさらに数週間かかることがありました。
- 環境立ち上げ:ワークスペースを作れば短時間で環境を用意でき、サーバーレスなら試行の開始も速まります。
- 基盤運用:クラスターの起動・停止・自動拡張、メンテナンスをサービス側が担います。
- 試行と検証:サーバーレスは容量を事前に確保せず、必要なときに処理能力を自動で割り当てます。
- 実データ検証:要件定義と並行して、無料トライアルやCommunity Editionで試せます。
- 既存クラウドの活用:利用中のクラウドを選ぶと、ネットワークやID認証の設計を流用できます。
マネージド機能は、インフラの構築や運用にかかる時間を抑えるため、導入までの期間を短くします。
期間を左右するエンジニア体制
Databricks導入では、運用を担うエンジニア体制を確保できるかが大切です。Notebookを中心に使うため、PythonやSparkを扱えるデータサイエンティストやデータエンジニアが必要になります。
SQL中心のSnowflakeやBigQueryは、非エンジニアにも比較的扱いやすいBI向けの基盤です。一方、Databricksは環境構築にも知識が求められます。
- 人材確保:社内に人材がいない場合、採用・育成やパートナー確保に時間がかかります。
- 環境構築:ワークスペースの設計や権限管理にも、一定の知識が必要です。
- 役割の明確化:構築担当と運用の引き継ぎ先を、見積もりの段階で決めておきます。
- 内製化:MLや非構造化データを使うなら、早期にパートナーと内製化の道筋を描きます。
- 目的との適合:BI分析だけが目的なら、Databricksはオーバースペックになる場合があります。
学習コストも踏まえると、遅延や属人化を抑える投資として、体制づくりを早い段階から進めることが大切です。また、活用目的と体制を要件定義でそろえることが、現実的な納期設定につながります。
納期を短縮する具体的な進め方
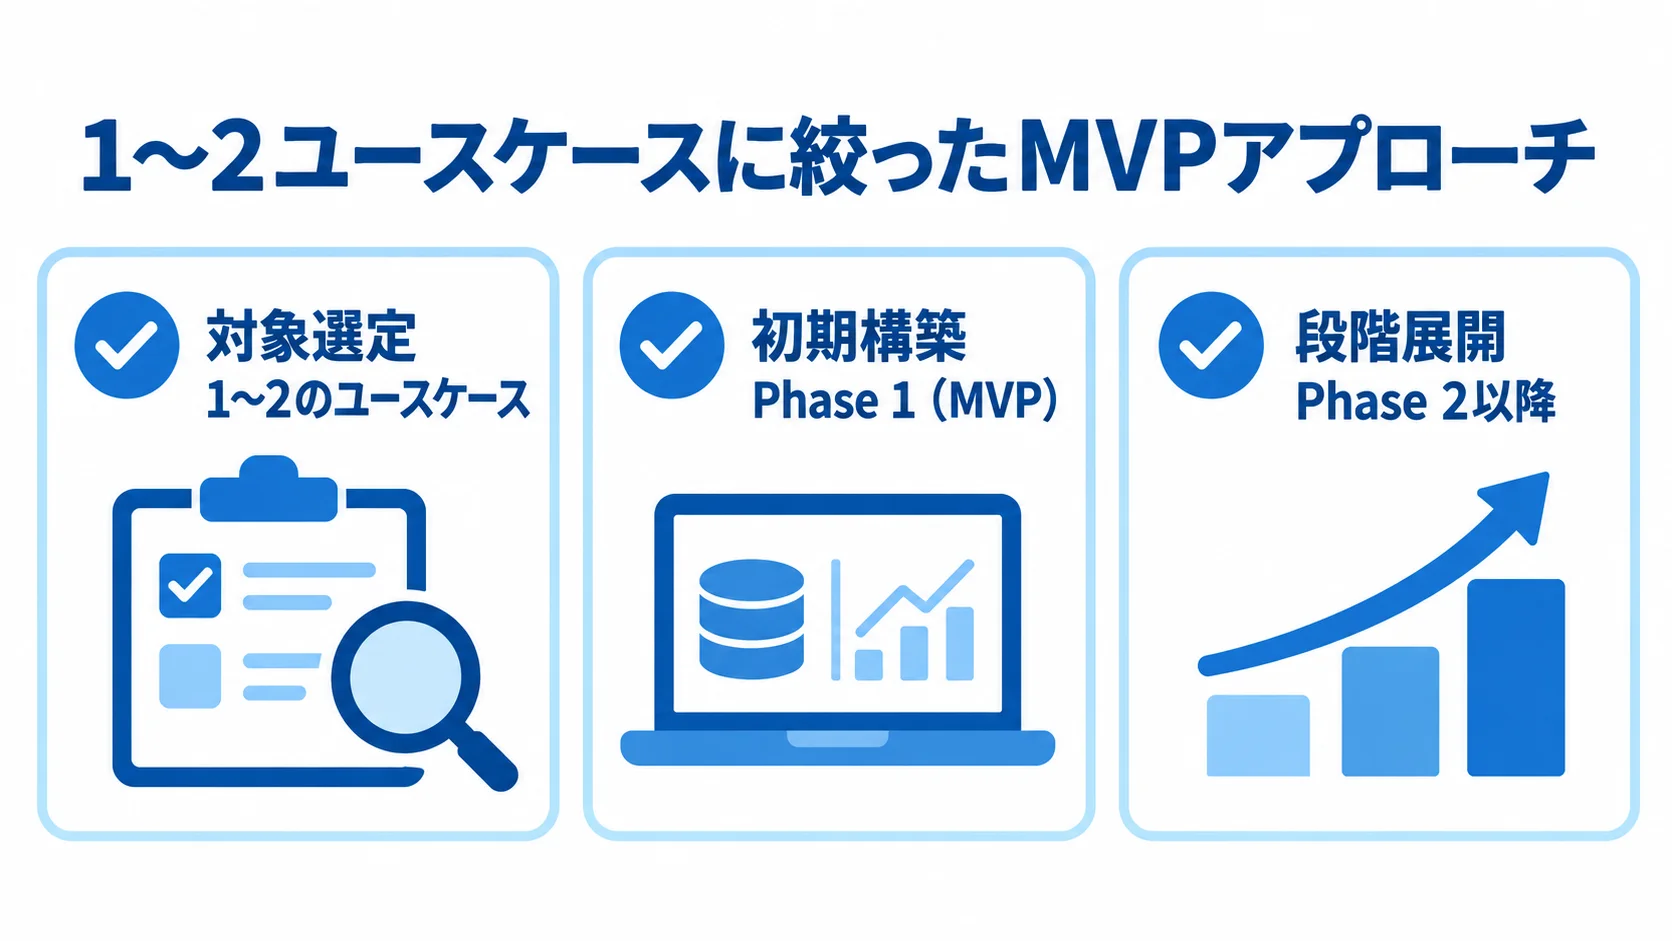
マネージド基盤の利点に加えて、進め方を工夫すると納期をさらに短くできます。その進め方として有効なのが、MVPとアジャイル・スプリントによる段階展開です。
1〜2ユースケースに絞ったMVPアプローチ
最初のリリース範囲を絞ることが、納期短縮に最も効果的です。全社のデータや分析・MLを一度に扱うと、要件や連携先が増えます。さらに、関係者の合意形成にも時間がかかり、本番稼働に届かないおそれがあります。
- 対象選定:成果が出やすく、事業や現場への影響が大きい1〜2のユースケースを選びます。
- 初期構築:Phase 1(MVP)で基盤を整え、月次の売上・粗利を商品・店舗別に見るBIなどを立ち上げます。
- 段階展開:初期はBIを中心にし、需要予測や異常検知などのMLはPhase 2以降に回します。
Databricksは、将来の機械学習や非構造化データの活用にも強い基盤です。対象を絞ると連携データとモデルがシンプルになり、3〜6か月で成果を示せます。最初の成功は、社内の理解や予算を得て、ML活用を進める力にもなります。
アジャイル・スプリントと段階的ロールアウト
要件をすべて固めてから作るウォーターフォール型より、短い反復でデータ活用の実像を確認する進め方が適しています。DatabricksのNotebookは、データを対話的に試しながら開発する進め方と相性がよいためです。
- スプリント:開発を2週間〜1か月単位に区切ります。
- 反復開発:データ取込、加工、ダッシュボードやモデルの提示、フィードバックを繰り返します。
- 早期修正:動く成果物を関係者に見せ、指標定義や分析軸のずれを見つけます。
- 段階展開:まずパイロット部門で運用問題やデータ不整合、DBU消費を確認してから、ほかの部門に広げます。
段階展開は一見すると回り道ですが、リスクとコストを抑えて定着を促します。大きな手戻りや運用トラブルによる遅れを防ぐことで、納期を守りやすくなります。
納期遅延の典型要因と対策
マネージド基盤でも、データ分析プロジェクト特有の遅延リスクはあります。発生頻度の高い2つの要因を把握して対策を立てておくと、計画の破綻を防げます。
データ品質・前処理の見積もり漏れ
元データの品質問題は、最も多い遅延要因です。基盤構築が順調に進んでも、実データを取り込んだ時点で問題が表面化することがあります。
名寄せやクレンジングに数か月かかる場合もあります。「明日から活用できる」と見込んでいても、データ整備が大きな作業として残ることがあります。
- 実データ確認:要件定義の段階でサンプルを調べ、品質の実態を早く把握します。
- 工数見積もり:データが整っていると決めつけず、前処理を計画に含めます。
- 対象を限定:完璧なマスター整備を待たず、優先するユースケースに必要な範囲から整えます。
- 継続改善:メダリオン構成で品質を段階的に高めながら、継続的なクレンジングの体制を設計します。
機械学習まで導入する場合は、学習データの品質がモデル精度を大きく左右し、前処理の比重が高まります。改善は一度で終わらないため、遅延の連鎖を防ぐには、後から手直しする時間も見込んでおくことが大切です。
スコープの拡大と数値検証の工数
もう一つの遅延要因は、スコープが広がることと、数値検証の工数を見込み違えることです。完成が近づくと、指標の追加や別の分析軸、予測モデルの要望が出てきます。要望が続くと、対象データやデータモデルの作り直しが起こります。
- 変更管理:追加要望は影響範囲と工数を見積もり、合意後に扱います。
- Phase 1の維持:追加案はPhase 2以降のバックログに記録し、初回リリースの範囲を守ります。
- 検証期間:集計値を現行帳票や既存システムと照合し、差異の原因を連携・変換処理から切り分けます。
- 事前準備:検証用サンプルデータと期待値を早く用意します。
Databricksは機械学習まで扱えるため、要望が広がりやすい点に注意が必要です。数値検証を後回しにすると、リリース直前に遅延するおそれがあります。
まとめ
Databricks導入の目安は、小規模で2〜4か月、中規模で4〜9か月、大規模で6〜12か月以上です。工程別の配分では、開発が約40〜60%を占め、6か月の中規模案件では設計・構築・テストに18〜22週程度を見込みます。
マネージド基盤と既存クラウドの活用は、構築工数を抑えます。一方で、PythonやSparkを扱う人材の確保が必要です。目的によっては、Databricksが過剰な選択になる場合もあります。
最初は1〜2のユースケースからMVPを始め、2週間〜1か月のスプリントとパイロット展開で段階的に広げます。そうすると、早期の成果と納期管理を両立できます。
実データの確認、追加要望の変更管理、十分な数値検証を計画に含めます。特に、データ品質やスコープ、テスト工数を早い段階で把握することが、納期遵守につながります。
▼全体ガイドの記事
・Databricks導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。