
Databricks導入は、基盤には製品を使い、自社固有の機能をオーダーメイドで開発するのが基本です。基盤まで一から作るフルスクラッチは費用や期間、運用の負担が重く、独自アルゴリズムや機密性の条件がある場合に検討します。
全体像は、Databricks導入の完全ガイドもあわせてご覧ください。
▼全体ガイドの記事
・Databricks導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Databricks導入とフルスクラッチ・オーダーメイドの関係
DatabricksはApache Sparkを基盤とするレイクハウスプラットフォームです。データレイクの柔軟性とデータウェアハウス(DWH)の分析性能を1つの基盤に統合します。BI分析から機械学習・生成AIまで同じ環境で扱えるため、データ活用基盤の中核として採用が広がっています。
一方、フルスクラッチは、既製品に頼らずシステムを一から独自開発する手法です。データ活用基盤では、ストレージ設計や分散処理エンジン、クエリ実行基盤を自前で用意し、ガバナンスの仕組みまですべて作り込むことを意味します。
Databricksなどのレイクハウス基盤やクラウドDWHは、大規模データ処理や可用性の機能に加え、セキュリティやガバナンスの機能も備えています。同等の基盤を自社で開発・維持するには、莫大なコストと専門人材、長い期間が必要です。
そのため、こうした基盤機能をゼロから開発するのは、現代では極めて非現実的です。自作は「車輪の再発明」になり、投資に見合いません。
Databricks導入では、基盤を実績ある製品に任せ、自社固有の価値を生む部分をオーダーメイドで作る形が基本です。
データ基盤の自作が非現実的な理由
データ活用基盤を完全にフルスクラッチで自作するのが非現実的な理由は、技術、費用と期間、運用の3つの面にあります。
- 技術的難易度:大規模データ処理や整合性の実現には、高度な専門性が要ります。
- 費用と期間:開発費は1,000万円から1億円以上、期間は6か月から2年が目安です。
- 運用負荷:障害対応や性能改善、セキュリティ更新を自社で担うことになります。
テラバイトやペタバイト級のデータを高速に処理する分散エンジンや、大量の同時アクセスをさばく仕組みを一から作るのは困難です。さらに、データの整合性を保証する仕組みも欠かせず、その実現には専門性の高いエンジニアを多数要します。一部の巨大IT企業でなければ対応が難しい領域です。
Apache SparkやDelta Lakeは、この領域で長年磨かれてきました。自作で同じ水準を再現しようとすれば、膨大な工数がかかります。
自作した場合は、開発後も専任チームを維持し、運用や保守に継続的な費用をかける必要があります。一方、Databricksのようなマネージドサービスなら、運用をサービス側が担うため、企業はデータ活用に注力できます。
このため、基盤自体は自作せず、実績ある製品を土台にするのが合理的です。
「製品導入+周辺のオーダーメイド」という構図
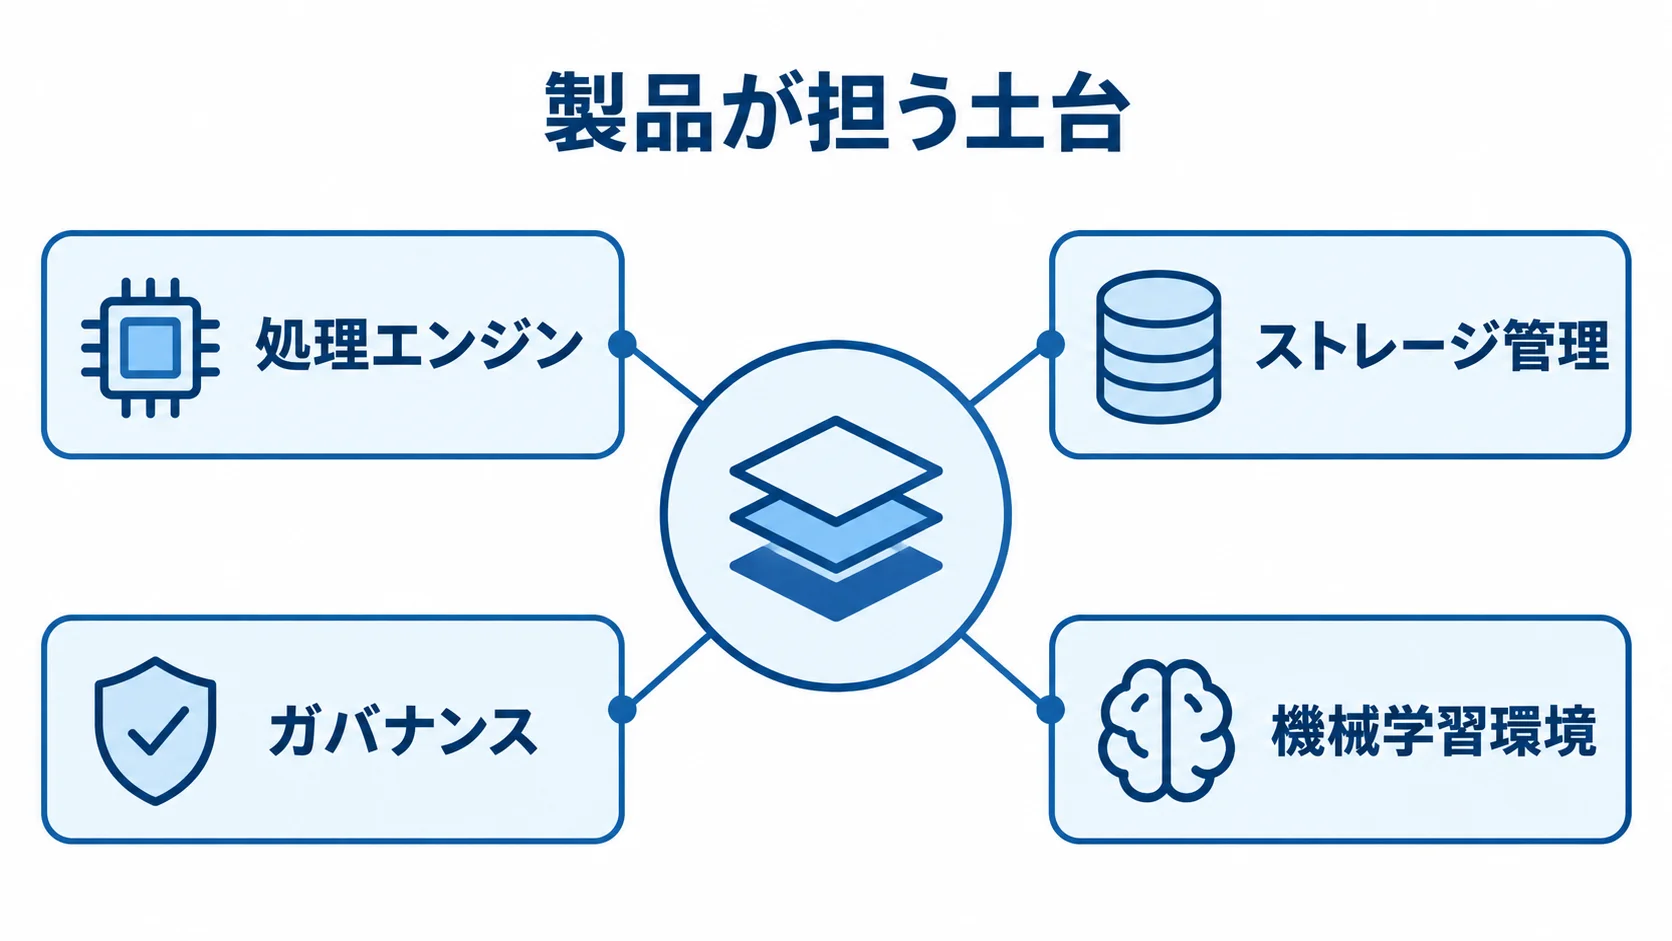
Databricks導入では、基盤の機能を製品で使い、その上に自社固有の機能を開発します。
- 製品が担う土台:処理エンジン、ストレージ管理、ガバナンス、機械学習環境。
- 個別に作る部分:ETL/ELT、データモデル、集計、ダッシュボード、機械学習モデル。
この土台にはDelta LakeやUnity Catalogが含まれます。一方で、各社の業務やデータ構造に依存するパイプラインや分析ロジックは、要件に合わせて設計・実装します。
この役割分担を理解しておくと、製品に任せる範囲と投資を集中する範囲を分けて考えられ、過剰な作り込みを避けられます。
フルスクラッチ・オーダーメイド・SaaSの選択肢比較
データ活用基盤の選択肢には、フルスクラッチのほか、Databricksなどの製品導入とオーダーメイド、API活用、SaaS(パッケージ)があります。費用や期間、カスタマイズ性、運用負荷で比べられます。自社の要件と照らし合わせると、フルスクラッチの位置づけと、現実的な選択肢が見えてきます。
フルスクラッチの特徴とコスト
フルスクラッチは、特徴と負担の両方を知ったうえで、どこまで採用するかを見極めます。
- カスタマイズ性:要件に100%合わせられるため、自由度が最も高い選択肢です。
- 実装範囲:特殊な業務ロジックや独自の分析手法も、制約なく実装できます。
- 費用と期間:費用は1,000万円から1億円以上、期間は6か月から2年が相場です。
- 運用・保守:費用・期間・運用負荷が最も重く、開発後も専任体制が必要です。
- 採用と失敗リスク:強力な選択肢である一方、既製品より費用が何倍にも膨らみ、成果がわずかしか上回らない失敗もあります。
製品導入+オーダーメイド・API活用・SaaS
既製の資産を使う方法は、フルスクラッチに比べてコストと期間を抑えられます。費用、期間、特徴を選択肢ごとに比べると、作り込みの自由度との関係が見えてきます。
- 製品導入+開発:Databricksなどの実績ある基盤の上で、固有のパイプラインや分析・機械学習のロジックを作ります。
- API活用:費用は約200万〜3,000万円、期間は1〜6か月が目安です。
- SaaS:月額数万〜数十万円、導入は即日〜1か月が目安です。
大規模データ処理や機械学習まで見据える場合、製品導入とオーダーメイドの組み合わせが有力です。
APIを使えばモデル開発の工数を大きく圧縮できますが、ベンダーロックインや従量課金による継続費用には注意が要ります。
SaaSは既製の分析・BIサービスをそのまま使うため手軽です。一方で、カスタマイズ性は低く、独自の要件に応えきれない場合があります。
必要なカスタマイズの範囲を絞り込んだうえで、Databricksを中心にAPIやSaaSを部分的に組み合わせると、費用対効果を高めやすくなります。
作り込みの自由度と、コスト、開発スピード、運用負荷はトレードオフの関係にあります。そのため、必要な自由度を見極めて選ぶことになります。
フルスクラッチが正当化される判断基準
フルスクラッチや基盤の一部を作り込む投資は、特定の条件下で正当化される場合があります。判断は、「自社仕様がよさそう」という感覚だけに頼らず、基準に沿って行います。
独自アルゴリズムと機密性という2つの基準
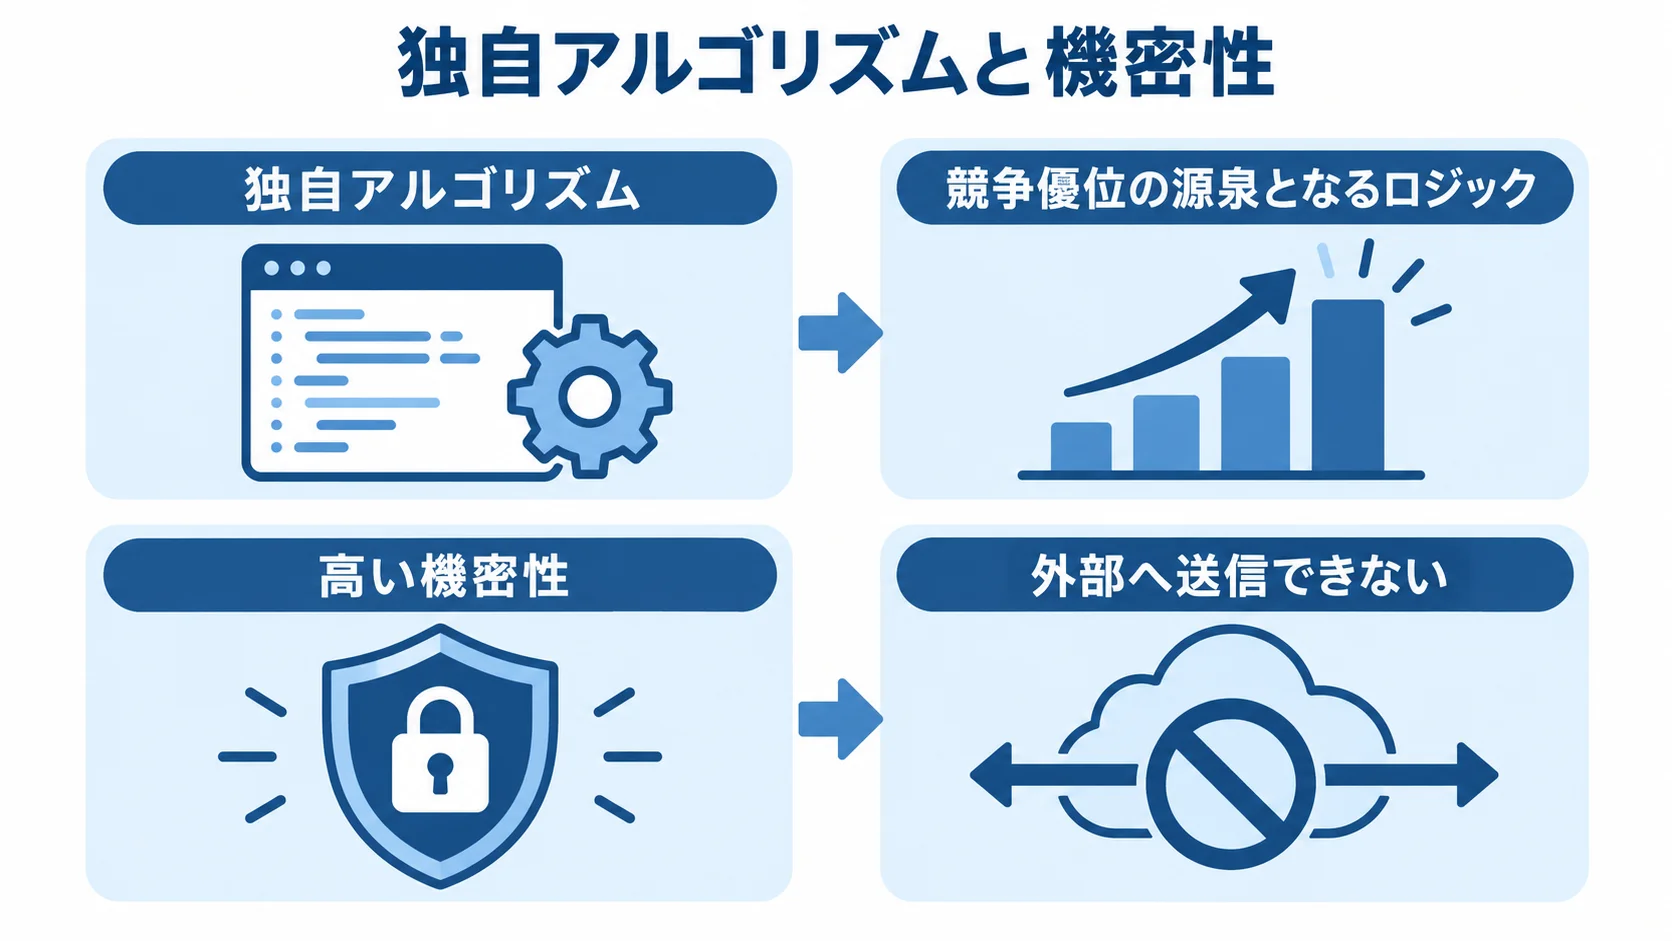
作り込みが正当化されるのは、独自ロジックが競争優位を生む場合と、データを外部へ送信できない場合です。
- 独自アルゴリズム:競争優位の源泉となるロジックを持つ。
- 高い機密性:法規制や契約、漏洩リスクの観点から、外部へ送信できない。
自社独自の需要予測モデルや、事業経験から生まれて最適な形を導くロジックは、収益に直結する場合があります。汎用サービスでは代替できない、事業の知的資産です。
データを自社の管理下から一切出せない場合は、外部SaaSやAPIに頼らない作り込みが必要になることがあります。ただし、どちらの条件でも、基盤全体を自作する必要があるとは限りません。
たとえば、Databricksを自社クラウド環境(VPC)内に閉じて構築し、機密データを外部に出さず、独自ロジックだけを作る方法もあります。まず、自作でなければ実現できないかを基準に照らして検討します。
基準を満たさないフルスクラッチの失敗リスク
基準を満たさない場合、もっとも典型的な失敗は、既製品を使うより費用が何倍にも膨らんでも成果がほぼ変わらないことです。
- 既製品がある汎用領域:自作しても差別化効果はわずかです。
- 運用・保守の負担:見えにくい作業や属人化が総保有コストを押し上げます。
汎用的な分析基盤や、優れた製品がすでにある領域では、投資対効果が悪くなります。たとえば、標準的なBIダッシュボードや一般的なETL処理は、Databricksなどの既製基盤やツールで実現できます。
実際に、汎用機能を自作すると、費用が10倍かかっても得られる価値は1.2倍程度という、割に合わない結果を招く場合があります。具体的には、障害対応や機能改修、担当者の退職による属人化といったリスクが積み重なります。
そのため、作り込みが競争優位や機密要件に直結するかを確かめ、該当しない部分はDatabricksなどの製品に任せるのが賢明です。
Databricks上でのオーダーメイド開発の実際
Databricks導入のオーダーメイド開発では、具体的に何を作り込むのでしょうか。
基盤は製品に任せ、自社固有の価値を生む部分を設計・実装します。作り込む内容は、データ整備のパイプラインと、分析・機械学習・活用の二つに分かれます。
ETL/ELTパイプラインとデータモデルの作り込み
データの取り込みと整備は、Databricks上の開発の中心です。業務システムやSaaSは、データ形式や更新頻度を含めて企業ごとに異なり、個別の設計が欠かせません。
各データソースからDelta Lakeへ集約し、変換して分析可能な形に整えるETL/ELTは、自社環境に合わせて設計・実装します。
- データ抽出:基幹システムやSaaSから情報を取り込む。
- 前処理:名寄せやクレンジングといった整形作業。
- データモデル:メダリオン構造に沿って整える。
メダリオンアーキテクチャでは、ブロンズが生データ、シルバーが整形済みデータ、ゴールドが分析用の集約データです。
層を自社のデータ特性に合わせて設計すると、品質と再利用性が高まり、後の分析やモデル構築がしやすくなります。
実装には、Databricksのノートブックやワークフロー、dbtなどの既存ツールを使えます。処理エンジンやストレージ管理は、自作しなくて済みます。
道具はDatabricksが提供するため、開発会社は自社データをどう流し、どう整えるかという設計とロジックに集中できます。この役割分担があるから、開発を効率よく進められます。
機械学習モデル・ダッシュボード・アプリ連携の作り込み
データ整備のあとに行う分析や業務活用も、オーダーメイド開発の対象です。主な開発内容は、モデル、ダッシュボード、業務システムとの連携に分けられます。
- 機械学習:需要予測、故障予兆検知、異常検知など。
- ダッシュボード:指標を見せる画面。
- アプリ連携:予測や分析結果を既存業務に組み込む。
機械学習基盤としてのDatabricksの強みを活かし、自社の課題に特化したモデルを構築します。
モデルは各社のデータと課題によって変わるため、個別に作り込みます。MLflowで実験を管理しながら開発・評価し、本番パイプラインで継続運用します。
ダッシュボードは、指標の定義や見せ方を自社に合わせ、Databricks SQLや外部BIツールで構築します。
分析や予測を既存システムや社内アプリに連携すると、日々の業務フローのなかで自動的に使えるようになります。たとえば、発注連携や異常検知の通知が、分析を業務改善につなげます。
開発リソースを自社の価値を高める部分に集中させることが、投資対効果の高いデータ活用につながります。
発注・パートナー選定のポイント
Databricksの基盤を製品に任せても、その上の作り込みには専門性が必要です。そのため、実力あるパートナーと適切な条件で組むことが、成否を分けます。
契約形態とスコープの明確化
契約形態は請負と準委任に分かれ、要件の確定度や費用変動の許容度を踏まえて選びます。
- 請負契約:完成まで約束するため、予算を見通しやすい。
- 準委任契約:工数に応じて費用がかかり、仕様を調整しやすい。
請負は、完成責任を負うことに加え、仕様変更で追加費用が生じやすいため、準委任の1.3〜1.5倍程度の費用係数になる傾向があります。一方で、準委任は最終的な費用が変動するリスクがあります。
要件が進行中に明確になるデータ基盤開発では、探索フェーズを準委任、要件確定後の構築フェーズを請負にする方法もあります。
そこで、契約の種類を問わず、開発範囲と前提条件を明確にします。連携するデータソースや分析・モデル、ダッシュボードを具体化しないまま見積もると、各社の前提が異なり、後から追加費用が発生します。
また、仕様変更時の流れも、あらかじめ合意しておきます。影響範囲を調べ、工数を見積もり、承認を得てから実施します。この順に進める変更管理が、予算超過を防ぎます。
パートナー選定で見るべきポイント
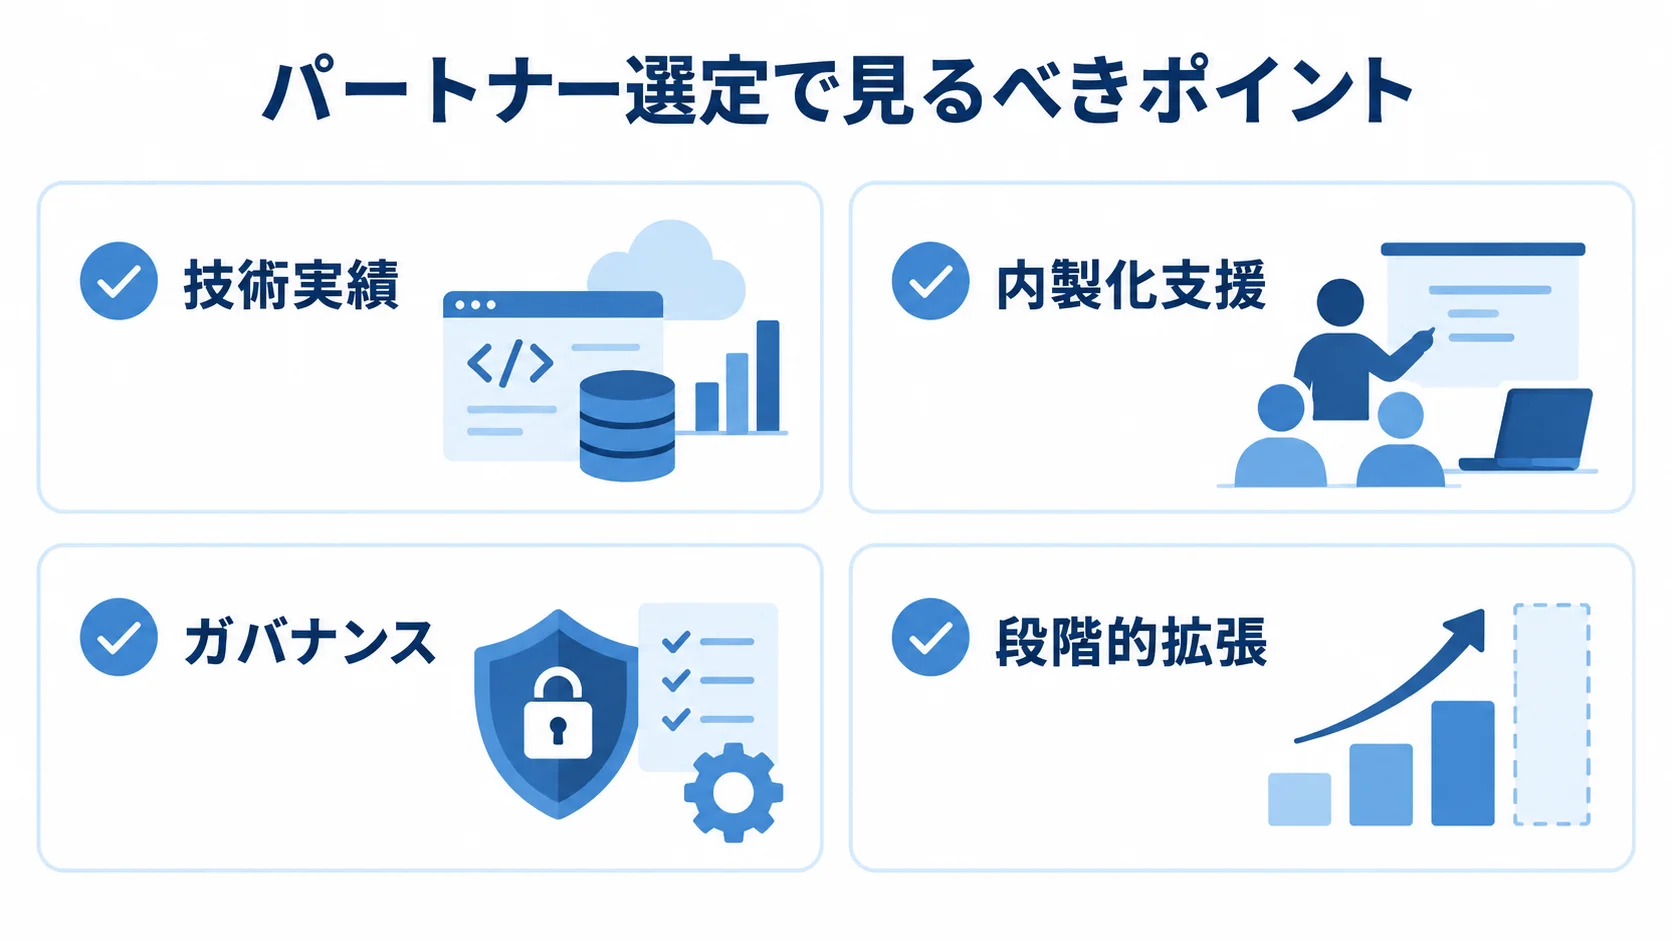
パートナーは、技術実績だけでなく、内製化支援やガバナンス、段階的な導入提案も含めて比べます。
- 技術実績:Databricks、Spark、Delta Lake、Pythonの経験。
- 内製化支援:ノウハウ移転と自社運用の体制づくり。
- ガバナンス:権限、データ来歴、機密情報の設計。
- 段階的拡張:PoCから成果を確かめて広げる計画。
Databricksはエンジニア向けの基盤で、扱える人材が限られます。だからこそ、類似プロジェクトの経験があるかどうかが、開発品質を左右します。
Databricksの運用にはエンジニアが欠かせません。開発を丸投げしたままだと、パートナー依存が続き、属人化やコスト増を招きます。
Unity Catalogを活用したDatabricksの設計経験も確かめます。段階的な拡張計画は、過剰投資を避けるうえで役立ちます。
複数社を比べ、価格や開発力だけでなく、長期的にデータ活用を一緒に育てられる相手を選びます。
まとめ
Databricks導入では、基盤を製品に任せ、自社の価値を生む部分をオーダーメイドで作るのが基本です。
基盤を自作すると、開発費は1,000万〜1億円以上、期間は6か月〜2年に及び、技術面と運用面の負担も大きくなります。
作り込みを検討するのは、独自アルゴリズムが競争優位になる場合や、機密データを外部へ出せない場合です。発注時は、契約形態と範囲を決め、技術実績や内製化支援を備えたパートナーを選びます。
▼全体ガイドの記事
・Databricks導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。