
DatabricksのPoCは、モックアップ、プロトタイプ、PoCの順に検証を重ね、本番投資の可否を判断する取り組みです。
Databricksは、データレイクの柔軟性とDWHの分析性能を併せ持つレイクハウスで、BIから機械学習・生成AIまで扱えます。
▼全体ガイドの記事
・Databricks導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
DatabricksにおけるPoC・プロトタイプの位置づけ
PoC(Proof of Concept、概念実証)は、本格開発の前に、構想の技術的な実現性と業務成果を小規模に検証する取り組みです。要件が曖昧なまま大規模に投資すると、期待した成果が出ずに費用がかさむおそれがあります。PoCは、そうした投資判断の誤りを防ぐフィルターです。
データ活用では、技術的に動くことと業務で使える成果が出ることが一致するとは限りません。分析基盤が正しく動いても、結果が現場の意思決定に役立たなければ意味がありません。そのため、業務成果の見込みまで確かめる必要があります。
Databricksは無料トライアルやサーバーレスを使えるため、小さくPoCを始めやすい基盤です。
検証の焦点は段階ごとに異なるため、確かめたい内容に合わせて段階を選びます。
PoCで検証すべき2つの論点
DatabricksのPoCでは、技術面と業務面の両方から実用性を判断します。
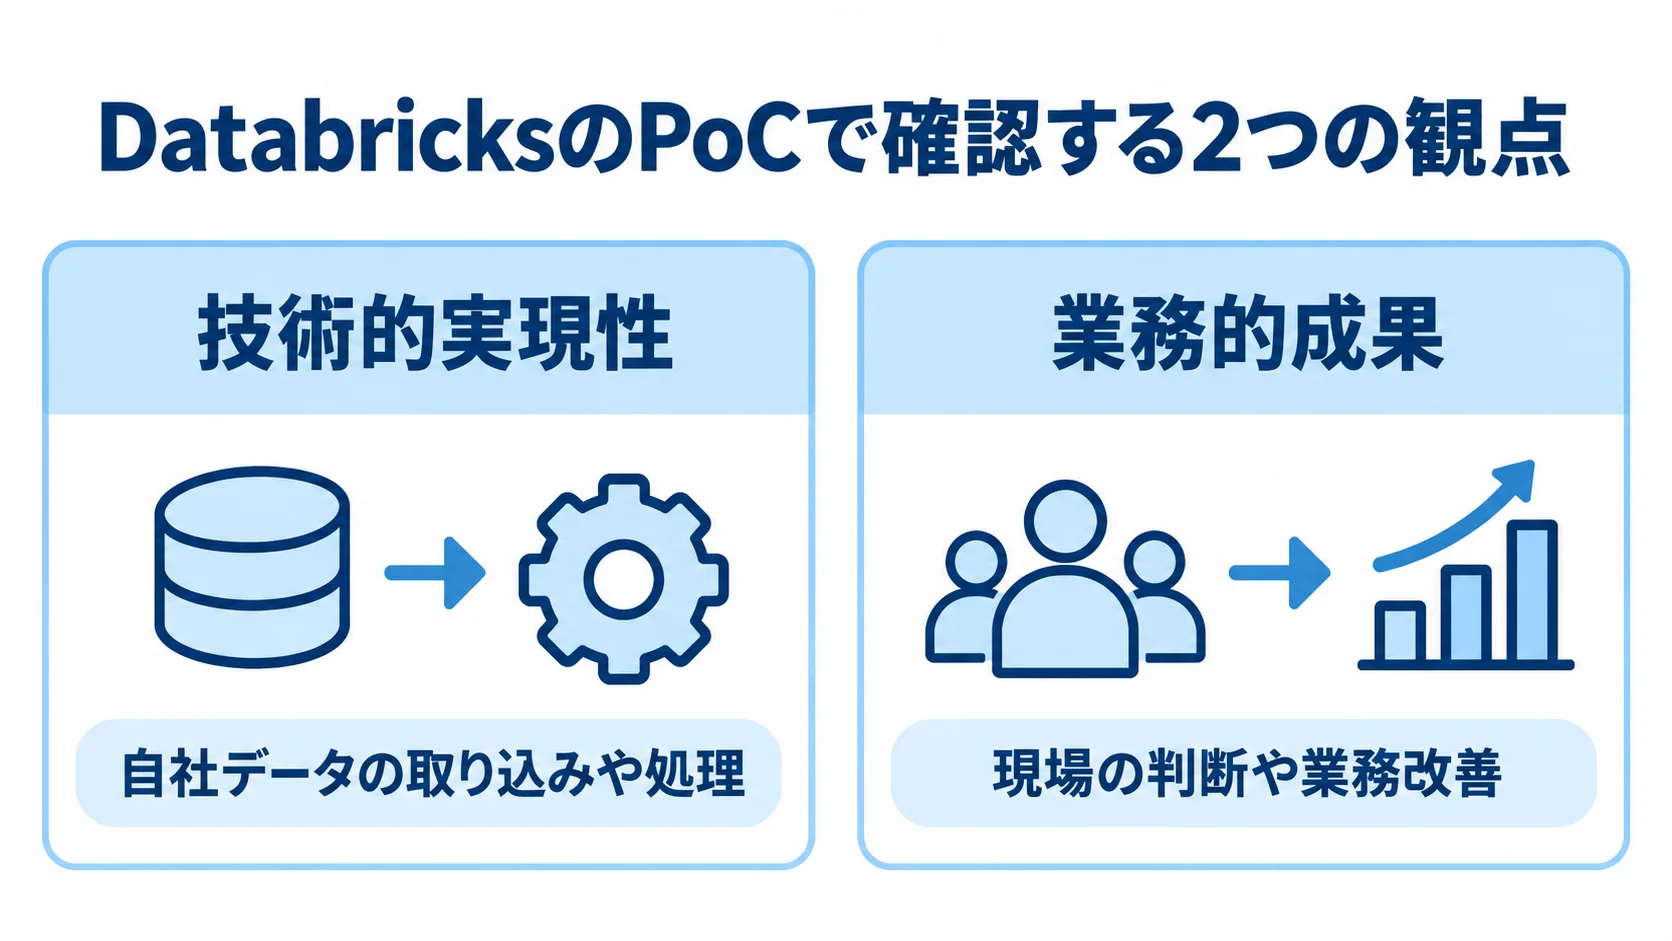
- 技術的実現性:自社データの取り込みや処理、分析・モデルの実行、既存システムとの連携が成り立つかを確かめます。
- 業務的成果:分析結果が現場の判断や業務改善に役立つかを測ります。
技術面では、Delta Lakeへの取り込みや想定データ量の処理時間・コストも確認します。特に、大規模処理や機械学習に強いDatabricksでは、需要予測や異常検知のモデルを自社データで一定の精度にできるかが中心です。
業務面では、予測精度が実用に耐えるか、ダッシュボードの指標が判断を変えるか、手作業の集計をどれだけ減らせるかを測ります。
技術検証に偏ると「動いたが使えない」結果になりがちです。そこで、計画の段階で業務成果の測り方も決めておきます。
PoC・プロトタイプ・モックアップの違い
3つは検証の対象と作り込みの度合いが違うため、確かめたい内容に応じて使い分けます。
- モックアップ:最も簡易な段階で、データや処理を伴わずに画面の見た目を示し、指標や配置の認識をそろえます。
- プロトタイプ:一部データで動く試作を作り、操作感や処理の流れを確かめます。
- PoC:実データに近いデータを使い、技術面と業務成果の実現可能性を定量的に評価します。
たとえば、Databricksではプロトタイプに少量のサンプルデータを取り込み、集計や可視化、初歩的なモデルを動かせます。
実務では、モックアップで完成像を合意し、プロトタイプで操作感を確かめてから、PoCで本番投資の可否を判断します。目的を混同せず、いまどの段階で何を確かめるのかを明確にしておくと、無駄の少ない検証につながります。
DatabricksでPoCを始めるメリットと進め方
DatabricksはPoCを始めるハードルが比較的低い基盤です。マネージドなクラウドサービスのため、短時間で分析環境を立ち上げられます。
PoCを始める際に押さえたいのは、立ち上げを軽くする工夫と、検証の範囲を絞る設計の2点です。
トライアル・サーバーレス・ノートブックによるスモールスタート
立ち上げが速く、初期投資も小さく抑えられることが、DatabricksでPoCを始める利点です。さらに、機能を試しながら仮説検証を重ねられます。
- 無料トライアル・Community Edition:本格契約前に基本機能を試せます。
- サーバーレス:必要なときだけ処理能力を使い、断続的な検証を進められます。
- ノートブック:コードを対話的に実行し、データの集計やモデル構築を行えます。
無料トライアルなどを使えば、契約前に大きなコストをかけずに、基本機能の手触りを確認できます。手軽に試せる環境がそろうと、大きな投資をする前に、実際の操作と結果を確かめられます。
クラスター規模を事前に見積もらずに済むため、検証の規模がまだ読めない段階でも進めやすくなります。PoCの利用が断続的でも無駄を抑えられる点も、サーバーレスの利点です。
Python・SQL・Sparkが使えるため、少量データであれば、その場で集計や可視化を試せます。
「書いてすぐ結果を見る」反復はPoCと相性が良く、仮説を立てては確かめるサイクルを速めます。
PoCで作ったノートブックやDelta Lakeのテーブルは、本番構築の土台に引き継げます。そのため、成功後の本番移行にも役立ちます。
成果につながるPoCのスコープ設計
検証の範囲を絞ることが、PoCの成否を左右します。Databricksでできることを一通り試そうとすると、検証が発散し、期間と費用が膨らんで、結論も見えにくくなります。
- ユースケース:事業課題に直結し、成果を測りやすい1〜2件に絞ります。
- 成功基準:予測精度80%以上や集計工数を月40時間削減など、定量基準を決めます。
テーマの例としては、過去データを使った特定商品の需要予測や、取引データからの異常検知が挙げられます。
経営や現場への影響がはっきりしたテーマを選ぶと、必要なデータソースと論点を限定できます。
対象を絞れば、短期間で結論を出しやすくなります。また、先に決めた成功基準と照らし合わせれば、結果を客観的に評価して本番投資を判断できます。
狭く深く、成果に直結するテーマで検証することが、本番につながるスコープ設計の要点です。
PoCの費用と期間の目安
PoCは本番導入より小さな投資ですが、予算と期間の目安がないと、社内承認やパートナーとの合意を進めにくくなります。
DatabricksのPoCの費用と期間には一般的な目安があり、その内訳も確認しておきます。
費用と期間の相場
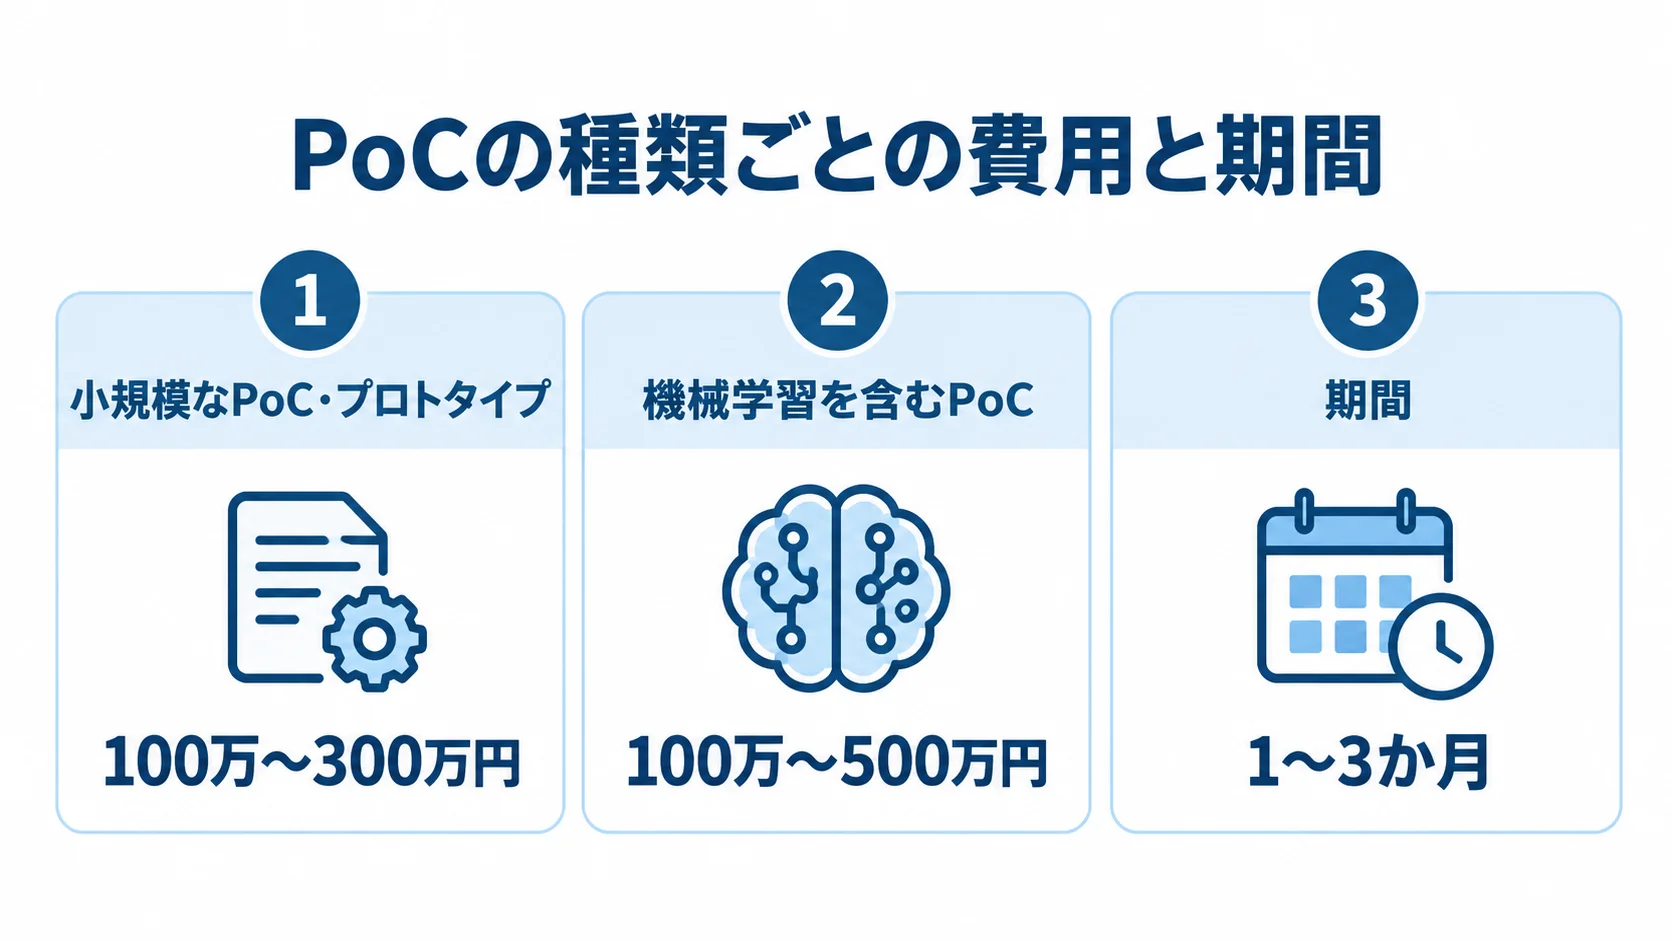
PoCの費用は、単一データの小規模な型と機械学習を含む型で上限が異なります。
- 小規模なPoC・プロトタイプ:単一データソースの連携と基本集計・簡易可視化で、100万〜300万円、1〜3か月です。
- 機械学習を含むPoC:需要予測や異常検知の検証で、100万〜500万円、期間は同じく1〜3か月です。
機械学習では、学習と評価の計算資源や精度向上の試行に工数がかかります。
生成AIではさらに、API利用料やGPUリソースも加わります。
PoCは3か月以内に結論を出す計画が目安です。期間が延びるほど、本番に至らず終わる確率が高まります。
金額と期間は、あくまで目安です。データの状態や検証内容によって変わるため、スコープを固めてから見積もります。
PoC費用の内訳
PoC費用の大部分は人件費です。データ量と処理量が限られるため、基盤の利用料は比較的少額に抑えられます。
- データ準備:検証用データの収集と整備にかかる工数
- 分析・モデリング:ノートブックで分析ロジックやモデルを作る工数
- 評価・合意形成:結果の業務的な意味を読み解き、関係者に説明して次の段階を合意する工数
DatabricksのDBUやクラウド基盤の費用は、サーバーレスや自動停止を使うと抑えやすくなります。
前処理では、表記ゆれや欠損への対応が必要になり、PoCでも想定以上に時間がかかる場合があります。
予算は、コンピュート費用よりも人件費を中心に見積もります。まずモックアップで完成像を合意し、プロトタイプで小さく動かしてからPoCに進めば、無駄な手戻りを減らせます。
「PoC死」を防ぐ進め方
PoC死とは、検証が終わっても本番導入に進まず、立ち消えになる状態です。時間と費用をかけても、投資を回収できなくなります。
データ活用のPoCでは、一定の割合が本番に至らず放棄されるとも言われます。対策として押さえたいのは、範囲・基準・期間の決め方と、本番移行の設計の2点です。
スコープ限定・定量的な成功基準・短期集中
範囲、成功基準、期限をあらかじめ定めておくと、判断の先送りを防げます。
- 範囲:検証は1〜2のユースケースに限定します。
- 成功基準:予測精度80%以上、ROIが2倍以上、または特定業務の工数半減などを合意します。
- 期限:3か月以内に結論を出す計画にします。
基準が曖昧だと「なんとなく良さそう」で終わり、本番投資を決められません。そのため、誰が見ても判断できる基準が必要です。
一般に、3か月以内に区切ると本番移行に至る確率が高く、6か月を超えると進む確率が大きく下がるとされます。長期化すると目的が曖昧になり、関係者の熱量も下がって、立ち消えになりがちです。
「いつまでに」「何を満たせば」次に進むのかを書き出しておき、期限を区切って集中的に検証します。
本番データ検証と本番移行を見据えた設計
PoCの初期から本番を見据えると、検証結果を移行判断へつなげられます。
- 本番に近いデータ:汚れや偏りを含む実データで検証します。
- 引き継げる成果物:使い捨てにせず、本番構築に活用できる形で作ります。
- 移行の見通し:本番の概算費用・期間・体制・運用イメージも示せるようにします。
きれいな小規模データでは成功しても、本番の生データでは通用しない場合があります。
目安として、PoC予算の一定割合、たとえば2割程度を本番相当データの検証に充てると、移行時の想定外を減らせます。
Databricksでは、Delta Lakeでデータを管理し、Unity Catalogの権限やガバナンスを意識しておくと、本番で拡張しやすくなります。
本番移行後の費用や体制も示せると、経営層が投資判断を下す材料になります。
Databricks特有のPoC留意点
データ分析基盤に共通する進め方に加えて、Databricksの特性に応じた留意点もあります。PoCを通じて、自社に合う基盤かどうかも判断できます。
Databricksがオーバースペックになるケースの見極め
PoCでは、Databricksが用途に対して過剰でないかも見極めます。強みと運用条件の両方を考え合わせて判断します。
- Databricksが向く用途:大規模データ処理、機械学習、非構造化データ活用を検討します。
- 軽量な選択肢:単純なBI集計ならBigQuery、Snowflake、Redshiftなども比較します。
Databricksを運用するには、Notebook形式でPythonやSparkを扱えるエンジニアが必要で、学習コストも相対的に高くなります。
データ量が大きくなく、目的がBI集計や表示だけなら、Databricksは過剰になりかねません。SQL中心で非エンジニアにも扱いやすいBigQueryやSnowflake、コストを見通しやすいRedshiftで十分な場合もあります。
データ量が少なく、複雑な非構造化データも扱わない初期段階では、Amazon RDSなどのRDBから始める方法が合理的な場合もあります。そのため、機械学習や大規模処理、非構造化データが必要かを確認し、必要に応じて軽量な基盤も比較します。
基盤の選定そのものをPoCで確かめることも、見落とせない観点です。
PoCからスケールさせる前提での設計
Databricksを選ぶ理由が将来の機械学習や生成AI、非構造化データ活用にあるなら、PoCの段階から拡張を見据えます。
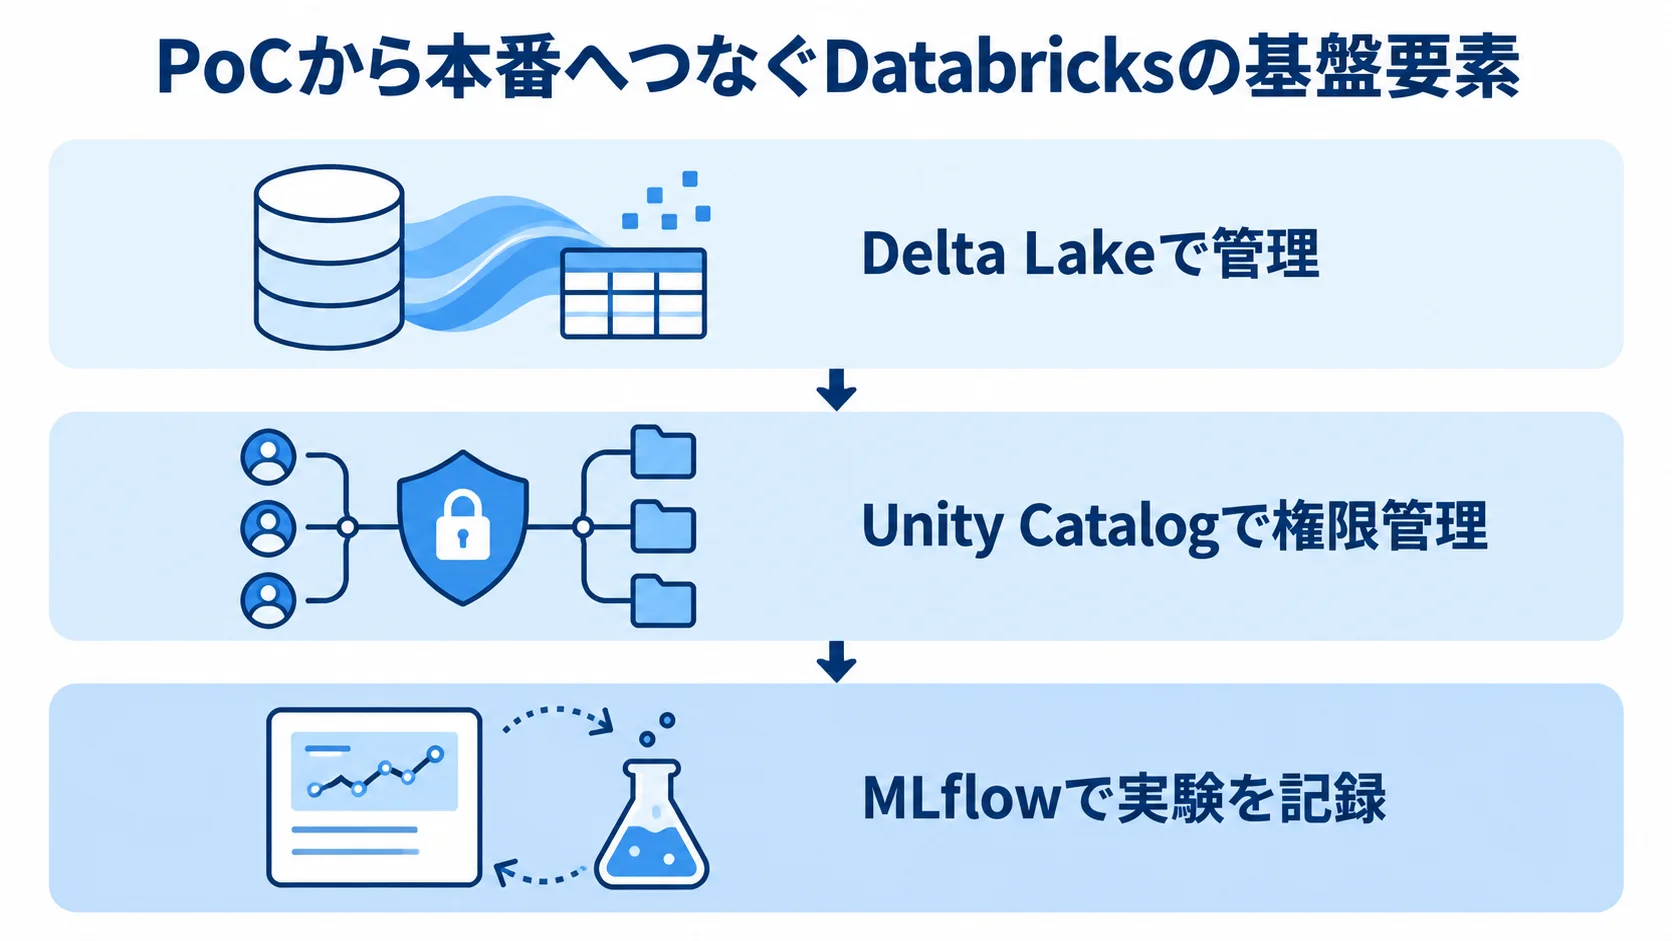
- データ基盤:Delta Lakeで管理し、ブロンズ・シルバー・ゴールドの層を意識します。
- ガバナンス:Unity Catalogで権限管理とデータの来歴追跡を考慮します。
- 機械学習:MLflowで実験を記録し、MLOpsへの移行に備えます。
データを層構造で整えると、本番で分析や機械学習の用途が増えても再利用しやすくなります。
利用者や用途が広がったときに、アクセス権の管理やデータの流れをたどる作業で困りにくくなります。
実験の履歴が残っていると、本番でモデルを継続的に改善・運用するMLOpsへ移りやすくなります。
PoCは、レイクハウスを本格的に活用するための第一歩です。拡張を見据えた土台が投資効果を高めます。
ただし、オーバースペックのリスクもあります。必要な範囲を見極め、段階的に育てることが大切です。
まとめ
DatabricksのPoCは、本格投資の前に技術的実現性と業務成果を検証し、投資判断の精度を高める取り組みです。
無料トライアル、サーバーレス、ノートブックを使えば、実データで小さく試せます。また、成果物を本番の土台に引き継げます。
1〜2のユースケースに絞り、定量基準を設けて3か月以内に結論を出します。加えて、本番相当のデータと移行計画も用意します。
費用は小規模で100万〜300万円、機械学習を含む場合は100万〜500万円です。
期間はいずれも1〜3か月で、人件費が大部分を占めます。
単純なBI分析には過剰な場合があるため、自社に適した基盤かを検証します。一方で、機械学習や非構造化データ活用への拡張には、Delta LakeやUnity Catalogを意識します。
小さな検証から始め、自社のデータ活用に合う次の一歩を見極めます。
▼全体ガイドの記事
・Databricks導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。