
社内の売上・在庫・顧客・広告データを一つの環境に取り込むQlik Sense導入は、規模によって期間が変わります。小規模は1〜3ヶ月、中規模は3〜6ヶ月、大規模は6〜12ヶ月が目安です。
進め方は、要件定義とKPI設計、モデル構築、テスト・定着の順です。期間の目安と進め方を知っておくと、導入計画や開発先選びの判断に役立ちます。
▼全体ガイドの記事
・Qlik Sense導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Qlik Sense導入とアソシエイティブエンジンの全体像
Qlik Senseは、Qlik社がガイド型分析ツール「QlikView」の後継として開発したBI・データ分析プラットフォームです。利用者が自らデータを探索するセルフサービスを、企業の統制が効いた形で提供します。
導入期間を見積もるには、他のBIツールとの違いを理解することが大切です。その違いの中核にあるのが、Qlik Sense独自のアソシエイティブエンジン(連想エンジン)です。
このエンジンは全データをメモリ上(インメモリ)に保持し、テーブル間の関連を全方向に保ったまま計算します。利用者が選択すると、データセット全体の関連性が瞬時に再計算されます。
アソシエイティブエンジンが実現する自由な多次元探索
Qlik Senseのアソシエイティブエンジンは、探索の経路を事前に決めずに多次元で探索できる仕組みです。中でも象徴的な機能が、「グリーン・ホワイト・グレー」の選択モデルです。
- 選択値:利用者が選んだ値(緑)
- 関連する値:選択値とつながる値(白)
- 関連しない値:選択値とつながらない値(グレー)
選択するとデータセット全体の関連性が瞬時に再計算され、関連するデータと関連しないデータの両方が画面に浮かび上がります。一方で、Power BI、Tableau、Looker、Domoなどは、事前に定義したクエリやドリルダウン経路、階層に沿って分析します。たとえば、設計者が地域、支店、担当者の順に掘り下げる道筋を用意し、利用者はその経路をたどります。
クエリに含めなかったデータは画面に現れず、分析者が気づかないうちに盲点になることがあります。これに対し、Qlik Senseは非関連データも示し、関連データの発見と非関連データへの気づきを促します。この自動発見と気づきが、可視化ツールとの違いです。この特性は、スケジュール設計にも影響します。
スケジュールを左右するデータ整備とアソシエイティブモデル設計
キューブや全ドリルダウン経路を事前に作り込む必要がない点で、従来型BIとは分析設計の性格が異なります。とはいえ、設計の工数がなくなるわけではなく、データロードスクリプトを通じてアソシエイティブなモデルを組み立てます。
- 関連づけ:複数テーブルを結ぶキー項目の設計
- モデル品質:合成キーや循環参照の回避
- データ整備:散在データの収集、クレンジング、統合
モデル設計の品質は、その後の探索体験と処理性能を大きく左右します。設計工数は画面の見た目より、モデルの設計・実装に比重が移ります。エンジンの速さと、導入全体の完了速度は別物です。この理解が、現実的な工程計画の出発点です。
遅延の多くはツール操作ではなく、データ整備やKPI定義の詰めの甘さから生じます。
規模別のQlik Sense導入期間の目安
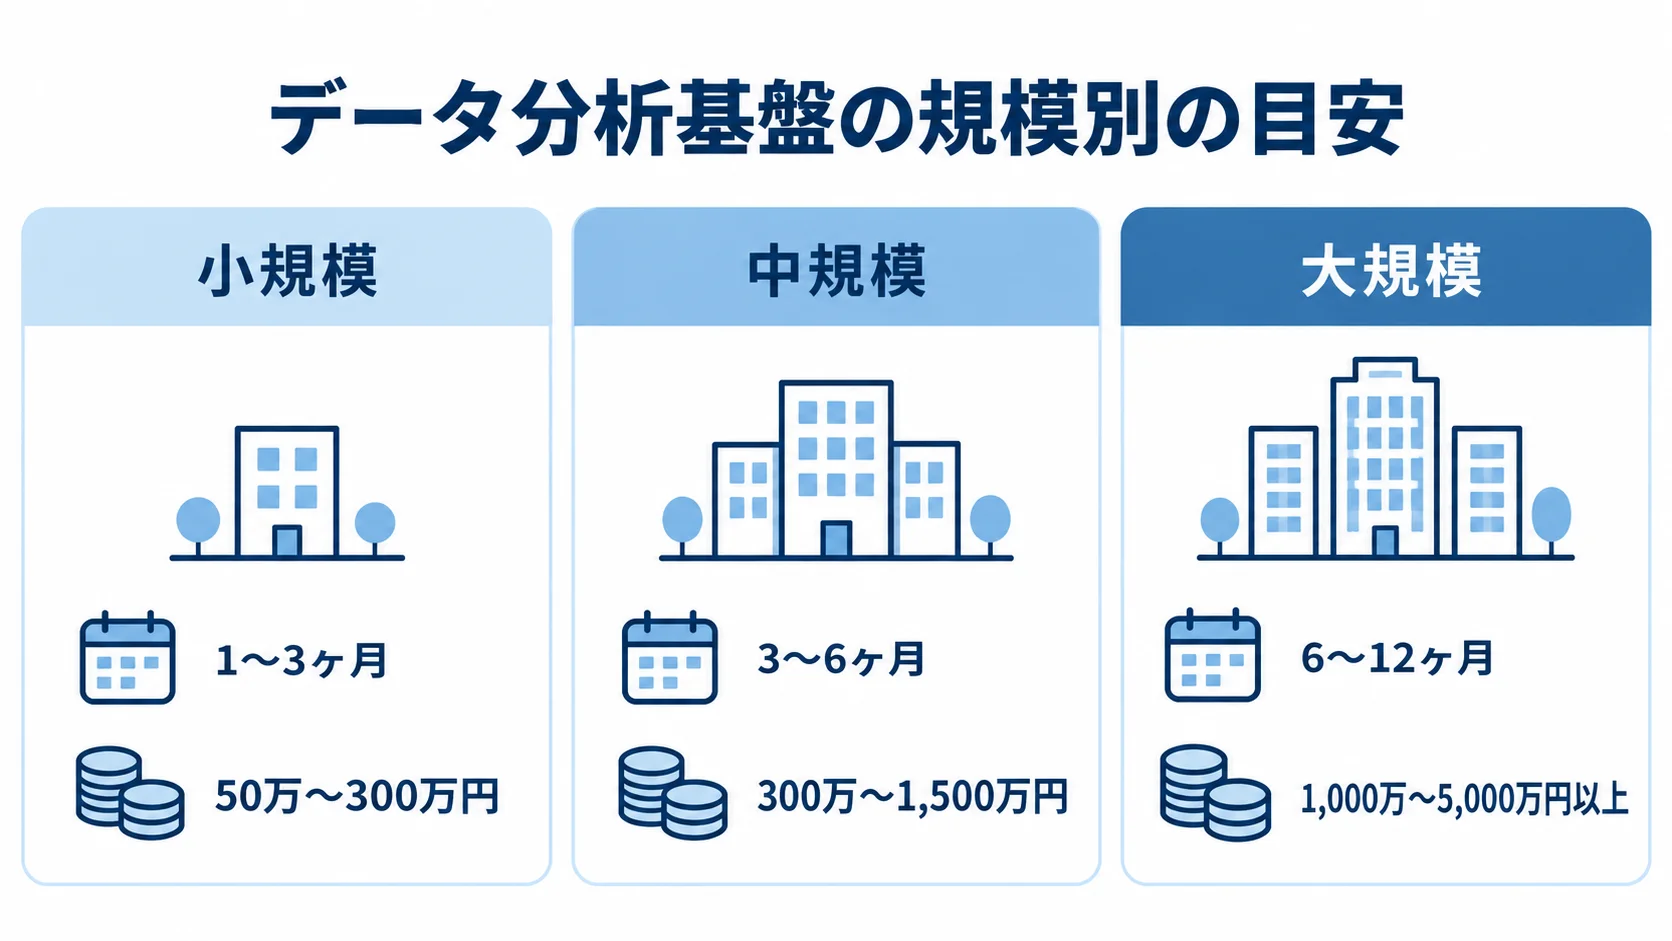
期間と費用は、導入範囲や機能の複雑さで変わります。Qlik Senseの特性を踏まえると、データ分析基盤の規模別の目安は3段階で考えられます。自社の規模を見極めれば、現実的なスケジュールと予算の初期イメージを持てます。
小規模(スモールスタート・MVP):1〜3ヶ月
小規模導入は、特定部署や単一テーマから始めるスモールスタート・MVP(Minimum Viable Product)です。
- 期間:1〜3ヶ月が目安
- 費用:50万〜300万円程度が目安
- 範囲:単一データソースと代表的なKPI
基本集計と簡易可視化を行い、ダッシュボードを1つ立ち上げるイメージです。ドラッグ&ドロップでアプリ(分析画面)を作れ、選択操作で多角的に絞り込めます。
データソースを1つに絞れば、ロードスクリプトのモデリングも単純に保てます。そのため短期間での立ち上げが現実的です。
限定範囲なら早く画面を用意でき、現場に探索の価値を体感してもらえます。その結果を投資判断の材料にする進め方が有効です。
中規模(本格的な業務利用):3〜6ヶ月
中規模導入は、複数のデータソースを統合し、部門横断で業務利用するケースです。
- 期間:3〜6ヶ月が目安
- 費用:300万〜1,500万円程度
- 整備内容:詳細なKPI、権限管理、複数のダッシュボード
取り込み対象は、基幹システム、各種SaaS、Excelファイルなどです。セクションアクセスなどを使い、利用者ごとに見せるデータの範囲を制御します。
複数テーブルを結ぶキーや、粒度の異なるデータの扱いが重要になります。モデリングの判断は探索性能と正確性を左右するため、要件定義と設計に時間を確保します。データ量が増えるとインメモリに必要なメモリも増えるため、サーバーリソースの見積もりも欠かせません。
大規模(全社展開・高度な分析):6〜12ヶ月
大規模導入は、全社展開に加え、ほぼリアルタイムの更新や高度な分析を含むケースです。
- 期間:6〜12ヶ月が目安
- 費用:1,000万〜5,000万円以上に達することもあります
- 対象:全社基盤、ガバナンス、高度な分析まで含む範囲
この規模では、複数部門のデータ基盤、詳細な権限制御、ガバナンス設計を行います。大量データ向けにサーバー構成を最適化し、Qlik AutoMLによる予測分析も検討します。さらに、Insight Advisorによる高度なインサイト提示も対象になり得ます。
データウェアハウス(DWH)やデータ統合パイプラインの整備も含めて、全体を設計します。また、運用体制やユーザー教育の仕組みづくりも必要です。
全社で数字を信頼して使うには、KPI定義の統一とデータモデルのガバナンスが欠かせません。この合意形成には時間を要することが多いため、計画に織り込んでおきます。
工程別のスケジュールと期間配分
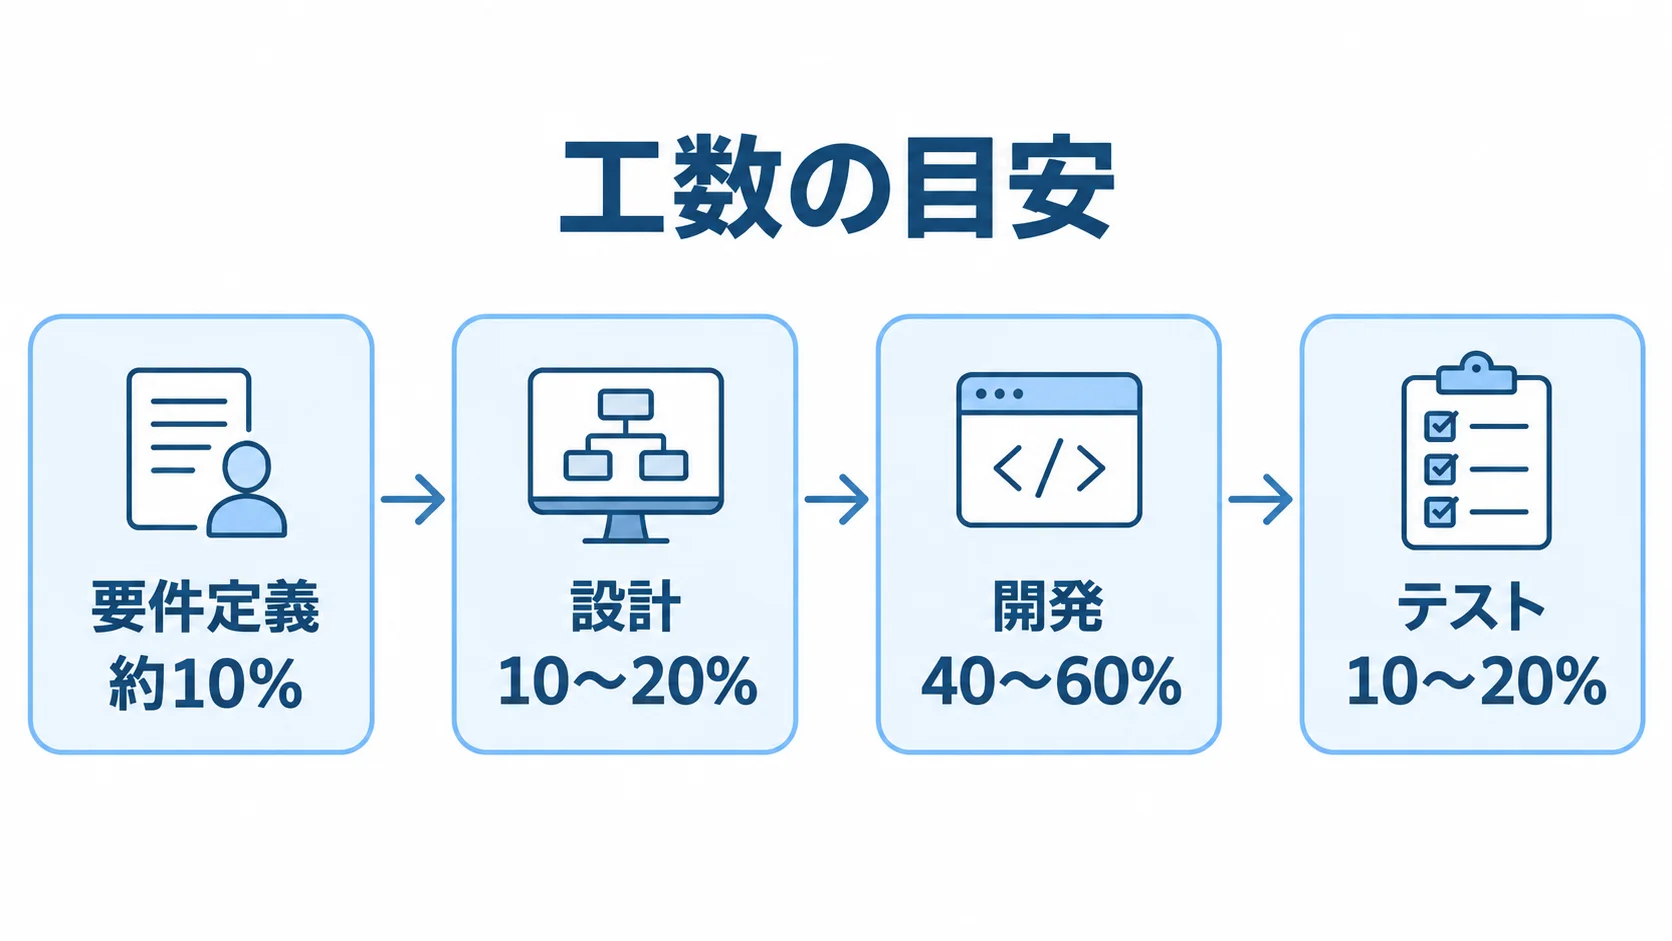
導入は、要件定義・KPI設計、モデル構築、テスト・定着の順に進みます。段階ごとに、作業の中身と時間のかかる箇所は異なります。
工数の目安は、要件定義が約10%、設計が10〜20%です。また、開発(データ加工とダッシュボード構築)は40〜60%と最も重く、テストは10〜20%です。
要件定義・KPI設計フェーズ:2週間〜2ヶ月
要件定義では、誰がどの業務判断に、どのデータをどう使うかを明らかにします。
- 業務とデータ:対象業務と必要なデータソースの特定
- 指標と切り口:KPIとディメンションの定義
- 完成イメージ:画面のラフスケッチ
期間は規模に応じて2週間〜2ヶ月が目安です。
KPI(重要業績評価指標)の定義は、関係者どうしで厳密に合意しておきます。「売上」ひとつでも、受注基準か出荷基準か、返品や値引きをどう扱うかで数字が変わります。部門間で解釈がずれることもあり、定義が曖昧なままだと後工程で手戻りが起きます。
こうした数字のずれは、ロードスクリプトやモデルの修正にもつながります。利用者が自由に探索できるからこそ、指標の定義とデータの意味を全社で一貫させます。この段階で必要な事項を固めておくと、後続工程の手戻りを小さくできます。
データロード・アソシエイティブモデル構築フェーズ:2〜3ヶ月
プロジェクトの中核は、データロードとアソシエイティブモデルの構築です。この工程は2〜3ヶ月で、全工数の40〜60%を占めます。
- データ接続:各データソースとの接続
- 抽出と加工:ロードスクリプトによるデータの抽出、変換、整形
- モデル構築:キー項目による複数テーブルの関連づけ
- 画面構築:シートやダッシュボードへのグラフとKPIの配置
合成キーや循環参照を避け、粒度の異なるデータを正しく扱う設計が欠かせません。モデルの設計は、探索の正確性とパフォーマンスを決定づけます。
再読み込みを効率化するため、QVD(Qlik独自のデータ格納形式)で中間ファイル化する設計も行います。画面はドラッグ&ドロップで作れても、時間がかかるのはデータ加工とモデリングです。
運用も見据えてモデルを丁寧に作ることが、分析体験の質を高めます。
テスト・定着フェーズ:1〜2ヶ月
テスト・定着には1〜2ヶ月をかけ、要件との適合を確かめたうえで現場利用につなげます。
- 数値照合:元データや既存帳票と表示値の突き合わせ
- 原因特定:集計誤り、欠損、更新時期、KPI解釈の確認
- 利用支援:操作説明会、マニュアル、初期の問い合わせ対応
数値の検証は、BI基盤のテストで最も重要かつ工数がかかります。数値の確認を軽視すると、現場から数字を信用されず、ダッシュボードが使われなくなるおそれがあります。
数値の正確性を確かめたあとは、利用者に選択して絞り込む操作を試してもらいます。緑・白・グレーで関連を読む方法にも慣れてもらいます。利用者が自分で数字を掘り下げられる状態にすることが、投資を成果に変える鍵になります。
納期を左右する要因と遅延対策
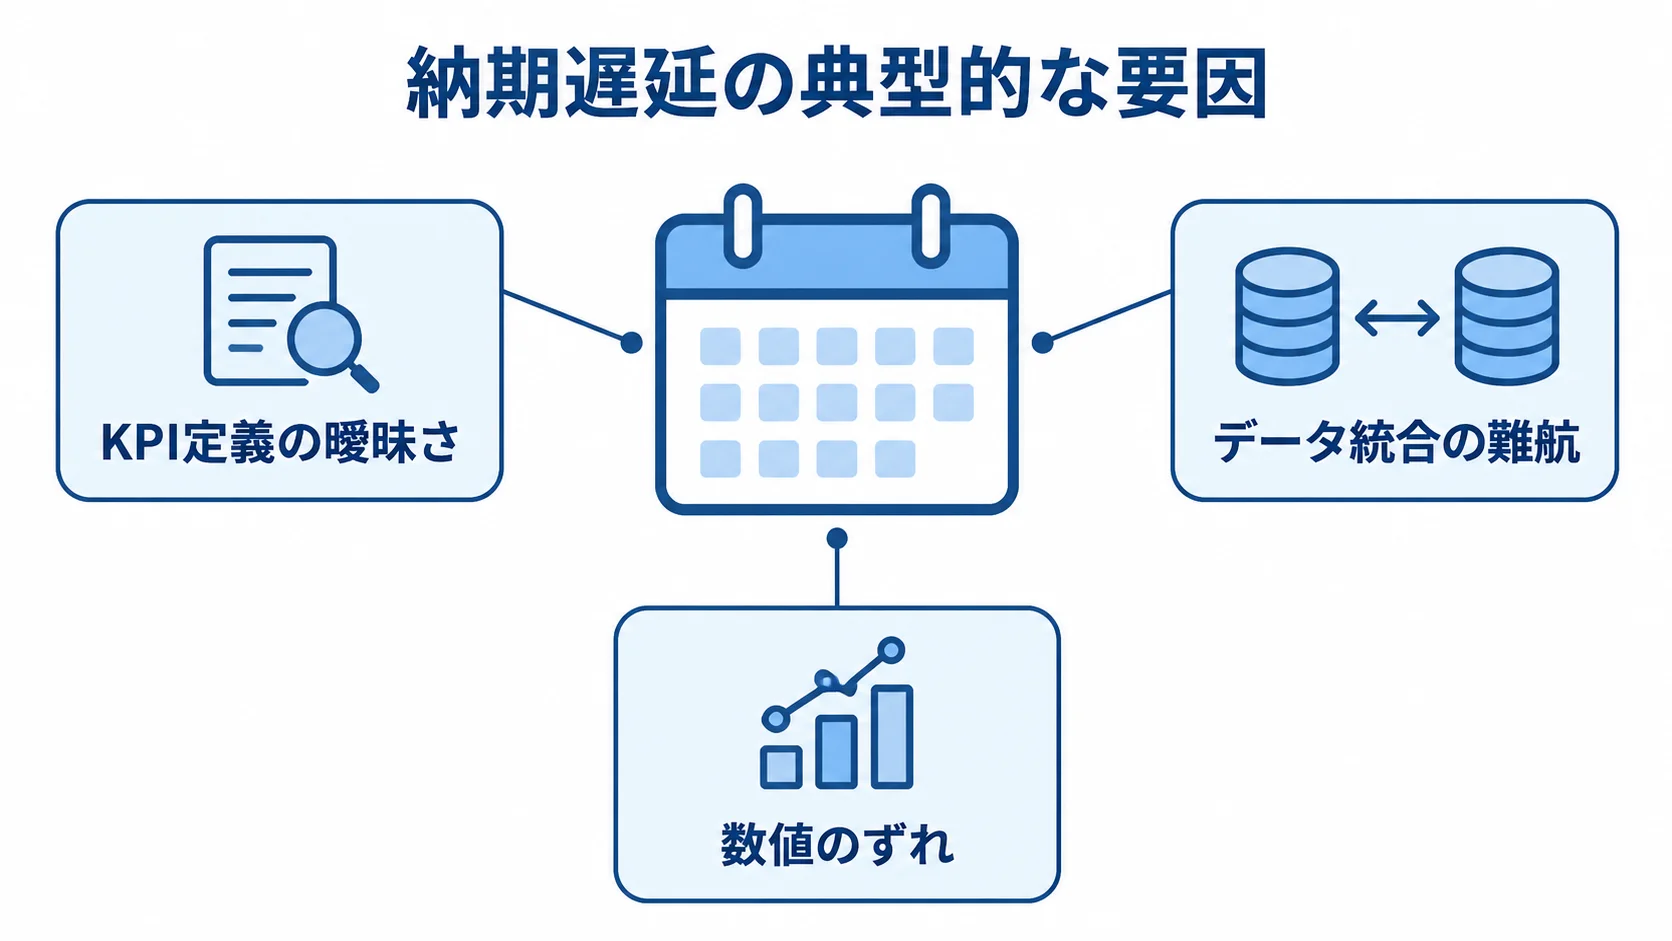
遅延の原因は、ツール操作そのものより、周辺の準備にあることがほとんどです。要因と対策を把握したうえで、リスクを含めた現実的な日程を立てます。
納期遅延の典型的な要因
遅延を招く主な要因は、KPI定義、データ統合、数値検証に関する問題です。
- KPI定義の曖昧さ:部門ごとに指標の認識が揃っていない状態
- データ統合の難航:形式や更新時期の違い、欠損、表記揺れによる工数の増加
- 数値のずれ:原因の切り分けに時間がかかること
KPI定義が部門ごとにずれると、開発後半に数値の変更要望が相次ぐことがあります。その変更要望により、ロードスクリプトやデータモデルの再構築が起こります。
手戻りはアソシエイティブモデルの再設計コストになるため、上流で定義を固めておく必要があります。
第二の要因は、複数システムのデータ統合・整備の難航です。問題がデータに触れて初めて見つかり、想定以上の工数になることもあります。
第三の要因は、テスト工程で数値のずれを検証する作業が膨らむことです。集計ロジック、欠損、更新時期、定義解釈を順に切り分けていく必要があります。
これらに共通するのは、可視化機能ではなく、データとKPIの品質が関係している点です。
スモールスタートとフェーズ分割による納期対策
遅延対策には、対象を絞ったスモールスタートとフェーズ分割が有効です。
- 対象業務を1つに絞った、単一または少数のデータソースでの立ち上げ
- 第一フェーズでの特定部門の分析基盤づくりと、価値の実証
- 第二フェーズでの隣接部門やデータソースの追加
- 第三フェーズでの全社展開
全社・全データを一度に対象にすると、KPI合意とデータ整備が膨大になり、納期リスクが高まります。Qlik Senseはアソシエイティブエンジンを使うため、限定範囲でも早い段階で分析画面を示しやすく、スモールスタートに向いています。
遅延要因を上流で抑え、小さく始めて着実に広げることが、納期を守る進め方です。各段階でKPI定義とデータ整備を固めれば、投資効率も高めやすくなります。
要件定義の段階で変更時の管理プロセスを合意しておけば、口頭の追加要望が積み重なる事態を防げます。
まとめ
規模別の期間、工程別の配分、納期を左右する要因と遅延対策は、上で見たとおりです。
Qlik Senseは全データをインメモリで保持し、事前定義したクエリやドリルダウン経路に縛られず探索できます。関連する値も非関連の値も自動で示します。
分析設計の性格は従来型BIと異なりますが、工数はモデルの設計・実装に移ります。データ整備とKPI定義の品質が、日程を左右します。
スモールスタートは1〜3ヶ月、本格利用は3〜6ヶ月、全社展開は6〜12ヶ月が期間の目安です。工数の中心は画面づくりではなく、データ接続、加工、モデリングです。
KPI定義の曖昧さ、データ統合の難航、数値検証の作業増は、上流で抑えておきます。そのうえで段階展開を進めると、納期を守りつつ投資効率を高められます。
導入を検討する際は、まず自社のデータ整備状況とKPI定義を把握します。次に、複数の開発パートナーに相談し、現実的なスケジュールを描きます。
▼全体ガイドの記事
・Qlik Sense導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。