
Amazon Redshiftの導入は、3段階で進めるのが一般的です。最初は要件定義・企画で、次は設計・構築です。最後はテスト・移行・リリースです。
各段階でPOCによる実現可能性の確認と構成の選定、移行前後の性能・データの検証を重ねることが、導入を成功させる要点です。費用と見積もりの要点もあわせて扱います。
▼全体ガイドの記事
・Amazon Redshift導入の完全ガイド
データ基盤構築の工程ごとの進め方と注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Amazon Redshiftの全体像
Amazon Redshiftは、AWSが提供するペタバイト規模のデータウェアハウスサービスです。列指向ストレージと超並列処理(MPP)アーキテクチャを採用しており、従来のオンプレミスDWHと比べて、大幅なパフォーマンス向上とコスト削減を実現できます。導入をスムーズに進めるには、まず基本的な仕組みとデプロイオプションを理解しておく必要があります。
RedshiftのアーキテクチャとProvisioned/Serverlessの違い
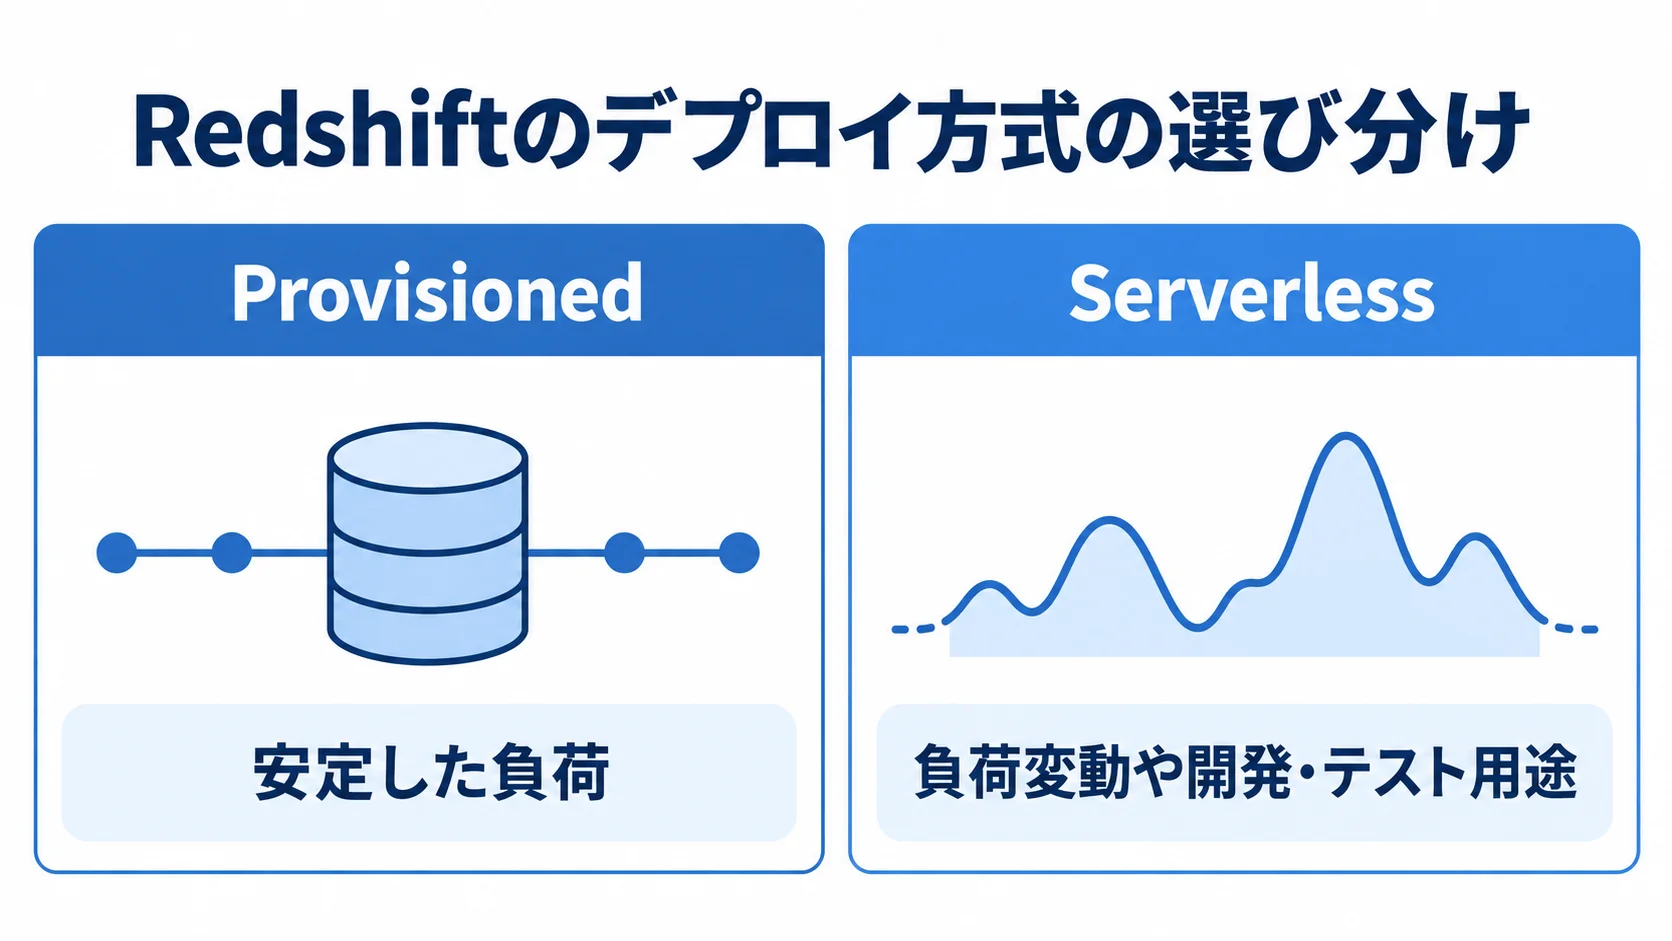
Redshiftのデプロイ方式は、負荷が安定しているかどうかと、クラスターを自分で管理する必要があるかどうかを軸に選びます。
- Provisioned:ノード数やインスタンスタイプを調整し、安定した負荷に対応します。
- Serverless:クエリ実行時の従量課金で、負荷変動や開発・テスト用途に向きます。
Provisionedでは、リーダーノードとコンピューティングノードで構成するクラスターを事前に定義します。なお、DC2インスタンスは2025年4月時点でAWSが廃止を発表しており、今後はRA3またはServerlessへの移行が推奨されています。
Serverlessは、RPU(Redshift Processing Unit)という単位で処理能力をスケールします。また、Serverless Reservationsを活用すれば、3年契約で最大45%のコスト削減も可能です。
Redshiftの主な特徴と他サービスとの違い
Redshiftの特徴は、クエリ処理、データ連携、分析ツールの3点です。
- 処理性能:列指向ストレージにより、集計クエリを高速に処理します。
- データ連携:Redshift SpectrumでS3上のデータを直接分析できます。
- 分析ツール:ゼロETL統合やBIツール連携も利用できます。
S3のデータレイクとRedshiftを組み合わせたレイクハウス構成にも、Redshift Spectrumが使えます。膨大なデータを低コストで保存し、必要なときに高速に分析できる点も特徴です。
AuroraやRDSのデータは、ゼロETL統合でRedshiftへ連携できます。従来のETLパイプライン構築を省けるため、トランザクションデータをリアルタイムに近い形で扱えます。
Amazon QuickSightやTableauなどのBIツールとも容易に接続できるため、データ活用の幅が広いのも特徴のひとつです。
Redshiftは標準SQLに対応しているため、既存のSQL資産をそのまま流用しやすく、移行プロジェクトでは大きなメリットになります。
Amazon Redshift導入の進め方
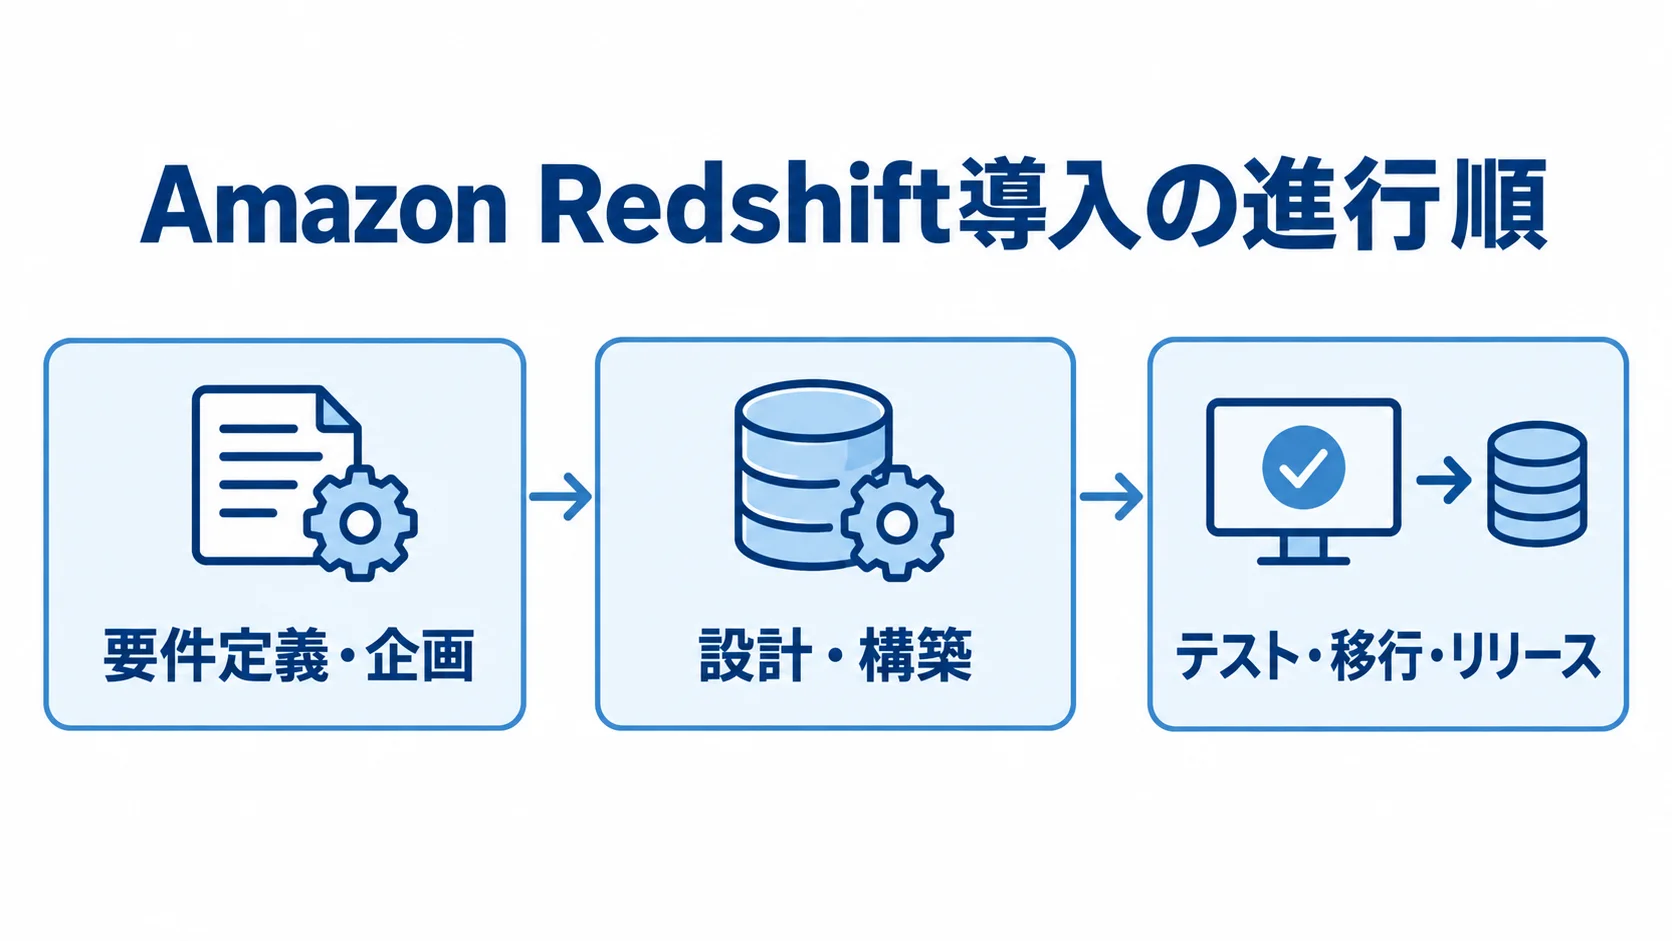
導入は、「要件定義・企画」「設計・構築」「テスト・移行・リリース」の順に進みます。
各フェーズで適切な判断と準備を行うことが、スムーズな導入と安定した運用につながります。
要件定義・企画フェーズ
要件定義では、現状と導入後に求める条件を揃えます。
- 現状把握:移行元のデータ基盤と業務課題を洗い出します。
- 実現可能性:POCで性能と導入可否を確かめます。
- 将来要件:成長予測、セキュリティ、体制を要件に含めます。
最初のフェーズでは、Redshiftの導入で実現したいビジネス目標を明確にすることが出発点になります。移行元の候補には、Oracle DWH、SQL Server、Teradataなどがあります。MySQLやPostgreSQLも、移行元になります。
まず、現在使っているデータウェアハウスやデータベースを洗い出します。そのうえで、対象システムを特定し、データ量とテーブル数を調べます。また、クエリの種別と処理頻度も確認します。
日本経済新聞社の導入事例では、既存SQLをRedshiftで実行するPOCを行いました。その結果、定型処理は8ノード構成で既存環境と同等の性能を確認したと報告されています。
日本経済新聞社の事例のように、POCで実現可能性を検証しておくと、後工程のリスクを減らすうえで効果的です。次に、データ量の見積もりと将来のスケールアップ計画を立てます。
現在のデータ量と今後3〜5年の成長予測をもとに、必要な構成を検討します。Provisionedのノード数やインスタンスタイプを決めるか、Serverlessを採用するかは、その結果をもとに判断します。
セキュリティ要件やコンプライアンス要件(暗号化、VPC内へのデプロイ、IAMによるアクセス制御など)も、要件定義フェーズで整理しておく必要があります。
発注側は、プロジェクトのスケジュールと体制を確定し、AWSパートナー企業やSIer(システムインテグレーター)の活用有無も含めて検討します。
設計・構築フェーズ
構築と並行して、データモデルや連携方式を決めます。
- 環境構築:AWSコンソールやIaCツールで環境を作ります。
- データ設計:データモデルとDISTKEY・SORTKEYを設計します。
- 連携と確認:データ連携方式と基本性能を確かめます。
環境は、RedshiftクラスターまたはServerlessワークグループのどちらかを用意します。その際、データモデルとETLパイプラインも設計します。
クラスターの作成には、AWSマネジメントコンソールのほか、Terraform・AWS CDKなどのIaCツールも使えます。Serverlessはネームスペースとワークグループを設定すれば、数分で環境を整えられます。一方、Provisionedではノード数・インスタンスタイプに加え、VPC・サブネットグループ・セキュリティグループを設定します。
データモデル設計は、Redshiftの性能を最大限に引き出すうえで最も重要なステップです。Redshiftには、スターまたはスノーフレーク型のディメンション・ファクト構造が適しています。
DISTKEY・SORTKEY・圧縮エンコードを適切に設定すると、クエリ性能を大幅に高められます。また、AWS公式ドキュメントは、大規模ファクトテーブルにDISTSTYLE KEYを推奨しています。さらに、頻繁に絞り込む列をSORTKEYに指定することも、テーブル設計のベストプラクティスです。
ETLはExtract-Transform-Load、ELTはExtract-Load-Transformの略です。データソースの種類に応じて、設計に使う方式を選びます。
AuroraやRDSからのデータ連携にはゼロETL統合が活用でき、複雑な変換処理にはAWS GlueやAmazon EMRを組み合わせる構成が一般的です。
Redshift DataAPIを使えばサーバーレスなSQL実行も可能で、Lambda関数からデータの投入や集計処理を非同期に実行することもできます。
構築が完了したら、サンプルデータを用いた動作確認と、基本的なクエリのパフォーマンステストを実施します。
テスト・移行・リリースフェーズ
移行前後の結果と稼働後の性能を確かめます。
- 移行検証:移行データをロードし、結果と性能を比べます。
- 切り替え:Blue-Green方式で、切り替え時のリスクに備えます。
- 初期運用:稼働後は性能を監視し、統計情報を保ちます。
最後の段階では、本番データを使った移行リハーサルと、最終的なカットオーバーを行います。
データ移行では、移行元のデータを抽出してS3に格納し、RedshiftのCOPYコマンドを使って高速にロードするのが基本的な手順です。なお、COPYコマンドは、S3だけでなく、DynamoDB・EMR・SSH経由でのリモートホストからのロードにも対応しています。
大規模移行ではAWS DMS(Database Migration Service)を活用できます。CDC(Change Data Capture)でデータを継続同期しながら、ダウンタイムを抑えられます。
テスト工程では、既存システムとRedshiftの両方で同一のクエリを実行し、結果の整合性とパフォーマンスを比較検証します。特に、集計結果の数値の一致とNULL値の扱いは、移行元データベースとRedshiftで挙動に差異があるため、注意が必要です。
本番移行の際には、Blue-Greenデプロイメントアプローチを採用すれば、問題発生時にすばやくロールバックできます。たとえば、小売大手企業は、DC2からRA3への移行でこの手法を使い、ETLクエリの性能向上とストレージ容量の拡大を安全に実現した事例として報告されています。
カットオーバー後は、通常1〜2週間の初期安定化期間を設けます。統計情報の更新には、VACUUM・ANALYZEを必要に応じて実行します。
費用相場とコストの内訳
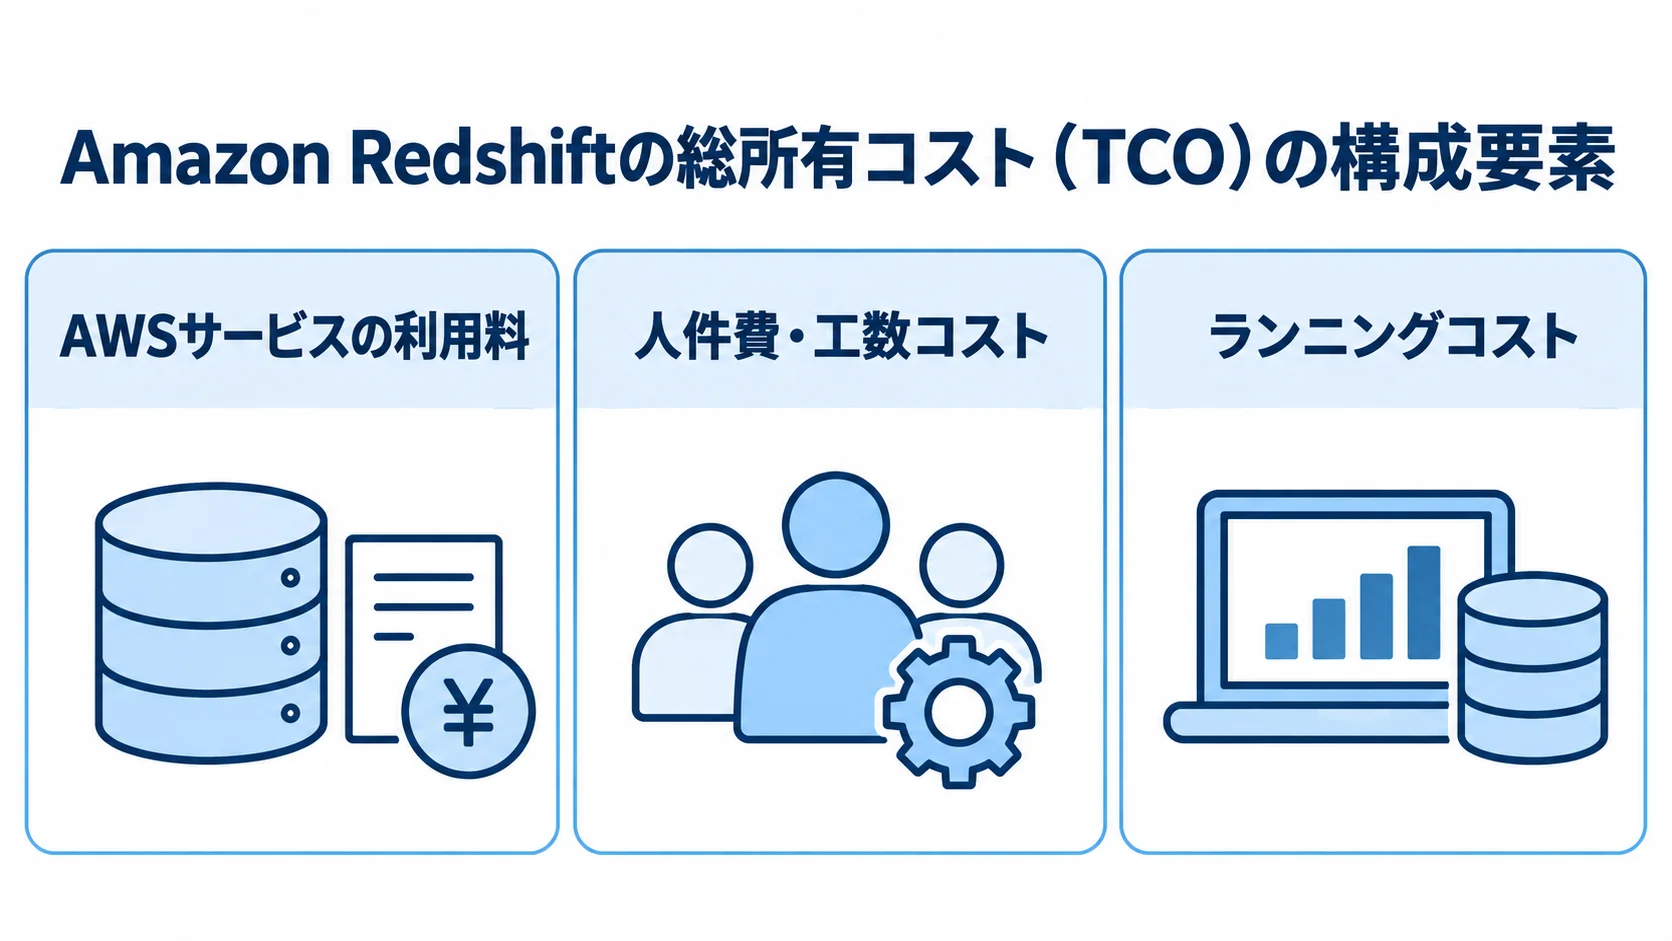
Amazon Redshiftの費用は、AWSサービスの利用料と、導入・構築にかかる人件費・工数コストの2つに大別されます。
AWSの料金体系は、選択するデプロイオプション(ProvisionedかServerless)やインスタンスタイプ、リージョンによって異なります。そのため、自社の利用規模とワークロードの特性に応じて構成を選ぶことが、コストを抑える第一歩になります。
AWSサービス利用料の目安
費用は、構成と利用時間を軸に見ていきます。
- Provisioned:ノード構成と契約で料金が変わります。
- Serverless:RPU時間に応じて課金されます。
- 割引と規模:予約割引と利用規模を踏まえて比べます。
- 導入工数:AWS以外の導入工数も、総所有コスト(TCO)に含めます。
東京リージョンのオンデマンド料金は、ra3.xlplusが1ノード約0.543ドル/時間からです。また、ra3.4xlargeは約1.086ドル/時間、ra3.16xlargeは約4.344ドル/時間が目安となります。
小規模な分析用途であれば、2ノードのra3.xlplusクラスターで月間約800〜1,000ドル(約12〜15万円)程度のAWS利用料となります。一方、データ量が数十TB規模になる大規模なケースでは、8〜16ノード構成で月間5,000〜20,000ドル(約75〜300万円)規模になることもあります。
Serverlessは1RPU時間あたり約0.375ドルで、クエリのないアイドル時間は課金されません。そのため、利用頻度の低い開発環境やアドホック分析に向いています。
重い分析クエリを常時実行する本番環境では、Provisionedが候補です。
リザーブドインスタンスは、1年契約で約20〜30%、3年契約では約40〜50%の割引率が適用されるため、購入によって総コストを抑えられる場合がほとんどです。
ナレコムクラウドの見積もり例では、ra3.xlargeの2ノード構成が紹介されており、1年リザーブドの場合、AWS費用は月額換算7〜10万円程度です。
人件費・工数と導入支援費用の目安
導入規模に応じて、期間と支援費用が変わります。
- 小規模PoC:2〜4週間程度で完了する場合があります。
- 中規模構築:3〜6か月、300〜800万円程度が目安です。
- 大規模刷新:1〜2年、1,000万円〜数千万円規模です。
AWSの利用料とは別に、導入プロジェクトでは人件費・工数コストがかかります。社内エンジニアで対応する場合も、SIerやAWSパートナーに委託する場合も、費用はプロジェクトの規模によって大きく変わります。
小規模PoCは、数テーブル・数十GB規模が目安です。社内エンジニア1〜2名で完了できる場合もあります。また、AWSの300ドルのServerlessクレジットを活用できます。
中規模の本番環境構築には、既存DWHからの移行やETLパイプラインの構築も含まれます。
SCSKやアシストなどのAWSパートナー企業は、Redshift導入支援を提供しています。要件ヒアリングから設計・構築、移行、運用監視の設計まで一括で対応しており、初めて導入する企業にとっても利用しやすい選択肢です。
ランニングコストには、AWS利用料のほかに、AWS GlueとS3の費用があります。さらに、データ転送とCloudWatchの監視にも費用がかかります。
AWS利用料と導入費用、ランニングコストを合わせて、総所有コスト(TCO)で試算します。
見積もりを取る際のポイント
Amazon Redshiftの導入を外部ベンダーやSIerに依頼する際には、適切な見積もりを得るための事前準備と、比較の基準を理解しておく必要があります。
見積もりの精度は要件の明確度に大きく左右されます。そのため、できるだけ具体的な情報を整理したうえで複数社に依頼することが、適正な費用でのプロジェクト推進につながります。
要件明確化と仕様書の準備
見積もりを依頼する前に、最低限、移行・処理・運用の条件を揃えます。
- 移行元:データ量と、日次・月次の増加量をまとめます。
- ETL/ELT:処理内容・頻度・所要時間を記載します。
- 業務要件:利用者数・SLA・BI接続の要件を整理します。
- セキュリティ:暗号化・VPC・IAM・監査ログを定めます。
移行元は、Oracle、SQL Server、Teradataなどを明記します。オンプレミスのPostgreSQLなども、移行元として書き添えます。データ量はTB単位で示し、テーブル数も添えます。
ETL/ELTでは、変換処理の数と複雑度に加えて、Informatica、Talend、自作スクリプトなど利用中のツールも書き添えます。
業務要件では、想定するユーザー数と同時接続数、クエリの応答時間の目標を示します。
セキュリティ要件では、暗号化(保存時・転送時)とVPC内へのデプロイの有無を示します。IAMとの統合方針と監査ログの要件も、あわせて整理します。
これらを仕様書または要件定義書にまとめると、各社の見積もりの精度が上がり、見積もり金額の根拠も明確になります。
AWS Pricing Calculatorを事前に試せば、ベンダーの見積もりの妥当性を確かめる参考になります。
複数社比較と発注先の選び方
見積もり金額に加えて、実績や支援体制を比べます。
- 候補選定:APN登録企業などから3社以上の見積もりを取ります。
- 導入実績:実績・類似業種・運用支援を比較します。
- 技術提案:POC実績と設計案の根拠を確認します。
- 協力体制:担当者の応答ぶりも含めて評価します。
発注先候補は、AWSパートナーネットワーク(APN)登録済みのSIerやコンサルティング会社を中心に選びます。
APNパートナーは、AWSによってRedshiftの技術力が認定されており、一定の品質が期待できます。
導入後の運用保守サポートも含めて、総合的に評価します。また、POCの実施経験があるか、POCの結果として具体的なパフォーマンス改善の実績を示せるかも、評価の基準になります。
提案では、Provisioned/Serverlessの選定理由を確認します。テーブル設計方針やETL構成を説明できるベンダーは、技術理解が高いと判断できます。
金額だけが安く、技術的な根拠が示されない提案には、後工程での手戻りや追加費用が発生するリスクがあります。
最終的な選定では、担当エンジニアとの相性や、質問への回答スピード、レスポンスの丁寧さといった、プロジェクト運営での協力関係も判断材料になります。
注意すべきリスクと対策
導入前の検証と運用中の監視で、主なリスクに備えます。
- SQL互換性:移行元SQLとの互換性をPOCで確かめます。
- 性能設計:DISTKEY・SORTKEYをレビューします。
- 費用監視:AWS費用を監視し、想定外の増加を抑えます。
- 移行計画:Blue-Green方式や段階移行で停止に備えます。
移行元がOracleやSQL Serverの場合は、固有の関数や構文がRedshiftで動作しないケースがあります。そのため、互換性のないSQLのリライト工数を見積もりに含めておくことが大切です。
テーブル設計が不十分でDISTKEYやSORTKEYを適切に設定しないと、大規模テーブルのJOINやGROUP BYが極端に遅くなることがあります。設計フェーズでは、AWSの推奨するベストプラクティスに沿ったレビューを行うことが大切です。
Redshift SpectrumのS3スキャン費用やスナップショット費用がかさむ場合があります。さらに、AWSサービス間の転送費も加わると、月額が想定を超えることがあります。
導入初期には、AWS Cost ExplorerとAWS Budgetsを使ったコストモニタリング体制を整えることをお勧めします。
Blue-Green方式は、本番環境への影響を抑える効果があります。
まとめ
Redshift導入は3段階で進めます。最初の要件定義・企画では、データ基盤を洗い出し、POCで実現可能性を検証します。次は設計・構築です。最後はテスト・移行・リリースです。
設計では、DISTKEYやSORTKEYなどRedshift固有の要素が性能を左右します。移行では、Blue-Green方式を使うと移行リスクを抑えられます。
運用では、コスト監視とVACUUM・ANALYZEの定期実行が安定稼働の鍵です。
費用は、AWS利用料と導入・構築費用を合算したTCOで評価します。目安として、小規模のAWS利用料は月額10〜15万円、大規模では数百万円規模です。また、中規模案件の導入・構築費は300〜800万円程度です。
見積もりを取る際は、要件を事前に整理したうえで、AWSパートナー認定を受けた複数社を比較検討します。そうすることで、適正な費用とサービス品質を確保できます。
Amazon Redshiftの導入をご検討中の方は、ぜひ専門家への相談も活用しながら、データ活用基盤の整備を進めていただければ幸いです。
開発を相談する前に、次のホワイトペーパーもご活用ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。