
C言語のリバースエンジニアリングは、対象の選定と目的の明確化から始め、解析と成果物化まで6つの工程を順に進めます。
C言語のバイナリは、設計書や仕様書が失われると解読が極めて難しくなります。外注でも内製でも、工程ごとの役割を押さえておくことが大切です。
▼全体ガイドの記事
・C言語のリバースエンジニアリングの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
C言語のリバースエンジニアリングとは:他言語との根本的な違い
C言語のリバースエンジニアリングを正しく進めるには、まずC言語固有の特性を理解することが欠かせません。
JavaやC#のような中間言語(マネージドコード)と異なり、C言語はネイティブコードに直接コンパイルされます。そのため、逆コンパイルで可読性の高いソースコードを復元するのが本質的に難しく、バイナリ解析(逆アセンブル)が中心的な方法になります。
この特性が、C言語リバースエンジニアリングの難易度と工数を大きく左右します。組み込みシステムや産業機器でC言語が使われ続けているのは、ハードウェアのリソース効率と実行速度の点で他言語の追随を許さないためです。そのぶん、リバースエンジニアリングの需要も必然的に高まっています。
中間言語・スクリプト言語との解析難易度の違い
C#やJavaのような中間言語(IL/バイトコード)で動作するプログラムは、ILSpyやJAD(Java Decompiler)などのツールを使うと、制御構造やクラス設計がほぼそのまま復元できます。ただし、変数名は失われます。一方で、C言語のコンパイル済みバイナリは、変数名・関数名・コメントがすべて消去され、型情報も失われた機械語の命令列として存在します。
IDA ProやGhidraによる逆アセンブルでアセンブリコードは取得できますが、業務ロジックの意味を復元するには、制御フローグラフの分析、データフロー解析、動的実行トレースを組み合わせる高度な技術が求められます。
PHPやPythonのようなスクリプト言語は、ソースコードが人間の読める形で存在するため、論点は「難読化の解除」と「設計意図の読み解き」が中心です。C言語は対極にあり、バイナリからの情報抽出という根本的に異なるアプローチが必要です。組み込みや産業機器でC言語が使われ続けるのは、ハードウェアのリソース効率と実行速度で他言語の追随を許さないためで、リバースエンジニアリングの需要も高まっています。
C言語リバースエンジニアリングの主な用途
C言語のリバースエンジニアリングが活用される場面は、大きく3つに分けられます。第一は、製造業や公共インフラにおける組み込みシステムのモダナイゼーションです。製造ラインの制御装置やFA機器の制御プログラムは、設計書がないまま20〜30年稼働し続けているケースも珍しくありません。そのため、機器の更新や機能追加の際に、リバースエンジニアリングで仕様書を再構築する需要があります。
第二は、IoT機器・ルーター・ネットワーク機器のセキュリティ脆弱性診断です。C言語で書かれたファームウェアに潜むバッファオーバーフローや整数オーバーフローを検出するには、バイナリ解析が欠かせません。
第三は、ベンダーロックインの解消や互換製品の開発を目的とした仕様書の復元です。クリーンルーム手法を組み合わせることで、著作権リスクを回避しながら進められます。
C言語リバースエンジニアリングの6工程
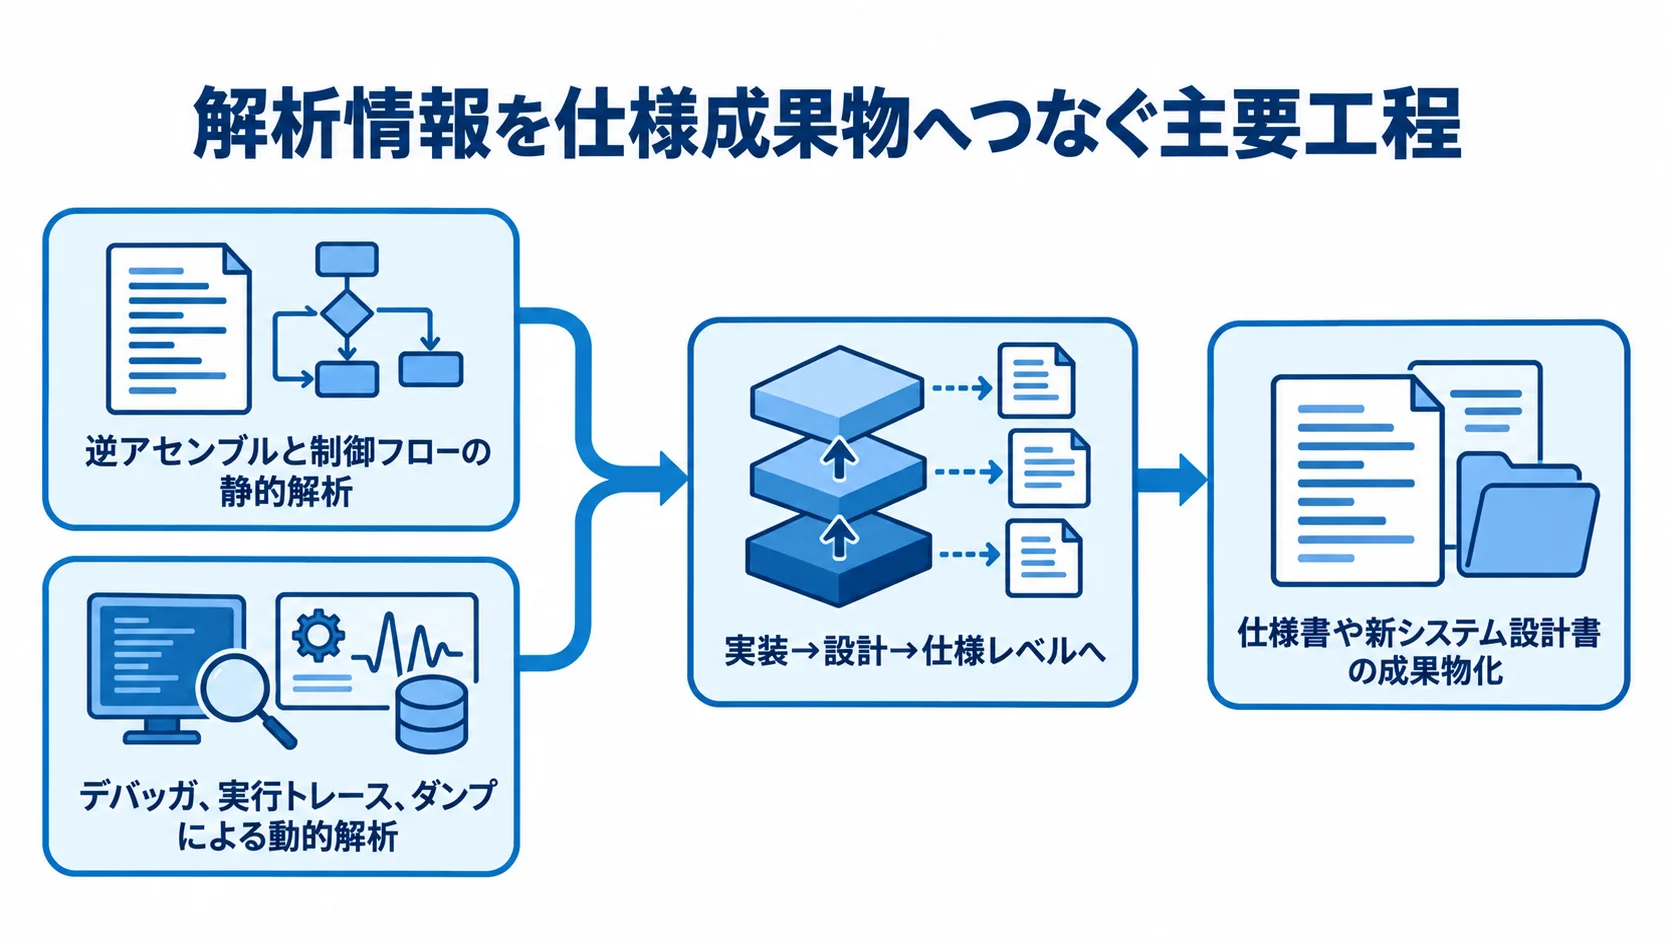
C言語のリバースエンジニアリングを成功させるには、場当たり的な解析を避けることが重要です。そのため、6つの工程を体系的に踏み、各工程の目的と成果物を明確にします。それにより、解析の漏れや手戻りを最小限に抑えられます。
- 工程1:対象選定、目的の明確化、スコープの定義
- 工程2:解析環境とC言語特化ツールの準備
- 工程3:逆アセンブルと制御フローの静的解析
- 工程4:デバッガ、実行トレース、ダンプによる動的解析
- 工程5:実装から設計・仕様への抽象化
- 工程6:仕様書や新システム設計書の成果物化
各工程で何を決め、どう進めるかを、順に説明します。
工程1:対象選定・目的明確化とスコープ定義
リバースエンジニアリングを始める前に、解析対象の選定と目的の明確化が最も重要です。「何を明らかにしたいのか」が決まっていないと、どの関数から解析すべきか判断できず、工数が際限なく膨らみます。
目的には「特定機能の仕様書復元」「脆弱性の有無確認」「業務ロジックの移植」「ファームウェアの改ざん検知」などがあります。いずれの場合も、成果物の粒度(フローチャートのみか、詳細設計書まで必要か)を事前に定めておくことが欠かせません。
解析対象のバイナリが取得できる状態かどうかも、確認が必要です。PCソフトウェアなら実行ファイル(.exe/.elf)を直接入手できますが、組み込みデバイスのファームウェアはフラッシュメモリに書き込まれているため、UART・SPI・JTAG経由のダンプ作業が工程1に含まれます。対象機器に応じた解析環境の準備方針も、この段階で決めます。
工程2:解析環境・ツール準備(C言語特化ツールの選定)
C言語バイナリの解析環境として定着しているのは、IDA Pro(Hex-Rays社)とGhidra(NSA開発・無料OSS)の2大ツールです。IDA ProはC言語バイナリの逆コンパイル品質が非常に高く、標準ライブラリ関数の自動認識(FLIRT技術)も優れています。そのため、解析効率が大きく向上します。
価格は数十万〜百万円単位と高額です。ただし、複数のアーキテクチャ(x86、ARM、MIPS)に対応し、組み込みファームウェア解析に特に適しています。GhidraはNSAが公開した無料OSSで、複数人が同一プロジェクトに注釈を付けながら解析できる点が特徴です。
Binary Ninjaは、スクリプティング(Python/APIによる自動化)の一貫性が最も優れているとされ、大量の関数の自動ラベリングに向いています。組み込みのファームウェアをダンプする場合は、圧縮・暗号化されたイメージの解凍と構造解析に使うBinwalkも必須ツールです。動的解析にはx64dbg(Windows)やGDB(Linux/組み込み)を組み合わせます。
工程3:静的解析(逆アセンブル・制御フロー分析)
静的解析では、バイナリを実行せずに構造を解析します。IDA ProまたはGhidraに読み込むと、逆アセンブル、関数リスト、制御フローグラフ(CFG)、クロスリファレンスが生成されます。
C言語バイナリの静的解析では、まずエントリーポイント(main関数)から呼び出しグラフをたどり、主要な業務ロジック関数を特定することから始めます。C言語特有の注意点として、コンパイラの最適化によって元のコードとは大きく異なる命令列が生成される場合があります。
特にインライン展開(inline expansion)が起きた関数は呼び出しグラフに現れず、解析から抜け落ちるおそれがあります。制御フロー平坦化(Control Flow Flattening)では、if-else構造がswitch文のような単調なループに変換され、復元に多大な工数がかかります。その場合は、D810などの難読化解除プラグインを活用します。
工程4:動的解析(デバッガ・実行トレース・ファームウェアダンプ)
実行時の挙動、特に条件分岐の実際のパスや外部入力への反応は、静的解析だけでは把握しにくいため、動的解析を組み合わせます。PCソフトウェアなら、x64dbgやGDBでブレークポイントを設定し、引数・戻り値・メモリ状態を確認します。実際の入力データに対する処理の変化を追うことで、業務ロジックの「Why(なぜその処理をするのか)」に近づけます。
組み込みデバイスでは、まずUART、SPIフラッシュ、JTAGのいずれかを使ってファームウェアをダンプする必要があります。たとえば、Belkin N300ルーターのUART経由の解析では、一度に大量にダンプするとデバイスがクラッシュするため、Pythonスクリプトで4,096バイト×512回に分けて読み出しました。約2時間で200万バイト全量のプレーンテキスト化に成功した報告があります。
SPI接触型では、Mikrotik mAP2nルーターのSPIフラッシュから抽出したバイナリをBinwalkで解凍すると、PEM DSA秘密鍵とOpenSSH公開鍵が平文で格納されていた事例があります。C言語ファームウェアのセキュリティ脆弱性の深刻さを示す例です。
工程5:抽象化(Design Recovery)―実装→設計→仕様レベルへ
静的解析と動的解析で得た情報をもとに、実装レベル(アセンブリ命令・機械語)の情報を、設計レベル(モジュール構成・データフロー)、仕様レベル(業務要件・機能仕様)へと段階的に抽象化します。業務仕様の復元には、このボトムアップの抽象化が不可欠です。このプロセスが「Design Recovery」で、熟練したリバースエンジニアの経験と判断が最も問われる工程です。
具体的には、解析した関数群に意味のある名前を付け(リネーミング)、データ構造(struct/enum)を再定義し、モジュール間の依存関係を整理します。この段階では業務部門の協力が欠かせません。
コードから分かるのは「How(どう動いているか)」で、「Why(なぜその仕様か)」は業務担当者にしか分からないことが多いです。誤解釈は移行後のバグにつながる最大のリスクです。定期的な業務部門レビューを組み込み、解析仮説の検証を繰り返すことが品質確保の鍵です。
工程6:成果物化(仕様書・新システム設計書の作成)
解析結果を組織の資産として残すため、ドキュメント化が最終工程です。成果物の粒度は目的によって大きく異なり、最小限のフローチャート(処理の流れの可視化)は追加開発の参照資料になります。
要件定義を経た業務仕様書には、画面遷移、入出力項目、業務ルールを記載し、例外処理も含めます。最も詳細な詳細設計書は、データベース設計、API仕様、モジュール構成図まで含み、新システムの開発インプットとして直接使えます。
成果物の品質では、保守性の確認が重要です。若手エンジニアが保守できるか、業務ロジックの背景(Why)が説明されているか、変数・関数の役割が明確かを必ず確認してください。ここが不十分だと、「属人的なドキュメント」になり、技術継承の問題が再発します。
C言語固有の注意点と難読化・難解バイナリへの対処
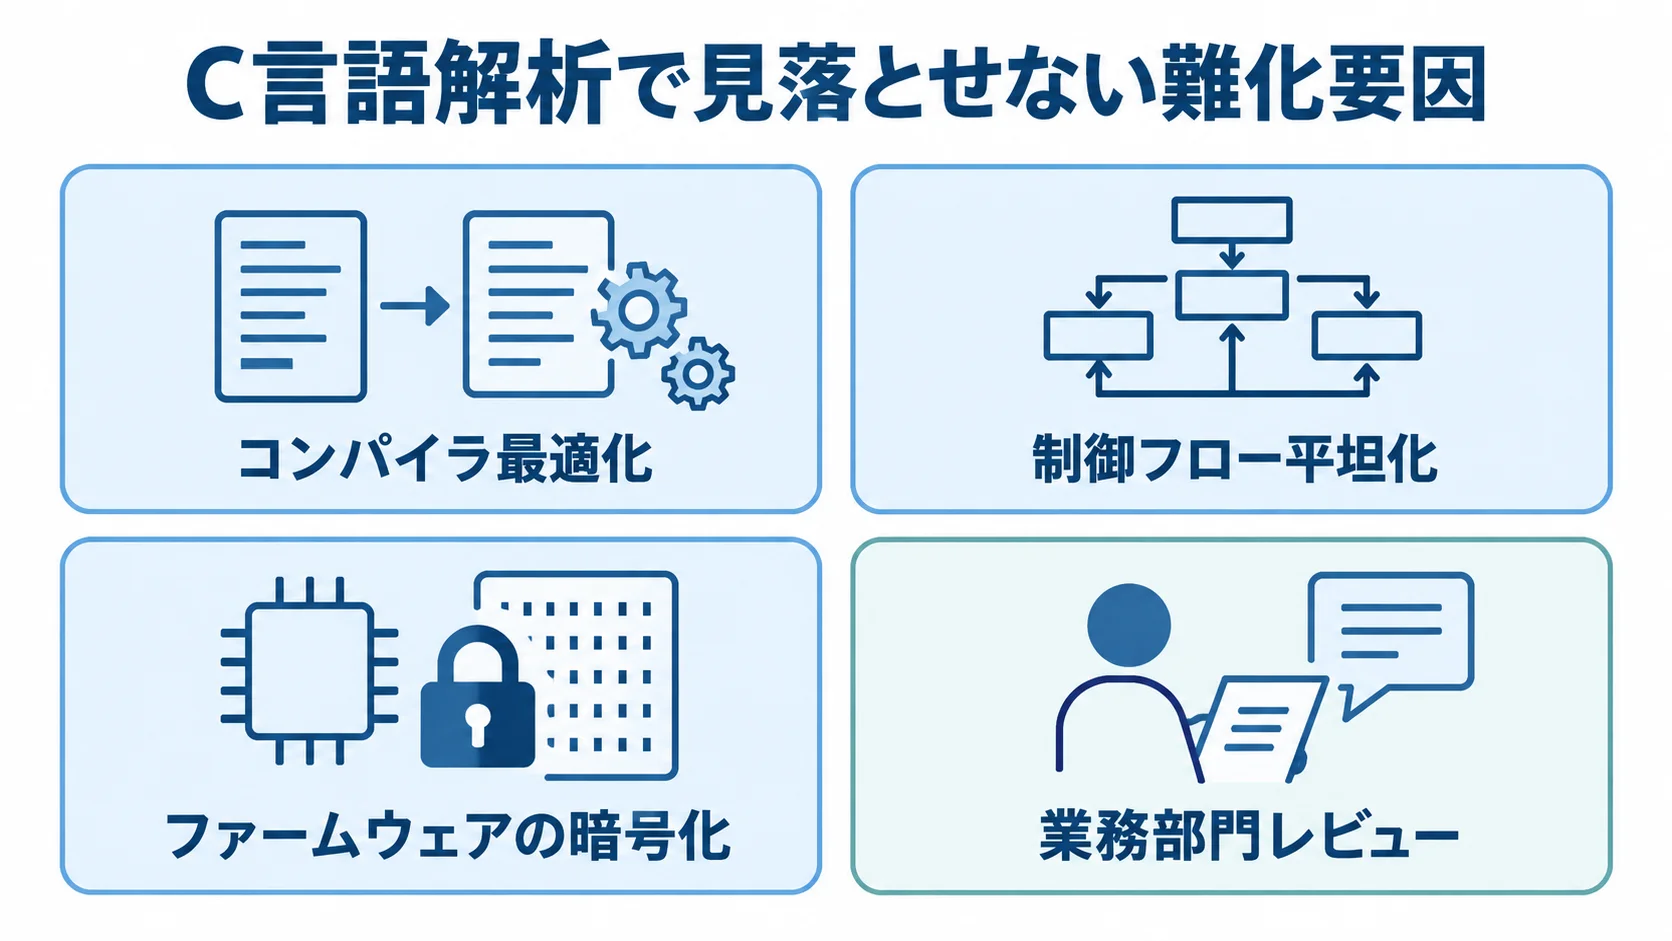
C言語のリバースエンジニアリングには、他言語にはない固有の困難があります。
コンパイラの最適化と難読化技術が重なって解析が想定以上に複雑になるケースが多く、事前の難易度評価と対策準備が成否を左右します。
C言語解析での典型的な失敗パターン
最も多い失敗パターンは、コンパイラ最適化による変数の消滅と関数のインライン展開です。-O2/-O3で最適化されたバイナリでは、ソース上で分かれていた関数が命令列として融合し、機能単位の分析が困難になります。
アーキテクチャが特殊な組み込みプロセッサ(独自RISC命令セット)では、IDA ProやGhidraが対応していない可能性があり、プロセッサ固有のプラグインを開発または入手する必要が生じます。業務ロジック喪失による移行後バグも、深刻な失敗パターンです。
「コードは読めたが業務ルールの意図が分からず、移行後にバグが多発した」というケースは、C言語バイナリの案件で繰り返し報告されています。Howは分かってもWhyは業務部門へのヒアリングなしには復元できず、解析工程に業務部門レビューを組み込まない設計がこのリスクを高めています。
制御フロー平坦化・暗号化難読化への対処法
セキュリティ意識の高いソフトウェアや産業機器では、故意に難読化(Obfuscation)が施されたC言語バイナリが存在します。制御フロー平坦化(Control Flow Flattening)は、本来の条件分岐を単一のdispatcherループとstate変数で置き換え、制御フローグラフを極度に複雑化させます。
この対処には、D810(IDA Pro用プラグイン)やREtdec(逆コンパイラ)を使った自動復元が使われます。または、バイナリを修正して難読化前の制御構造を再現するバイナリパッチ手法を用います。
ファームウェアが暗号化されている場合は、動的解析でメモリ上に展開された復号後のコードをダンプする手法が有効です。デバイスは起動時に復号してメモリに展開するため、その瞬間にJTAGデバッガでメモリダンプを取れば、平文のバイナリを入手できます。ただし、この手法は対象デバイスへの物理的アクセスと、JTAGピンの特定・接続という専門的なハードウェア作業を伴います。
法的リスクの回避:著作権法・不正競争防止法とクリーンルーム手法
C言語バイナリのリバースエンジニアリングを実施する前に、法的リスクの評価と回避策を準備することが不可欠です。
特に第三者が開発したソフトウェアを解析する場合は、著作権法・不正競争防止法・EULAとの関係を正確に把握しておく必要があります。
EULAに「リバースエンジニアリング禁止」条項がある場合でも、互換性確保のために必要不可欠なときや、独占禁止法上の不公正取引に該当するときは、当該条項が無効となる可能性があります。
クリーンルーム手法の実務的な運用
平成30年の著作権法改正(第30条の4)により、非享受目的(マルウェア解析・セキュリティ調査・仕様書復元など)のリバースエンジニアリングは原則として合法化されました。ただし、解析で得た情報をもとに競合製品を開発すると著作権侵害のリスクが生じるため、クリーンルーム手法の採用が法務上の最善策です。
解析チーム(Dirty Room)と開発チーム(Clean Room)を完全に分離します。解析チームは対象バイナリから機能仕様書を作成し、開発チームはその仕様書のみを参照して新実装を行います。元のバイナリや中間生成物には、一切触れません。EULAに「リバースエンジニアリング禁止」条項がある場合でも、互換性確保に必要不可欠な場合や、独占禁止法上の不公正取引に当たる場合は、無効となる可能性があります。
1980年代のフェニックス・テクノロジーズとIBM BIOSの互換BIOS開発は、歴史的な成功事例です。法務・仲介担当者が仕様書に著作権保護対象の「表現」が混入していないかを検査し、「機能」と「アルゴリズム」の仕様だけを開発チームに伝えました。これにより、著作権侵害(依拠性)の成立を完全に回避しました。
非享受目的の立証方法と解析記録の整備
著作権法第30条の4の「非享受目的」と認められるには、解析プロセスの記録整備が重要です。具体的には、解析専用のPCや仮想環境で実行し、通常業務環境から隔離して、「業務目的での享受」ではないことを示します。
さらに、解析の開始から完了まで、目的・手順・発見事項を詳細なレポートとして記録し、「機能享受目的ではない」ことを事後に立証できる状態を保ちます。この記録は、万が一法的問題が生じた際の証拠としても機能します。
不正競争防止法(営業秘密)の観点では、対象が「秘密管理性・有用性・非公知性」の三要件を満たす営業秘密なら、技術的に可能でも不正競争行為として問われるおそれがあります。解析着手前に、法務部門または専門の弁護士へ確認することを強く推奨します。
外注 vs 内製の判断軸:C言語リバースエンジニアリングの適切な進め方
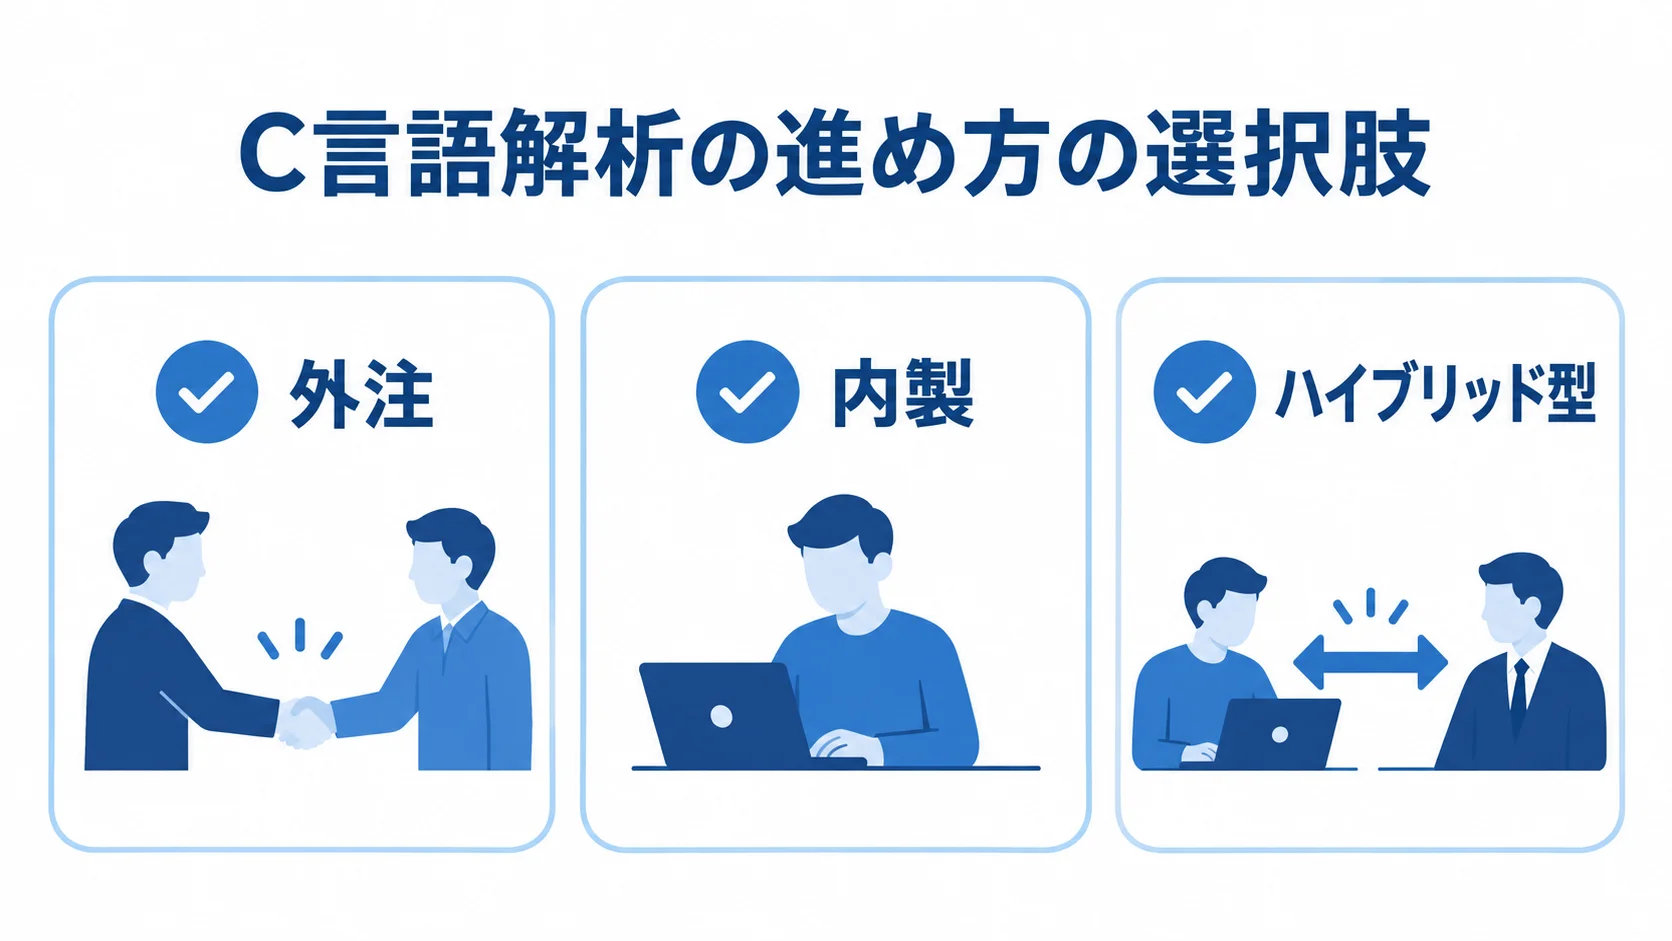
C言語のリバースエンジニアリングを外注するか自社で内製するかは、保有技術力・セキュリティ要件・コスト・スケジュールの4軸で判断します。
多くの企業にとって、少なくとも部分的な外注は現実的な選択肢となります。
外注が適しているケースと選定時のチェックポイント
外注が適しているのは、IDA ProやGhidraを日常的に使いこなせるリバースエンジニアが社内にいない場合や、組み込みデバイスのJTAG/UART接続という物理的作業が必要な場合です。そのほか、クリーンルーム手法の法務運用体制を自社で構築できない場合や、第三者評価のエビデンスが必要なセキュリティ脆弱性診断の場合も、外注が現実的です。
ベンダーを選ぶ際は、C言語バイナリ解析の実績(業種・規模・対象プラットフォーム)を具体的に確認し、組み込みやIoTファームウェアの解析経験を持つエンジニアが在籍しているかを必ず見てください。費用の目安は、LOC従量課金による仕様書復元で基本料金30万円(4,000行まで)、超過分は1行あたり50円が相場です。
規模の大きなモダナイゼーション全体では、手法によってリホスト(数千万〜1億円台)からリビルド(5億円以上)まで幅があります。セキュリティ脆弱性診断目的のバイナリ解析は、手動診断で50〜150万円が標準的です。急ぎの案件では、通常の20〜60%増の特急料金が加算されます。
内製が適しているケースとスキル要件
自社内製が適しているのは、解析対象が自社開発のシステムで機密保持が絶対条件となる場合です。継続的なセキュリティ診断業務(年数回のファームウェア検査)として内部化したほうがコスト効率が良い場合や、教育目的で社内のセキュリティ人材を育成したい場合も該当します。
内製に必要なスキルは、アセンブリ言語の読み書きと、Cのメモリモデル(スタック・ヒープ・セグメント)の深い理解です。加えて、IDA ProまたはGhidraの習熟、デバッガ(GDB/x64dbg)の操作も求められます。組み込み向けには、UART/JTAG接続の実務経験も挙げられます。
現実的な選択肢として、バイナリの取得・初期解析を内製し、詳細な仕様書化やDesign Recoveryを外注するハイブリッド型が増えています。機密情報はバイナリのまま社内に保持し、専門スキルが必要な深掘り解析のみ外部の専門家に依頼します。これにより、セキュリティと効率を両立できます。
まとめ
C言語のリバースエンジニアリングは、ネイティブコードへのコンパイルという特性上、中間言語系と比べて本質的に難易度が高くなります。IDA ProやGhidraによるバイナリ解析、UART/JTAG経由のファームウェアダンプ、制御フロー平坦化への対処など、C言語固有の専門知識が求められます。
それでも、体系的な6工程(目的定義→ツール準備→静的解析→動的解析→Design Recovery→成果物化)を踏めば、組み込みシステムや産業機器のブラックボックス化した仕様を確実に復元できます。
法的リスクについては、著作権法第30条の4の非享受目的要件を満たすための記録整備と、競合製品開発を伴う場合のクリーンルーム手法の適用が基本原則です。
外注か内製かは、保有スキル・機密性・コストのバランスで決め、ハイブリッド型も有力な選択肢です。
C言語リバースエンジニアリングの進め方に迷ったら、まず専門のベンダーに相談して解析難易度の見立てを聞くことをお勧めします。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。