
ビデオ通話アプリの開発・導入で起きる失敗は、配信方式の設計、リリースと運用、コスト見積もり、開発体制と発注の4つの面に分けられます。とくに、リリース初日に炎上して信頼を失ったサービスは数多く存在します。
各失敗には原因とあわせてリカバリー策も併記しています。全体像から知りたい方は、先にビデオ通話アプリ開発の完全ガイドをご覧ください。
スマホアプリ開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「スマホアプリ開発の完全ガイドブック」で詳しく解説しています。
配信方式の設計ミスによる失敗
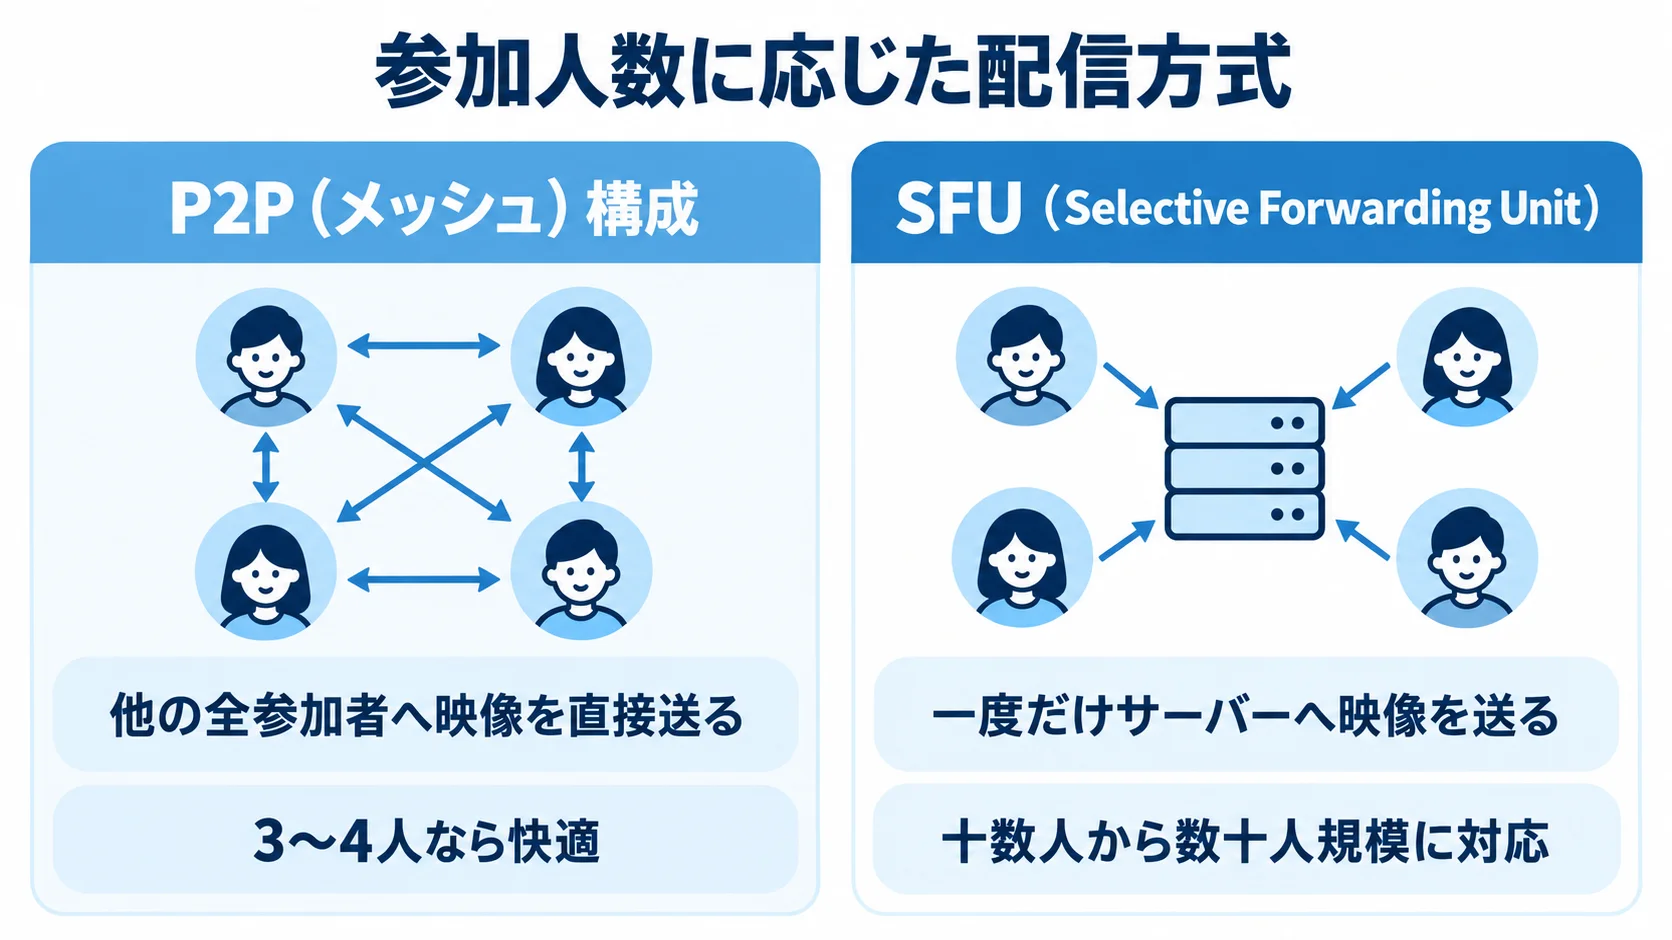
ビデオ通話アプリの失敗で最も根が深いのが、配信方式の選定ミスです。配信方式は開発の最初期に決まるため、誤ったまま進むと作り直すしかなくなり、多大な手戻りコストが生じます。とくに、リアルタイム通信の特性を理解しないまま設計に入ると、この段階でつまずきます。
P2P構成のまま人数を増やして破綻する失敗
なかでも典型的な失敗が、WebRTCのP2P(メッシュ)構成のまま参加人数を増やそうとして破綻するケースです。P2Pでは各端末が他の全参加者へ映像を直接送るため、参加者が増えるほど送信数が爆発的に増え、端末のCPUとアップロード帯域がたちまち限界に達します。
3〜4人なら快適でも、10人になると映像がカクつき、音声が途切れ、端末が発熱して使い物にならなくなります。また、「少人数で動いたから大丈夫」と判断してリリースし、利用シーンが広がった途端に破綻する失敗は、今も後を絶ちません。
リカバリー策は、最大同時接続人数を最初に定義し、それに応じてSFU(Selective Forwarding Unit)やMCU、外部SDKを選ぶことです。SFUは各端末が一度だけサーバーへ映像を送る方式で、十数人から数十人規模に対応できます。すでにP2Pで作り込んでしまった場合でも、配信基盤を抽象化していれば、SFUへの移行は比較的スムーズです。
逆に、特定の方式にべったり依存した作りだと、移行は大規模な作り直しになります。設計段階で人数の上限を見据え、付け替え可能な構造にしておくことが最大の防衛策です。
参加人数が増えても崩れない配信になっているかは、発注前に次の2点で確かめられます。
- 最大同時接続人数:想定する人数を先に決め、その人数に合う配信方式が選ばれているか
- 配信方式の付け替え:SFUなどへ移れるよう、配信基盤を抽象化した設計になっているか
配信基盤の単一依存による全断リスク
もう一つの設計ミスが、配信基盤やSDKを一つに依存させることです。一つのクラウドサービスや一つのSDKにすべてを任せていると、その基盤に障害が起きた瞬間、サービス全体が止まります。
DeNAのPocochaは、Amazon IVS単一依存のリスクを重く見て、Tencent CSS等を併用する冗長構成へ移行しました(出典:DeNA技術事例)。全断リスクを先回りして避けるための判断でした。配信は、どれだけ堅牢な基盤でも障害をゼロにはできないという前提に立つ必要があります。
リカバリー策は、配信基盤やTURN/STUNサーバを複数系統で持ち、障害時に自動でフェイルオーバーできる構成にすることです。DeNAは、BroadcastOriginManagerという共通インターフェースとStrategyパターンで配信基盤を動的に選択しています。さらに、クライアント側もFactoryパターンでSDKを切り替えられるようにしており、この設計は冗長化のお手本です。
最初は単一の基盤でも、抽象化された設計にしておけば、後から冗長系を追加できます。可用性は事後に足すのが難しいため、設計段階で織り込むことが肝心です。事例の詳細は、関連記事『ビデオ通話アプリの導入/開発事例や活用/成功事例について』もあわせてご覧ください。
冗長化の備えは、次の2点で確かめられます。
- 冗長化の範囲:配信基盤とTURN/STUNサーバが、どこまで複数系統で用意されているか
- 障害時の切り替え:障害が起きたとき、人の手を介さずに別の系統へ移れる仕組みか
リリース・運用フェーズの失敗と炎上
設計を乗り越えても、リリースと運用のフェーズには別の落とし穴が待っています。とくにビデオ通話アプリは、多くのユーザーが接続するピーク時に負荷が集中するため、平常時には見えなかった問題が一気に噴出します。
リリース初日のアクセス集中による炎上
最も痛ましい失敗の一つが、リリース初日のアクセス集中でサービスが落ちる炎上です。期待を集めて華々しくローンチしたものの、想定を超えるユーザーが一斉に接続し、データベースがデッドロック(複数の処理が互いの完了を待ち合って停止する状態)を起こして全面ダウンします。
せっかく集めた初日のユーザーが「つながらないアプリ」という第一印象を抱いて離れてしまい、その後の挽回は容易ではありません。話題性が高いサービスほど、この初日炎上のダメージは深刻です。
リカバリー策の核心は、リリース前の負荷テストです。本番の前に検証しておけば、初日の破綻を防げます。
あわせて、急激な負荷に対してサーバーを自動で増強するオートスケールの設計や、データベースのコネクション管理・ロックの見直しも欠かせません。負荷テストを要件として検収条件に含めることが、初日炎上を防ぐ確実な手段です。要件化の方法は、関連記事『ビデオ通話アプリのRFP/要件定義書/提案依頼書について』もあわせてご覧ください。
初日の集中アクセスに備えるには、次の2点を発注時の要件として押さえておきます。
- 負荷テストの条件:想定ピークの同時接続数と、遅延・パケットロス・エラー率の目標値
- データベースの設計:コネクション管理とロックの見直しが、開発の範囲に入っているか
音声途切れ・つながらない品質トラブル
運用フェーズで地味に効いてくるのが、音声途切れや「そもそもつながらない」という品質トラブルです。stand.fmは当初WebRTC単独で音声途切れに悩み、その原因が端末側かネットワーク側かを切り分けられませんでした(出典:Agora導入事例)。品質トラブルの厄介さを象徴する事例です。
原因が特定できないまま放置されると、ユーザーは静かに離れていきます。また、TURN/STUNサーバを用意していないと、企業ネットワークやモバイル回線の一部のユーザーが「どうしてもつながらない」状態に陥ります。
リカバリー策は二つあります。
第一に、品質を計測できる仕組みを持つことです。遅延・パケットロス・音声レベルを数値で見られれば、障害の原因を切り分けられます。たとえばstand.fmは、Agoraへ切り替えてデシベルレベルで音声を把握できるようにし、最大70%のパケットロス下でも遅延2秒以下を達成しました(出典:Agora導入事例)。
第二に、自前実装で品質が安定しない場合は、音声映像処理に強い外部SDKへの切替を検討することです。品質トラブルは「我慢して使ってもらう」ものではなく、計測と技術選定で構造的に解消すべき課題です。
品質の確認は、次の2点が中心です。
- 計測の仕組み:遅延やパケットロスの数値を、運用中に担当者が見られる状態になっているか
- 外部SDKへの切替:自前実装で安定しない場合に備え、代替の選択肢を計画に入れておく
コスト見積もりの抜けによる失敗
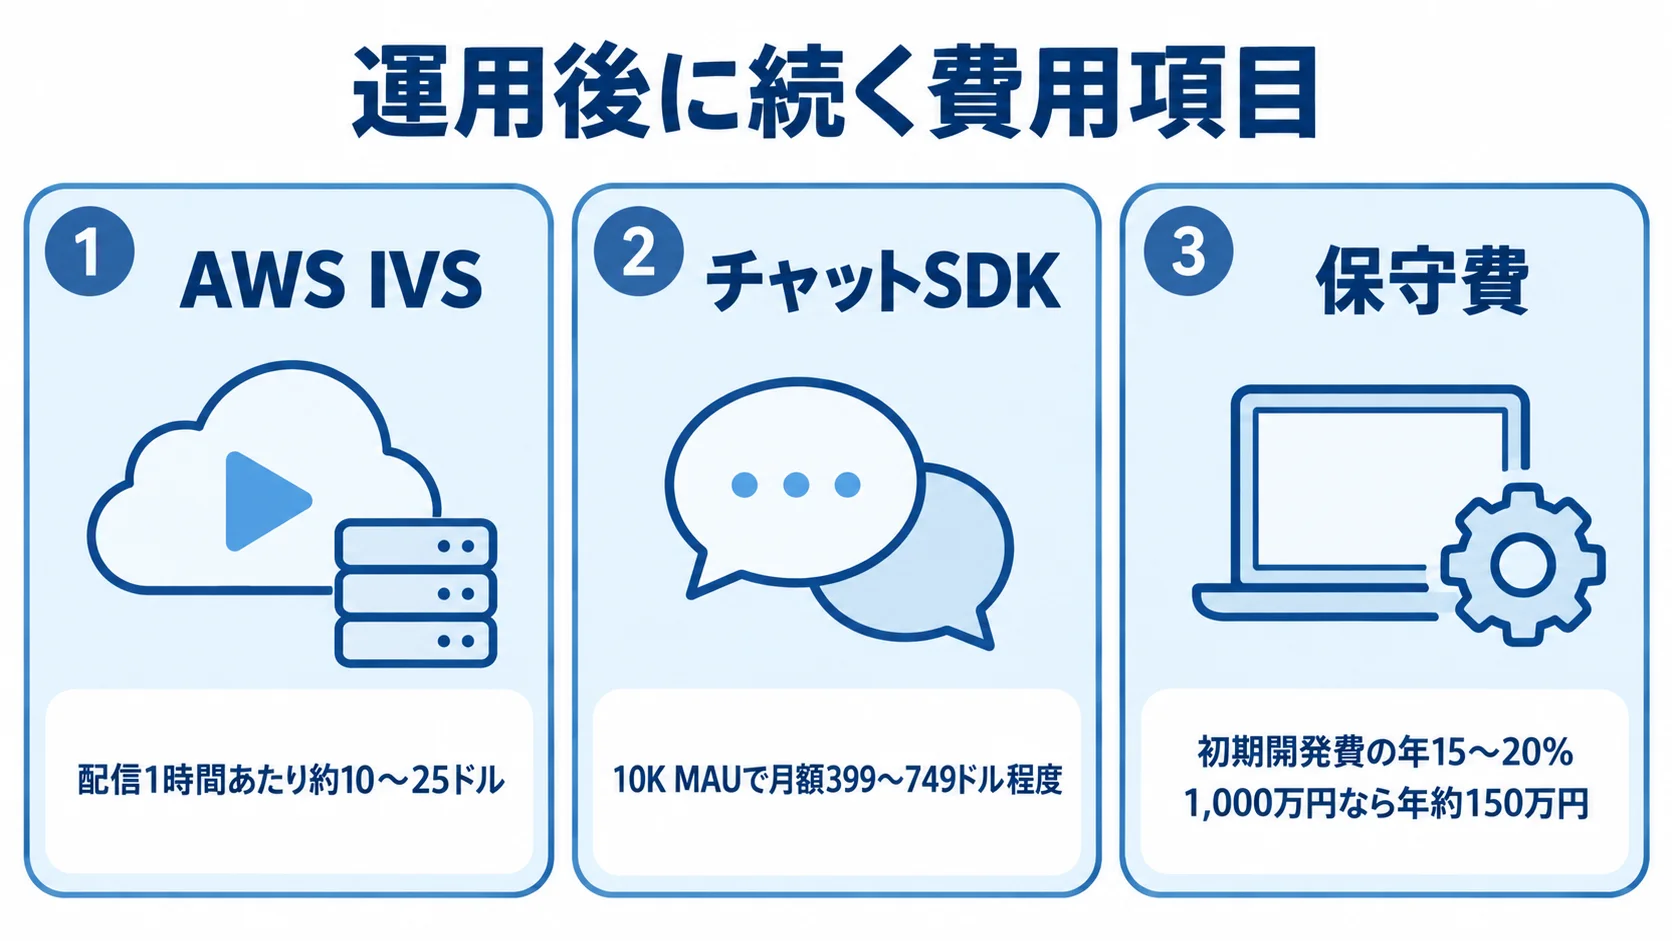
技術的な失敗と並んで多いのが、コスト見積もりの抜けです。初期の開発費だけに目を奪われ、運用後に継続的に発生する費用を見落とすと、サービスの収益構造そのものが破綻します。ビデオ通話アプリは、トラフィックに比例してコストが増える性質を持つため、特に注意が必要です。
ランニングコストと録画費用の計上漏れ
見落とされがちなのが、トラフィックに連動するランニングコストです。ライブ配信を伴う場合、AWS IVSは配信1時間あたり約10〜25ドルといった水準で、利用が増えるほど費用が膨らみます。
外部SDKも、MAUに応じて月額がかかります。たとえば、チャットSDKでは10K MAUで月額399〜749ドル程度です。さらに保守費が初期開発費の年15〜20%(1,000万円なら年約150万円)かかります。これらを初期見積もりに含めていないと、運用開始後に「思った以上に毎月の費用が重い」という事態に陥ります。
とくに録画機能は、ストレージとサーバー費用が利用量に比例して際限なく膨らむ落とし穴です。「とりあえず全通話を録画する」という設計にすると、データ量の増加に合わせてコストが段階的に積み上がります。
リカバリー策は、DAU 1万人時のAWS転送料やDB費用を月額でシミュレーションしておくことです。録画は保存期間とアクセス範囲を絞り、必要最小限に設計します。手法ごとのコスト比較は、関連記事『ビデオ通話アプリ開発/導入のメリット/デメリット/効果と判断基準について』もあわせてご覧ください。
継続費用の計上漏れを防ぐには、見積もりに次の2点が入っているかを確かめます。
- 運用費の項目:トラフィック連動の費用と、SDKの月額・保守費が見積もりに入っているか
- 録画の範囲:保存期間とアクセス範囲を絞り、録画する通話を必要最小限にする
ストア審査の長期化と遅延コスト
もう一つの見落としが、アプリストアの審査リスクです。ビデオ通話やマッチング要素を含むアプリは、安全性やプライバシーの観点から審査が厳しくなりがちで、一発で承認されないことも珍しくありません。
とくに出会い系の要素を含む場合、初回の一発承認はほぼなく、平均2〜3回却下されたうえで、本番公開まで2〜3ヶ月のバッファを要することもあります。問題は、この審査待ちの期間中も、サーバー費用やSDKの月額が発生し続ける点です。
リカバリー策は、審査の遅延をあらかじめスケジュールと予算に織り込むことです。本番公開まで2〜3ヶ月の余裕を見て、その間のランニングコストも計上しておけば、資金計画が狂いません。
長期のリジェクトに備えて、PWA(プログレッシブWebアプリ)などストアを介さない代替プランを用意しておくと、事業の立ち上げを止めずに済みます。審査は「落ちる前提」で計画しておくことで、遅延コストによる失敗を防げます。
審査の遅れに備えるには、次の2点を押さえておきます。
- 公開までの余裕:本番公開まで2〜3ヶ月を見込み、その間の費用も予算に含めているか
- 代替の立ち上げ方:ストアを介さない方法を、審査が長引いたときの手段として決めておく
開発体制・発注の失敗と作り直し
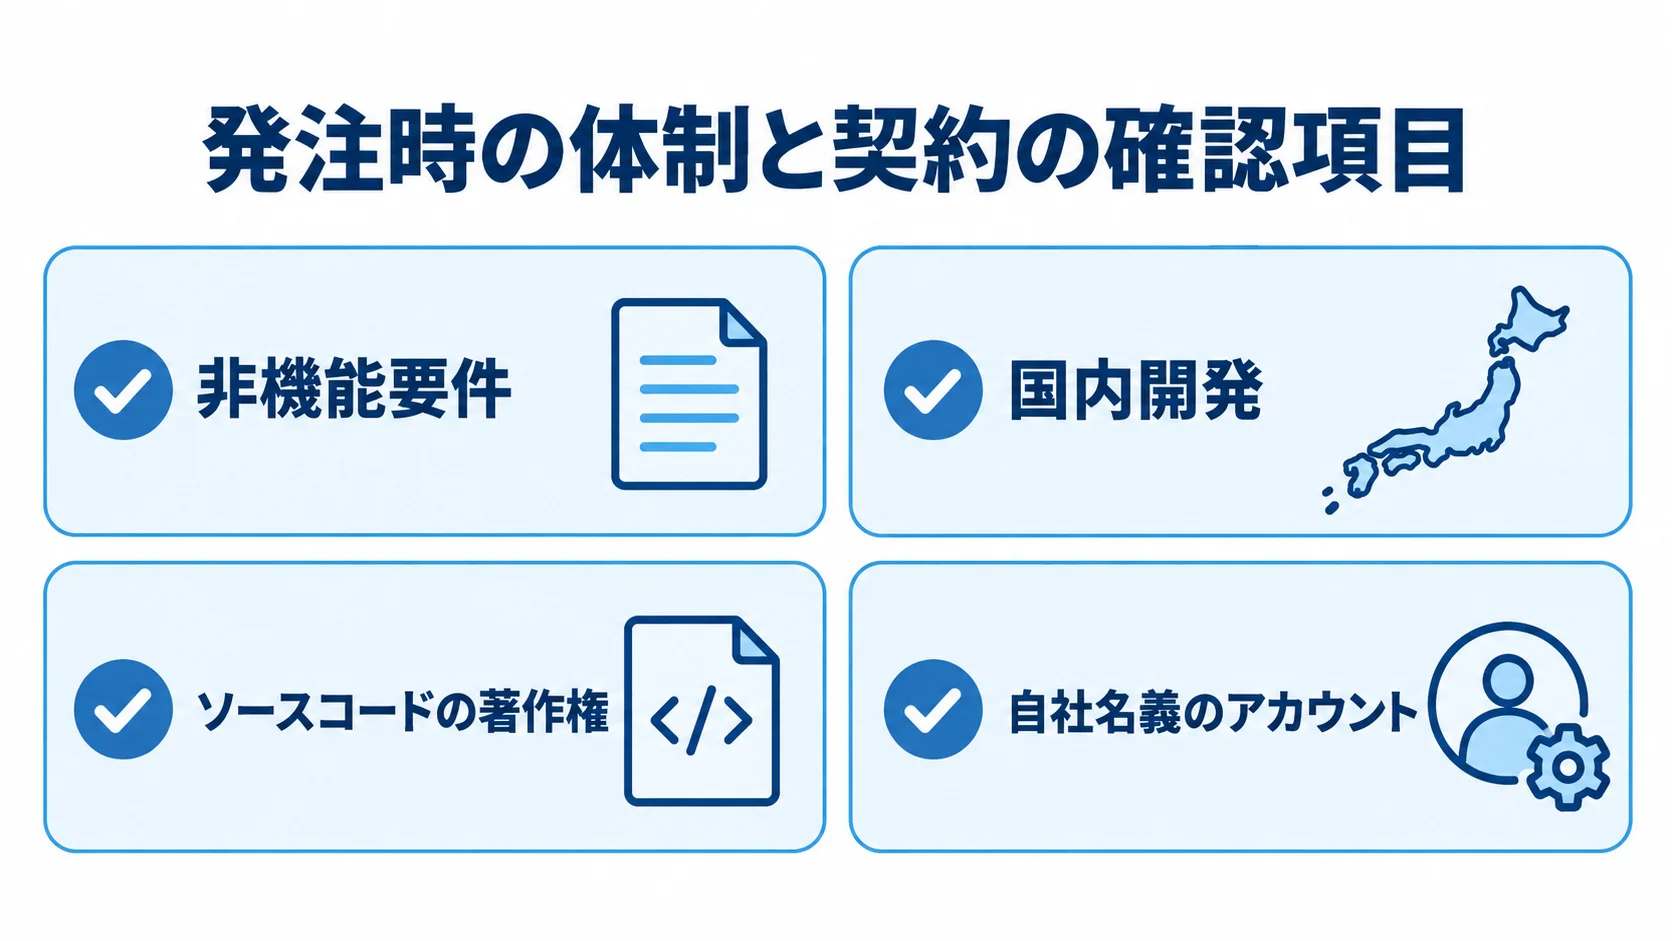
技術やコストだけでなく、誰にどう発注するかという体制面の失敗も深刻です。発注先の選定や進め方を誤ると、完成したものが使い物にならず、大規模な作り直しを強いられることがあります。
オフショア丸投げの仕様解釈違いによる作り直し
コスト削減を狙って海外オフショアに開発を委託した結果、仕様の解釈違いから期待と異なるものが納品され、作り直しになる失敗があります。
とくにリアルタイム通信のような難易度の高い領域では、曖昧な仕様書を丸投げすると、品質の認識がずれたまま開発が進みます。その結果、完成後に「これでは使えない」と発覚します。
安く作るつもりが手戻りで結局割高になるという、典型的な失敗です。さらに、言語や時差、開発文化の違いも、認識のずれを広げる要因になります。
リカバリー策は、非機能要件を数値で明確にし、検収条件まで落とし込んでから発注することです。「同時接続◯人で遅延◯ms以下なら合格」といった定量基準があれば、解釈の余地が減ります。
また、品質が事業の生命線となるコア部分は、コミュニケーションを密に取れる国内開発で進める、という切り分けも有効です。riplaのような国内のフルスクラッチ受託であれば、仕様の詰めと品質の擦り合わせを密に行えます。コストだけで発注先を選ぶのではなく、難易度とコミュニケーションコストを踏まえた体制設計が重要です。
仕様の解釈違いを防ぐには、発注時に次の2点が決まっているかを確かめます。
- 非機能要件:同時接続数や遅延の上限を数値で示し、検収の条件にしているか
- 国内で進める範囲:品質が事業の生命線となるコア部分を、どこまで国内の体制で担うかを決めておく
ベンダーロックインと権利未取得のリスク
発注時の取り決め不足が、後から重大なリスクになることもあります。ソースコードの著作権やインフラのアカウントがベンダー名義のままだと、別のベンダーへ乗り換えたいときや自社で改修したいときに身動きが取れません。これがベンダーロックインです。
最悪の場合、サービスを事実上人質に取られ、不本意な条件で契約を続けざるを得なくなります。開発が順調なうちは問題が表面化しません。しかし、関係がこじれたり、ベンダーの体制が変わったりした瞬間に致命傷になります。
リカバリー策は、契約の段階でソースコードの著作権を発注者に帰属させることです。あわせて、技術的なナレッジトランスファー(知識移転)を契約条件に含めれば、将来の体制変更にも耐えられます。
これらは開発が始まってからでは交渉が難しいため、RFPと契約の段階で前提にしておく必要があります。失敗の多くは技術ではなく、こうした契約と体制の詰めの甘さから生まれます。
発注時に契約へ入れたい点は、次の2つです。
- アカウントの名義:クラウドアカウントとドメインが、自社名義で保有されているか
- 引き継ぎの範囲:設計書と運用手順書の納品、技術移転が契約の条件に入っているか
まとめ
ビデオ通話アプリ開発・導入の失敗を振り返ると、その多くは技術力不足ではなく、リアルタイム通信特有のリスクを設計段階で見落としたことに起因します。
P2P構成の設計ミス、配信基盤の単一依存による全断、リリース初日の炎上といった失敗は、最大同時接続数の定義、冗長化、負荷テストで避けられます。さらに、ランニングコストや録画費用の計上漏れ、ストア審査の長期化、オフショア丸投げの作り直しは、TCOの全計上や契約での自衛という先回りで回避できます。
失敗には必ずリカバリー策があるため、起こりうる前提で設計に織り込むことが何より大切です。「うまくいく前提」ではなく「壊れる前提」で備えることが、失敗を避けるうえでの要になります。
stand.fmはWebRTC単独の限界をSDK切替で乗り越え、DeNAは単一依存を冗長構成で解消しました(出典:Agora導入事例、DeNA技術事例)。
先人の失敗から学び、設計・運用・コスト・体制の各面で防衛策を講じてください。riplaはフルスクラッチ受託と国内開発を組み合わせ、失敗を前提に冗長化と負荷検証を織り込む設計で、つまずきにくいビデオ通話アプリの開発を支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼開発を相談する前に読みたい無料ホワイトペーパー
・スマホアプリ開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。