
Amazon Bedrockのシステム開発は、要件整理から定着まで、6つのフェーズに分けて進めます。業務とデータを整理してから構成を選び、設計、評価、稼働まで段階的に進めると、PoCで止まらず業務に定着しやすくなります。
▼全体ガイドの記事
・Amazon Bedrockのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Amazon Bedrockのシステム開発の全体像
Amazon Bedrockは、AnthropicやAmazonなど複数企業の基盤モデルに、統一APIからアクセスできるフルマネージドサービスです。また、AWS公式ドキュメントによると、100以上の基盤モデルをサポートしています(出典: AWS「概要 – Amazon Bedrock」、2026年8月確認)。
業務システムとして使うには、Bedrockとの契約に加えて、システム全体を設計しなければなりません。画面や認証、データ連携、検索に加えて、ログ、評価、保守まで含めて設計します。
Bedrockで何を作るかの分解
導入対象の候補としては、次のような業務が考えられます。
- 社内情報:社内文書の検索
- 商談記録:商談や会話の要約
- 文書作成:メールや提案書の下書き作成
- 顧客対応:問い合わせへの一次回答
- 営業管理:リードや商談の分類
Agents for Amazon Bedrockなどを使うと、CRM更新、チケット起票、社内検索など複数の処理を組み合わせられます。
初期から自動更新を任せると、誤った顧客情報を登録するリスクがあります。そのため、初期段階は回答案を提示し、人が承認してから登録する流れで始める方が安全です。
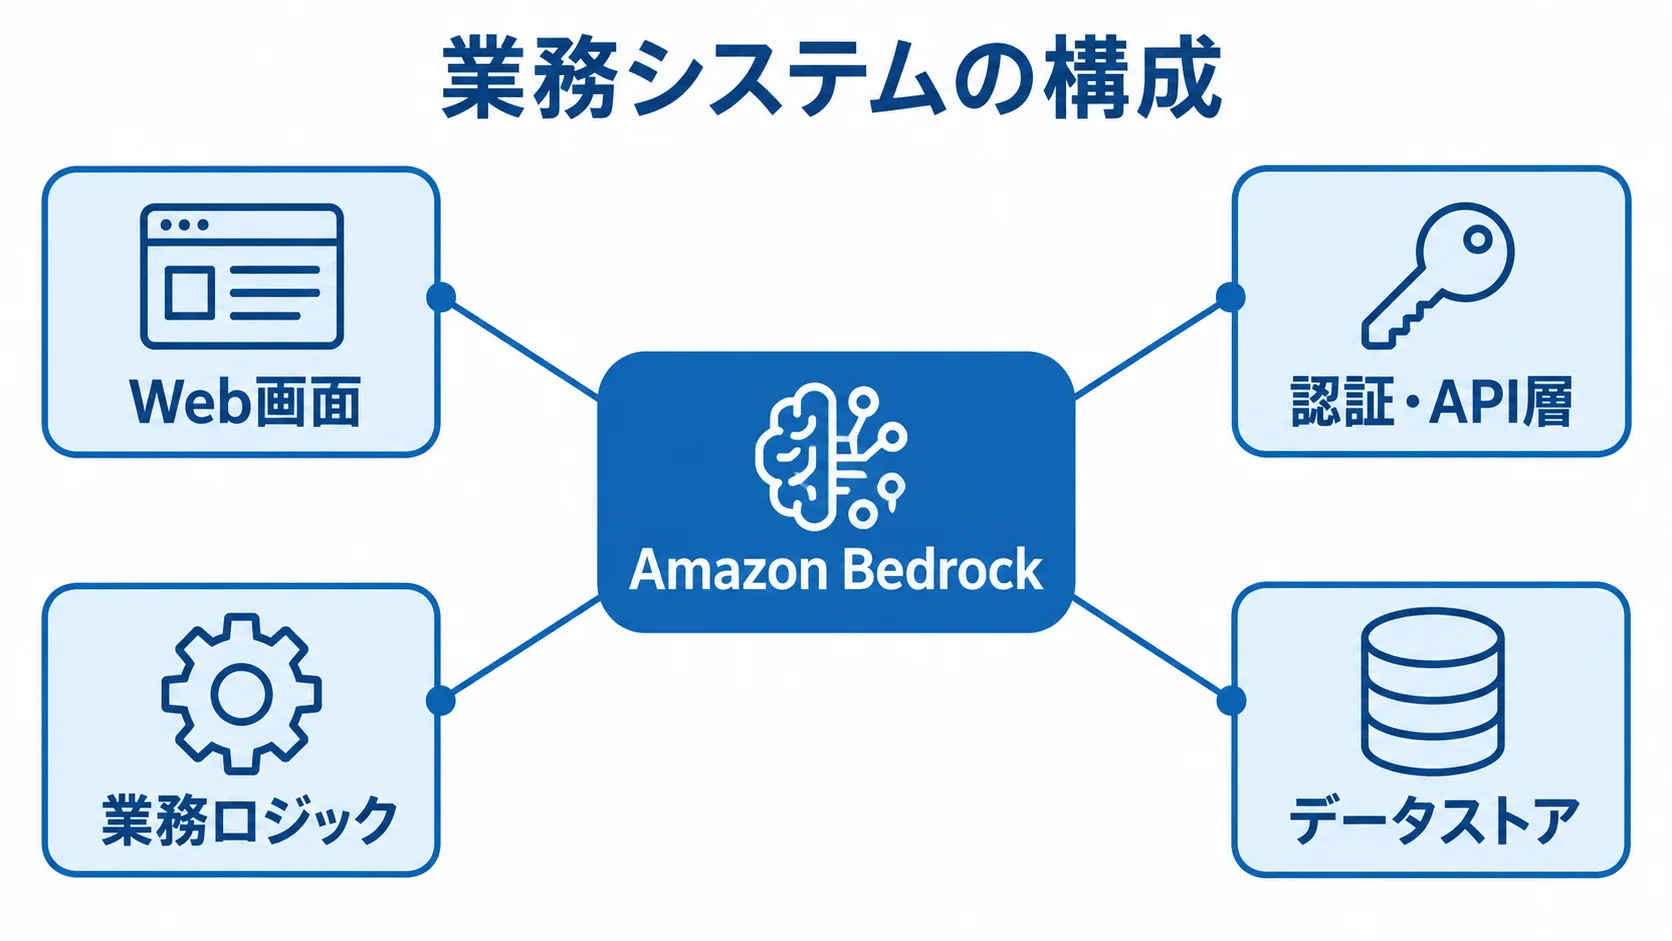
構成は、利用者向けWeb画面、認証・API層、業務ロジックから成ります。これらにAmazon Bedrockを組み合わせ、データはAmazon S3などのデータストアで扱います。
さらに、Knowledge Basesや検索エンジンを構成に含めます。CRM・SFA・MA連携や、IAM・KMS・CloudTrail・監視も含みます。
顧客情報を扱う場合は、所属や担当顧客に応じて検索結果を絞る権限を、きちんと引き継ぐ設計が欠かせません。
RAG・AIエージェント・既存SaaS連携の使い分け
構成は、扱う情報が社内資料か、業務処理か、外部情報かで選びます。その際は、最新機能を使うかよりも、業務上どこまで自動化するかを基準にします。
- 根拠付きの回答:社内資料や商品情報に対してRAGを検討
- 業務処理の実行:複数システムをまたぐ場合は、AIエージェントが候補になる
- 最新Web情報の利用:AgentCore Web Searchで最新情報を検索し、出典URLと公開日も回答に含める
RAG(検索拡張生成)は、資料をS3などに保存しておき、検索で見つけた関連箇所をモデルに渡して回答させる方式です。
特に、価格表や営業資料の更新頻度が高い企業では、ファインチューニングより、データ更新と検索権限の整備のほうが保守しやすい場合があります。
AIエージェントを使う場合は、実行権限と承認の仕組み、失敗時の取り消し、監査ログを用意します。
Amazon Bedrock AgentCoreは2025年10月に一般提供され、東京を含むリージョンで利用できます。AgentCoreは、実行、認証、メモリなど、本番運用に向けた基盤を備えています(出典: AWS「Amazon Bedrock AgentCore、東京を含むAWSリージョンで一般提供開始」、2025年)。
AgentCore Web Searchは2026年6月に一般提供されました。ただし、社内の顧客情報の検索とは分けて考えます。
外部情報を使うなら、利用目的と取得先、著作権を要件に含めます。また、検索回数に応じた料金と、回答に表示する出典の確認方法も決めておきます。
利用目的や料金、出典の条件を決めておけば、営業調査や顧客対応への展開を安全に検討できます(出典: AWS「Amazon Bedrock AgentCoreでのWeb Search」、2026年6月)。
業務KPIとデータによる成功条件
導入前に、業務時間や回答品質などの成功指標を決めておきます。
- 時間と業務量:商談後の入力、資料検索、一次回答作成の所要時間
- 利用結果:再質問率と、提案書作成のリードタイム
- 回答品質と費用:正答率、根拠提示率、回答してはいけない質問の拒否率、応答時間、1回答あたりのAWS利用料が評価の対象
どれだけ短縮できれば成功かは、導入前に目標値として置いておきます。
データは、重複、表記揺れ、欠損の有無を確かめます。そのうえで、古い資料や、権限が不明なファイル、退職者が所有するデータも洗い出します。特に、現場のExcelや個人フォルダをそのまま取り込むと、AIの混乱を高速化するだけになります。
モデルを選ぶより先に、データの責任者と更新頻度を決めておきます。さらに、公開範囲と廃棄ルールも定めます。
Amazon Bedrockのシステム開発の進め方
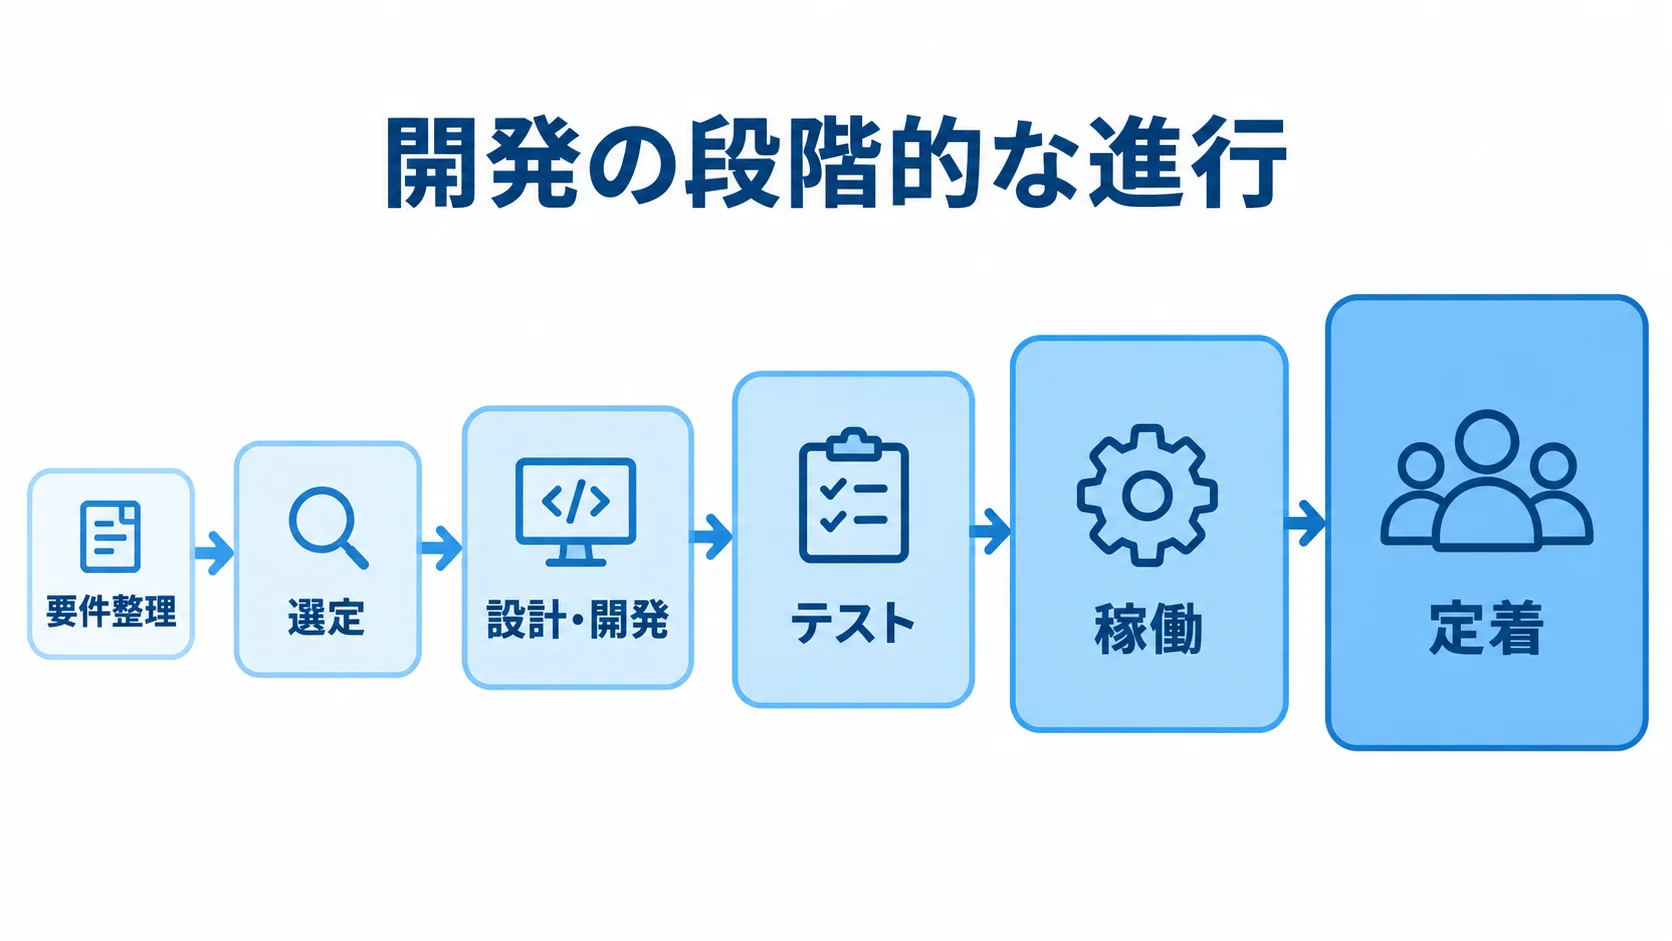
開発は6つのフェーズに分けて進め、最初は要件整理と選定を行い、続いて設計・開発に進みます。その後のテスト、稼働、定着は、下の各フェーズで順に説明します。PoCは短い期間で始めても構いませんが、各段階で次へ進む条件は決めておきます。
PoCの画面が動いただけで成功とはせず、本番データや権限、運用担当者まで確かめてから投資を判断します。
1. 要件整理:業務課題と利用範囲
まず、利用部門と利用者、対象業務を決めます。次に、入力データと期待する出力、最終判断者を整理します。
- 業務を具体化:「営業を効率化する」は広すぎるため、実行する業務の単位まで落とし込む
- 対象と権限:対象業務と対象外の業務、利用者ごとの役割と権限を決める
- データと安全条件:参照先と更新責任を決め、承認箇所や停止条件も定める
たとえば、「商談後30分以内に議事録を構造化し、次回アクションを登録する」のように定義します。導入前に現状の作業時間と件数を測り、その数字をもとに導入後の目標値を置きます。
CRMへの書き戻しは、回答生成と分けて要件に書いておきます。そうすると、事故が起きたときの影響を抑えやすくなります。
2. 選定:モデルと構成の比較
モデルとシステム構成は、業務に必要な条件をそろえて比べます。
- モデル性能:日本語の自然さと業務上の正確性を比べ、回答速度とコンテキスト長も確かめる
- 利用条件:入出力トークン料金と利用リージョンを確認し、画像・音声対応やガードレールとの組み合わせも見る
- システム構成:既存CRM・SFAへの追加か、新しいクラウド画面か、閉域網や基幹連携を含むハイブリッドかから選ぶ
分類や要約には小型モデルを、複雑な提案や判断支援には高性能モデルを使い分けると、費用を抑えられます。
候補モデルの比較表や想定プロンプト、データフローは、残しておきます。権限マトリクスや概算利用料、採用しなかった案の理由も記録します。
モデル変更用の抽象化を設けておくと、価格改定や提供終了にも落ち着いて対応できます。
3. 設計・開発:データと権限を中心とした作り方
設計では、処理の流れと情報保護の両面を具体的に決めます。
- データ処理:取り込みから回答生成までの流れと、出典表示やエラー処理、ログ保存を定義する
- セキュリティ:最小権限とMFAを設計し、TLS・KMSの暗号化やS3制御、CloudTrailの監査も組み込む
- 情報保護:ログの個人情報マスキングとプロンプトインジェクション対策を設ける
RAGでは、文書の分割単位や更新時の再インデックス方法が、回答の品質を左右します。根拠をどう表示するかも、設計で決めておきます。
AWSの資料では、入出力データを基盤モデルの学習に使わないことなどが説明されています(出典: AWS「データ保護 – Amazon Bedrock」、2026年8月確認)。
自社の保持期間や委託先、リージョンは、契約と設定の両面で確認します。バックアップとログの扱いも、確認の対象に含めます。
4. テスト:正確性・安全性・費用の検証
実業務から、十分な種類の質問と正解例を用意します。そのうえで、品質・安全性・費用の合格基準を決めます。
- 質問パターン:通常の質問に加えて、曖昧な質問や古い資料を前提にした質問も試す
- 安全性:権限外・個人情報を含む質問、悪意ある指示、外部サイトへの誘導への耐性を確かめる
- 合格基準:正答率や根拠、拒否性能に加えて、個人情報の露出、応答時間、エラー率、1回あたりの費用も定める
AWSは2025年3月にAmazon BedrockのRAG評価を一般提供し、検索の関連性や回答の正確性を評価できるようになりました。カバレッジや完全性、忠実性も対象になります。
RAG評価は、拒否や危険性についても評価できます(出典: AWS「Amazon Bedrock now supports RAG Evaluation」、2025年)。
評価機能を使う場合も、業務固有の正解データと、人によるサンプル確認を組み合わせます。自動スコアだけで本番の可否を決めず、人の確認も含めて判断します。
5. 稼働:人が止められる仕組みでのリリース
本番は、一部の営業チームや限定データから始めます。そのうえで、利用者と担当者が運用を確かめられるようにします。
- 段階リリース:対象チームやデータを限定して開始
- 利用者の支援:回答評価や誤回答の報告、人への引き継ぎ手順の用意
- 重要処理の承認:CRMへの自動書き込み、顧客への自動送信、価格・契約条件の確定を承認制にする
運用設計書には、監視項目とアラート基準、障害時の切り戻し方法を記載します。加えて、モデルやプロンプトの変更承認者と、AWS利用料の予算上限を決めます。問い合わせ窓口とデータ更新の責任者も、運用設計書に載せます。
AWS公式の中外製薬事例では、約6,000人が使う生成AIアシスタントを2か月で開発しました。
RAG活用例では約57%の業務削減効果が示されています(出典: AWS「中外製薬株式会社」、2026年8月確認)。ただし、既存基盤や専任体制がある事例のため、期間をそのまま自社の目標に流用しないようにします。
6. 定着:利用率と業務成果の改善
リリース後は、利用状況と業務成果を月次で確認し、改善へつなげます。
- 利用状況:利用者数と継続利用率
- 回答品質:再質問率と回答修正率
- 業務成果:業務時間と、商談後の入力完了率
利用が進まないときは、モデルを変える前に、画面との適合や入力項目の量を見直します。根拠の見やすさや、誤回答の報告しやすさも確かめます。
説明会では、できることとできないこと、確認事項を伝えます。プロンプトの書き方を個人の工夫に任せないため、質問テンプレートと確認手順を用意します。禁止入力やエスカレーション先も決めておきます。
Excelへ戻る原因は、現場の能力よりも、入力負担や業務ルールとの不整合であることが多くあります。そのため、利用者の声を改善バックログに取り込む体制が必要です。
Amazon Bedrockのシステム開発にかかる費用相場
Amazon Bedrockの一律な開発相場は、公式には公開されていません。そのため、費用は、開発会社への初期費用、AWS従量課金、データ整備・教育・保守改善に分けて考えます。
この後に示す金額は、リサーチノートのCRM・MA開発相場と、RAG・連携・評価を含む構成から算出した見積もりのたたき台です。金額を断定するものではなく、要件と前提をそろえて比べるためのレンジとして見てください。
開発会社へ支払う費用の幅(100万円台〜1億円超)
開発範囲に応じて、技術検証から本番まで費用の幅があります。
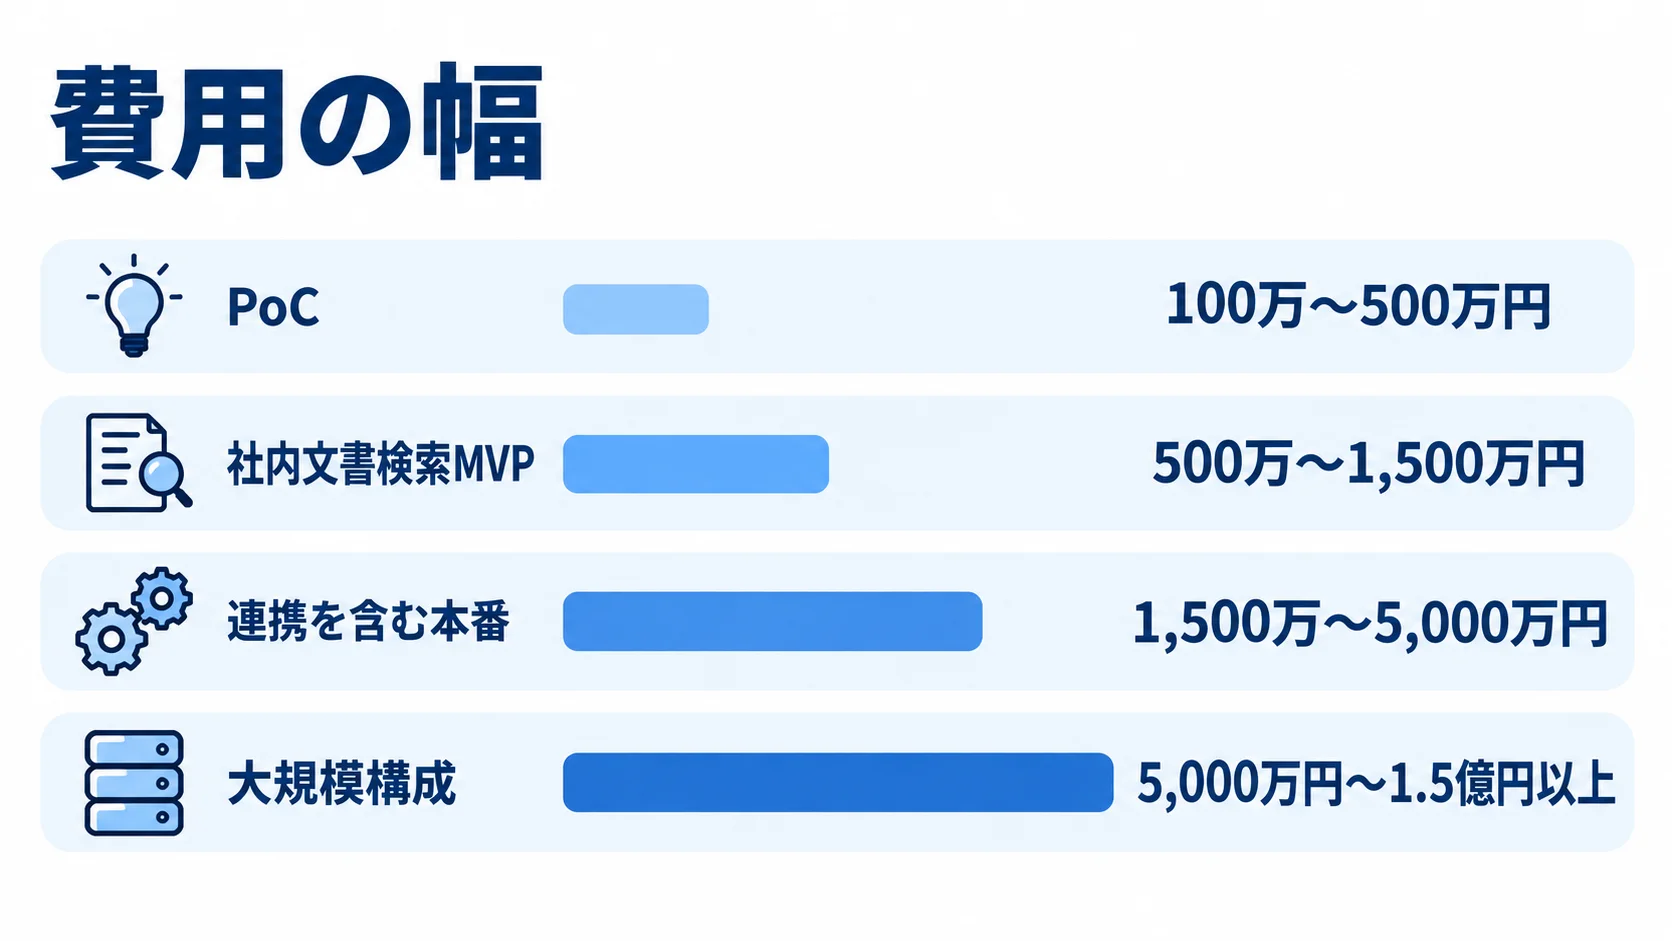
- PoC:1ユースケース、少量データ、最小限の画面なら100万〜500万円程度
- 社内文書検索MVP:認証から取り込み、検索、回答画面、基本ログ、評価までを含み、500万〜1,500万円程度
- 連携を含む本番:CRM・SFA・MA連携や権限分離を含み、承認と監査ログ、運用設計も加わって1,500万〜5,000万円程度
- 大規模構成:複数拠点・業務、基幹連携、閉域網、全社展開、厳格な可用性要件を含むと、5,000万円〜1.5億円以上の可能性
これらは推定値で、データ整備や権限、連携数などが前提に含まれています。
また、一般的な業務システムでは、過剰なカスタマイズによって2,000万円から4,200万円へ膨らんだ事例もあります(出典: リサーチノート内の営業・CRM・MA提供Q&A)。そのため、標準機能で済む範囲と独自開発する範囲は早めに分け、カスタマイズの膨張を防ぎます。
AWS利用料を左右するモデル・トークン数・検索基盤
AWS利用料は開発費とは別に見積もり、利用条件をそろえて試算します。
- モデル・リージョン:入出力トークンの単価がモデルやリージョンで異なるため、利用する条件で確かめる
- 利用ティア:Standard、Flex、Priority、Reservedなどから選ぶ
- バッチ推論:対象モデルでは、オンデマンドより50%低い価格になる場合がある
- 利用量:モデルと入出力の長さによって請求額が変わり、キャッシュやバッチ、呼び出し回数も影響する
AWS料金ページの価格条件を、見積もりに反映します(出典: AWS「Amazon Bedrock pricing」、2026年8月確認)。試算の例は、月10万回、1回あたり入力1,000トークン・出力500トークンを、Claude 3.5 Sonnetで処理するケースです。
入力100万トークンが6ドル、出力100万トークンが30ドルの場合、モデル部分は月2,100ドルになります。Knowledge BasesやS3、Lambdaの費用は、モデルとは別に必要です。検索やログの費用も別途かかります。
1ドル150円で換算すると約31.5万円になります。ただし、為替や料金改定は含んでいません。契約前には、AWS Pricing Calculatorで再計算します。
保守・改善費の別枠での確保
生成AIは、リリース後も資料の更新やモデル・料金の変更が続きます。プロンプトの改善や誤回答への対応も続きます。さらに、脆弱性対応や利用者教育もあり、リリースして終わりではありません。
- 年額の目安:一般的なCRM・MAでは初期開発費の10〜20%程度
- 見積もり区分:固定保守費とAWS利用料を分け、評価・データ更新の従量費や追加改修単価も別に示す
- 費用管理:従量費の上限アラートを設ける
この年額は、一般的なCRM・MAシステムの参考レンジです。24時間監視や月次評価を含むかどうかで、費用は大きく変わります。データクレンジングや追加開発、AWS請求管理も、含めるかどうかで金額が変わります。
部門別にタグやアカウントを分けると、業務ごとの費用と成果を追跡できます。
Amazon Bedrockの見積もりを取る際のポイント
見積もりを比べるには、モデル名だけでなく、各社に示す前提がそろっていることが欠かせません。対象業務やデータ量、利用者数を同じ前提で示します。連携先や権限に加え、評価方法や運用体制も伝えます。
初期構築と本番化は、分けて提示してもらいます。PoCの価格と本番構築の価格を単純に並べず、成果物と除外項目をそろえて比べます。
要件書の業務・データ・評価の3面
要件書は、業務、データ、評価の3つの観点で整理します。
- 業務要件:利用者とユースケース、画面を示し、承認や連携、KPI、SLAの条件も書く
- データ要件:ファイルやテーブルの種類と容量、更新頻度を示し、個人情報の扱い、保持期間、権限、正本管理者も明記する
- 評価要件:質問セットと正解例を用意し、根拠表示や拒否、応答時間、費用上限、再評価頻度を条件に含める
納品物では、要件定義書と構成図、データ辞書を確認します。権限設計書やプロンプト、評価データも、納品に含まれるかを見ます。
テスト結果や運用手順書、監視設定も、納品対象か確認します。ソースコードやインフラ定義、教育資料も、納品対象に含まれるかを確かめます。プロンプトや評価データの所有権は契約書に明記します。
複数社への同じRFPによる比較
開発会社は、技術経験と業務理解をそろえて比べます。提案範囲と運用体制も、同じ条件で見ます。
- 業務・技術経験:Bedrockや営業・CRM・MAの経験、既存連携、PoCから本番までの実績
- 安全対応:個人情報保護、閉域、監査への対応
- 見積もり体制:要件定義の工数、データクレンジングの担当範囲、AWSアカウントと請求の管理者
- 設計と評価:モデル・検索・Guardrailsの選定理由、試験データと合格基準
- 運用と納品:保守受付時間、追加改修単価、設計書とソースコードの納品
モデル変更時の再評価担当者と、誤回答時に停止する担当者を各社に尋ねると、運用力を判断する材料になります。
特に、価格が低く見える提案では、データ整備や運用が除外されていないかを確かめます。
費用と納期のリスク抑制(前提条件と変更管理)
見積もりの前提には、品質・技術・社内体制に関する不確定な要素も含めます。
- 技術とデータ:データ品質と権限の複雑さ、API制限、モデルの利用リージョン、応答遅延を確認する
- 社内調整:法務審査と現場の受け入れを見込み、未確定の項目は調査タスクに分ける
- 変更管理:連携や移行、権限追加、自動送信、モデル変更を、初期費用に含めるか追加費用とするか、契約前に決める
「資料を渡せばすぐ高精度になる」「2か月で全社展開できる」といった期待は、リスクです。中外製薬や岩崎電気の短期事例は参考になります。ただし、体制や対象範囲が異なるため、自社の期間を直接決める根拠にはしません。
各フェーズの成果物と受け入れ基準を置いておきます。そのうえで、要件整理から選定へ進む前に、経営と現場、セキュリティの担当者で費用と効果を合意しておきます。
よくある質問(FAQ)
料金や期間は要件によって変わります。ここに挙げる数字は、公開情報と構成から整理した目安として確認してください。
Amazon Bedrockのシステム開発は何から始めればよいですか?
モデル選びより先に、対象業務を一つに絞ります。そのうえで、利用者とデータを決め、期待するKPIと最終判断者も定めます。
「商談議事録から次回アクションを抽出する」のように、現状の作業時間を測れるテーマなら、PoCの評価と本番化を判断しやすくなります。
Amazon BedrockではRAGとファインチューニングのどちらを選びますか?
社内文書、商品情報、営業資料など、更新される知識を参照する場合は、まずRAGを検証します。
口調や定型出力を調整したい場合は、プロンプト設計やモデル選定を確認します。それでも足りない場合に、ファインチューニングを検討します。
データや権限の問題は、モデル学習で解決しようとせず、先に整えます。
顧客情報をAmazon Bedrockに入力しても安全ですか?
安全性は、AWSの仕様に加えて、自社の権限や暗号化、ログ、保持期間などを含めて判断します。委託契約や入力ルールも、判断に含めます。
個人情報保護委員会が出している生成AIに関する注意喚起も確認します。利用目的と第三者提供・委託を確かめ、外国にある第三者への提供や安全管理措置も、法務とセキュリティの担当と確認してください。
顧客情報を使う場合は、マスキングと最小権限を要件に含めます。承認と監査ログ、誤送信時の停止手順は、運用の要件として書きます。
PoCから本番稼働までの期間と費用はどのくらいですか?
期間の推定目安は、PoCが1〜3か月、MVPが3〜6か月、本番導入が6〜12か月程度です。
費用の推定レンジは、PoCが100万〜500万円、RAGのMVPが500万〜1,500万円程度です。本番はCRM・SFA・MA連携を含み、1,500万〜5,000万円程度です。
金額は、データ整備や権限、連携数などの範囲で変わります。複数拠点や基幹連携を含む場合、5,000万円〜1.5億円以上になる可能性もあります。
まとめ
Amazon Bedrockのシステム開発は、基盤モデルへのAPI接続に加えて、業務やデータ、権限を組み合わせる取り組みです。評価と運用も含めて進めます。
要件整理と選定、設計・開発の各段階で、成果物と次へ進む条件を決めておきます。テスト、稼働、定着でも同様に条件を決めると、PoC止まりや予算超過のリスクを抑えられます。
成功のために押さえるポイント
最初に業務KPIを決め、現場データを整え、利用者の権限を検索と連携処理へ引き継ぎます。
RAGは根拠と更新性、AIエージェントは実行権限と承認を基準に選びます。モデルは、品質と速度を比べ、費用とリージョンも確かめて選びます。
AWS利用料は開発費と分けて考えます。保守・改善費や評価データ、教育、変更管理と合わせて予算化します。
次に作るべき資料
対象業務と現状の作業時間、利用者、データソース、権限を、1枚にまとめます。期待するKPIや許容予算、希望時期、必要な成果物も書き添えます。
その資料をもとに複数社へ同じRFPを渡し、PoCの範囲と本番化の条件を分けて提案してもらうと、自社に合う開発計画を立てやすくなります。
▼全体ガイドの記事
・Amazon Bedrockのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。