
Amazon Bedrockのシステムは、基盤モデル、業務データ、既存システムを組み合わせて、検索・要約・自動処理を実現する業務基盤です。
できることや構成から、開発の進め方、費用、セキュリティ、会社選びまでを一通り押さえられます。各テーマの詳しい内容は、関連記事をご覧ください。
▼関連記事一覧
・Amazon Bedrockのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Amazon Bedrockのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Amazon Bedrockのシステム開発の見積相場や費用/コスト/値段について
・Amazon Bedrockのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Amazon Bedrockのシステムの概要
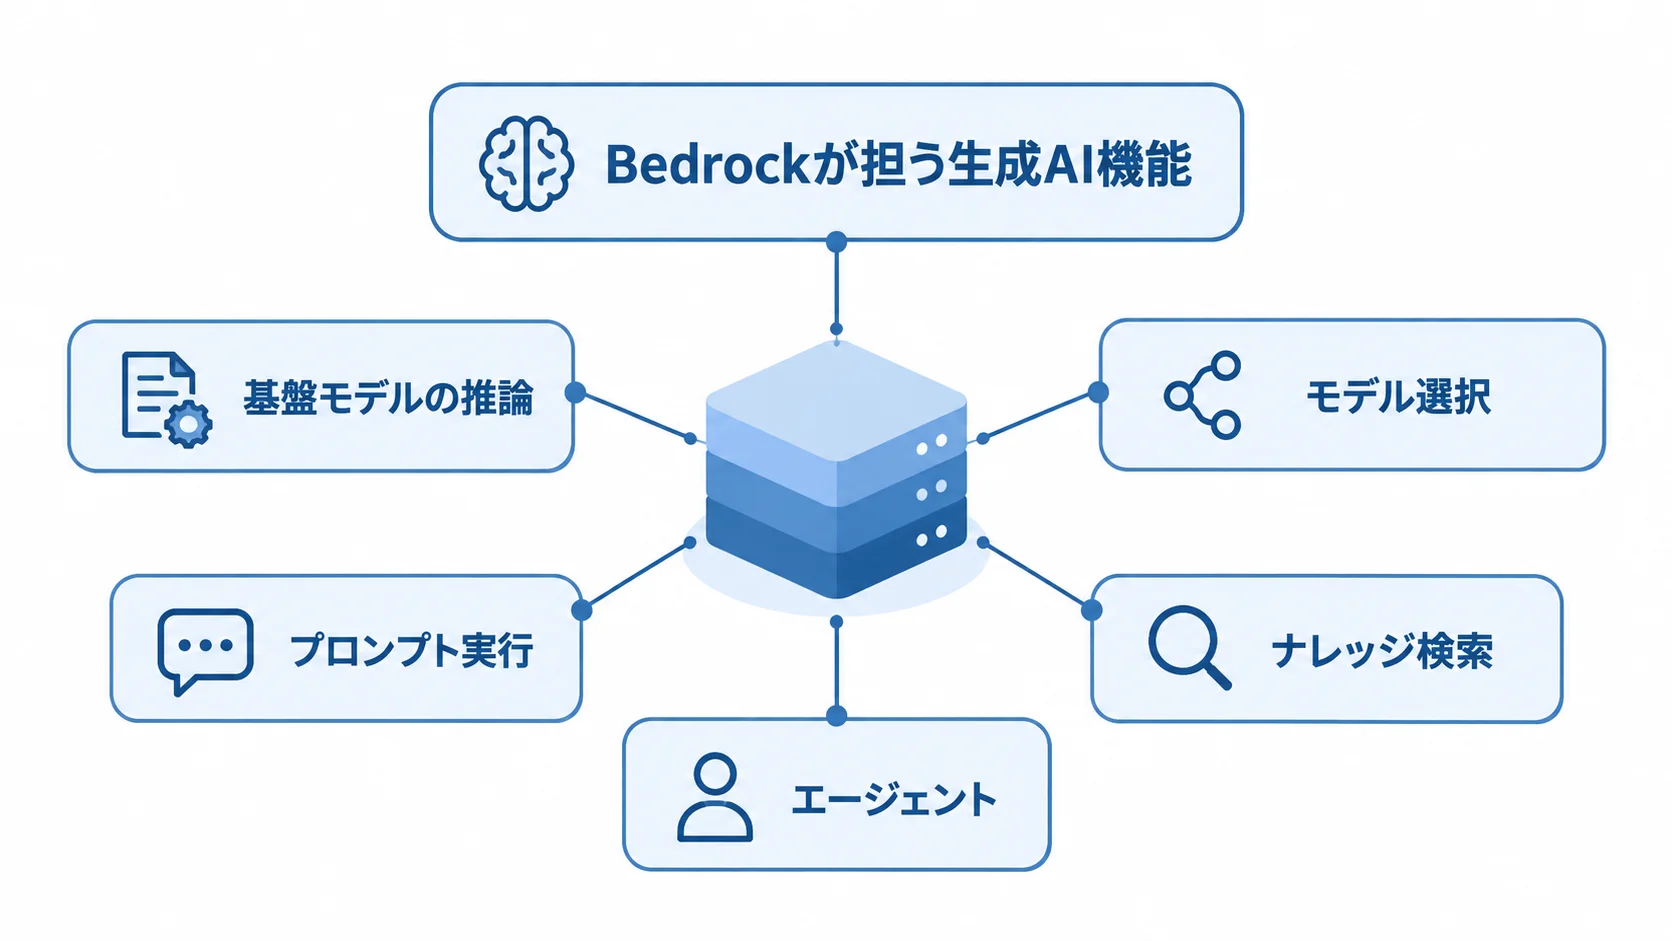
Amazon Bedrockは、複数のAI企業が提供する基盤モデルを、共通APIやAWSの管理機能から利用できるフルマネージドサービスです。そのため、自社で大規模モデルを学習・運用しなくても、業務アプリに生成AI機能を組み込む土台として使えます。
AWS公式ドキュメントでは、100以上の基盤モデルをサポートすると説明されています(出典: AWS公式「Amazon Bedrockの概要」、2026年8月確認)。
Bedrockが担当する範囲
Bedrockが担うのは、基盤モデルの推論やモデル選択、プロンプト実行です。さらに、ナレッジ検索やエージェントなども担います。
一方で、ログイン画面や顧客マスタ、CRMやSFAとの連携は、Bedrockとは別に設計します。承認や請求管理、障害時の業務継続も、別途設計が必要です。
Bedrockを契約しただけでは、システムとして完成しません。そのため、Bedrockを中核にした業務システムとして捉えるのが、実態に合います。
システムの5つの層
Bedrockを中核にしたシステムは、画面から統制までの5つの層で構成されます。層ごとに受け持つ役割が違うため、どの層で何を用意するかを分けて考えます。
- 画面:チャットや営業支援の画面。
- 認証・API:IAMやCognitoなどの配置。
- AI・検索:BedrockやKnowledge Basesの利用。
- データ:S3や検索インデックスへの保存。
- 統制:暗号化・監査ログ・監視・費用計測を、各層にまたがって設けます。
既存資産を再利用する層と、新規に開発する層の範囲によって、費用と期間が変わります。
Amazon Bedrockでできることと主な種類
活用方法は、知識を検索して回答する機能、複数の処理を実行する機能、文章を生成・変換する機能に大別できます。
営業や顧客対応では、回答根拠が必要な検索型から始め、効果と安全性を確認したうえで自動実行へ広げるのが現実的です。
RAGによる社内文書・営業資料の検索
RAGは、質問に関係する文書を検索し、その内容を基盤モデルに渡して回答を生成する方式です。ただし、文書をS3へ置くだけでは十分ではありません。
- 検索対象:商品資料や提案書、規程などを検索できます。FAQや議事録も対象にでき、回答には参照元を示せます。
- 更新への対応:資料が更新されても再学習は不要です。内容が変わりやすい業務では、ファインチューニングより先に検討できます。
- 運用設計:古い資料の除外や部署別の権限設定、文書の分割を行います。根拠表示やアクセスログも設けます。
顧客情報や商談情報を扱う場合は、検索時に利用者の権限を引き継ぎます。権限が適切でないと、見せてはいけない情報が回答に含まれるおそれがあります。
AIエージェントによる業務処理の連携
AIエージェントは、情報を取得してツールを呼び出し、複数段階の処理を進める仕組みです。
- 活用例:商談メモから次回アクションを抽出し、確認後にタスクとして登録できます。問い合わせの分類や担当部署への振り分けにも使えます。
- 自動実行:回答生成より厳しく設計し、顧客情報の更新・メール送信・チケット起票・見積作成の操作に限定します。
- 承認:重要な処理は、人の承認を挟んで実行します。
- 監査:実行者・入力・判断結果・実行結果を記録し、後から原因を追跡できるようにします。
要約・分類・文書生成とモデル評価
入力例と期待する出力例を用意すると、生成・分類の用途や評価指標を具体的に定められます。
- 対象機能:商談・電話の要約やメール下書きが対象になります。問い合わせ分類や議事録からの項目抽出にも使えます。
- KPI:作業時間や修正時間、分類の正解率などを設定できます。
- モデル選択:単純な分類や短い要約には軽量モデル、複雑な推論には高性能モデルが候補になります。
評価では、回答の根拠と、回答できない場合の拒否を確かめます。個人情報の保護と応答時間も、評価の対象に含めます。
RAG評価やLLMを審査員に使う評価では、評価用モデルの推論費用なども発生します(出典: AWS公式「Amazon Bedrock Pricing」、2026年8月確認)。
Amazon Bedrockのシステム構成と必要なAWSサービス
典型構成では、画面から認証・API層を通り、業務ロジックがデータを取得してBedrockを呼び出します。
RAGを使う場合は、文書ストレージと検索インデックスを加えます。さらに、取り込み・更新処理と権限フィルターも必要になります。
設計時に確認したい主な構成要素を、層ごとに見ていきます。
画面・認証・業務ロジックの用意
チャット画面から業務ロジックまで、部分ごとに担う内容が異なります。
- チャット画面:質問履歴、参照元、回答評価を配置します。再生成や担当者への引き継ぎも、同じ場所に置きます。
- 認証:部門や役職、顧客担当などの属性を社員ごとに取得し、検索やツール実行の権限に反映します。
- API層:入力検証とレート制限を担い、タイムアウトやエラーの処理も受け持ちます。
- 業務ロジック:AIの出力をそのまま使わず、形式や必須項目を検証してから既存システムへ渡します。
S3・Knowledge Bases・検索層の組み合わせ
S3などの保存先に、Knowledge Basesの取り込み機能や検索サービスを組み合わせます。
- 管理項目:資料の所有者と更新頻度を決めたうえで、削除の反映方法、メタデータ、閲覧範囲も定めます。
- 検索条件:営業資料に対象部門や公開期限、商品カテゴリを付けると、絞り込みやすくなります。
- 取り込み前の確認:重複した資料や表記揺れ、古い価格表は誤回答につながります。スキャン画像や権限のない共有フォルダは、権限逸脱を招きます。
- データ台帳:残す資料と除外する資料、更新責任者、保存期間を一覧にします。
検索結果を左右するのは、データ量よりもデータ品質です。
IAM・KMS・CloudTrail・監視による統制
本番では、IAMの最小権限やMFA、通信の暗号化を組み合わせます。そのうえで、KMSによる保存データの暗号化・監査ログ・異常検知・バックアップも加えます。
ログにはプロンプトや回答が含まれる場合があるため、保存期間とマスキング、閲覧権限を決めておきます。
AWSのサービスを組み合わせるほど、設定項目は増えていきます。そのため、構成図に加えて、誰がどのデータに何をできるかを表で確認すると、設定の漏れを減らせます。
RAG・AIエージェント・ファインチューニングの選び方
更新される社内知識にはRAG、複数ツールの実行にはAIエージェント、文体や出力傾向の安定にはファインチューニングを検討します。
まずは業務課題に対して必要最小限の方式を選び、すべてを一度に採用する必要はありません。
知識の更新が多い場合のRAG
商品情報や社内規程、営業資料のように頻繁に変わる内容は、RAGで検索対象を更新する方が運用しやすいです。回答の根拠を示せるうえ、アクセス権や公開期限も制御できます。
検索精度が低いままでは、高性能なモデルを使っても改善しにくくなります。そこで、文書分割とメタデータ、検索クエリ、再ランキングを評価します。
業務処理を自動化する場合のエージェント
複数システムから情報を取得し、条件を判断して次の処理へ進める場合は、エージェントが候補です。
たとえば、問い合わせを分類し、顧客契約の状態を照会して、回答案を担当者へ渡す流れが考えられます。まずは読み取り専用から始め、登録・変更・送信には承認や二重確認を設けます。
目的とデータを確認したうえでのファインチューニング
ファインチューニングは、特定の形式や応答傾向を学習させる手法です。一方で、最新の知識を参照する場合は、RAGが適しています。
変わりやすい価格や規程を、ファインチューニングだけで管理しようとすると、再学習と検証の負担が増えます。教師データが不十分な場合は、プロンプト設計や出力形式の制約、検索の改善を先に行います。
Amazon Bedrockのシステム開発の進め方
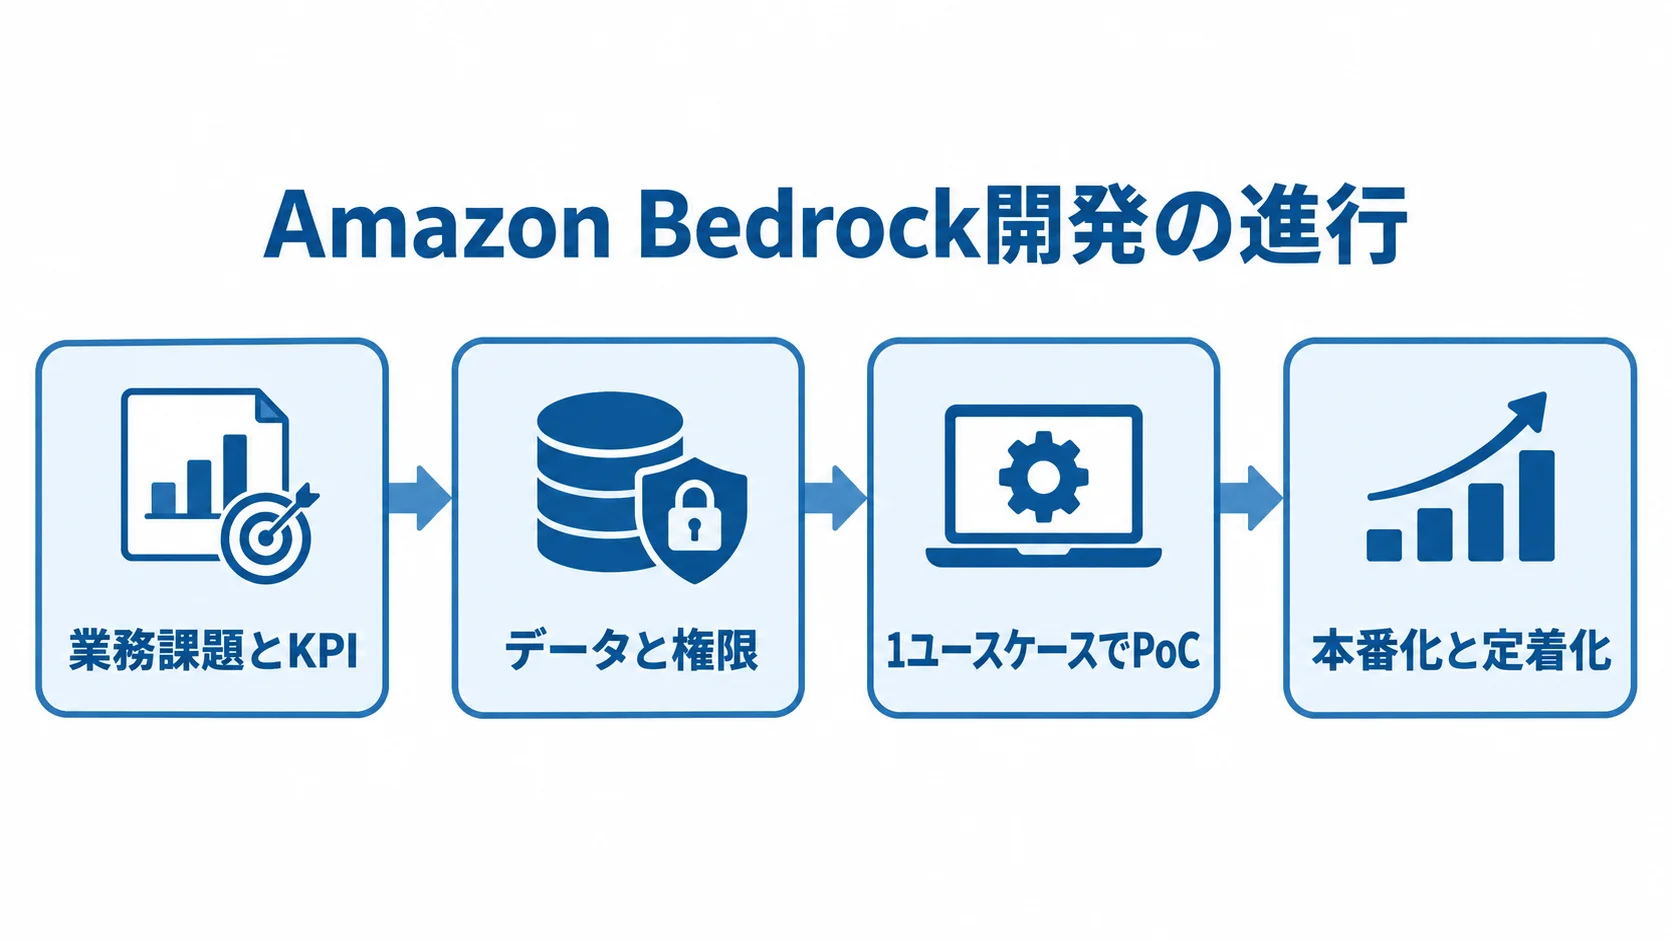
開発は、まず業務課題とKPIを定めます。そのうえで、データと権限を確認し、小さく検証してから本番化します。
営業・顧客対応では、回答品質に加えて、現場が使い続けられるか、既存の入力作業を減らせるかも評価します。
▶ 詳細はこちら:Amazon Bedrockのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
1. 業務課題とKPIの定義
「生成AIを導入する」ことを目標にせず、何の時間をどれだけ減らすかを、まず決めます。そのうえで、現状から計測できる指標に落とし込みます。
- 測定対象:資料検索や商談後の入力にかかる時間、問い合わせの一次回答と提案書初稿の時間。
- 評価指標:利用率や再質問率、修正時間、業務完了時間、1回あたりの費用。
正解率だけをKPIにすると、業務改善につながらない場合があります。
2. データと権限の確認
利用する文書や顧客データは、所在や形式、更新頻度、管理者を一覧にして確かめます。
- 個人情報:有無や閲覧対象、保存期限を確かめ、重複や表記揺れも整理します。
- Excelや個人フォルダ:正確性と権限を確認できる範囲から投入を始めます。
- マスタ整備:発注者側が責任を持たないと、開発側だけでは正しい検索結果を保証できません。
3. 1ユースケースでのPoC
対象業務を一つに絞り、実際の質問と正解例を評価セットにします。
- 検索型の評価:根拠文書の取得率、回答の正確性、回答不能時の拒否。
- 運用面の評価:応答時間、個人情報のマスキング、1回答あたりの費用。
評価者の感想だけでなく、合格基準を数値にして本番化を判断します。さらに、モデルやプロンプトを変えたときの影響も比べられます。
4. 本番化と定着化
PoCで効果が確認できたら、本番に向けて認証や権限、監査を加えます。さらに、障害対応やバックアップ、費用上限、運用窓口も整えます。
リリース前には、通常の質問に加えて、次の質問も試します。
- 情報の範囲:権限外の情報を求める質問。
- 想定外の入力:プロンプトインジェクションや古い資料、外部送信を促す質問も対象にします。
リリース後は、利用率と業務KPIを確認します。また、誤回答を報告しやすい画面を用意し、文書の更新担当者も決めておきます。
Amazon Bedrockのシステム開発費用相場と期間
開発会社への支払いとBedrockの利用料は、分けて考えます。一律の公式相場はなく、以下は要件やデータ量、連携数、セキュリティ要件を前提にした推定です。
見積もりでは、金額に加えて、何が含まれるかを揃えて確認します。
▶ 詳細はこちら:Amazon Bedrockのシステム開発の見積相場や費用/コスト/値段について
開発会社へ支払う費用の目安
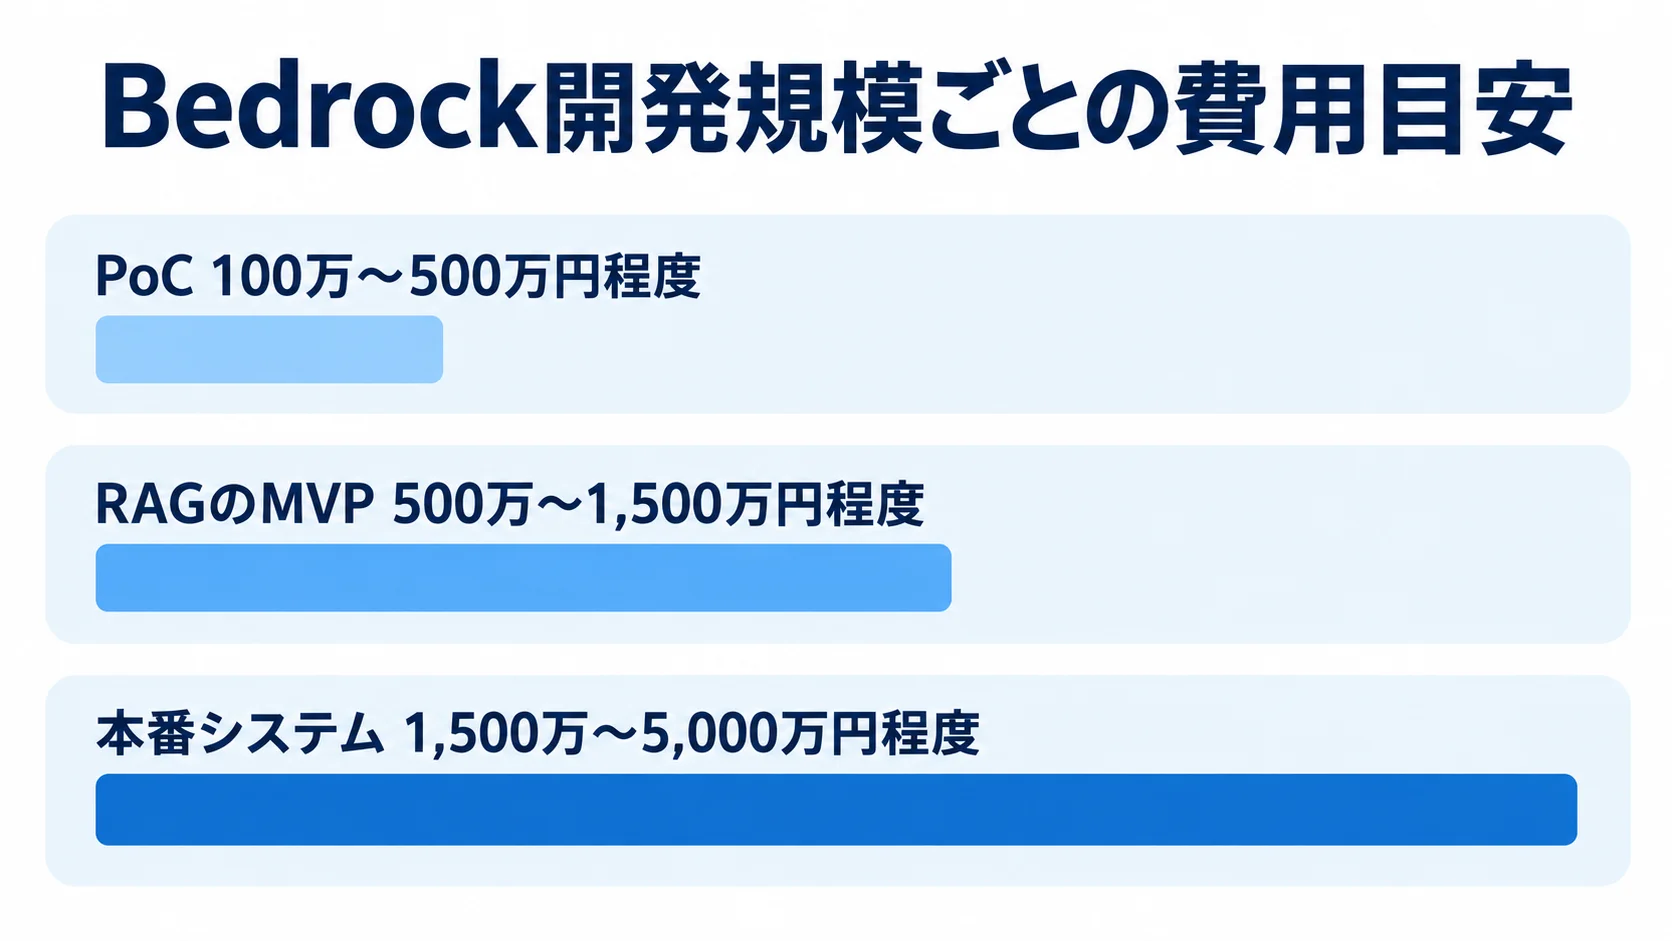
PoCから全社展開まで、開発規模ごとの費用の目安を並べます。
- PoC:技術検証や簡易チャットは100万〜500万円程度。
- RAGのMVP:認証や取り込み、検索、回答画面を備え、500万〜1,500万円程度。
- 本番システム:複数システム連携、権限分離、監査、運用設計を含み、1,500万〜5,000万円程度。
- 全社展開など:複数拠点・業務、閉域網、高可用性を含むと、5,000万円〜1.5億円以上の場合があります。
いずれも、類似業務システムの相場と生成AI開発の構成から算出した推定です。公開価格ではありません。
データ整備や既存連携、権限設計は、費用が膨らみやすい要素です。評価データ・現場テスト・教育・運用設計も、費用を押し上げる要因になります。
年間の保守・改善費は、一般的な業務システムの参考値として、初期開発費の10〜20%程度と見ておきます。そのうえで、モデル変更や評価の再実施が含まれるかを確かめます。
トークン数と周辺サービスで変わるAWS利用料
モデル単価と処理量を分けて考えると、利用料の条件を整理できます。
- 単価の条件:モデルやリージョン、入力・出力トークン、利用ティアによって変わります。
- 別途必要な費用:検索、ストレージ、API、コンピュート、ログ、ガードレール、データ取り込み。
AWS公式料金では、特定モデルのプロモーション料金として、入力100万トークン2ドル、出力100万トークン10ドルが2026年8月31日まで掲載されていました。
標準料金は入力3ドル、出力15ドルです(出典: AWS公式「Amazon Bedrock Pricing」、2026年8月確認)。
料金は変わるため、発注時と公開時に公式料金ページを再確認します。
たとえば、月10万回、1回あたり入力1,000・出力500トークンの場合、プロモーション料金では入力200ドル、出力500ドルで、モデル費は700ドルです。
同じ条件で標準料金の場合は、入力300ドル、出力750ドルで、計1,050ドルです。
1ドル150円と仮置きすると、約10.5万〜15.75万円になります。
実際の費用は、プロンプトの長さと利用回数を計測して試算します。
PoCと本番の開発期間の目安
開発規模や含める工程で期間が変わるため、段階ごとの目安を確認します。
- PoC:1ユースケースで1〜3か月。
- MVP:データ連携と評価を含めて3〜6か月。
- 本番導入:連携や認証、監査、教育を含めて6〜12か月程度。
複数拠点や業務を段階的に展開する場合は、1〜2年程度になることもあります。
AWS公式事例には、既存基盤と専任チームを活用し、約6,000人が使う生成AIアシスタントを2か月で開発した例があります(出典: AWS公式導入事例、2026年8月確認)。
体制や前提が違うため、この期間を一般企業の目標にそのまま当てはめるのは難しいです。
セキュリティと個人情報保護の確認事項
顧客名やメール、商談履歴のほか、通話音声や担当者評価を扱う場合は、生成AIの利便性だけで導入を決めてはいけません。
入力データの利用目的や委託先、保存場所は、法務・セキュリティ担当と確認します。
アクセス権やログ、削除方法も含め、AIに入力してよい情報を明文化します。
個人情報の入力可否の判断
個人情報保護委員会は、入力した個人情報がサービス提供者の学習データに使われる予定か確認するよう注意喚起しています。
Bedrockを組み込む場合も、サービスのデータ保護の仕様に加えて、利用目的や委託契約、社内規程を整理します。さらに、外国にある第三者への提供や安全管理措置も確認します(出典: 個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」、2023年)。
実装時のデータ保護は、次の方法で進めます。
- 情報の制限:マスキングし、必要な項目だけを渡します。
- アクセスとログ:部門別のアクセス制御、ログの秘匿化、保存期間の設定。
- 評価データ:開発環境には本番の顧客データを持ち込まず、匿名化データを使います。
- 匿名化が難しい場合:利用者、目的、対象データを承認制にして記録します。
Guardrailsと監査ログによるリスクの抑制
Amazon Bedrock Guardrailsは、有害な内容や拒否トピック、機密情報、禁止ワードなどを、入出力で検査できます。また、個人を特定できる情報の秘匿化にも使えます(出典: AWS公式「Amazon Bedrockガードレール」、2026年8月確認)。
- 多層防御:IAMや入力検証、検索権限の制御を重ね、監査ログと人の確認も加えます。
- 検証シナリオ:通常の質問のほか、権限外文書の要求や機密情報の出力指示を試します。プロンプトインジェクションや古い資料も対象です。
- 拒否時の対応:利用者への案内、業務の代替手段、インシデント時の連絡先の取り決め。
Amazon Bedrockのシステム開発で起きやすい失敗と対策
生成AIプロジェクトの失敗は、モデルの性能不足だけで起きるとは限りません。業務課題があいまいなことや、データ責任者がいないことも原因になります。さらに、現場作業の増加や、PoCの評価基準の不足も、失敗につながります。
データを整えずにAIを追加する失敗
古い文書や商品名の揺れ、顧客マスタと商談データのID不一致があると、誤った回答が速く返るだけになりかねません。
まずは対象データを絞り、文書の所有者と更新期限を決めます。そのうえで、テスト用の正解データを作り、品質を確認できた領域から段階的に広げます。
AIへの正解と自動化の過度な期待
生成AIは文章作成や検索を支えますが、判断の責任まで自動で引き受けるものではありません。
初期から完全自動化を目指すと、例外処理や承認、誤回答への対応が不足します。そのため、回答案の作成や候補の分類、根拠の提示など、人の確認を前提にした使い方から始めます。
自動実行へは、効果と安全性を確認した処理から広げます。
現場の入力負担の増加による利用停滞
新しい画面で二重入力を求めると、現場が使わなくなり、既存のExcelや個人メモに戻る可能性があります。
まず現場の代表者に早く試してもらい、既存業務のどこで使うかを決めます。そのうえで、入力項目を減らす工夫や、既存システムから値を取得する設計、回答の修正を改善に使う設計も検討します。
Amazon Bedrockの開発会社・ベンダーの選び方
会社は、Bedrockの利用経験に加えて、業務理解や既存連携を見て選びます。さらに、データ整備やセキュリティ、運用の体制も確かめます。
資格やサービス名の数よりも、営業・顧客対応の現場で使えるシステムを作れるかを見ます。そのうえで、PoCから本番、改善まで責任を持つ体制かを、提案書と面談で確かめます。
業務・データ・Bedrockを横断した説明力
候補先には、説明の中身を具体的に確かめます。
- 既存システム:CRMやSFA、MA、基幹システムとの連携について質問します。
- 運用の確認:RAG評価や顧客データ分離、権限継承、モデル変更時の再評価について尋ねます。
- 設計の示し方:構成図やデータフロー、失敗時の処理、前提条件まで示されるかを確かめます。
発注者側で整備すべきデータも、自社で明確にします。
PoCの成果物と本番移行の条件
PoCの費用が安くても、本番費用や条件が不明なままでは比較できません。そのため、納品範囲を明記してもらいます。評価データやプロンプト、設定、設計書のほか、ソースコードやインフラ定義、運用手順も含みます。
ログの所有権やAWS利用料、請求代行、保守・改善は、それぞれ分けて確認します。
障害対応時間やモデル変更時の検証も、確かめておきます。
RFPの項目と見積もり条件の揃え方
比較表やRFPでは、次の5項目に整理して見積もり条件を揃えます。
- 目的・KPI、評価セット・合格基準
- データソースと更新頻度
- 利用者と権限
- SLAと障害対応
- 初期費用・月額費用、納品物・運用担当
モデル候補や1日あたりのリクエスト数、入出力トークンも加えます。個人情報の扱いと将来のモデル変更方針も、条件として書き添えます。条件を揃えることで、会社の知名度よりも、案件との適合性で判断できます。
▶ 詳細はこちら:Amazon Bedrockのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Amazon Bedrockのシステム開発の発注/外注/依頼/委託方法について
よくある質問
導入前には、費用や安全性、既存システムとの関係について疑問が生じやすいものです。ここでは、確認されやすい質問に答えます。
Amazon Bedrockは他の生成AI APIとどう比較しますか?
AWS上で既存のクラウドや認証、監査、データ管理を統合したい場合は、Bedrockが候補です。
別のモデルAPIが適する場合もあります。品質だけでなく、データ保護やリージョン、契約まで比べて決めます。既存連携や運用体制も、判断材料に含めます。
既存のCRMやSFAと連携できますか?
API、データベース、ファイル連携など、既存システムの接続方法に応じて連携できます。
取得するデータやタイミング、権限の引き継ぎ、AI出力を書き戻す際の承認者を決めます。
読み取り専用から始め、更新や送信は、安全性を検証したあとに加えます。
顧客情報や個人情報をAmazon Bedrockで扱えますか?
扱える可能性はありますが、入力してよいかを自動的に判断できるものではありません。
個人情報保護法や社内規程、契約を確認し、利用目的や権限、保存期間、ログも見直します。必要に応じて、匿名化やマスキングを行います。
まず機密度の低いデータで検証し、法務・セキュリティ担当の承認後に対象範囲を広げます。
PoCだけで終わらせないために何を決めますか?
開始前に、本番化の判断基準と、本番で必要になる要件を決めます。
正確性・根拠提示率・応答時間・利用率・費用上限を合意します。さらに、セキュリティテストや運用担当、予算、移行時期も決めておきます。評価データと改善課題は、PoCの成果物として残します。
使えるかの確認で終えず、使い続けられる仕組みまで評価することが大切です。
まとめ
Amazon Bedrockは、複数の基盤モデルを業務に組み込める柔軟な基盤です。
RAGや要約・分類、AIエージェントなどを利用できます。
成果を左右するのは、モデルの選択だけではありません。業務課題やデータ品質、権限のほか、評価と現場定着も、一連の導入フローとして設計します。
本番運用までを含む費用と期間の見積もり
推定費用はPoCが100万〜500万円、RAGのMVPが500万〜1,500万円、本番連携が1,500万〜5,000万円程度です。
AWS利用料とデータ整備は、別に発生します。このほか、次の項目も別に発生します。
- 権限・監査:アクセス権やログの設計。
- 評価:回答を確かめるデータと現場テスト。
- 保守・改善:毎年かかる費用です。
そのため、成果物と運用の範囲を揃えて、見積もりを比べます。
小さな検証と本番化の条件の事前決定
本番化に向けては、準備、検証、展開の順に進めます。
- 準備:対象業務を一つに絞ったうえで、利用者やデータ、権限を決めます。KPIや評価セット、予算、運用担当も定めます。
- PoC:回答品質に加えて、安全性と現場での使いやすさを確認する段階です。
- 本番化:条件を満たした機能から広げれば、Bedrockを一時的な実験で終わらせず、業務改善につながるシステムとして育てていけます。
▼関連記事一覧
・Amazon Bedrockのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Amazon Bedrockのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Amazon Bedrockのシステム開発の見積相場や費用/コスト/値段について
・Amazon Bedrockのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。