
Amazon Neptuneのシステム開発は、業務課題とデータを定め、方式を選ぶところから始まります。そのあと、設計、テスト、稼働、定着と進み、関係検索を業務判断に活かします。
▼全体ガイドの記事
・Amazon Neptuneのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Amazon Neptuneのシステム開発の全体像
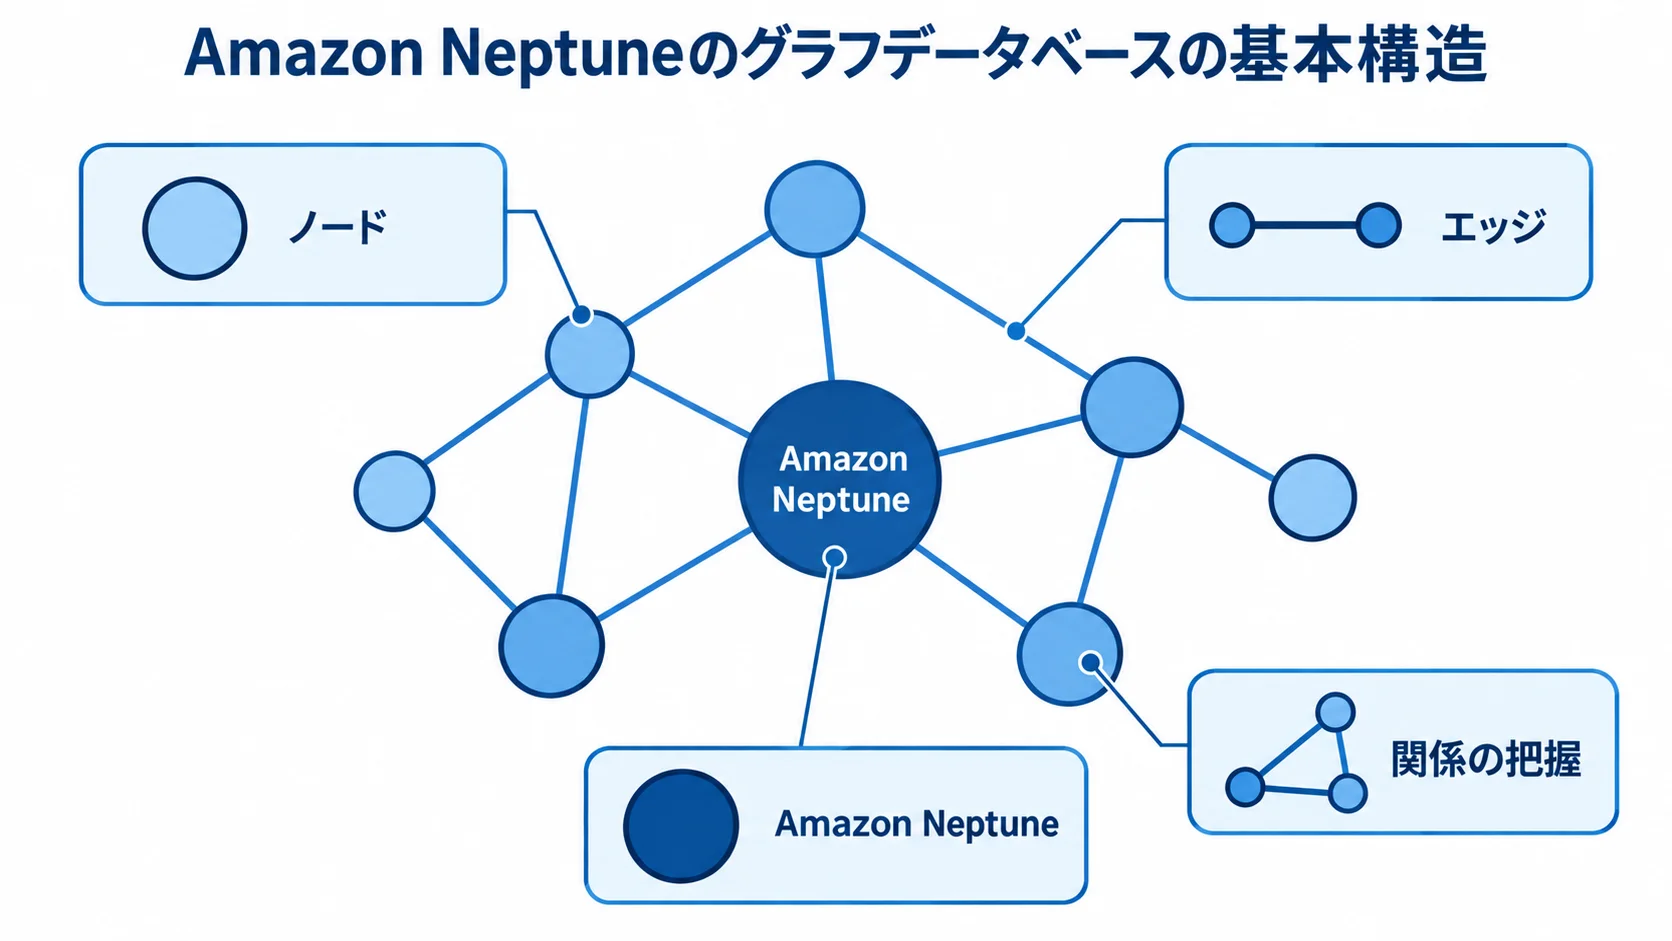
Amazon Neptuneは、AWSのマネージド型グラフデータベースです。顧客や企業、商品などをノードで表します。契約や担当者、問い合わせも、同じようにノードで表せます。
ノード同士の関係はエッジとして表し、たどって検索できます。営業・CRM・MAでは、顧客360度ビューや紹介関係の可視化に使えます。
重複リードの検出や商品推薦にも使えます。一方で、顧客一覧や受注金額の集計が中心なら、RDBやCRM SaaSのほうが運用しやすい場合があります。
グラフデータベースが向く条件
グラフデータベースは、複数段階にわたる顧客や企業の関係を追う課題に向いています。
- 関係の把握:会社、部署、人物、契約、製品を数段階にわたってたどる
- データの横断:複数のデータソースに散らばった関係を、一画面にまとめて見る
- 営業準備:企業間のつながりをたどって、訪問前に確認する
たとえば、親会社と子会社、販売代理店をつなぎ、さらに担当者、商談、導入製品をつなぐと、営業担当者は次回の訪問前に関係をたどれます。
RDBで同じ検索を作ると、多数のJOINや中間テーブルが必要になる場面があります。そうした場面では、グラフで関係を起点に探索できます。
顧客名や住所、売上、ステータスを一覧で表示するだけなら、Neptuneを採用する必要性は高くありません。
発注する会社は、Neptuneありきで考えず、関係検索でどの業務判断を何秒短縮し、どの成果を改善するかを先に決めます。
Neptune DatabaseとNeptune Analyticsの使い分け
DatabaseとAnalyticsは、照会と分析のどちらを担わせるかで使い分けます。
- 低遅延の照会:日常業務画面からの関係検索は、Neptune Databaseが受け持つ
- 大規模な分析:ページランク、類似度、コミュニティ検出、ベクトル検索はNeptune Analyticsに任せる
- 営業システム:リアルタイム検索はDatabase、週次分析や推薦候補の計算はAnalyticsに分けた構成
- クエリ言語:業務アプリはGremlinまたはopenCypher、ナレッジグラフはRDFとSPARQLが候補
- 方式選定:将来性、チーム経験、移行性、代表クエリの書きやすさで比べ、混在するときは責任範囲を定める
大規模な事例でも、Neptuneだけですべてを処理せず、役割を分けています。
AWSのWiz事例では、セキュリティグラフに数千億の関係を保存しています。データの保管はAurora、処理の高速化はElastiCache、調査支援はBedrockが担っています。
同事例では、ElastiCacheによる20%のコスト削減と、Bedrockによる調査時間40%の削減が紹介されています(出典:AWS公式顧客事例「Wiz」、2026年確認)。
これは大規模なセキュリティサービスの成果であり、一般的なCRM開発の効果を保証する数字ではありません。
Amazon Neptuneのシステム開発の進め方
開発は6つのフェーズで進め、まず代表的な1業務と少量の実データで仮説を検証します。数値基準を満たしたら、次に対象範囲を広げます。
1. 要件整理フェーズでの業務課題とデータの定義
業務課題とデータの扱いは、発注側と開発会社がそろえて具体化します。次の観点で書き出しておくと、後の設計や見積もりがぶれにくくなります。
- 利用場面:誰がどの画面で関係を見て、何を判断するかを文章にする
- 探索条件:営業担当者が商談画面で、2ホップ以内の子会社や過去の接点、契約中の製品を5秒以内に確認できるか
- データ源と管理:CRM、SFA、MA、ERP、問い合わせ、Web行動、名刺を一覧にし、会社・個人ID、更新日時、出典、同意状態、削除・訂正、管理部門を決める
- 8項目の確認:業務KPI、代表クエリ、データ項目、更新頻度、個人情報、権限、RTO・RPO、PoC合格条件
「顧客を一元管理する」という目標を立てても、必要なノードやエッジ、性能目標は決まりません。名寄せ前のデータでは、同じ人物が複数のノードに分かれ、関係検索の結果を信用できなくなるおそれがあります。
2. 選定フェーズでのNeptune採用の判断
Neptuneを採用するかは、製品どうしを同じ軸と測定項目で比べて判断します。そこで、PoCでも次の軸と測定項目をそろえて記録します。
- 製品候補:Neptune、既存RDB、DynamoDB、CRM SaaS
- 評価軸:多段探索の必要性、データ量と増加率、同時接続、更新頻度、分析、AWS標準化、運用人材
- PoC準備:1ユースケース、代表データと代表クエリ、最悪ケースの多段探索を用意する
- 測定項目:検索レイテンシ、同時実行数、1日あたりの書き込み件数、初回ロード・再取り込み・障害復旧の時間、1処理あたりのAWS費用
顧客マスタの登録や営業活動の入力、配信停止の管理まで、すべてをNeptuneに寄せる必要はありません。業務トランザクションは既存のCRMやRDBに置き、関係検索だけをNeptuneに置く構成も有力です。
発注側と開発会社は、PoCの合格条件を先に決めておきます。たとえば、「95パーセンタイルの応答が5秒以内」のように数値で書きます。名寄せ後の重複率やRTOの条件を満たさなければ、モデルや製品の選択を見直します。
3. 設計・開発フェーズでのデータモデルと連携の作成
開発会社は、データ構造、API接続、インフラの設計で次の項目を押さえます。
- データモデル:ノード、エッジ、プロパティ、履歴、時点情報、削除・訂正ルール
- API接続:Lambda、ECS、EKSなどからの接続で、認可、監査、レート制限、入力検証を組み込む
- インフラ:IaCで定義し、VPC、サブネット、セキュリティグループ、TLS、IAM、KMS暗号化の設定を記録する
- 運用基盤:バックアップ、CloudWatch監視、Readerの配置を、設計書に明記する
「担当する」「契約している」「閲覧した」といった関係には、開始日や終了日が必要になる場合があります。さらに、発注側と開発会社は、出典、信頼度、更新者などの属性も検討します。
履歴を上書きすると、当時の営業経路を追えなくなります。そのため、履歴を残す単位は業務部門と合意しておきます。
画面から直接アクセスしない構成にすると、CRMやMAとの連携を後から変えられます。
4. テストフェーズでの性能・品質・安全性の検証
テストでは、品質・性能・安全性を次の項目で検証します。
- 機能と復旧:データ変換、名寄せ、API連携、権限、監査ログ、バックアップ復元、障害時切り替え
- 性能:ピーク時の同時接続、深い探索、データ増加時、読み書きが重なる場合の挙動
- 個人情報を扱う場合:ロールごとの閲覧範囲、配信停止・利用目的変更の連携先反映、退職者権限の即時無効化
- ログ管理:ログの保管期間と閲覧者
性能は、平均値に加えて、クエリごとの実行時間とI/O量を記録しておきます。その数値は、本番後の料金予測とチューニングに使えます。
AWSのマネージドサービスを使う場合でも、データ分類とアクセス権限は、利用者側で設計する必要があります。監査やインシデント対応も、利用者側で受け持ちます。
5. 稼働フェーズでの本番への切り替え
本番への移行では、切り替えの条件と監視対象を事前に決めておきます。
- 切り替え準備:方式、データ凍結時間、差分同期、戻し方、担当者、連絡網
- 二重更新:既存CRMから段階的に同期する場合、どちらを正とするかを決めておく
- 限定稼働:部門と用途を絞って、検索精度、応答時間、入力負荷、問い合わせ件数を見る
- 監視:CPU、メモリ、クエリレイテンシ、接続数、エラー、書き込み遅延、データロード失敗
AWS公式料金ページには、月額296.61米ドルの例があります。その条件は、db.r5.largeを1台、50GBのデータ、200百万I/Oです。
これは米国東部の例で、日本リージョンの実額を保証するものではありません。そこで、PoCの時点から同じ指標を記録し、発注側が見積もりと本番実績の差を管理します。
6. 定着フェーズでの現場が使い続ける仕組みづくり
現場で使い続けてもらうには、画面、教育、改善指標、責任分担を整えておく必要があります。
- 検索画面:表示する関係を絞り、顧客・案件から自然にたどれる導線を作る
- 操作説明:商談前の関係企業確認や重複リード統合など、業務シナリオで練習する
- 月次改善:利用率、検索成功率、重複削減数、商談準備時間を見て、データ品質と画面を改善する
- 責任分担:データの正しさを担保する担当、クエリ・インフラ担当、現場の問い合わせ担当を定め、変更申請の流れを決める
たとえグラフが正しくても、営業担当者が入力しなければ価値は生まれません。
定着後の責任分担も、契約と運用設計に含めておきます。新しい商品や組織、同意ルールが追加されたとき、誰がモデルと連携を更新するかまで決めておくと、開発会社への依存を減らせます。
Amazon Neptuneのシステム開発にかかる費用相場
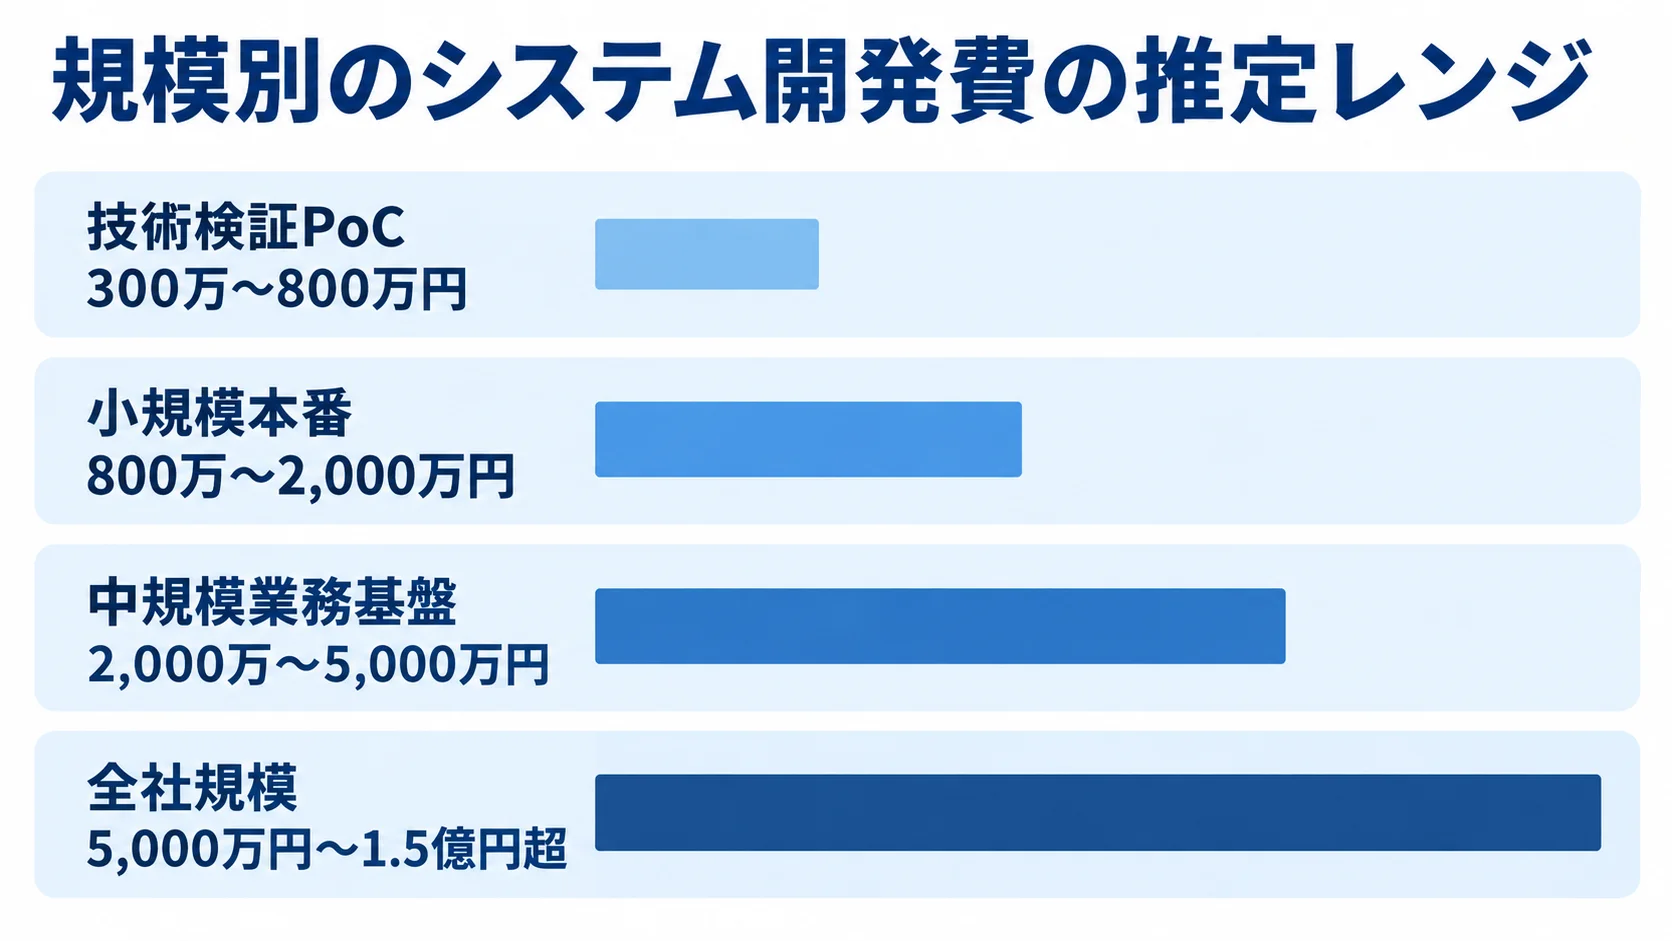
発注側は、費用を初期開発費、AWS利用料、保守・改善費に分けて考えます。
Neptune固有の国内見積もりの統計は、一律には公開されていません。そのため、開発費は営業・CRMシステムの相場を基にした推定になります。推定には、グラフモデリング、AWS基盤、データ移行、連携の追加工数を加味しています。
予算は、PoCと実データの測定をもとに更新します。
規模別の開発費と期間の目安
開発規模ごとの推定レンジは、検証の対象と本番の範囲によって変わります。
- 技術検証PoC:1用途・少量データのモデルと代表クエリ検証で300万〜800万円、1〜2か月
- 小規模本番:顧客360度ビューやCRM連携、管理画面を含めて800万〜2,000万円、3〜6か月
- 中規模業務基盤:複数部門や名寄せ、移行、MA・SFA連携を含めて2,000万〜5,000万円、6〜12か月
- 全社規模:複数リージョン、大量データ、厳格なSLA、複数業務で5,000万円〜1.5億円超、12〜24か月以上
いずれも推定の目安です。データの状態、画面数、認証、テストの範囲によって、金額や期間は変わります。これらは、ノートに基づく推定で、公開されたNeptune案件の平均価格ではありません。
AWS利用料の積み上げ方
AWS利用料は、Neptune本体と関連サービスを分けて積み上げて見積もります。
- Neptune本体:DBインスタンス、ストレージ、I/O、バックアップ、Reader、Multi-AZ、Analytics、Neptune Workbench
- 実行・保管:S3、Lambda、ECS・EKS
- 接続・監視:CloudWatch、VPC接続、データ転送
- 支援・稼働時間:AWS Supportを含め、本番系と営業時間だけ使う検証系を分ける
AWS公式料金例では、米国東部のdb.r5.largeを1台、50GBのデータ、100GBのバックアップ、月2億I/Oで296.61米ドルです(出典:AWS公式「Amazon Neptune pricing」、2026年確認)。
I/O-Optimizedの例は350.56米ドルです。1米ドル=150円で機械的に換算すると、それぞれ約4.4万円と約5.3万円になります。
為替やリージョンによって金額は変わります。たとえば、Writer 1台とReader 3台の4台構成では、月額5,740.10米ドルの例があります。
可用性と読み取り分散を高めるほど、インスタンス費が大きくなります。
保守・改善費の別枠での確保
モデルを作ったあとも、データ品質とクエリの改善が続きます。そのため、保守・改善費はAWS利用料と分けて見積もります。
- 保守費の目安:初期開発費の年10〜20%程度を仮置きする考え方
- 対象作業:24時間監視、障害・セキュリティ対応、データ品質改善、機能追加
- 生成AI連携:Bedrockのモデル・埋め込み・再ランキング、S3、監視の費用を別途見積もる
保守費は、含める作業の範囲によって変わります。そこで、利用量に連動する費用と人員に連動する費用を分けて見積もります。
2025年3月、AWSはAmazon Bedrock Knowledge BasesのGraphRAG一般提供を発表しました(出典:AWS公式ブログ、2025年)。
GraphRAGは文書から抽出したエンティティと関係をNeptune Analyticsに保存し、検索時に周辺関係をたどって回答の文脈を補えます。
Amazon Neptuneの見積もりを取る際のポイント
金額だけで比べると、データクレンジングや運用設計が抜けた提案を安く見てしまうことがあります。
提案依頼書には、目的、対象ユーザー、代表クエリを記載します。さらに、データソースや件数、増加率などの規模の情報と、連携先も書き添えます。
権限と可用性、RTO・RPOも、提案に含めてもらいます。納品物と保守期間についても、提案の段階で示してもらいます。未確定の項目は、前提条件と追加費用の発生条件を明記してもらいます。
見積もり依頼前に準備する資料
見積もりの精度を上げるには、発注側が次の資料と条件をそろえておきます。
- 業務・画面:業務フロー図、画面または帳票一覧
- データ・負荷:項目表、連携先、ユーザー数、月間登録・検索件数、ピーク時間帯
- 個人情報:項目ごとの機微性、利用目的、保存期間、削除要件
- 検証用データ:匿名化し、実データに近い文字数、重複率、欠損率を保つ
代表クエリは、入力と期待結果が分かる形にしておきます。たとえば、企業から関連子会社を2ホップで探す例があります。
同じ人物の別名義を見つける例や、契約中の製品から影響を受ける顧客を探す例もあります。また、検索結果の正しさを誰が判定するかを決め、正解データによる精度評価の費用も見積もりに含めます。
開発会社の比較項目
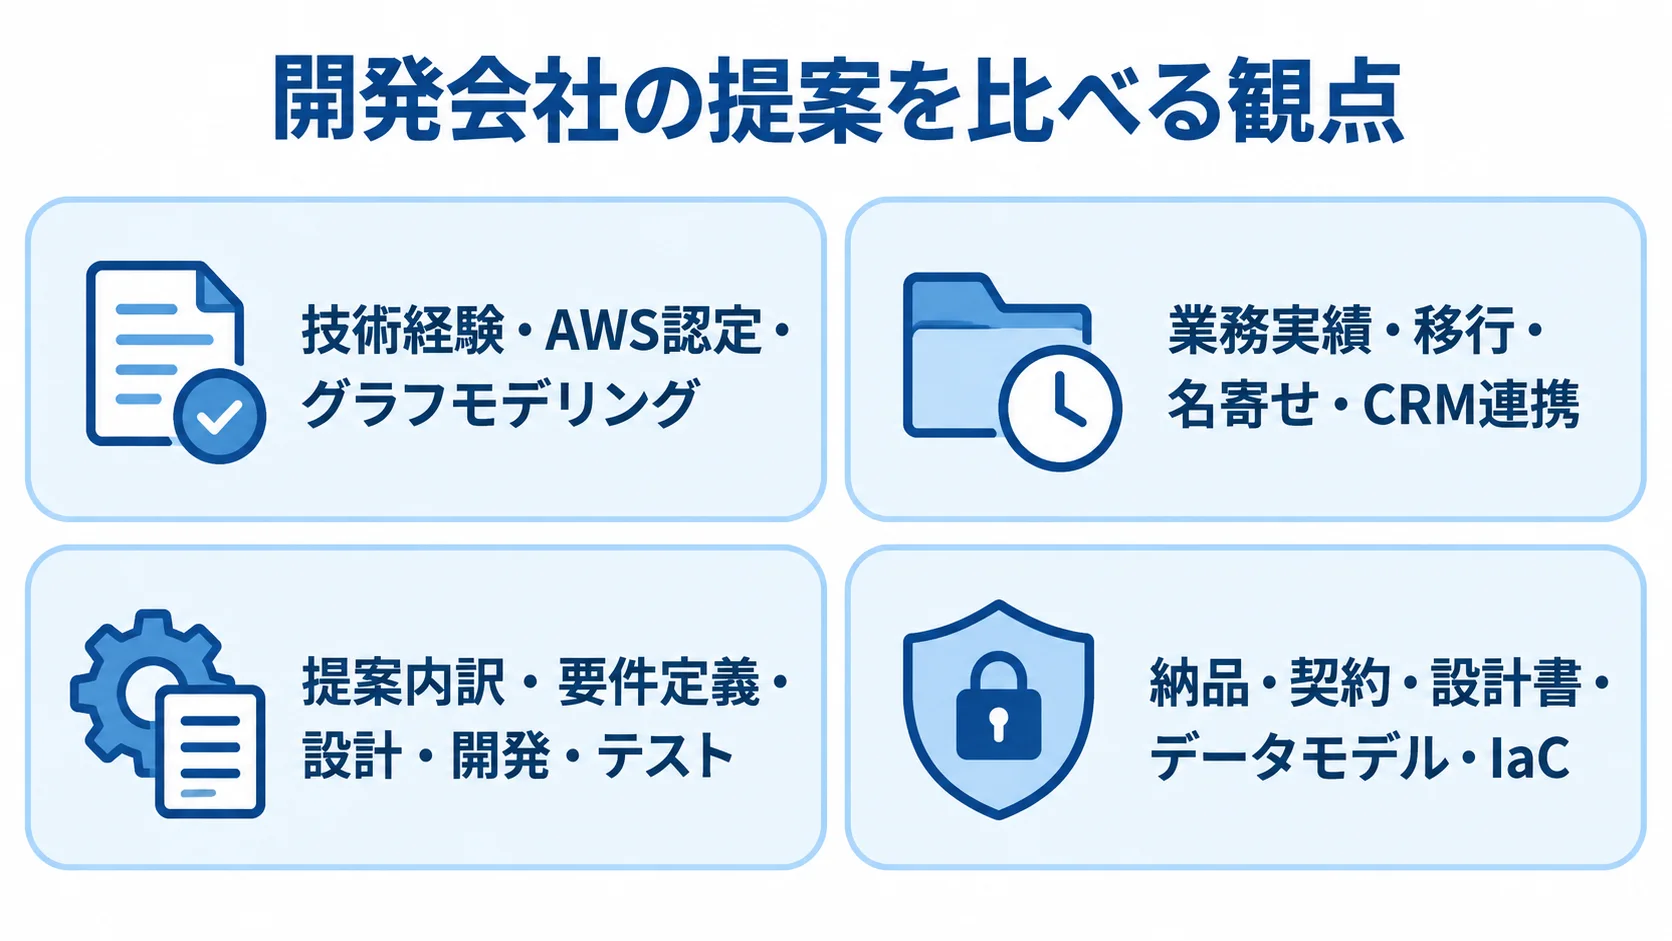
発注側は、開発会社を技術力と見積もりの内訳で比べて選びます。納品物と契約条件も、比較の対象にします。
- 技術経験:AWS認定、クラウド構築、グラフモデリング、Gremlin・openCypher・SPARQL
- 業務実績:移行、名寄せ、業務UI、CRM・SFA・MA連携の実績。Neptuneの実績がない場合は、類似案件の規模、改善クエリ、成果を見る
- 提案内訳:要件定義、設計、開発、テスト、移行、教育、保守の工数と除外項目
- 納品・契約:設計書、データモデル、API仕様、IaC、テスト仕様、ソースコード、運用手順、変更条件
AWSパートナーに認定されていても、それがNeptuneの専門性を示すとは限りません。
発注側は、契約終了後に自社で運用できるかを確認します。あわせて、PoC後の移行、権限、監視で追加請求が生じる条件も事前に把握しておきます。
最新動向の見積もりへの反映
新機能は、要件との適合性を確かめてから採用します。次の動向は、見積もりに入れて確かめます。
- 空間データ:2026年3月対応。ISO 13249-3準拠の11関数とGEOMETRY型(出典:AWS公式What’s New、2026年)
- デュアルスタック:2026年6月にIPv4・IPv6両対応を発表(出典:AWS公式What’s New、2026年)
空間データを使うと、商圏、拠点、配送ルート、設備位置を関係データと一緒に扱えます。そのため、位置情報を別のDBで管理する構成を減らせる可能性があります。
地理情報の精度や座標系は、別途確かめる必要があります。表示画面と、個人の位置情報の保護設計も別途必要です。
デュアルスタックを使うと、既存ネットワークとの互換性を保ちやすくなります。社内DNSやセキュリティグループ、接続元を設計し、監視と障害切り分けもテストします。
最新機能が自社の要件に必要かどうか、対応リージョンとSDK・クライアントが合うかを確認します。
よくある質問
Amazon Neptuneの開発では、採用の可否や期間についての質問が多く寄せられます。既存CRMとの関係やセキュリティ、費用についても、よく質問されます。
ここでは、計画の段階で判断しやすい質問に答えます。
Amazon Neptuneは顧客管理システムに必ず必要ですか?
必ずしも必要ではありません。顧客情報や商談ステータスの登録・一覧が中心なら、既存CRMやRDBで足りることが多いです。
複雑な関係検索が業務成果に直結する場合は、Neptuneを候補にします。たとえば、企業と人物、商品をつなぐ検索や、契約や行動をたどる検索が該当します。
既存構成のJOINや連携が過度に複雑になる場合も、採用を検討できます。
Amazon Neptuneのシステム開発にはどのくらいかかりますか?
対象を技術検証から中規模の業務基盤へ広げると、開発期間は次のように延びていきます。
- 技術検証:1〜2か月程度
- 小規模本番:3〜6か月程度
- 中規模業務基盤:6〜12か月程度
期間は、含める範囲が広いほど長くなります。画面数やデータ移行、名寄せが増えると、その分だけ延びます。連携先や権限、テスト、利用者教育も、含める範囲に入ります。
期間を短くするには、対象業務を一つに絞り、PoCの合格条件と本番移行の範囲を先に決めておきます。
個人情報をAmazon Neptuneに保存しても安全ですか?
Neptuneは、VPCやTLS、IAMを組み合わせて保護できます。暗号化やバックアップも、その保護の一部として使えます。ただし、保存するだけで自動的に安全になるわけではありません。
- アクセス管理:データ分類、最小権限、アクセス監査
- データ管理:削除・訂正、連携先への反映、バックアップの扱い
- 運用対応:インシデント対応
匿名データのPoCから本番の個人データへ移す前に、法務、情報システム、業務部門が、利用目的と権限を確認します。
Amazon Neptuneは生成AIやGraphRAGにも使えますか?
Amazon Neptuneは生成AIやGraphRAGにも使えます。AWSは2025年にAmazon Bedrock Knowledge BasesのGraphRAG一般提供を発表しました。
- データ保存:文書から抽出したエンティティと関係をNeptune Analyticsに保存する
- 回答への利用:検索時に周辺関係をたどり、回答に活用する
回答精度や根拠の表示は、文書の品質によって左右されます。そのほか、チャンク分割や埋め込みも関わり、再ランキングやガードレールの設定も影響します。
ほかの生成AI導入と同じように、評価データと合格基準を用意しておきます。
まとめ
Amazon Neptuneの開発は、顧客や企業、商品などの関係を活かし、業務判断を改善するプロジェクトです。グラフDBの導入は、その手段にあたります。
要件整理で代表クエリとKPIを決め、選定でRDBやCRMとの役割を分けます。そのうえで、設計から定着まで同じ指標で確認します。
着手前に確認するチェックリスト
着手の前に、発注側は次の項目を確認します。
- 業務課題:関係検索が必要な用途を一つに絞り、代表クエリと期待結果、データオーナーを決める
- データと負荷:名寄せ、個人情報、権限、削除、更新頻度、ピーク負荷を確認する
- 運用と発注:RTO・RPO、PoC合格基準、AWS利用料上限、設計書とIaCの受領を決める
未定の項目が残るなら、全社開発をすぐに発注せず、要件整理やPoCとして見積もりを分けて依頼します。
最初に取るべきアクション
過剰投資を避けるには、用途を絞り、PoCで構成と効果を確かめます。
- 営業、顧客管理、セキュリティ、商品推薦などから、関係検索の効果を測りやすい用途を一つ選ぶ
- 匿名化したサンプルデータと代表クエリを用意し、Neptune Database、Neptune Analytics、既存CRMやRDBを含む構成案を比べる
- PoCで性能、正確性、運用負荷、費用を測り、本番化か別構成かを判断する
実測の結果を見てから判断すれば、過剰投資を避けながら、Amazon Neptuneのシステム開発を始められます。
▼全体ガイドの記事
・Amazon Neptuneのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。