
Amazon Neptuneのシステム開発は、業務に合うかどうかを判断したうえで、DatabaseとAnalyticsの構成とクエリ言語を決める流れで整理できます。
活用業務、開発の進め方、費用と運用の順に見ていきます。各テーマの詳細は、下の関連記事もご覧ください。
▼関連記事一覧
・Amazon Neptuneのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Amazon Neptuneのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Amazon Neptuneのシステム開発の見積相場や費用/コスト/値段について
・Amazon Neptuneのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Amazon Neptuneのシステムの概要
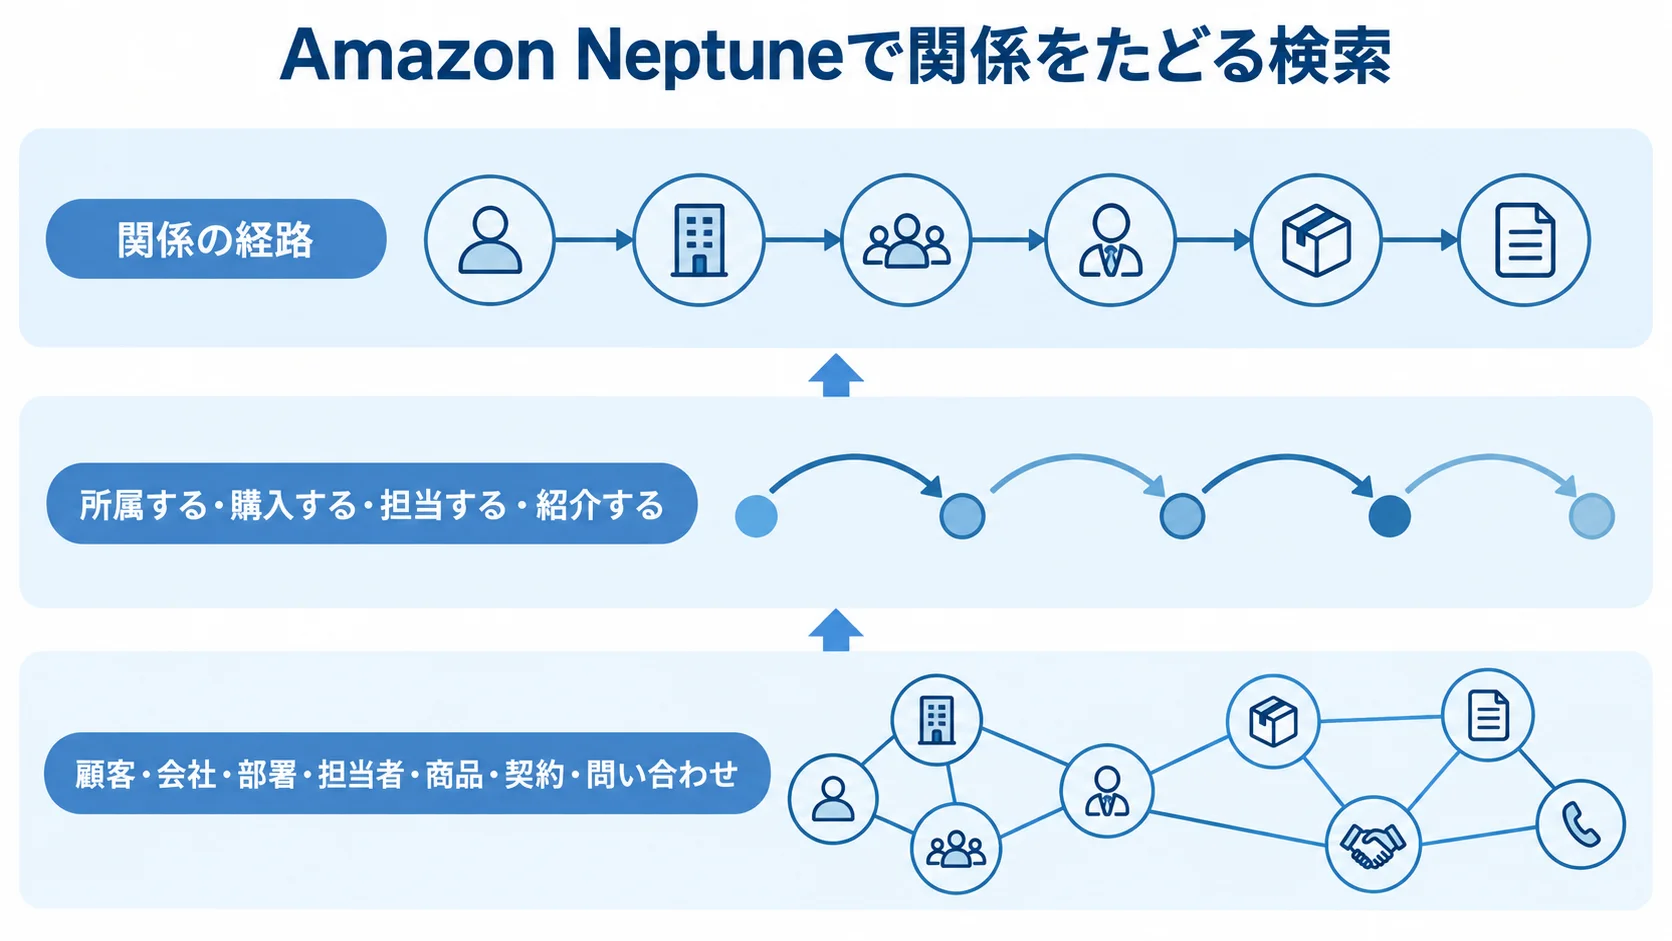
Amazon Neptuneは、ノードとエッジでデータの関係を表す完全マネージド型のグラフデータベースです。たとえば、顧客、会社、部署をノードとして登録できます。担当者、商品、契約、問い合わせも、ノードとして扱えます。
「所属する」「購入する」「担当する」「紹介する」といった関係は、エッジとして保存します。そのため、複数の表を何度も結合するより、関係をたどる検索を設計しやすいのが特徴です。
グラフデータベースの得意分野
グラフ型では、検索結果を一覧としてだけでなく、関係の経路として扱えます。
- 多段探索:企業の担当者が接点を持った子会社や契約商品を、関係をたどって洗い出します。
- 重複リード検知:同じ人物にひもづくリードを見つける用途です。
- 関係分析:推薦、ナレッジグラフ、不正検知、ネットワーク分析、顧客360度ビューの各用途に使います。
セキュリティ上のリスク要因を数百億件の関係で保持する事例があります。
日々数十億のクラウド資源を分析する事例もあります(出典: Amazon Neptune公式ケーススタディ、2026年確認)。
ただし、この規模は一般的な営業システムにそのまま必要なわけではありません。関係の複雑さを扱うためにグラフを選ぶという考え方を理解する材料になります。
CRMやRDBとの役割分担
入力画面や営業プロセスは、Neptuneを導入しても自動では整いません。CRMやRDBとNeptuneは、次のように役割を分けて使うと整理しやすくなります。
- 既存システム:商談登録、配信停止、請求処理、帳票出力を担います。
- Neptune連携:日常の登録と基幹データは既存システムに残し、関係探索や横断分析に使うデータを連携します。
- 採用判断:顧客一覧、完全一致のマスタ検索、集計だけが目的なら、学習・連携・運用の負担が増える可能性があります。
関係をたどることで、どの業務判断が速くなるのかを、言葉で説明できるかを確かめておきます。
Amazon Neptuneが向いている業務
向いているのは、データ件数よりも、関係の種類と経路が増え続ける業務です。
候補は、顧客360度、名寄せ、商品推薦、営業関係の可視化です。ほかに、サプライチェーン、不正検知、ナレッジ検索もあります。ただし、用途名をそのまま採用理由にせず、自社の検索や判断に置き換えて考える必要があります。
顧客360度ビューと名寄せ
複数のサービスを使うと、同じ会社が異なる表記で登録されることがあります。そのため、名寄せでは次の点を設計します。
- 関係データ:会社、部署、担当者、メール、契約、問い合わせを、関係で結んで持たせます。
- 名寄せ運用:正解の自動判定とは切り分けて、照合ルール、確認者、履歴、削除依頼への対応を決めておきます。
- 効果測定:検索時間、重複リード率、担当者間の引き継ぎ漏れ、休眠顧客への再接触件数を、導入の前後で比べます。
関係データを使うと、表記の違いを吸収した探索画面を作れます。
営業は、子会社、導入済みの製品、過去の接点を一画面で確認できます。
推薦・不正検知・ネットワーク分析
推薦や不正検知では、関係の経路をたどって、結果の背景を探索できます。
- 商品推薦:閲覧・購入商品、似た属性の顧客、関連契約を関係としてつなぎます。
- 不正検知:口座、端末、住所、申込、取引、過去のアラートをつないで見ます。
- 関係探索:単独では異常に見えない組み合わせを探し、その理由を経路で説明します。
- 役割分担:順位・スコアやモデル管理は別に設計し、分析、特徴量、評価、画面、承認の役割を分けます。
推薦順位、不正スコア、機械学習モデルの管理まで、Neptuneだけで完結するわけではありません。そのため、グラフは関係を取得し、判断に必要な文脈を返す層として定義します。
GraphRAGと位置情報を使うシステム
GraphRAGと空間機能は、文書間の関係や位置を含む検索に使えます。
- GraphRAG:社内規程、製品資料、商談記録など文書間の関係を検索対象にします。
- 空間情報:顧客拠点と営業エリア、店舗と配送ルートなどを、関係と位置の両方で扱えます。
2025年にはAmazon Bedrock Knowledge BasesのGraphRAGが一般提供されました。
GraphRAGは、文書のエンティティと関係をNeptune Analyticsに保存します。そのため、ベクトル検索だけでは拾いにくい周辺情報を回答へ加えられます(出典: Amazon Web Services公式ブログ、2025年)。
社内規程、製品資料、商談記録が文書をまたいでつながる場合は、根拠文書と関係経路を示す検索基盤として検討できます。
2026年にはNeptune Databaseの地理情報機能が拡充されました。点・線・面、距離、包含、交差などは、openCypherから扱えます(出典: Amazon Neptune公式What’s New、2026年)。そのため、別の空間データベースとの役割分担を見直せる可能性があります。
種類・構成・クエリ言語の選び方
設計では、データモデル、オンライン照会、分析処理、クエリ言語をそれぞれ別々に決めます。
まずは代表的な検索を数本に絞り、更新頻度と利用者数をもとに構成を選びます。
Neptune DatabaseとNeptune Analyticsの違い
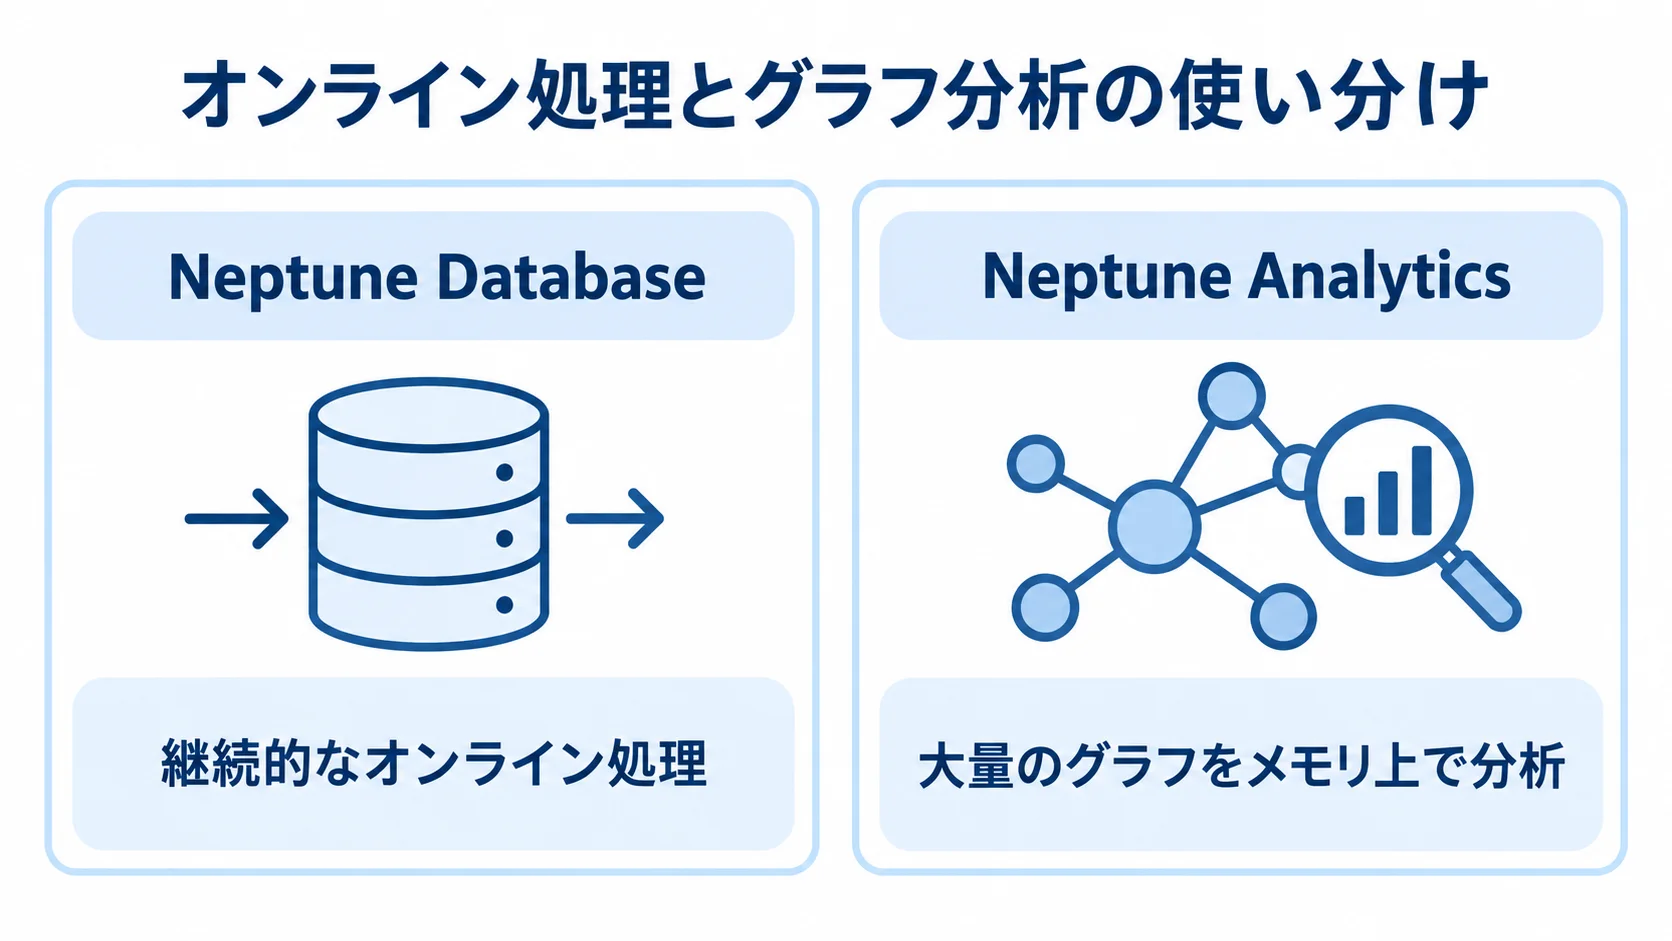
Databaseは継続的なオンライン処理、Analyticsはグラフ分析に使います。
- Neptune Database:アプリから継続してグラフを読み書きします。
- Neptune Analytics:大量のグラフをメモリ上で分析します。
Databaseでは、顧客画面の関係検索やAPI照会、イベントによるエッジ更新ができます。WriterとReaderを分ける場合は、読み取り負荷や障害時の切り替え、台数を費用と合わせて検討します。
Analyticsでは、ページランク、類似度、経路探索を実行できます。常時オンラインのDBと、必要な時間だけ動かす分析環境を分けると、業務検索と集計の干渉リスクを抑えられます。
未使用のAnalyticsグラフは、一時停止すると通常のコンピューティング料金の10%で保持できます(出典: Amazon Neptune公式料金ページ、2026年確認)。
Gremlin・openCypher・SPARQLの選び方
顧客、案件、接点をプロパティグラフで扱うなら、GremlinかopenCypherが候補になります。言語は、データ形式とチームの経験に合わせて選びます。
- Gremlin:段階的にたどる処理を細かく表現でき、知識やライブラリとの相性も確かめます。
- openCypher:SQLに近い宣言型の書き方で、業務担当者と検索条件を共有しやすい言語です。
- SPARQL:語彙や意味を厳密に定義し、複数ソースを知識グラフに統合するときに検討します。
顧客関係だけを扱う場合に、将来性を理由にRDFを選ぶと、設計や人材育成の負担が先に立つことがあります。そこで、代表クエリを3言語で試し、応答時間、可読性、保守担当者の確保を比べます。
Amazon Neptuneのシステム開発の進め方
開発では、業務課題、データ品質、代表クエリ、運用体制の順に確かめます。
既存のCRMやSFAを取り込む場合は、モデル設計より前にデータを棚卸しします。そのとき、識別子、更新日時、同意状態、削除要件、データの出典を確かめます。
要件定義とデータ棚卸し
最初に、誰がどの判断を何秒以内に行うかを決め、データと成果指標を棚卸しします。
- 業務シナリオ:営業は顧客の関連会社と契約状況を確認し、マーケティングは同じ人物への重複配信を止め、管理者は取引関係の異常を調べます。
- 成果指標:検索時間、判断の正確性、確認作業、対応漏れの減少を、指標として定めます。
- データソース:CRM、SFA、MA、ERPを一覧にします。Web行動、問い合わせ、契約、名刺も加えます。
- データ管理:IDごとの更新日、利用目的、出典、保持期限、権限、訂正・削除手順を整理します。
サンプルデータで表記揺れと重複を先に確かめておくと、PoC後の移行で費用が膨らみにくくなります。
グラフモデル・API・アプリケーションの設計
モデル、API、画面の設計では、次の事項を決めます。
- データモデル:ノード、エッジ、属性、履歴、時点情報、削除・訂正を扱える形にします。
- 追跡情報:関係の成立時点とデータソースを保持し、監査に備えます。
- クエリ仕様:代表クエリごとに、多段探索の深さ、最悪時の結果件数、ページング、タイムアウトを仕様として定めます。
- API:認証、認可、入力検証、監査、レート制限を行う部分です。
画面は、既存のCRMや営業ポータルに組み込むか、専用に新設します。ノード、経路、根拠、更新日時を表示すると、関係を理解しやすくなり、現場にグラフの価値が伝わります。
PoC・テスト・本番化
PoCから本番化まで、範囲を絞って性能と運用を確かめます。
- PoC範囲:全データは移さず、1ユースケース、代表ノードとエッジ、クエリ、異常系データで検証します。
- 測定:レイテンシ、同時接続数、書き込み量、ロード時間、検索精度、月額費用を測ります。
- 合否判定:平均値だけでなく、アクセス集中時と最悪ケースの多段探索も確認します。
- 本番準備:Infrastructure as Code、CI/CD、監視、アラート、バックアップ、復旧訓練を整えておきます。
- 運用:Reader構成、障害連絡先、データ品質責任者を定め、環境の稼働時間とクエリ遅延、I/Oを管理します。
たとえば、開発環境は常時起動せず、分析環境は必要なときだけ使う方法があります。
Amazon Neptuneのシステム開発費用・料金相場の目安
費用は、AWS利用料と、要件定義・設計・移行・開発・保守の費用に分けて考えます。料金表だけで見積もると、連携、監視、権限、データ品質、教育費を見落としやすくなります。
以下の金額は、公式料金例と類似する営業・CRMシステムの相場に基づく推定です。実際の見積を保証するものではありません。
▶ 詳細はこちら:Amazon Neptuneのシステム開発の見積相場や費用/コスト/値段について
NeptuneのAWS利用料
公式例のAWS利用料は構成によって異なるため、以下の金額はあくまで目安です。
- 料金変動:リージョン、インスタンス世代、為替、稼働時間、I/O量で変わります。
- 本番構成:複数台、検証環境、バックアップ、監視、転送、接続先の計算資源も費用に影響します。
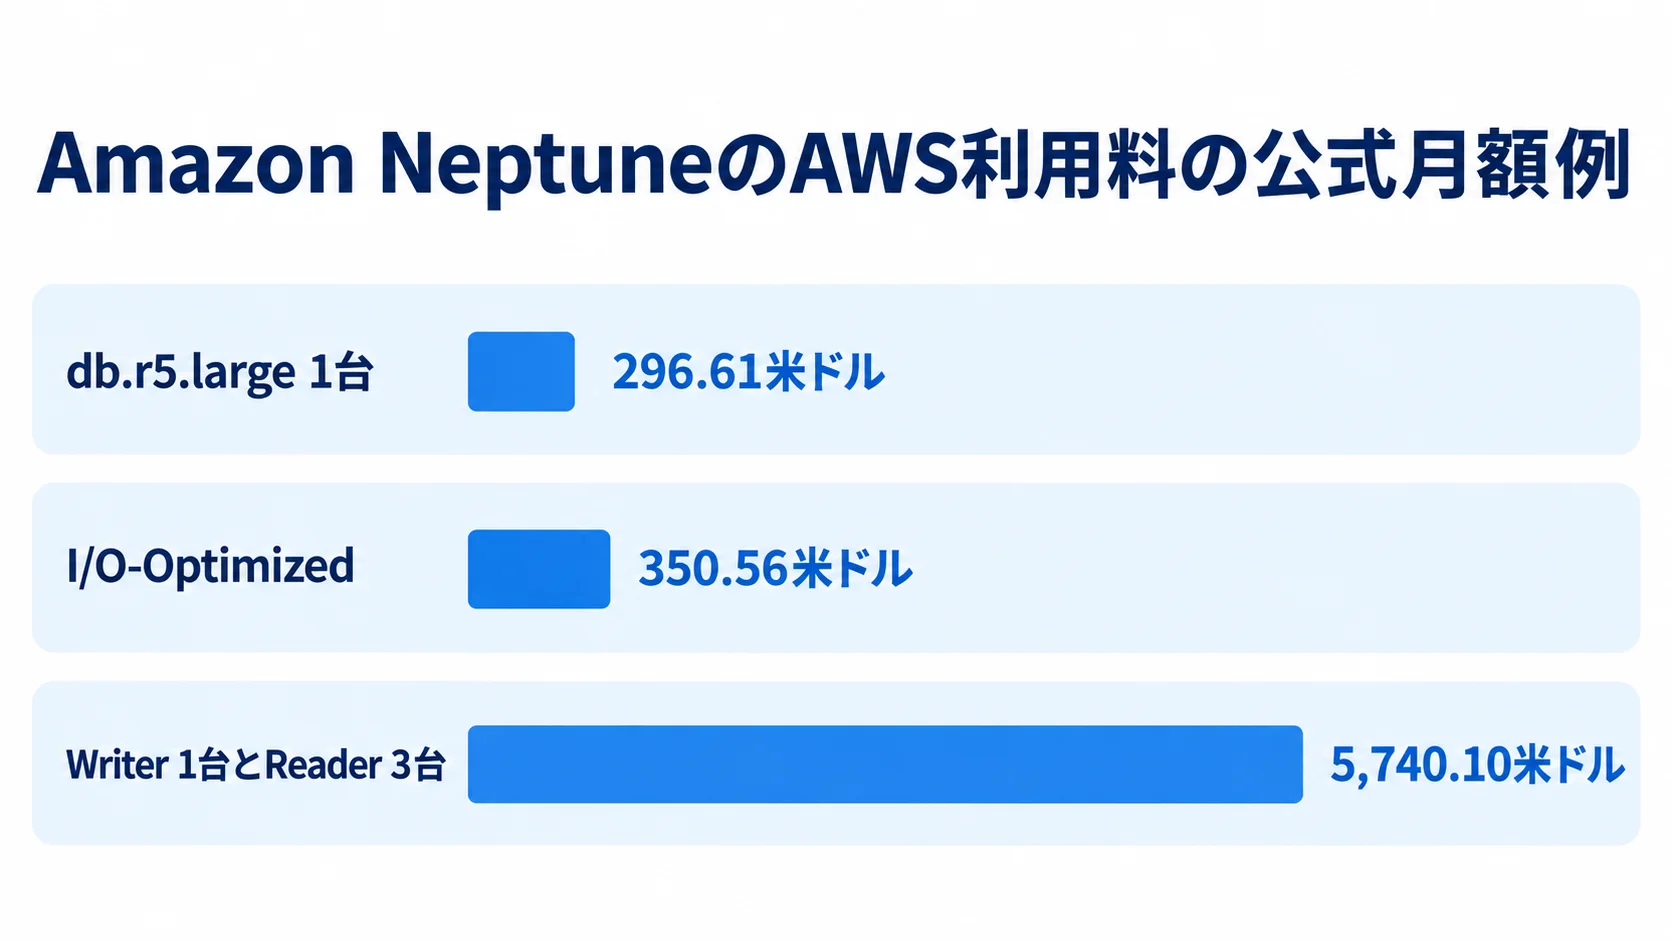
米国東部のdb.r5.large 1台、データ50GB、バックアップ100GB、月2億I/Oという例では、月296.61米ドルです。1米ドルを150円で換算すると約4.4万円です。同じ条件のI/O-Optimizedは、月350.56米ドル、約5.3万円です(出典: Amazon Neptune公式料金ページ、2026年確認)。
Writer 1台とReader 3台の計4台に、分析用ノートブック、ストレージ、I/Oを含めた公式例は、月5,740.10米ドルです。150円で換算すると約86万円です(出典: Amazon Neptune公式料金ページ、2026年確認)。つまり、構成によって月額は数十万円から100万円超になる可能性があります。
開発会社へ依頼する費用の目安
開発費は規模や範囲に応じて変わります。以下の金額は、営業・CRM相場などからの推定です。
- 技術検証PoC:1ユースケース、少量データ、モデル、代表クエリで300万〜800万円、1〜2か月程度です。
- 小規模本番:顧客360度、CRM連携、管理画面を含み800万〜2,000万円、3〜6か月程度です。
- 中規模基盤:複数部門の名寄せ、権限、監査、移行、MA・SFA連携で2,000万〜5,000万円、6〜12か月程度です。
- 全社規模:大量データ、厳格なSLA、複数リージョン・業務で5,000万円〜1.5億円超、12〜24か月以上の可能性があります。
営業・CRM相場に、グラフ設計、移行、基盤構築の工数を加えた推定で、Neptune固有の統計ではありません。
見落としやすいランニングコスト
インスタンス、ストレージ、I/O、バックアップの費用に加えて、次の費用も見積もります。
- 関連サービス:分析環境、S3、Lambda、コンテナ、監視が対象です。ログ保管、転送、サポート、セキュリティ運用も含まれます。
- 環境数:開発・ステージング・本番を分けると、環境数に応じて固定費が増えます。
- 稼働時間:夜間や休日に停止できる環境と、常時稼働が必要な環境を分けます。
- 保守費:初期開発費の年10〜20%を仮置きし、問い合わせ、クエリ調整、更新、復旧訓練を含むかを確かめます。
- 保守範囲:脆弱性対応、データ品質改善、利用部門の追加について、契約での扱いを決めておきます。
AWS利用料と保守費用を分けて、利用量で増える費用と人が対応する費用を見積もります。そうすると、予算変動の理由を説明できるようになります。
セキュリティと運用の設計
顧客情報や営業機密をNeptuneに保存する場合も、法令や社内規程への適合は、DBの機能に加えて利用者側の運用まで含めて確かめる必要があります。
クラウド側と利用者側で責任を分け、利用目的、権限、監査、削除、事故対応を設計します。
ネットワーク・認証・暗号化
ネットワーク、認証、暗号化は、最小権限を基本に設計します。
- ネットワーク:アプリとNeptuneをプライベートVPCに置き、公開インターネットへ直接さらさない構成にします。
- 接続制御:セキュリティグループ、サブネット、ルート、接続元を絞り、APIから必要なポートと処理だけを許可します。
- 暗号化:TLS通信、保存データ、鍵管理、認証情報のローテーションを要件に含めます。
- 権限管理:IAMでアプリ、運用者、分析者、監査者を分け、業務ロールと閲覧範囲を対応させます。
- 個人情報:画面やAPIの単位でマスキングすることも検討します。
公式文書では、クラウド側と利用者側の責任共有モデルが説明されています(出典: Amazon Neptune公式セキュリティドキュメント、2026年確認)。
監視・バックアップ・障害復旧
監視項目と復旧方法を決め、実際に切り分けと復元ができる状態にしておきます。
- 監視:CPU、メモリ、レイテンシ、接続数を見ます。書き込み遅延、I/O、エラー率も確認します。
- データ連携:ロード失敗や更新遅延を見て、クエリ、インデックス、インスタンス、API、上流連携を切り分けます。
- バックアップ:保持期間、保管場所、復元テスト頻度、目標復旧時間と目標復旧時点を定めます。
Readerを増やしても、データ破損や誤更新から自動的に守られるわけではありません。そのため、復旧手順を文書化し、担当者が実際に復元できるかを確かめます。
2026年時点の更新要素
新機能は接続影響と運用負荷を確かめ、PoCの範囲を絞って評価します。
- IPv6:2026年にデュアルスタックが利用可能になり、IPv4環境との段階的な接続を選べます。
- 構成候補:Graviton、サーバーレス、I/O-Optimized、GraphRAG、空間データは改善候補です。
- 採用範囲:使う機能と将来の選択肢を分けて、クエリ知識、検証環境、監視、運用ルールが増える点を考慮します。
IPv6対応が使えても、移行が不要とは限りません。接続先、監視、アクセス制御、名前解決、障害経路を検証し、既存アプリへの影響も確認します。IPv6の詳細は、Amazon Neptune公式What’s Newで確認できます(出典: Amazon Neptune公式What’s New、2026年)。
Amazon Neptuneの開発会社・ベンダーの選び方
委託先は、AWS構築、グラフ設計、移行、業務アプリ、セキュリティ、運用をまとめて任せられるかで選びます。公開実績があっても、自社のデータ量、クエリ、部門、SLAに合うとは限りません。
提案の段階では、課題を測る指標、納品物、運用担当者を確認します。
グラフ設計とデータ移行の経験
Neptuneの利用経験だけでなく、設計、移行、引き継ぎまで含めた実務経験を確かめます。
- 設計:プロパティグラフとRDF、ノード・エッジの粒度、履歴や削除の表現を質問します。
- 移行・検証:クエリ調整、バルクロード、重複排除、移行後の差分検証を確認します。
- 実例確認:匿名化した実データに近いサンプルで、検索結果とモデルを説明してもらいます。
- 納品と継続性:設計書、データ辞書、クエリ一覧、IaC、テスト・移行・障害対応手順を受け取ります。
特定の担当者の知識に依存すると、追加開発や障害対応の費用と時間が増えます。
対応範囲・見積・運用体制
見積、契約範囲、運用担当は、項目ごとに分けて確認します。
- 見積項目:要件定義、棚卸し、設計、基盤、API、画面を分けます。さらに、連携、移行、テスト、教育、保守も別の項目にします。
- 追加費用:PoC後の本番移行や権限設計、仕様変更単価、追加データソース、AWS利用料の請求方法を確認します。
- 運用範囲:時間外障害対応、監視一次対応、クエリ改善、データ品質の担当を決めます。パッチ、復旧、月次費用レビューについても、担当を明確にします。
- 内製化:自社担当者が設計をレビューし、PoCで操作や障害訓練を経験できる契約にします。
PoCの費用が安くても、本番移行などが別契約であれば、総額は変わります。
全面的に委託する場合でも、データの利用目的と業務上の責任者は自社で持つ必要があります。
▶ 詳細はこちら:Amazon Neptuneのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Amazon Neptuneのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:Amazon Neptuneのシステム開発の発注/外注/依頼/委託方法について
失敗しやすいパターンと採用判断のチェックポイント
業務課題と運用が曖昧なまま導入すると、データを蓄積しても、現場の判断が変わらないことがあります。採用の前に、Neptuneを使わない構成と比べて、費用、性能、期間、運用負担を数値で確認します。
よくある失敗と対策
失敗を避けるには、要件、データ、利用者、性能の検証をそろえておく必要があります。
- 過剰な採用:一覧や定型帳票は既存CRMやRDBに残します。
- データ品質の放置:名寄せルールとデータ責任者を、先に決めておきます。
- 利用者不在の設計:技術者だけで決めず、営業・管理・分析担当に、入力や画面導線を含むシナリオを試してもらいます。
- 平均値だけの検証:ピーク、障害復旧、最悪ケースも合否の対象に含めます。
単純な一覧、定型帳票、厳密なトランザクションが中心なら、既存の仕組みを残し、関係探索だけを追加する構成も比較します。
検証では、重複や表記揺れのほか、関係の正確性も確かめます。さらに、ピーク負荷、更新遅延、権限エラー、バックアップ復旧も確認します。
PoCを合格にする指標
PoCの合格条件は、業務要件に合わせて、数値や動作で定めます。
- 性能:代表クエリの95パーセンタイル応答時間を目標以内にします。
- 利用状況:月間想定アクセス時のエラー率や名寄せ候補の確認時間を測ります。
- 運用条件:夜間の許容時間内にロードでき、権限ごとの閲覧範囲を守れるかを確かめます。
具体的な数値は自社の要件から決め、後から都合よく変えないようにします。
不合格のときは、クエリ、モデル、インスタンス、RDBとの分担を見直すか、採用を中止するかを決めます。また、必要な関係処理だけをNeptuneに残し、他のデータは既存システムに置く方法もあります。
よくある質問
導入時によく相談される疑問に回答します。費用や既存システムとの関係は、データ量だけでなく、業務要件と運用条件から考えます。
Amazon Neptuneは既存CRMの代わりになりますか?
Neptuneで既存CRMをそのまま代替できるとは限りません。関係探索や分析に強い一方で、入力画面、営業プロセス、配信停止、帳票、権限画面は別途構築が必要です。
既存CRMを業務の中心に残し、Neptuneを関係検索基盤として連携する構成も現実的です。
Amazon Neptuneの月額料金は数万円で収まりますか?
小規模な検証環境だけなら数万円程度に収まる可能性がありますが、本番構成でも同額になるとは限りません。
- 1台構成:公式例は月額296.61米ドルです。
- 4台構成:WriterとReaderを合わせた公式例は月額5,740.10米ドルです。
- 見積条件:台数、I/O、バックアップ、分析を含めます。監視、接続先サービス、為替も見積条件に入れます。
GremlinとopenCypherはどちらを選べばよいですか?
選定では、チームの経験や既存モデルとの相性を見たうえで比べます。
- 比較軸:代表クエリの書きやすさ、応答時間、可読性、保守担当者を確認します。
- Gremlin・openCypher:顧客や案件の関係を同じサンプルで試します。
- RDF・SPARQL:複数ソースで語彙や意味を統合する要件が強い場合に候補とします。
個人情報をAmazon Neptuneへ保存しても問題ありませんか?
個人情報を保存できるかは、法令や社内ルールを含めて項目ごとに判断します。
- 確認事項:データの種類、利用目的、社内規程、契約、法令を確認します。
- 運用条件:アクセス制御、保管場所、削除手順を確かめます。
技術面では、VPC、TLS、IAM、暗号化を整えます。さらに、監査ログ、バックアップ、権限分離も加えます。それでも、利用目的や同意管理は別途必要です。個人情報保護の担当者と開発の担当者が、それぞれの役割を分けて確認します。
まとめ
Amazon Neptuneは、顧客、企業、商品の関係をたどる処理に強い基盤です。契約、担当者、文書、リスクといった関係も、たどる対象になります。導入の成否は、関係を使ってどの業務判断を速く正確にするかで分かれます。
まずは、RDBやCRMで足りる要件と、Neptuneが効果を発揮する多段探索を切り分けます。
DatabaseとAnalytics、Gremlin・openCypher・SPARQLの役割を、代表クエリで比べます。
PoCでは、性能、費用、データ品質、権限、復旧を測ります。
次に、AWS料金例を起点に、開発、連携、保守、監視の費用を分けて見積もります。
2025年のGraphRAG一般提供や、2026年の空間データ、IPv6デュアルスタックなどで、用途は広がっています。ただし、機能が増えても、採用が常に正解とは限りません。
現場の入力、個人情報、データ更新、運用責任者、代替案を整理してください。その後、必要な関係処理を小さく検証してから本番化してください。
▼関連記事一覧
・Amazon Neptuneのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Amazon Neptuneのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Amazon Neptuneのシステム開発の見積相場や費用/コスト/値段について
・Amazon Neptuneのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。