
Amazon SageMakerのシステム開発は、要件整理から定着まで6フェーズで進めます。モデルの精度だけでなく、現場で使い続けられるかまで見ながら、順に決めていきます。
▼全体ガイドの記事
・Amazon SageMakerのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Amazon SageMakerのシステム全体像
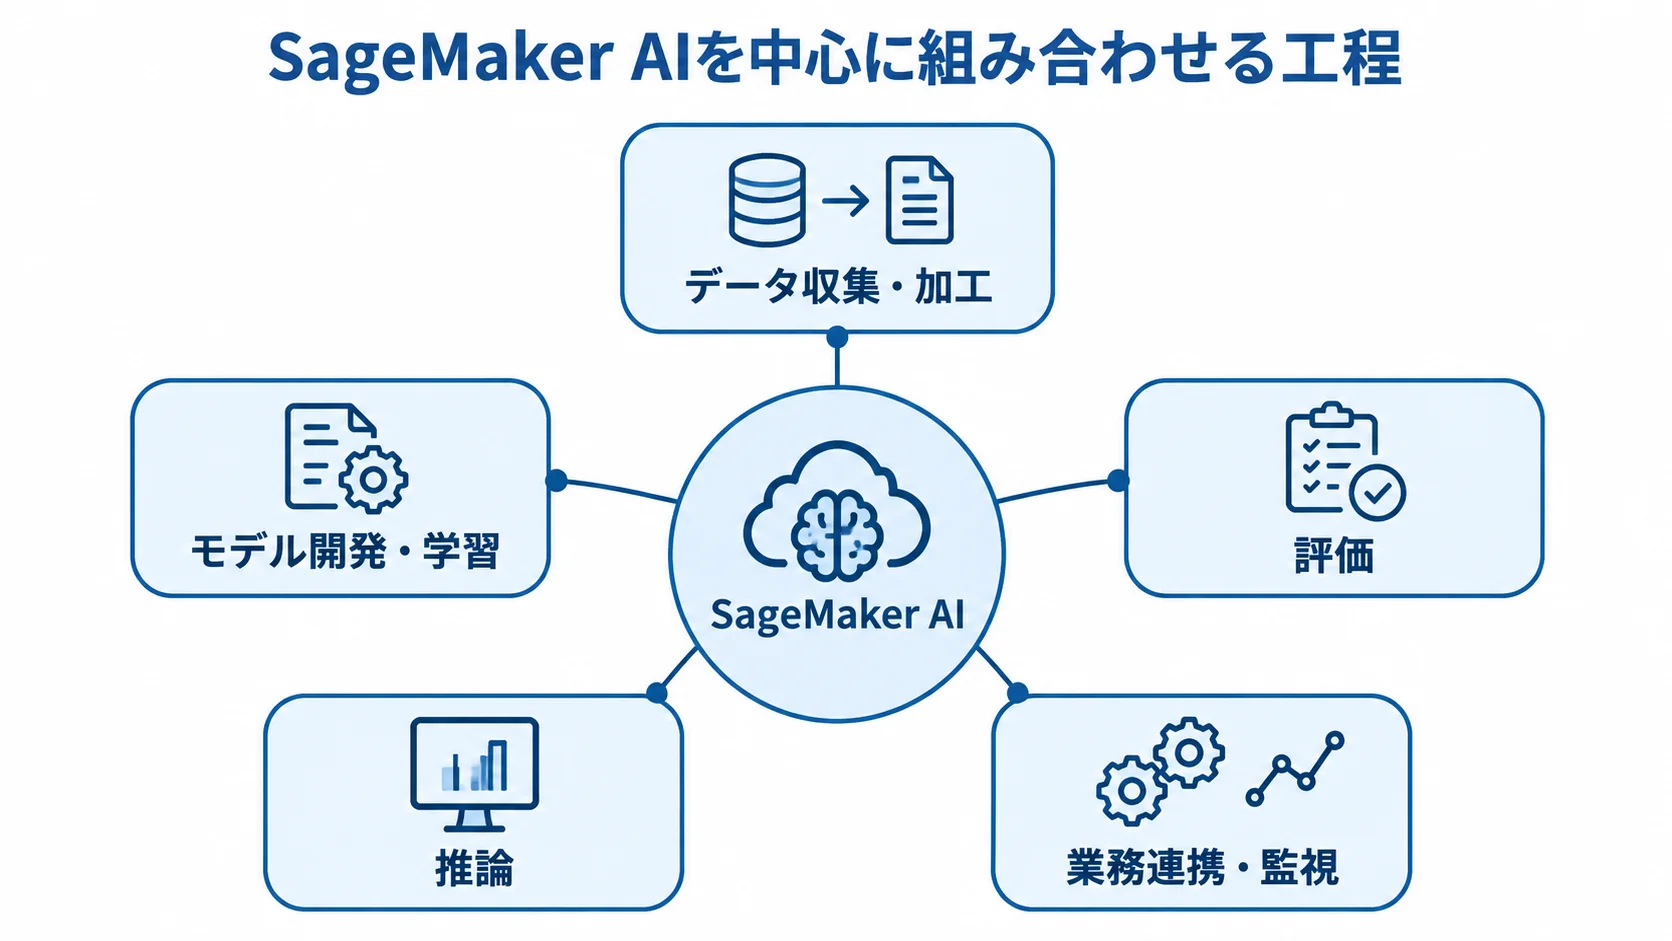
Amazon SageMakerのシステムは、SageMaker AIを中心に各工程をつなぐ基盤です。データの収集と加工からモデルの学習、推論までを扱い、業務との連携や監視も含みます。
SageMaker AIは、データ準備、モデル構築、学習、デプロイを支援するサービス群です。予測モデルを作るだけでなく、業務で結果を使い続ける方法まで設計します。
データから業務アクションまでをつなぐ仕組み
標準的な流れは、業務システムのデータをAmazon S3に集めることから始まります。
- CRM、MA、営業管理システムから、顧客情報、商談履歴、Web行動、問い合わせ履歴を取得します。
- AWS Glue、Athena、SageMaker Data Wranglerで、顧客IDの名寄せ、欠損処理、重複排除、学習ラベルの作成を行います。
- SageMaker Processingで、前処理を再現可能にします。
加工済みのデータはSageMaker Trainingで学習させ、評価に合格したモデルはModel Registryで管理します。予測結果は、画面で即時に返すか夜間にまとめて計算するかで、業務への戻し方が変わります。
- 即時にスコアを返す営業画面では、リアルタイム推論を使います。
- 夜間に全顧客を計算する場合は、Batch Transformやバッチ処理を使います。
- API GatewayやLambdaを介して、予測結果をCRMへ戻します。
- 担当者の電話、対象者へのメール、上長の承認など、予測後の行動を決めます。
営業・CRM・MAの四つの活用パターン
営業・CRM・MAで代表的な活用例は、成約、離反、需要、問い合わせの四つです。
- リードスコアリング:成約見込みを算出します。
- 解約予測:離反の兆候を検知します。
- 需要予測:過去の実績から、売上や需要を予測します。
- 問い合わせ分類:内容を担当部署へ振り分けます。
このほか、営業活動の優先順位付けやレコメンド、商談確度の予測、文章の要約も候補になります。
同じAI活用でも、必要な構成は業務のタイミングとモデル管理の範囲によって変わります。バッチで足りるか、入力と同時に応答が要るかで、構成の違いは大きくなります。
- 毎朝の抽出:フォロー対象を出す用途なら、バッチで足ります。
- 入力中の判定:Webフォームには、低遅延のエンドポイントが必要です。
- 独自モデルの管理:学習、評価、承認を繰り返す場合は、SageMaker AIが候補です。
- 基盤モデルの利用:API利用が中心なら、BedrockやCRM標準のAIが適する場合もあります。
2024年12月のAWS公式説明では、次世代SageMakerを、Unified Studio、Lakehouse、データとAIのガバナンスを含む統合プラットフォームとして紹介しています。
SageMakerを機械学習用の仮想マシンとだけ見ると、データカタログや権限、分析チームとの連携が漏れやすくなります。そのため、組織のデータ基盤として全体を設計します。
根拠は、AWS APN Blogの記事「Powering Partner Solutions with Next Generation Amazon SageMaker」です。2024年の公開記事を参照しています。
Amazon SageMakerのシステム開発の進め方
開発は、要件整理から定着まで6フェーズで進めます。内容は、次の見出しごとに見ていきます。フェーズを分けるのは、精度の高いモデルを作ることと、現場が継続して使えるシステムを作ることが、別の課題だからです。そのため、各フェーズで何を残すかと、何を基準に判断するかを決めておくと、PoCの長期化や納品後に使われなくなるリスクを抑えられます。
1. 要件整理での業務KPIと利用場面の定義
最初に決めるのは、どの業務をどう変えたいかです。たとえば、営業画面に毎朝、上位50件のフォロー候補を表示します。また、解約リスクが一定値を超えた顧客は、担当マネージャーへ通知します。
そのうえで、利用者、画面、タイミングを文章にまとめ、次のアクションを整理します。次に、KPIと許容範囲を決めます。リードスコアリングなら成約率や商談化率、解約予測なら見逃し率や通知後の継続率、問い合わせ分類なら正しい部署へ届く割合や処理時間が指標になります。
合否の判断には、AUCや正解率のほかに、誤判定が起きたときに人が確認できるかと、確認に何分かかるかも含めます。
要件整理では、担当者と本番移行の判断条件を先に揃えます。役割と条件は、五つの項目に分けて整理します。
- 業務責任者:対象業務を任せられる人
- 利用者:予測を使う担当者
- 対象範囲:対象外とする顧客やデータの線引き
- 最終判断者:誤判定が起きたときに結論を出す人
- 移行条件:PoCから本番へ進むための数値条件
条件が曖昧なままだと、技術的には完成していても、業務側が受け入れにくくなります。
2. 選定での推論方式とサービスの組み合わせ
要件が決まったら、保管から推論、監視までの各工程で使うサービスを選びます。
- 保管・検索:S3への保管と、GlueやAthenaによる連携・検索
- 加工・学習:SageMaker ProcessingとTrainingによる処理
- 承認・リリース:PipelinesとModel Registryによる管理
既存のRedshiftや外部DWHがある場合は、データの複製先と、どこまでの更新の遅れを許すかを決めます。
推論方式は、業務で必要な応答時間と処理量に合わせて選びます。方式ごとに、応答の速さと一度に扱う件数の多さで向き不向きが分かれます。
- バッチ:アクセスが少なく、1日1回や週1回の計算でよい場合に有力です。
- 非同期:入力が大きく、数秒以内の応答が不要な場合に候補です。
- リアルタイム:画面操作と同時に結果を返す場合に使います。
- Serverless Inference:リクエストが少ない場合に比較の対象になります。
生成AIやモデルカスタマイズでは、Amazon Bedrockとの役割分担も検討します。基盤モデルをAPIで呼び、ガードレールやナレッジ連携を中心に作る場合は、Bedrockが適することがあります。
一方で、独自モデルの学習から再学習までを統制する場合は、SageMaker AIが向いています。その統制には、データ・コード・モデルの版管理、評価、承認も含まれます。
2025年12月には、サーバーレスでモデルのカスタマイズ、評価、デプロイを進める機能が発表され、東京を含む対応リージョンも示されました。ただし、対応モデルや一般提供の状況は変わるため、契約前にAWS公式What’s New(2025年12月3日)で確認します。
3. 設計・開発でのデータ品質とMLOps
設計では、データとシステムを運用するための条件を先に決めます。
- 基盤設計:データの流れ、ネットワーク、権限、保存期間
- 連携・障害対応:API連携、エラー時の処理、モデルの更新方法
- データ品質:顧客IDの名寄せ、退会者や重複レコードの扱い、目的変数の定義、データリークの防止
開発会社には、項目名に加えて、データの意味や型、更新頻度を、データ仕様書に書いてもらいます。欠損時の扱いと利用目的も、同じ仕様書に含めます。
モデル開発は、データ接続を1〜2種類、モデルを1つに絞った小さなPoCから始めます。S3への投入から予測出力まで、前処理や学習、オフライン評価を一通り通して、精度と現場の使い勝手を確かめます。
一方で、最初から全社データを集約したり、多数のモデルを自動で再学習したりすると、原因を切り分けにくくなるうえ、費用も増えやすくなります。
本番では、SageMaker Pipelinesでデータ準備から評価までを再現可能にします。Model Registryには、モデルの版、評価結果、承認状態を記録します。
また、GitやAWS CDK、TerraformなどのIaCを使うと、検証環境と本番環境の差異を抑えられます。さらに、ソースコード、設定値、学習データの版、モデルファイルの保存場所も納品物に明記します。これは、将来のベンダー変更に備えるためです。
4. テストでの連携と運用の検証
テストは、モデルの精度だけでなく、システムの連携と業務での使われ方も対象にします。
- テスト工程:単体、データ連携、モデル評価、性能、セキュリティ、受け入れ
- モデル検証:未使用データでの精度測定と、学習時と本番時の項目・前処理の照合
- 業務受け入れ:画面や帳票での予測の読み取りと、人が確認する条件の試行
システム面では、API停止やデータ再送を想定して試験します。予測の遅延や、モデルのバージョンを戻す復帰も確かめます。失敗時には、前回の予測を使うか、業務を止めて手動に切り替えるかを決めておきます。
推論方式によって、確認する性能条件も変わります。リアルタイム推論では応答時間と同時実行数、バッチでは処理時間と締め切りを見ます。非同期では、キューの滞留と再実行を確認します。
個人情報や機密情報を扱う場合は、テストデータを匿名化し、IAMの権限を最小限に絞ったうえで、ログへの混入や削除依頼への対応も点検します。
合格条件は、画面の表示以外も含めて定めます。KPIや精度、応答時間のほか、権限や費用上限、復旧手順についても、条件を決めておきます。
5. 稼働での段階リリースと監視
本番稼働は、対象部署や顧客群を限定して段階的に進めます。
- 最初の数週間は、予測を表示するだけのシャドーモードで運用します。
- 現場の判断と予測を比べ、役立ち方、誤判定、入力負担を確かめます。
- 確認結果を踏まえて、自動化する範囲を広げます。
稼働時は、CloudWatchでジョブの失敗やAPIエラーを監視します。応答時間、推論件数、リソース使用率も見ていきます。
Model Monitorや評価ジョブでは、データドリフトと品質低下を確認します。また、Model DashboardやModel Cardsでは、目的、評価結果、リスク、承認者を追跡します。
AWS公式文書では、Role Managerで最小権限を持たせる方法、Model Cardsへの記録、Model Dashboardでの性能確認を紹介しています。資料名は「Model governance to manage permissions and track model performance」で、2026年8月に確認しました。
費用の監視では、AWS Budgetsや請求アラートを設定します。加えて、開発、検証、本番のアカウントまたはタグを分けておきます。
未使用のノートブックや学習ジョブ、エンドポイントを残さないルールを定めます。予算超過時の通知先と停止の判断者も決めておきます。
6. 定着での業務手順と改善サイクル
AIシステムを定着させるには、現場の操作手順と判断基準を用意しておく必要があります。
- 利用と行動:営業担当者がスコアの意味を理解したうえで、予測結果をもとに動く
- フィードバック:現場が結果を返せる手順
- 最終判断:高スコアでも必ず連絡するとは限らず、顧客との関係や最新の接触履歴を踏まえて判断する
月次や四半期のレビューでは、KPIの改善状況と誤判定の傾向を確認します。あわせて、データ欠損や入力ルールの変化、精度やドリフトが許容範囲に収まっているかも見ます。
再学習は毎月と固定せず、データ量や性能低下を実施の条件にします。業務イベントや商品・料金の変更も条件に加えます。
現場がExcelや手作業へ戻る場合は、画面の導線や通知件数を見直します。説明の仕方や入力の負担も、見直しの対象になります。
担当者が異動しても運用を続けられるよう、教育や問い合わせ窓口を準備します。障害時の連絡網やモデルの廃止条件も、用意しておきます。
Amazon SageMakerのシステム開発費用と相場
費用は、開発会社に支払う初期開発費と、AWSの利用料、保守・運用費に分けて考えます。
SageMaker AIは、使用量に応じて払う従量課金で、前払いの一律料金ではありません。対象は、ノートブックや前処理、学習、推論に加え、ストレージや監視などです。
開発費だけで比べると、稼働後の請求や再学習の費用を見落とすおそれがあります。そのため、初期費用と1年目の総保有コストを別々に見積もります。
推論方式と稼働時間で変わるAWS利用料
AWS公式料金ページでは、使用量に応じたオンデマンド料金と、利用量のコミットで割引を受けるSavings Plansを案内しています。
- ノートブック:初回リソース作成後2か月、ml.t3.mediumを月250時間。
- 学習:同期間、m4.xlargeまたはm5.xlargeを月50時間。
- リアルタイム推論:対象インスタンスを同期間、月125時間。
無料枠は対象サービスと期間が限られます。さらに、S3やCloudWatchのほか、VPCエンドポイント、KMS、データ転送などの料金も、無料枠には含まれません。以上の内容は、AWS公式「SageMaker Pricing」(2026年8月確認)に基づいて整理したものです。
料金ページの例では、ml.c5.xlargeを1日2.5時間、31日使う非同期推論が15.81米ドルです。ストレージとデータ処理を含めると、16.38米ドルになります。
ml.m4.4xlargeを合計3時間使うBatch Transformの例は、2.88米ドルです。いずれも特定の構成での例で、自社の月額料金を保証するものではありません。常時稼働を避け、バッチやスケール・トゥ・ゼロを検討する際の参考にもなります。
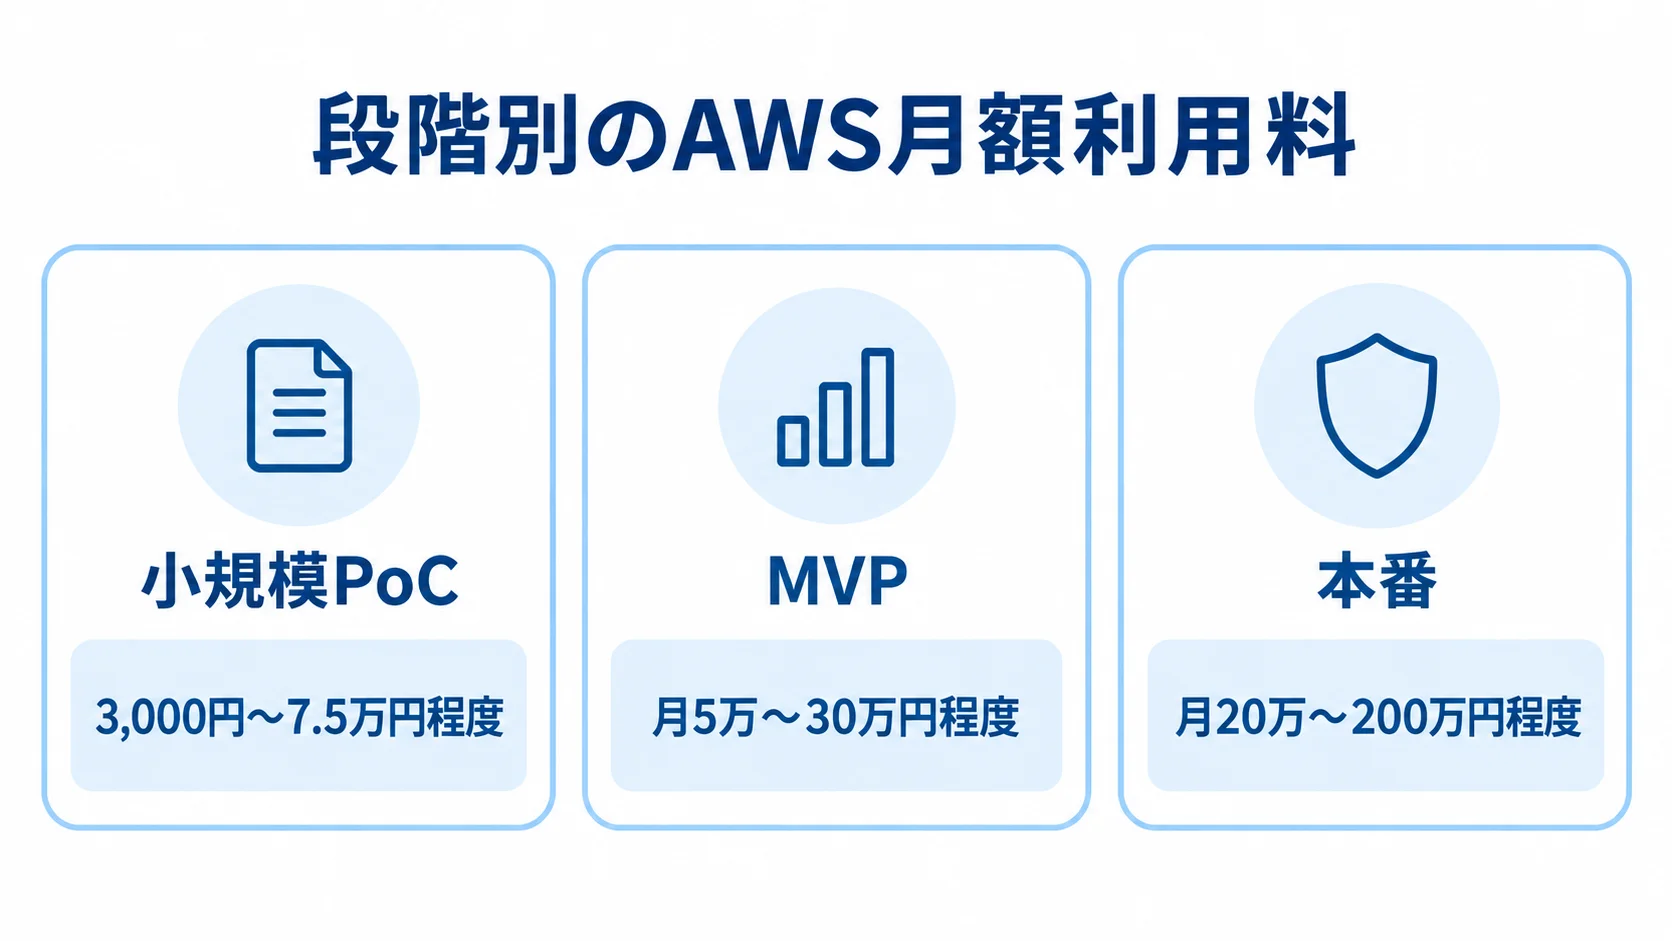
AWSの月額利用料は、PoC・MVP・本番で構成と稼働条件が異なります。そこで、段階ごとの目安を分けて見ていきます。
- 小規模PoC:データ接続1〜2種類、モデル1つ、バッチ中心で3,000円〜7.5万円程度。
- MVP:CRM連携や簡易画面を含み、月5万〜30万円程度。
- 本番:複数モデルや常時稼働エンドポイントを持ち、月20万〜200万円程度。
この金額は、公式の料金例や利用時間、データ量、周辺のAWSサービスを基にした概算です。リージョンやインスタンス、リクエスト数、GPU利用によって変動します。
PoC・MVP・本番別の開発委託費
開発委託費は、PoC・MVP・本番で含める連携や運用の範囲が異なります。このため、段階ごとの推定レンジで比べます。
- 小規模PoC:データ接続1〜2種類とモデル1つの検証で100万〜500万円程度。
- MVP:CRM・MA連携、簡易画面、評価運用を含め500万〜1,500万円程度。
- 本番導入:権限分離、CI/CD、監視、複数データソースを含め1,500万〜5,000万円程度。
対象範囲には、データ整備、要件定義、AWS設計が入ります。モデル開発や業務画面、テストも含まれ、MLOpsや教育も対象です。
複数部門のデータガバナンス、複数モデル、災害対策、24時間監視、全社の内製化教育まで含む場合は、費用が5,000万円〜数億円規模、期間が12〜24か月以上になる可能性があります。
この数字は、SageMaker単体の価格表ではありません。類似する業務システムの一般的な工数を、SageMakerのMLOps部分に当てはめた推定です。一律の相場として断定はできないため、自社の前提条件を添えて見積もりを取ります。
保守費は、初期開発費の10〜20%程度が一般的な目安です。ただし、AWSの従量課金は別途続きます。
再学習、データクレンジング、監視アラート、脆弱性、AWSアカウント、利用部門の問い合わせを保守に含めるかどうかで、金額が変わります。
見積書では、保守費とクラウド利用料を分けてもらいます。そのうえで、学習回数、推論件数、エンドポイントの稼働時間、ログの保存期間も数値で示してもらいます。
Amazon SageMakerのシステムで見積もりを取るポイント
相見積もりの精度は、発注側が渡す情報の具体性で決まります。「SageMakerでAIを作りたい」とだけ伝えると、会社ごとに含める工程や想定するインスタンスが変わるため、金額を比べることが難しくなります。
最低限、対象業務やKPI、データソース、推論方式を、同じ書式で渡します。利用者や希望納期、セキュリティ条件、納品物、運用分担も、あわせて伝えます。
同じ粒度で揃える要件と前提条件
見積依頼書には、データ量とその増加量、更新頻度、利用する過去データの期間を記載します。これらは五つの区分に分けて書くと、会社ごとの見積もりを同じ条件で比べられます。
- データと接続:顧客IDの統一、欠損・重複、個人情報、AWSアカウント、連携API
- 処理量:1日あたりのリクエスト数と推論方式ごとの性能条件
- リアルタイム:許容応答時間とピーク同時実行数
- バッチ・非同期:締め切り、1件あたりの最大データサイズ、滞留許容時間
- モデル要件:対象予測、学習データ、評価指標、再学習頻度、説明可能性、更新承認者
業務要件には、予測を表示する画面や通知先、手動確認、誤判定の訂正方法、問い合わせ窓口を記載します。こうした記載があると、データ整備や業務画面の漏れを防げます。
工程と納品物の分解と比較
見積書は工程ごとに分けてもらい、前提と追加費用を並べて比べます。区分は、開発工程から比較条件まで四つに分かれます。
- 開発工程:要件整理、データ棚卸し、PoC、設計、環境構築、データパイプライン
- 実装・検証:モデル、API・画面、テスト、リリース
- 導入後:教育、保守
- 比較条件:担当者、期間、除外事項、工程の前提、追加費用の条件
「作業一式」という表現で内容を判断しないよう、工程ごとの中身を確かめます。
納品物は、再学習やデプロイを自社で再現できる範囲まで確認します。
- 構成・実装:ソースコード、AWS構成図、IAM・ネットワーク設計書、IaC
- データ・モデル:データ仕様書、前処理コード、モデルファイル、評価レポート、Model Cards
- 運用・復旧:テスト結果、運用手順書、障害時の復旧手順
精度の数字だけを納品物にすると、担当会社が変わったあとに再現できなくなるおそれがあります。
開発会社に求めるSageMaker以外の実務力
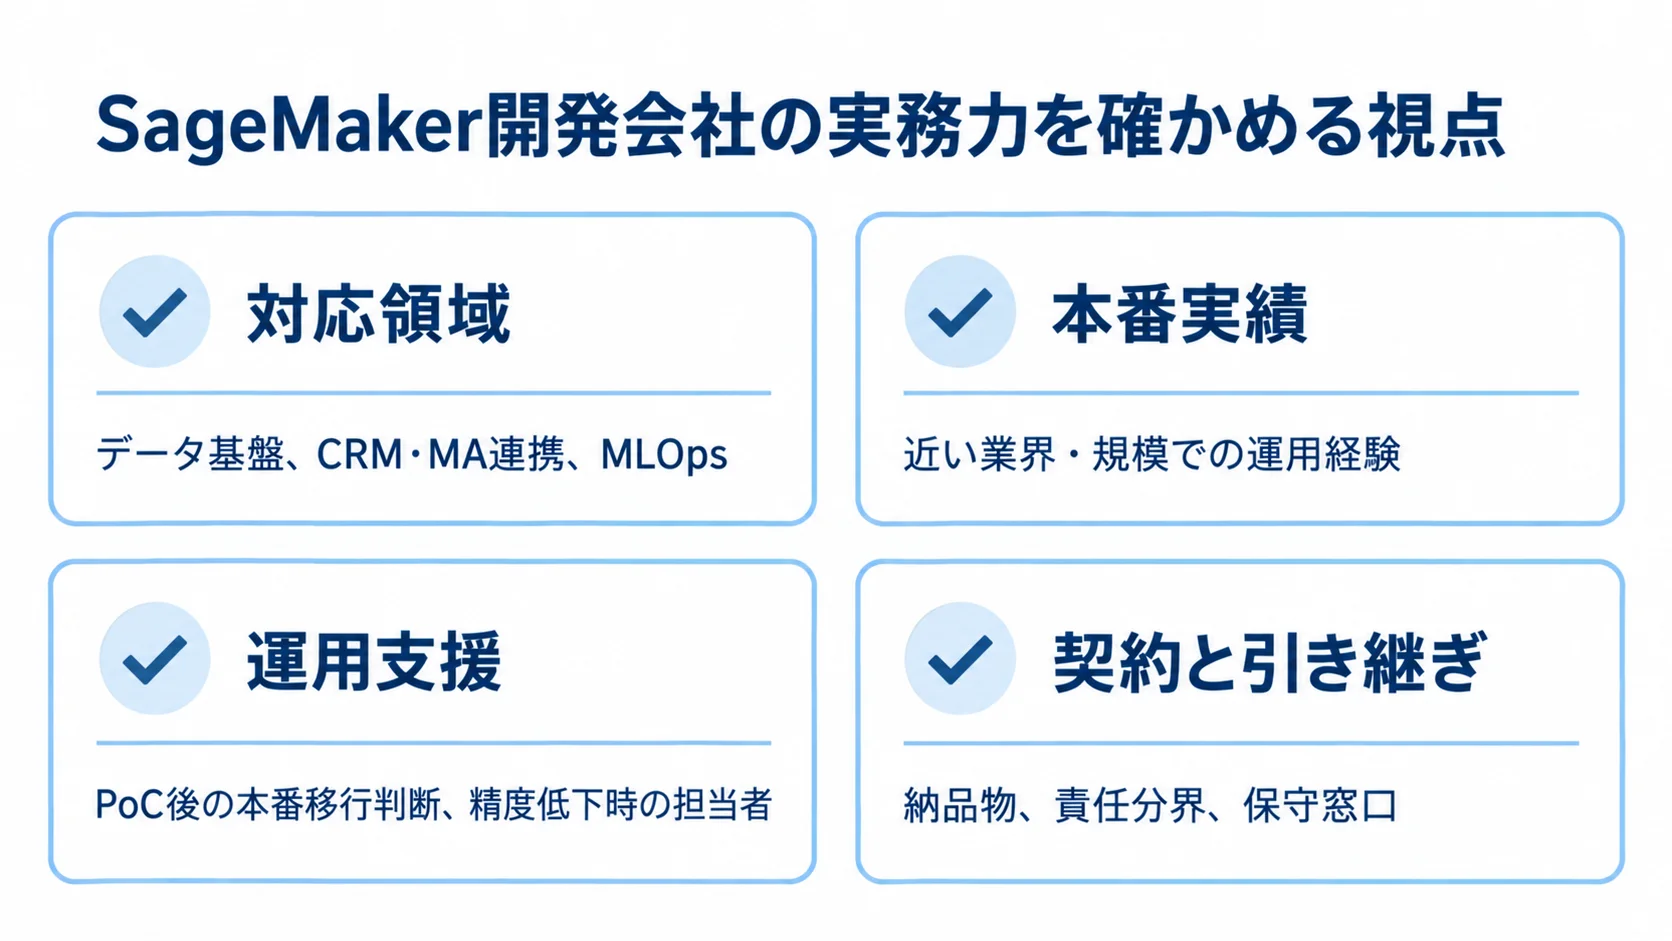
開発会社は、SageMaker以外の実務力も含めて確かめます。確かめる対象は、対応できる領域から契約と引き継ぎまで四つに分けられます。
- 対応領域:データ基盤、CRM・MA連携、MLOps、セキュリティ、業務定着
- 本番実績:自社に近い業界・規模での運用経験
- 運用支援:PoC後の本番移行判断、精度低下時の担当者、AWS請求の可視化
- 契約と引き継ぎ:内製化の教育範囲、担当者経験、納品物、責任分界、保守窓口、終了時の引き継ぎ
AWS公式の紹介には、TCS、Accenture、Cognizant、Infosys、Capgemini、NTT DATAなどが掲載されており、各社はUnified Studioやデータ・AI基盤の活用を説明しています。
掲載情報は候補を探す材料にとどまり、自社と同じ業界・規模での本番実績を保証するものではありません。参照先は、AWS APN Blogの記事「Powering Partner Solutions with Next Generation Amazon SageMaker」で、2024年の公開記事です。
AWS公式の顧客紹介では、NTT DATAが価値提供までの時間を最大40%短縮できると説明しています。また、NatWest Groupは、新しいツールへのアクセス時間を約50%削減できるとしています。
どちらも各社の事例での発言で、自社案件の効果を約束する数字ではありません。出典は、AWS公式「Amazon SageMaker customers」(2026年8月確認)です。
提案を受けるときは、データ品質や業務範囲、導入前後の測定方法を聞き、数字の前提を確かめます。
会社の知名度やAWS認定数のほかに、担当者の経験、納品物、責任分界、保守窓口、契約終了時の引き継ぎを比べて決めます。
セキュリティと責任分界を含めた金額
AWS公式文書では、共有責任モデルが示されています。SageMakerを使うだけで安全が保たれるとは限らないため、利用者側の役割を明確にします。
クラウド自体の保護はAWSが担います。利用者が見るべき領域は、四つの区分に分かれます。
- 利用者側の責任:データ機密性、設定、法令、アクセス権、ログ、アプリケーション
- アクセス・通信:IAM最小権限、MFA、VPC、TLS
- 保護・監査:S3・EBS暗号化、KMS、CloudTrail、CloudWatch
- データ管理:データの保持と削除
これらは見積もりに含めます。確認項目は、AWS公式「Configure security in Amazon SageMaker AI」(2026年8月確認)を基にしています。
個人情報を学習に使う場合は、法務・セキュリティ部門と一緒に、利用目的と同意を確認します。委託先、担当者、ログ保存先、削除要求への対応も、あわせて確かめます。
生成AIや自動判断では、出力の検証と説明、誤りの訂正、人の介入、インシデント対応も必要になります。
経済産業省のAI事業者ガイドライン第1.2版は、2026年3月31日に公表されたものです。リスクベースでAIガバナンスを構築する考え方を示しています。自社の利用形態に当てはめるため、同ガイドライン(2026年)も参照して、契約前に確認項目を整理します。
Amazon SageMakerのシステムに関するよくある質問
Amazon SageMakerのシステム開発を検討する担当者からよく寄せられる質問を、回答とともにまとめました。料金や既存システムとの連携、個人情報、PoCから本番への進め方は、初期相談の段階で確認しておくと、判断を早められます。
Amazon SageMakerとAmazon Bedrockはどちらを選べばよいですか?
独自モデルの学習・評価・デプロイ・監視を繰り返し、MLOpsを管理したい場合はSageMaker AIが候補です。
基盤モデルをAPIで呼び、生成AIアプリケーションを短期間で構築したい場合は、Amazon Bedrockが適することがあります。
モデルの管理範囲、データの置き場所、カスタマイズ方法、ガバナンス要件を比べて決めます。サービス名を先に決めるのは避けるべきです。
社内に機械学習の専門家がいなくても導入できますか?
導入はできますが、業務要件とデータの意味は社内で決めます。AWS設計やモデル開発は、外部と分担する進め方が現実的です。
外部へ丸投げすると、現場の判断基準や運用開始後の責任者が不明確になるおそれがあります。そのため、業務責任者、データ管理者、セキュリティ担当者を、早い段階から参加させます。
小規模なPoCで、作ったものと運用方法を確かめ、必要に応じて内製化の範囲を広げます。
Amazon SageMakerのシステム開発にはいくらかかりますか?
小規模PoCの開発委託費は100万〜500万円程度です。CRM連携を含むMVPは500万〜1,500万円程度、本番導入は1,500万〜5,000万円程度が推定レンジです。
AWS利用料は別の従量課金です。推論方式やインスタンス、稼働時間、データ量のほか、監視や周辺サービスでも変わります。
全国一律の価格ではありません。データソース、モデル数、リクエスト数、納品範囲を揃えたうえで、複数社に見積もりを依頼します。
顧客情報や個人情報をAmazon SageMakerで扱えますか?
扱うことはできますが、利用者側のセキュリティ設定と法務上の整理が必要です。IAMの最小権限、MFA、VPCは要件に含めます。
通信と保存の暗号化、KMS、CloudTrail、ログのマスキングのほか、データの保持と削除、委託先の管理も定めます。さらに、学習の目的が適切かどうかも確認します。
AWSの責任共有モデルに沿って、AWSと自社・開発会社の責任範囲を設計書と契約書に記載します。
まとめ:6フェーズで業務に定着するAmazon SageMakerの構築
Amazon SageMakerのシステム開発では、モデルを作ることに加えて、業務で使い続けられる仕組みまで作り込みます。
要件整理で業務KPIと利用場面を決め、選定で推論方式とサービスの組み合わせを判断します。そのうえで、設計・開発ではデータ品質とMLOpsを組み込みます。
テストで連携、精度、セキュリティを確かめたうえで、段階的に稼働させます。教育と改善サイクルを回して、業務への定着を図ります。
着手前に押さえる三つの判断基準
着手時には、業務、費用、運用の三つの面で判断基準を決め、それぞれを業務要件、費用、運用設計に反映しておきます。
- 業務:モデルの精度だけでなく、予測を使う担当者と業務アクション
- 費用:AWS利用料、開発費、保守費を分け、PoC・MVP・本番ごとのレンジで判断
- 運用:IAM、VPC、暗号化、監査ログ、モデルの評価・承認・監視に加えて、誤判定への対応、再学習、契約終了時の引き継ぎ
最初の相談で共有する業務課題とデータの現状
開発会社に相談する前に、業務とデータの前提を整理しておきます。項目は四つあり、KPIや利用者から、希望納期と社内で対応できる範囲までを含みます。
- 改善したいKPI、対象業務、利用者
- データソース、データ量、更新頻度、個人情報の有無
- 希望する推論方式と許容応答時間
- 希望納期と社内で対応できる範囲
SageMakerを使うこと自体を目的にせず、必要な構成と不要な機能を分けることが、費用と期間の適正化につながります。
料金や機能、対応リージョン、ガイドラインの版は更新されることがあります。そのため、公開前と契約前に公式情報を確認し直します。
▼全体ガイドの記事
・Amazon SageMakerのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。