
Amazon SageMakerのシステムは、データの準備からモデルの運用、業務への連携までを整える基盤です。営業やCRMでは、リードスコアリング、解約予測、商談確度予測を業務に活用できます。
予測結果を業務で使うには、構成、開発手順、費用、開発会社の選び方を順に押さえる必要があります。
▼関連記事一覧
・Amazon SageMakerのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Amazon SageMakerのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Amazon SageMakerのシステム開発の見積相場や費用/コスト/値段について
・Amazon SageMakerのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Amazon SageMakerのシステムの全体像
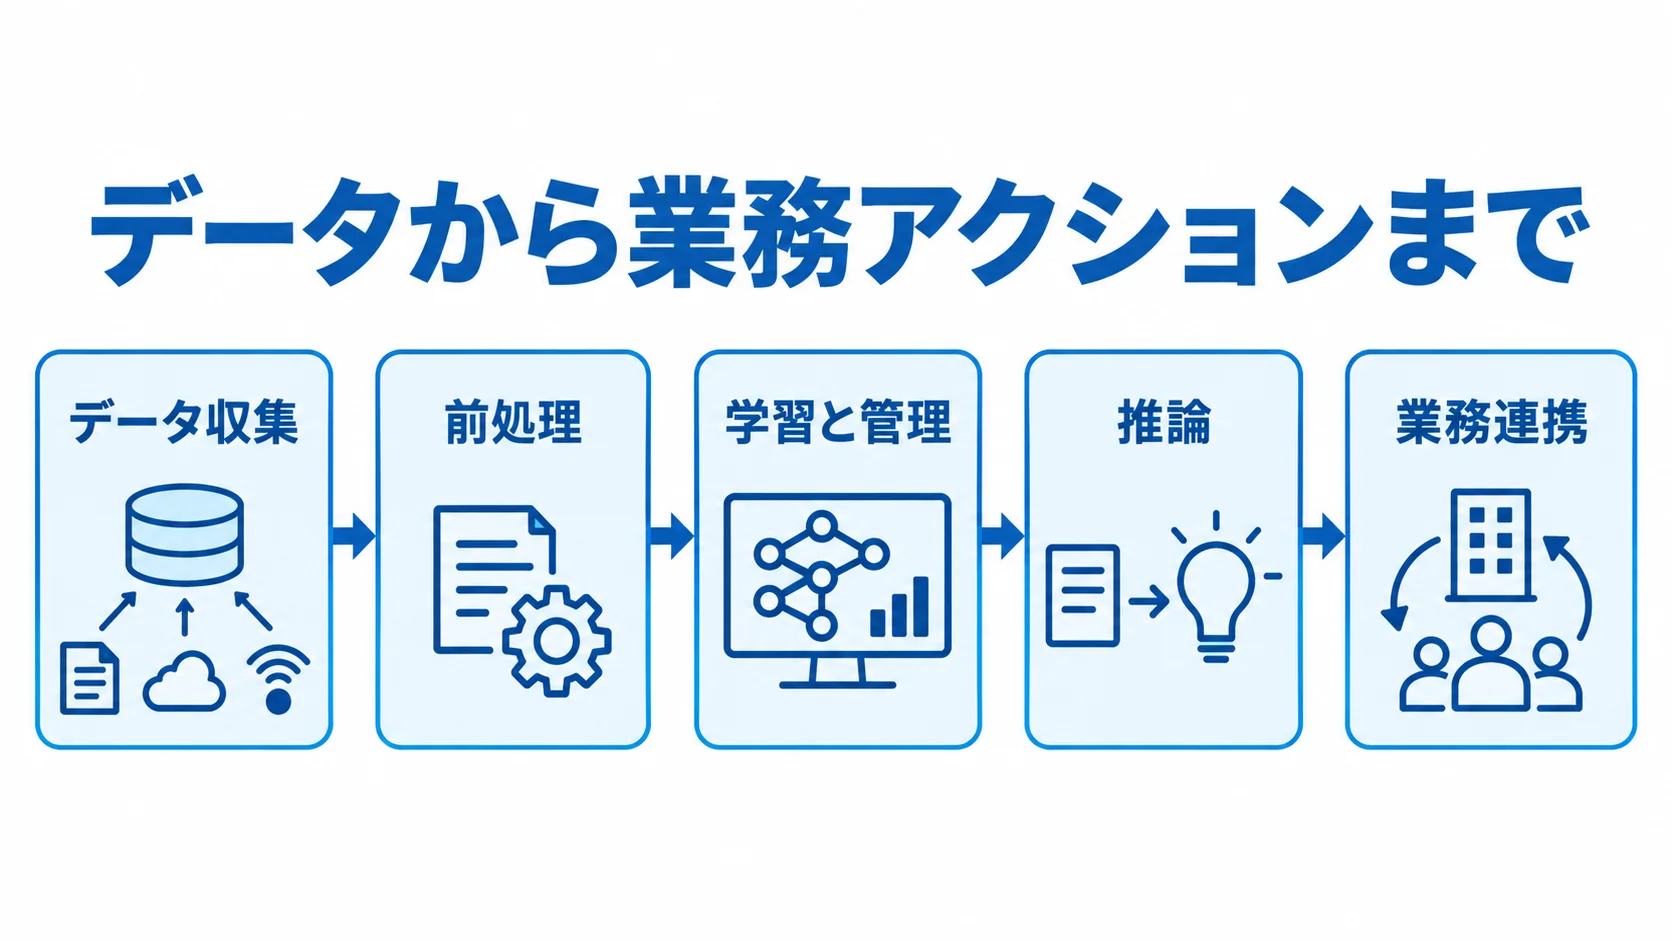
Amazon SageMakerは、機械学習モデルの準備、構築、学習、デプロイを支援するマネージドサービス群です。
導入の検討では、データ基盤や業務システムとの接続も含めた一連の流れとして捉えることが大切です。
データから業務アクションまでをつなぐ基盤
標準構成の各工程を順に追うと、データが業務へ届くまでの流れがつかめます。
- データ収集:営業・CRM・MAの顧客情報や商談履歴、Web行動、問い合わせ履歴を集め、Amazon S3に蓄積します。
- 前処理:Glue、Athena、Data Wranglerで欠損値や重複を整え、SageMaker Processingで加工します。
- 学習と管理:Trainingで学習し、評価に合格したモデルをModel Registryで管理する工程。
- 推論:API経由のリアルタイム予測や、夜間のバッチ予測に展開します。
- 業務連携:API GatewayやLambda経由で営業画面へ返し、データウェアハウス経由でBIやMAの抽出にも使います。
予測を見た担当者が次に何をするかまで設計して、初めて業務システムとしての価値が生まれます。
モデルの作成は、その一部にすぎません。
単体の機械学習ではなく運用まで含めて考える視点
ノートブックで精度が高くても、本番データとの形式差や過剰な権限があると、継続利用は難しくなります。画面連携が欠けている場合や、精度低下を検知できない場合も同様に、継続は難しくなります。再現性の確保、MLOpsの活用、検証と本番の対応を、段階ごとに整えておく必要があります。
- 再現性:データ、コード、モデルの版を記録し、承認者とリリース手順も残して、同条件で再実行できる状態にします。
- MLOps:SageMaker Pipelines、Experiments、Model Registryなどを使います。
- 検証時:小規模な検証では、一部の作業を手動にする方法もあります。
- 本番時:モデルの承認条件と、問題発生時に戻すモデルを決めておきます。
監視には、Model MonitorやCloudWatchも組み合わせます。これにより、学習からリリース、監視、再学習までを標準化できます。
Amazon SageMakerのシステムの種類と代表的な用途
予測のタイミング、モデルの種類、データの機密性、応答速度によって構成は変わります。
選択肢を理解しておくと、過剰な構成や本番に必要な機能の不足を避けやすくなります。
定期的なスコアリングに向くバッチ推論型
バッチ推論を選ぶ場合は、利用場面だけでなく費用や処理後の運用も確認しておく必要があります。確認の中心は、利用場面、費用、処理管理、通知管理の四つです。
- 利用場面:毎日・毎週の予測や、夜間に全顧客の解約確率を計算して翌朝に優先対象を渡す用途に向きます。
- 費用:Batch Transformや定期ジョブなら常時稼働のエンドポイントが要らず、低アクセスの業務で費用を抑えられます。
- 処理管理:データ抽出の遅延や処理時間を考慮し、古い結果の更新依頼者と、失敗時に前回結果を使うかを決めます。
- 通知管理:同じ顧客へ重複して通知しない方法を定めます。
画面操作と同時に判定するリアルタイム推論型
リアルタイム推論では、即時性、業務画面との連携、運用コストを合わせて検討します。
- 利用場面:Webフォーム入力、問い合わせ受付、商談登録などで数秒以内に予測を返します。
- 業務連携:APIで入力を受け、スコアや分類結果を画面へ返して、担当者の操作に応じた次の行動を示します。
- 費用と応答:常時稼働中は低アクセス時も計算資源の料金が発生するため、応答速度とコストを調整します。
- 障害・更新対応:アクセス量に応じたオートスケーリングを設け、タイムアウトやリトライ、モデル更新時の切り戻しを設計します。
生成AI・モデルカスタマイズ型の選択肢
基盤モデルをAPIで使うか、独自データで調整するかによって、候補となるサービスが変わります。用途、API利用、独自調整、機能確認、提供状況の五つで比べます。
- 用途:文章分類や問い合わせ振り分けのほか、社内文書の要約や営業支援にも基盤モデルを使えます。
- API利用:基盤モデルをAPI中心で使う場合、Amazon Bedrockが適することがあります。
- 独自調整:独自データでの調整や学習・評価・デプロイ管理には、SageMaker AIが候補です。
- 機能確認:2025年12月にサーバーレス機能、2026年6月にマルチターン強化学習が発表されました。
- 提供状況:対応モデルやリージョンは変わるため、公式ドキュメントで一般提供状況を確かめ、必須機能として固定しない扱いにします。
サーバーレス機能では、モデルのカスタマイズ、評価、デプロイを進められます。一方、マルチターン強化学習は、複数段階のエージェント作業を対象とします。
Amazon SageMakerのシステム開発の進め方
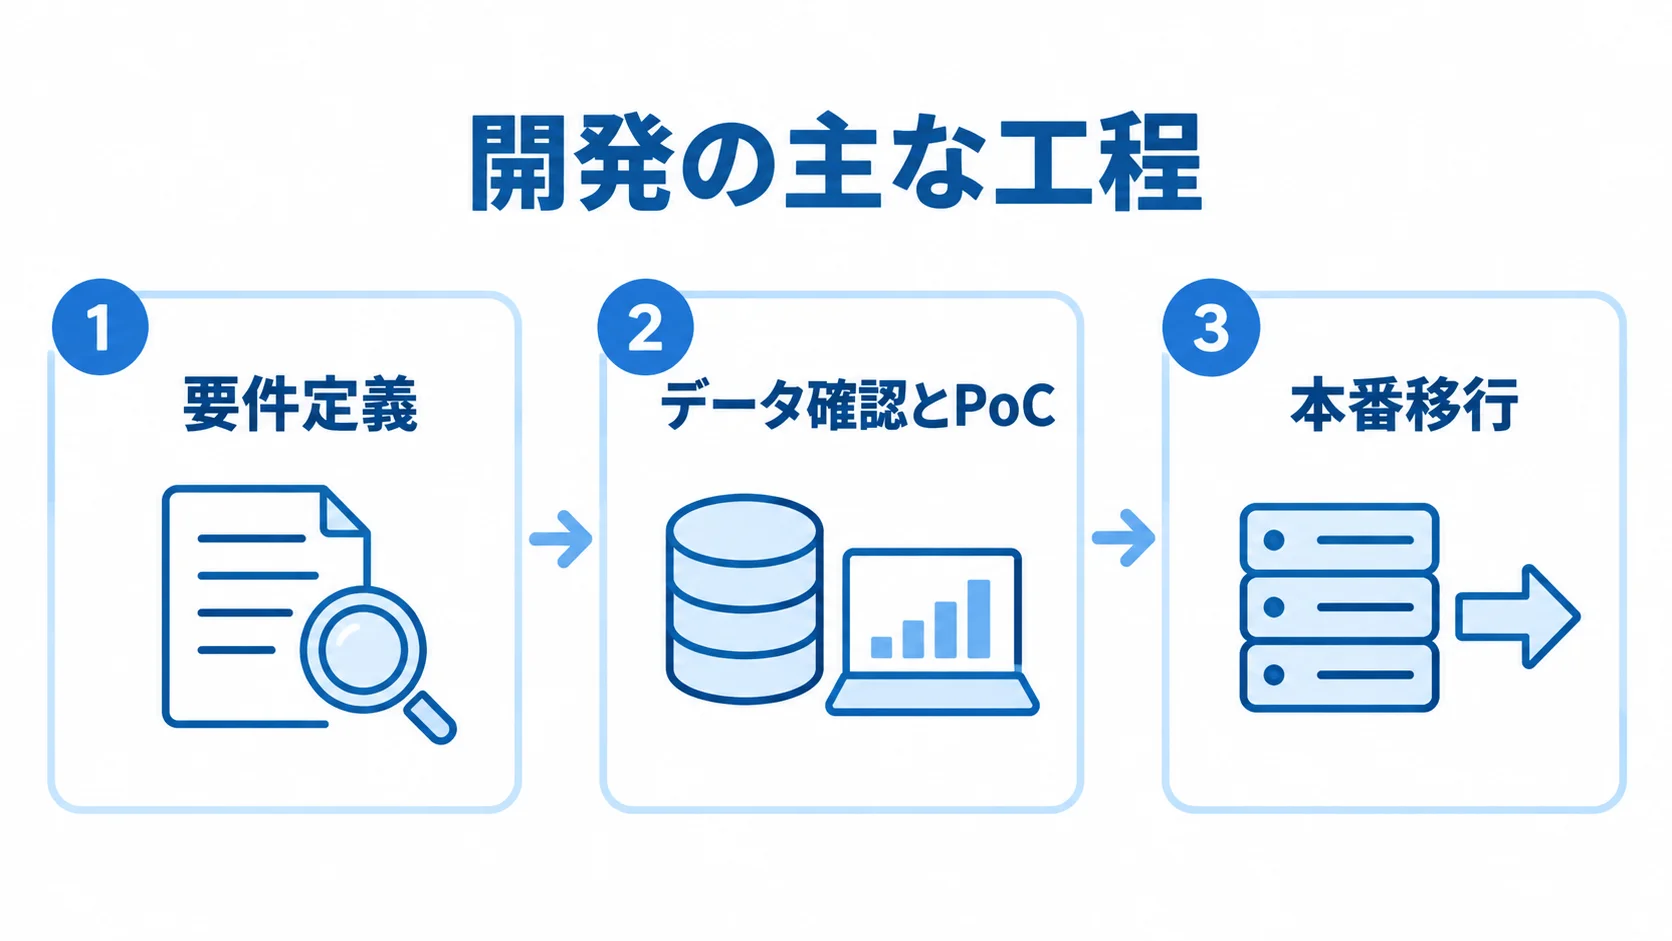
開発では、業務課題とデータを先に固め、評価方法や運用体制を順番に決めていきます。
「精度の高いモデルを作る」ことより先に、業務で何を変えるかを定義します。
▶ 詳細はこちら:Amazon SageMakerのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
開発の主な工程は、業務要件の定義、データ確認とPoC、本番環境と運用の設計です。
- 要件定義:業務KPI、利用者、許容する誤判定を決めます。
- データ確認とPoC:データを棚卸しし、小さく実現可能性を確かめます。
- 本番移行:MLOps、監視、責任分界を設計します。
各工程で確認しておく内容を、順に説明します。
要件定義での業務KPIと許容できる誤判定
要件定義では、利用目的、予測を使う現場、評価指標を具体化しておきます。
- 利用目的:「商談化率を上げる」「解約の兆候を30日前に把握する」「問い合わせを担当部署へ分類する」などを定めます。
- 業務設計:誰が予測を使い、どの画面で見て、どう動くかを決めます。対象外の顧客や、誤判定時の最終判断者も含みます。
- 評価指標:AUCや正解率に加えて、営業がフォローする上位件数を評価します。見逃しの許容範囲や、判定1件を確認する時間も含めます。
業務指標を加えると、モデル精度と現場の使いやすさを同じ基準で評価できます。
データ棚卸しと小さなPoCによる実現可能性の確認
PoCの前に、データの状態を確かめて、検証する範囲を定めておきます。
- データ確認:取得元、顧客ID、更新頻度を確かめます。欠損・重複、ラベル、個人情報、保持期間も確認します。
- データ整備:部署ごとにCRMの入力ルールが違うと、データの意味が揃わなくなります。AIは不備を自動では解決しないため、名寄せやマスタ整備の工数も見込みます。
- PoCの範囲:接続は1〜2種類、モデルは1つに絞ります。S3への投入から学習、オフライン評価、予測出力まで実行します。
- 短期検証:最初から本番画面や複雑な自動再学習を作り込む必要はありません。
- 本番への備え:データ形式と評価記録を早い段階で整理し、コードとモデルの保存場所も決めておきます。
本番移行でのMLOpsと責任分界の設計
本番移行では、承認と監視、復旧、運用の分担を整理しておく必要があります。
- 承認・配備:SageMaker Pipelinesでデータ準備、学習、評価をつなぎ、合格モデルをModel Registryで承認してデプロイします。
- 監視・復旧:Model MonitorやCloudWatchで性能とデータドリフトを確かめ、異常時の通知・停止・前モデルへの切り戻しを用意します。
- 環境管理:ソースコードとインフラをGitやIaCで管理し、検証環境と本番環境の差を抑えます。
- 運用責任:再学習の頻度と承認者、アラートの一次対応者を決めます。また、誤判定の窓口、モデル廃止の条件、AWS利用料の上限も定めます。
- 納品物:委託時は、モデルのほかに、ソースコードやIaC、設計書を含めます。データ仕様、評価レポート、運用手順書も対象です。
Amazon SageMakerのシステム開発費用とAWS利用料の相場
費用は、初期開発費、クラウド従量課金、運用・保守費に分けて考えます。
SageMakerは計算資源や処理時間に応じて課金されるため、モデル数だけでは月額を判断できません。
ここに示す概算は、データ量と推論方式、利用時間、セキュリティ要件を仮定したものです。
▶ 詳細はこちら:Amazon SageMakerのシステム開発の見積相場や費用/コスト/値段について
処理方式と稼働時間で変わるAWS利用料
2026年8月時点では基本的に従量課金で、オンデマンド料金とSavings Plansがあります。料金の対象は、開発・学習、推論、関連機能、周辺費用に分かれます。
- 開発・学習:ノートブックや開発環境、Data Wranglerのほか、Processingや学習も課金対象です。
- 推論:リアルタイムや非同期のほか、Batch TransformとServerless Inferenceも課金対象です。
- 関連機能:Feature StoreやMLflowにも料金がかかります。
- 周辺費用:S3やEBS、CloudWatch、CloudTrailの料金のほか、VPCエンドポイントやKMS、データ転送料がかかる場合があります。
- 課金方式:リアルタイムは常時稼働、バッチは実行時間、サーバーレスは処理時間とデータ量が中心です。
見積もりでは、SageMakerの本体の料金だけでなく、周辺の料金も含めて見ておく必要があります。
初めてリソースを作成した月から2か月間は、無料枠の対象になります。ml.t3.mediumのStudioノートブックなどは月250時間です。さらに、学習用インスタンスは月50時間、リアルタイム推論用は月125時間などです(出典: AWS SageMaker AI Pricing、2026年8月確認)。
無料枠は変更されるため、契約前に公式料金ページを確認してください。業務の呼び出し頻度に合わせて、推論方式を選びます。
PoCで100万〜500万円程度から始まる開発委託費の目安
委託費は、開発段階と実装範囲によって変わります。小規模PoCから本番導入までは、段階が進むほど金額と期間が大きくなります。
- 小規模PoC:100万〜500万円程度、1〜3か月が目安です。
- MVP:500万〜1,500万円程度、3〜6か月が目安です。
- 本番導入:1,500万〜5,000万円程度、6〜12か月が目安です。
- 大規模基盤:複数部門向けのMLOpsや複数モデル、災害対策、24時間運用を含むと、5,000万円から数億円規模になる場合があります。
小規模PoCは、データ接続1〜2種類、モデル1つ、バッチ推論中心の想定です。
MVPでは、CRM連携と簡易画面を加え、モデル評価と手動再学習も含めます。
金額はSageMakerのほか、データ加工やAPI、画面、テストまで含めた概算です。本番導入には、複数データソースや権限分離、CI/CDが含まれます。さらに、Model Registry、監視、可用性設計も含みます。
相場は案件の複雑さで変わるため、前提条件をそろえて比較します。
TCOと利用条件に基づく見積もりの明細
見積もりでは、利用条件に加えて、運用を含む費用管理の項目も確認します。
- 学習条件:学習回数、時間、インスタンスタイプを確認します。
- 推論条件:エンドポイント稼働時間、1日リクエスト数、入出力サイズを確認します。
- データ条件:ログ保存期間、データ量、転送量を確認します。
- 費用管理:未使用リソースの停止やタグ付けを設計し、予算アラート、自動制御、S3ライフサイクルも決めます。
- 総保有コスト:データ整備や再学習、精度監視を含めます。障害・脆弱性対応、アカウント運用、保守窓口も見込みます。
年間保守費は初期開発費の10〜20%程度とされることがあります。
AWS従量課金は、別に続きます。
契約前に、月額の上限目安と上振れ時の通知方法を決めておくと、予算を管理しやすくなります。
SageMakerと他の選択肢の比較方法
まず考えたいのは業務課題で、Amazon SageMakerを選ぶこと自体は目的ではありません。SageMakerは、その課題を解決する手段です。たとえば、CRMやMAに十分な標準AI機能があれば、短期間で定着することがあります。
独自データでモデルを細かく制御したい場合は、SageMakerが向いています。さらに、複数モデルの継続運用や既存データ基盤との統合にも適します。また、MLOpsや権限管理を自社の要件に合わせたい場合も候補になります。
SageMakerとBedrockの目的別の使い分け
生成AIの導入方法や独自モデルの運用目的によって、適するサービスが異なります。
- Bedrock:生成AIをAPIとしてすばやく組み込みたい場合に候補です。
- SageMaker:独自データで調整し、学習から監視までを一貫して管理する場合に候補です。
- 併用:Bedrockのモデルを評価しながら、SageMakerで独自モデルを管理する構成も考えられます。
選定では、モデルの知名度より、データ管理場所や追加学習の要否、許容する推論遅延を確認します。
監査や説明の必要性、運用担当者の人数も判断材料です。また、定型スコアだけであれば、従来型の機械学習とバッチ推論の方が説明しやすい場合もあります。
マネージドサービスとスクラッチ開発の比較
マネージド機能と自前構築では、自由度や運用負担に違いがあります。
- マネージドサービス:サーバー構築やパッチ対応の負担を抑え、標準の学習・推論・監視機能を使えます。
- 独自実装:特殊なアルゴリズムや既存システムの制約があると、独自コンテナや追加のデータ処理基盤が必要な場合があります。
- 自前構築:EC2などでは自由度が高まる一方、OSやライブラリ、GPUを自分たちで扱い、拡張、監視、障害対応も担います。
- 比較条件:自由度と社内の運用人材を見ます。将来のモデル数やセキュリティ基準も含めて、総合して選びます。
要件定義の段階で、標準機能で足りる範囲と、独自実装が必要な範囲を切り分けます。
Amazon SageMakerのシステムに必要なセキュリティとガバナンス
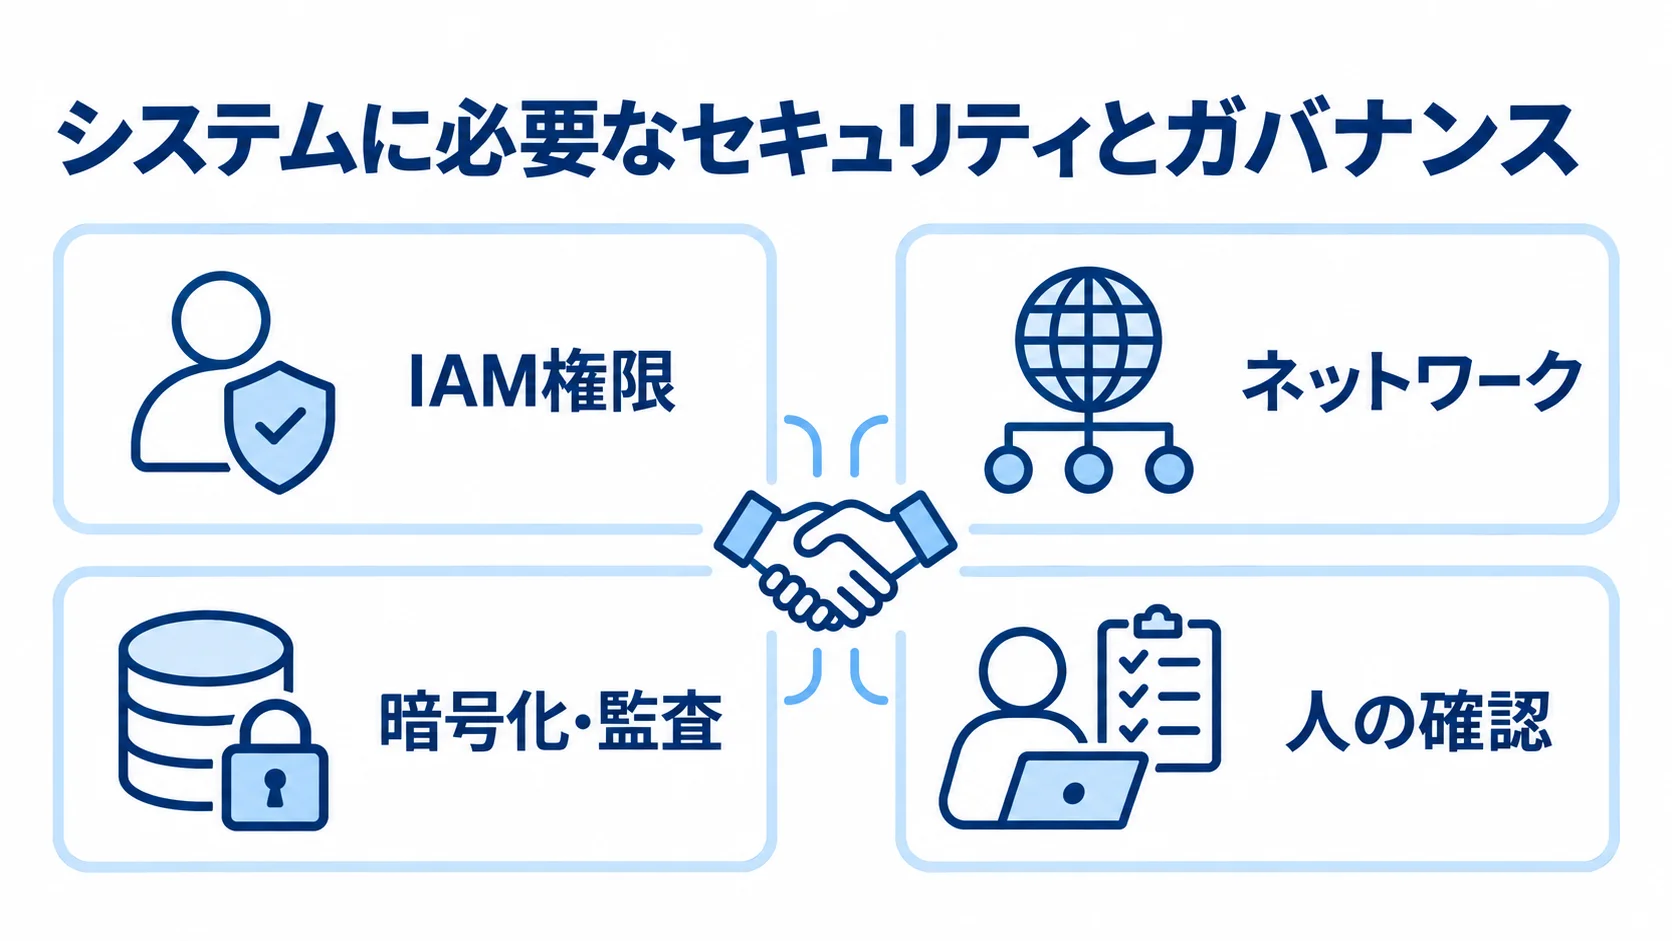
顧客情報や商談情報を扱う場合は、「クラウドだから安全」と言い切らず、役割を分けて考える必要があります。公式ドキュメントも、責任共有モデルで安全性を説明しています。
クラウド自体の安全性と、利用者が設定するセキュリティは分けて考えます。そのうえで、機密性、社内規程、適用法令を踏まえて要件を決めます。
IAM・VPC・暗号化によるアクセス境界の設計
アクセス管理では、権限、接続経路、暗号化、監査を組み合わせます。
- IAM権限:必要な権限だけを付与し、開発者の本番データ取得や学習ジョブの過剰権限を防ぎます。
- 接続先管理:各処理が接続するS3やDBを一覧化し、権限変更の承認者を決めます。
- ネットワーク:必要に応じてVPCやVPCエンドポイントを使い、データや推論APIへの経路を制限します。
- 暗号化・監査:S3、EBS、通信中のデータを暗号化し、KMSで鍵を管理します。CloudTrailに操作履歴を残します。
- 監視:CloudWatchでジョブやエンドポイントのエラー、利用量を追います。事故調査やコスト異常の発見にも役立ちます。
対象は、StudioやProcessing、Trainingに加えて、EndpointとBatch Transformです。
個人情報とAIガバナンスの運用ルール
個人データやAI出力を扱う際は、利用条件と確認手順を運用ルールとして定めます。
- データ利用:利用目的と同意範囲、第三者提供や委託、保管期間を確認します。削除要求への対応も確かめます。
- 識別リスク:匿名化・仮名化後も他データとの照合で識別される可能性を考慮し、関係担当者と判断します。
- 人の確認:AI出力を顧客対応や契約判断に直結させず、説明困難時の扱いや誤判定の訂正方法を決めます。
- 履歴管理:ログとモデル更新履歴を保存し、ガイドラインを参照して役割に応じた確認項目を定めます。
経済産業省などが2026年3月31日に公表したAI事業者ガイドライン第1.2版も参照します(出典: 経済産業省「AI事業者ガイドライン(第1.2版)」、2026年)。
Amazon SageMakerの開発会社・ベンダーの選び方
会社やベンダーを選ぶ際は、SageMakerの設定ができるかだけでなく、データ基盤や業務システムまで扱えるかを確かめます。MLOpsやセキュリティ、運用も対象です。
会社規模や認定数よりも、自社の課題と必要なフェーズに合うかを比べることが大切です。
構築範囲と本番移行の経験
委託先の提案範囲と、本番稼働を支える経験や体制を確認します。
- 構築範囲:データ抽出や名寄せ、前処理から、モデル評価、API、画面まで確認します。CI/CDや監視、権限設計も含みます。
- 本番経験:PoCの実績に加えて、本番移行案件の可用性や障害対応、品質基準、運用手順を聞きます。
- 業務理解:営業やCRMの入力ルールと既存システム制約を理解する体制か確認します。
- 担当体制:機械学習やデータの担当者に加えて、業務やクラウド、セキュリティの担当者も確かめます。打ち合わせ参加者も、見積もり前に確認します。
納品物・保守・内製化支援の契約前の確認
契約前に、納品物、保守対象、引き継ぎ支援の範囲を具体化しておきます。
- 技術資料:ソースコードやインフラ定義、学習データ仕様を明記します。モデル評価報告書、API仕様書、テスト結果も含めます。
- 運用資料:手順書、監視項目、障害連絡方法を含めます。これがあると、データ更新や再学習を続けやすくなります。
- 所有・終了条件:アカウントやリポジトリの所有者、契約終了後のデータ返却・削除方法を確認します。
- 保守範囲:精度劣化や連携エラー、エンドポイント障害を含め、料金異常や脆弱性、機能追加の扱いも決めます。
- 内製化支援:ML人材を増やす場合に、ペア開発やレビュー、研修を提案できるかを確認します。段階的な引き継ぎも対象です。
相見積もりで渡す同じ前提条件
比較時にそろえる条件は、データ量やデータソース、モデル数です。推論方式や1日リクエスト数、許容応答時間も同じ条件にします。
- 運用条件:SLA、希望納期、社内で担える作業
- 環境条件:個人情報の有無、既存AWSアカウント
条件がそろわないまま金額を並べると、安く見えた提案に、必要な監視やデータ整備が含まれていない可能性があります。
見積もりは、初期費用とAWS利用料、保守費に分けて比べます。追加開発費や社内作業も別に並べ、PoC成功、本番移行、中止の判定条件も確認します。
不確実な点を質問し、できないことや追加費用の条件を明示する提案者かどうかも判断材料です。
▶ 詳細はこちら:Amazon SageMakerのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Amazon SageMakerのシステム開発の発注/外注/依頼/委託方法について
Amazon SageMakerのシステムに関するよくある質問
記事の最後に、Amazon SageMakerの導入検討で多い疑問へ回答します。料金や機能は更新されるため、選定時の考え方を中心に説明します。
小規模な会社でもAmazon SageMakerを導入できますか?
導入できます。データソースとモデルを1つずつにし、バッチ推論中心のPoCから始めると、費用と運用負担を抑えやすくなります。
専門人材が少ない場合は、データ整備と業務要件を社内で定め、クラウド設計やモデル運用を外部に分担する方法もあります。
高い予測精度が出れば導入は成功ですか?
導入の成否は、担当者が予測を確認して適切な対応につなげ、業務KPIが改善したかで決まります。予測の精度は、その前提にすぎません。
精度低下を検知し、再学習と承認を行う運用が必要です。さらに、誤判定を人が訂正する仕組みも用意します。
個人情報を扱うシステムでも利用できますか?
利用はできます。ただし、利用目的、権限、暗号化、ネットワークの要件を整理する必要があります。監査ログや保持・削除、委託先管理も含めます。
個人情報を学習に使う適切性と、誰がどの目的で出力を見るかを、法務・セキュリティ担当者と確認します。
利用者側の責任は残ります。そのため、責任共有モデルに沿った運用設計が必要です。
AWS利用料が予想以上に増えないようにするにはどうしますか?
開発環境、学習ジョブ、エンドポイントにタグを付け、予算アラートを設定して請求の内訳がわかるようにします。
使わないノートブックや常時稼働のエンドポイントを停止します。アクセスの少ない処理では、バッチやサーバーレスも検討します。
見積もりの段階で、1日あたりのリクエスト数や学習回数、稼働時間、ログ保存期間を決めておきます。上限を超えた場合の通知と停止の方針も用意します。
まとめ:Amazon SageMakerのシステムは業務・データ・運用の一体設計
Amazon SageMakerのシステムは、モデルの学習環境がその一部です。データの収集と整備、モデルの安全なリリース、業務への予測結果の連携までを含みます。
また、精度と費用を監視し、再学習する工程まで含む機械学習の業務基盤です。
導入前に押さえる三つのポイント
第一に、誰のどの業務をどう改善するかを先に決め、そのうえでSageMakerの使い方を考えます。
第二に、AWS利用料と開発委託費を分けて考えます。PoC、MVP、本番の段階ごとに、TCO(総保有コスト)を見積もります。
第三に、IAMやVPC、暗号化、監査を本番要件に含めます。加えて、データ削除とモデル監視、再学習、責任分界も本番要件に入れます。
最初の相談で伝える業務課題とデータの現状
相談前に業務課題とデータ環境を整理すると、構成検討に必要な情報を共有できます。
- 業務・データ:改善したいKPIと対象業務を整理します。データソースやデータ量、更新頻度もあわせてまとめます。
- 利用条件:個人情報の有無と推論方式、許容応答時間、社内で担える作業を整理します。
条件を整理しておくと、必要な構成と不要な機能を分けて考えやすくなります。料金や機能、対応リージョン、ガイドラインの版は更新されるため、公開前と契約前に最新の公式情報を確認してください。
▼関連記事一覧
・Amazon SageMakerのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Amazon SageMakerのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Amazon SageMakerのシステム開発の見積相場や費用/コスト/値段について
・Amazon SageMakerのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。