
Apache Kafkaのシステム開発は、イベント量、連携先、保持と復旧の要件によって、構成も開発規模も変わります。そのため、費用や工程を比べる前に、全体像を要素ごとに分けて検討することが大切です。
導入の判断から、構成設計、開発工程、費用、運用、発注先の選び方まで、順に見ていきます。
▼関連記事一覧
・Apache Kafkaのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Apache Kafkaのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Apache Kafkaのシステム開発の見積相場や費用/コスト/値段について
・Apache Kafkaのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Apache Kafkaのシステムの全体像と種類
Apache Kafkaは、業務で起きたイベントをリアルタイムに収集・保存・配信する仕組みです。単なる中継機能とは違い、イベントはTopicに追記され、設定した期間だけ保持されます。
Producer・Consumer・Topic・Partitionの基本構成
Kafkaでは、複数の利用者がそれぞれの進み具合でイベントを読み直せます。注文、決済、在庫変動のイベントを、発生元と利用先を疎結合にして連携できます。さらに、IoTセンサーやアクセスログ、顧客行動も扱えます。
- Producer:イベントを書き込むアプリケーション。
- Consumer:イベントを読み取るアプリケーション。
- Topic・Partition:イベントの入れ物と、並列処理の分割単位。
- Broker・Consumer Group:Kafkaのサーバー群と、処理を分担するConsumerのまとまり。
たとえば、注文システムが注文イベントを書き込み、在庫、通知、分析の各Consumer Groupが同じイベントを別々に読み取る構成が考えられます。
順序は原則としてPartition内で保たれ、Topic全体では保証されません。そこで、同じ顧客IDや注文IDをキーにすると、同じキーのイベントが同一Partitionに送られ、順序を保てます。
Partitionを増やしすぎると、管理対象と再分配の負荷が増えます。そのため、Partition数はイベント量と順序要件を踏まえて決めます。
再処理・連携・ストリーム処理の機能
Offsetは、Consumerが読み取った位置を示します。必要に応じて、過去のイベントを再処理できます。さらに、ログコンパクションを使えば、同じキーの最新値を残して状態の復元に利用できます。
- Kafka Connect:データベース、SaaS、データレイクとの接続を担う機能。
- Kafka Streams:集計、結合、時間窓処理を行う機能。
2025年3月公開のApache Kafka 4.0は、ZooKeeperを別途運用しないKRaftモードを前提とした節目のバージョンです(出典:Apache Kafka公式リリース発表、2025年)。
そのため、新規開発では、発注側と開発会社がKafkaのバージョン、対応クライアント、KRaftの運用方法を最初に確かめておく必要があります。マネージド環境では、利用者が変えられる設定の範囲も見ておきます。
自前運用・マネージド・Kafka互換の3種類
導入形態は大きく次の3種類に分かれ、運用をどこまで自社で担うかと、機能の差が形態ごとに違います。
- 自前運用:OSSを仮想マシンやKubernetesで動かし、自由度と移植性を確保する形。
- マネージドKafka:クラスタ管理を減らせる一方、利用料とサービス固有の制約があります。
- Kafka互換サービス:Kafkaクライアントを接続しやすい一方、機能範囲は同じとは限りません。
自前運用では、Broker、ストレージ、パッチの管理を自社で担います。監視や障害対応も、自社の担当になります。オンプレミスや特殊なネットワーク、細かな設定の制御が必要な場合に向いています。
マネージドKafkaは、Kafkaの機能を保ちつつ運用負荷を抑えたい場合に適しています。一方、Kafka互換サービスは、既存のクライアントを大きく変えず、クラスタを管理しない構成を優先する場合の候補になります。
互換サービスでは、APIやトランザクション、保持、ストリーム処理が使えるとは限りません。そのため、比べるときは製品名ではなく、必要な機能や可用性で見ます。データ転送、保持期間、サポート範囲も、あわせて確かめます。
Apache Kafkaを採用すべきケースと避けるべきケース
採用するかは、複数の利用者がイベントを独立して読み、後から再処理し、連携先を増やしたいかで考えます。Kafkaは高スループットを実現できますが、どんな用途にも適する万能なメッセージ機能ではありません。
単純な非同期処理であれば、API連携やバッチ、一般的なキューのほうが小さく始められる場合もあります。
リアルタイム連携と複数の利用先がある業務
次のような連携では、Kafkaの強みが活きます。発生元から各処理を切り離せるためです。
- 業務イベントの即時反映:受発注・決済・在庫の変化を、数秒以内に複数のシステムへ届けられます。
- 継続データの収集:IoTセンサーやアクセスログを、継続して収集します。
- 複数用途への配信:同じイベントを、業務処理と分析処理の両方へ送れます。
たとえば、注文イベントを在庫更新、メール通知、売上分析、異常検知へ配信できます。このとき、各処理の追加や停止は、注文システムと切り離して行えます。
Consumerが停止しても、保持期間内であれば、復帰後に未処理のイベントへ追いつけます。夜間バッチでは間に合わない業務や、データを失わずに再計算したい分析に有効です。
低頻度の処理や厳密な業務キューで慎重に比べたい場合
1日に数件から数百件で、1つの処理を1人の担当者へ割り当てれば済む業務では、分散構成が過剰になる可能性があります。
- 状態管理が中心:ジョブの実行状態や期限を管理する場合は、業務キューが候補になります。
- 失敗時の担当再割当て:失敗時の隔離や担当者への再割当てが中心の場合は、ワークフロー基盤が適しています。
厳密な全体順序や複雑な条件付き配信、デッドレターキューが中心の処理では、別の方式や併用も比べる必要があります。Kafkaへイベントを集めれば解決するとは限りません。
Kafka互換サービスも、トランザクションやストリーム処理などの対応範囲に差があります(出典:Kafka互換サービスの公式説明、2024年)。
公開事例の読み取り方と運用効果
公開事例には、月1.2ペタバイト超のセキュリティデータや、1日30億件超のイベントを処理した例があります。インフラチームの負荷を約60%削減した例もあります。
フィッシングやDDoSへの平均対応時間を約97.8〜97.9%短縮した例もあります。ただし、いずれもKafkaだけの効果ではなく、ストレージ、分析、サーバーレス処理、監視を含む基盤全体の効果です。
自社で再現できるかは、イベント量、処理方式、運用体制、導入前の課題を分けて考える必要があります。
Kafkaのシステム構成設計で押さえるポイント
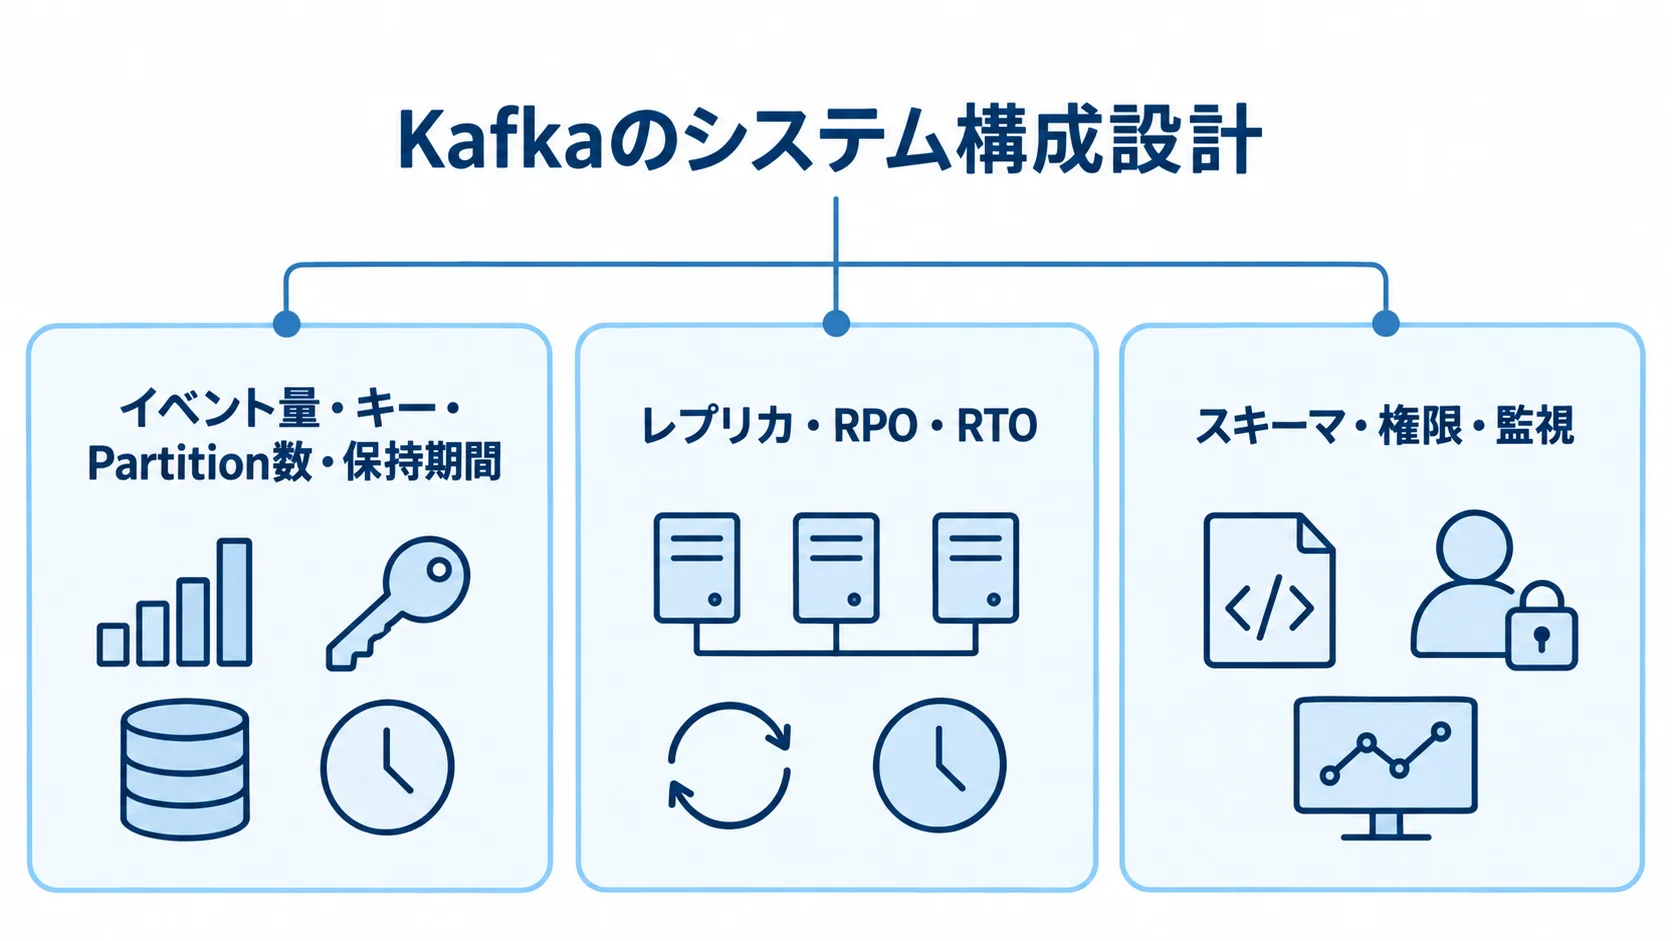
Kafkaの性能と可用性は、導入後の設定よりも要件定義の精度で決まります。そのため、イベント量とピーク、順序、保持を数値にしておきます。あわせて、再処理と障害復旧、個人情報の有無も整理します。
その要件は、Topicやレプリカ、ネットワーク、監視の設計に反映します。
イベント量・キー・Partition数・保持期間の決め方
平均値だけでなく、通常時とピーク時の毎秒件数、1件のサイズ、同時に読むConsumer数を押さえておきます。これらの数値は、必要な処理能力を見積もるための材料になります。
- 順序の単位:注文単位なら注文ID、顧客単位なら顧客IDをキーにする方法があります。
- キーの偏り:特定のキーにイベントが偏ると一部のPartitionが高負荷になるため、偏りも測ります。
- 保持期間:障害復旧と再処理に必要な時間をもとに決めます。
保持期間が24時間か90日かによって、ストレージと転送費が変わります。90日は、月次で再集計が必要な場合の例です。
削除が必要な個人情報を長く保持する場合は、イベントの最小化、匿名化、削除の設計も同時に検討します。
レプリカ・RPO・RTOの一体設計
Replication Factorは、Topicのデータを複製するBroker数です。増やすと障害への耐性は高まりますが、その分、保存容量と転送量も増えます。
- 重要Topic:高い耐久性を設定する。
- 再生成できるログ:別の保持方針にするなど、業務価値に応じて分ける。
RPOは復旧するデータの時点、RTOは処理を再開するまでの時間を指します。そのうえで、Consumer停止後に追いつけるか、別リージョンへ複製するかを決めます。
また、Broker障害時の自動切り替えも検討します。MirrorMaker 2などを使う場合は、切り替えと戻し方を訓練し、設計書だけに頼らない復旧手順にします。
スキーマ・権限・監視の事前設計
イベントのJSON形式を自由に変えると、既存のConsumerが停止するおそれがあります。そこで、項目や型の互換性ルールと、Producer・Consumerのリリース順序を決めておきます。
- 再送対策:同じイベントを二度処理しても結果が壊れない冪等性の設計。
- 失敗追跡:処理不能イベントのDLQと、失敗理由を追う相関IDの設置。
- アクセス管理:TopicとConsumer GroupのACL、TLS、保存時暗号化、秘密情報管理、監査ログ、ネットワーク分離の確認。
個人データを含む場合は、アクセス制御、識別・認証、不正アクセス防止、漏えい防止などの安全管理措置を、RFPに明記しておきます(出典:個人情報保護委員会の個人情報保護ガイドライン、2026年確認)。
監視では、Brokerのディスク使用率に加え、Consumer LagとUnder Replicated Partitionsを追います。処理の失敗、再送、スキーマエラーも、見えるようにします。
Apache Kafkaのシステム開発の進め方
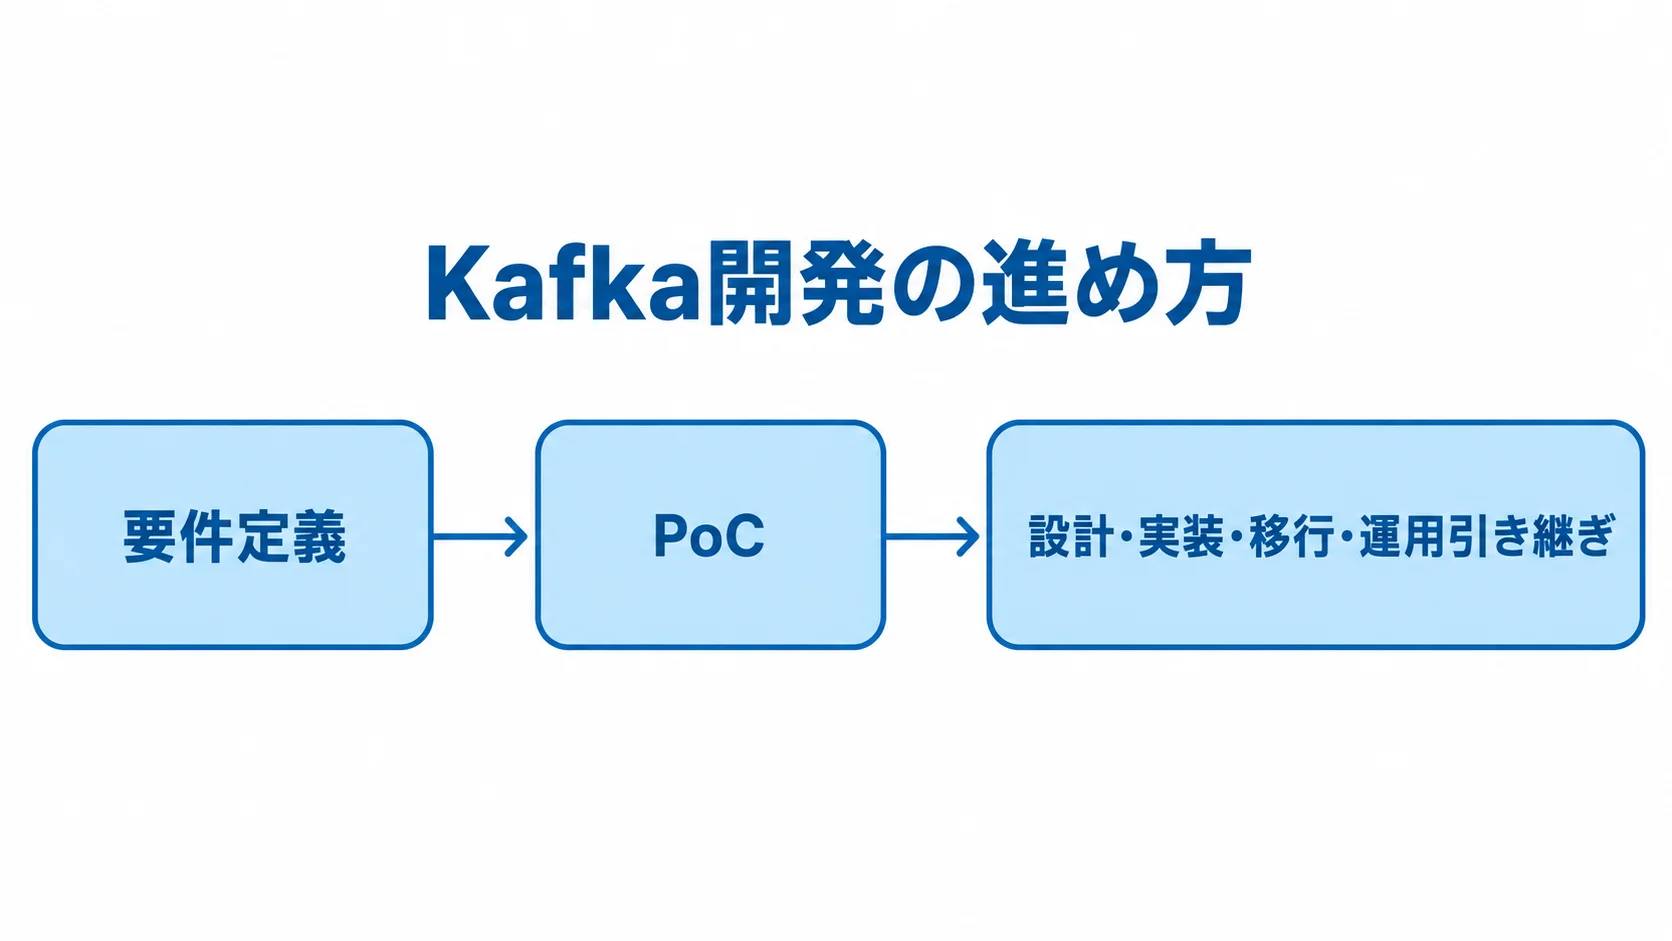
Broker構築後に連携先を考え始めると失敗しやすいため、先に業務イベントを一覧にして、Kafkaが必要な領域を絞ります。その後、小さなPoCで検証してから本番化します。
要件定義から運用引き継ぎまでは、一つの計画にまとめて進めます。Apache Kafkaのシステム開発の進め方/やり方/流れや方法/手法/工程/手順もご覧ください。
要件定義でのイベントと非機能要件の一覧化
要件定義では、イベントごとに発生元やイベント名、キー、ペイロードを整理します。個人情報の有無や、平均・ピーク件数、サイズ、順序、保持期間も、表にまとめておきます。
- 性能・復旧:再処理、許容遅延、RPO、RTO、SLAの記録。
- 連携先:必要なTopic、Consumer Group、成功条件、失敗時の再送方針を、連携先ごとに決めます。
- 業務用語との対応:受注、出荷、決済をTopic名やSchema名と結び付け、担当者が同じ対象を議論できるようにします。
APIやバッチで十分な連携は、Kafkaへ集約しないと判断することも一つの成果です。既存データベースの更新をイベント化する場合は、二重書き込みを避けるOutboxパターンやCDCも比べます。
PoCでの性能・障害・互換性の検証
PoCでは、ProducerからTopicの複数Partitionへ送り、Consumer Groupが並列で処理できるかを確かめます。目標値は、「高速」のような言葉ではなく、数値で定めます。
- 性能:ピーク時のスループットと、P95またはP99の遅延。
- 復旧:Consumer停止、Broker障害、ネットワーク遅延時の復旧時間と未処理件数。
- 異常系:権限エラー、スキーマ変更、再送、順序逆転を意図的に発生させる試験。
Java、Python、Go、.NETなどのクライアントや、RDB、SaaS、分析基盤との接続も試します。認証やTLS、ネットワーク経路、コネクタの制約も、あわせて確かめます。
終了条件には試験結果のほか、IaC、監視ダッシュボード、障害手順、残課題一覧も含めます。これらをそろえておくと、本番設計へ円滑に移れます。
設計・実装・移行・運用引き継ぎの段階分け
基本設計では、TopicやPartition、レプリカを決めます。保持や認証、ネットワークの方針も定めます。さらに、監視やバックアップ、災害対策も、この段階で決めます。
詳細設計では、イベントスキーマやキー、リトライ、タイムアウトを定義します。Offsetや冪等性、DLQ、デプロイの方式も、ここで定めます。
- Producer・Consumerの実装に加え、設定、秘密情報、ログ、メトリクス、アラートを整えます。
- 検証用イベント、影響の小さい業務、重要業務の順にリリースします。
- 移行の前後で件数、結果、遅延、重複、欠損を照合し、切り戻しの条件を決めます。
納品物には、構成図、Topic・Schema台帳、IaCを含めます。テスト結果と監視項目、障害対応手順も納品物に入れます。権限一覧と教育資料も、あわせて渡してもらいます。目指すのは、運用担当者が自力で復旧できる状態です。
Apache Kafkaのシステム開発費用相場とコストの内訳
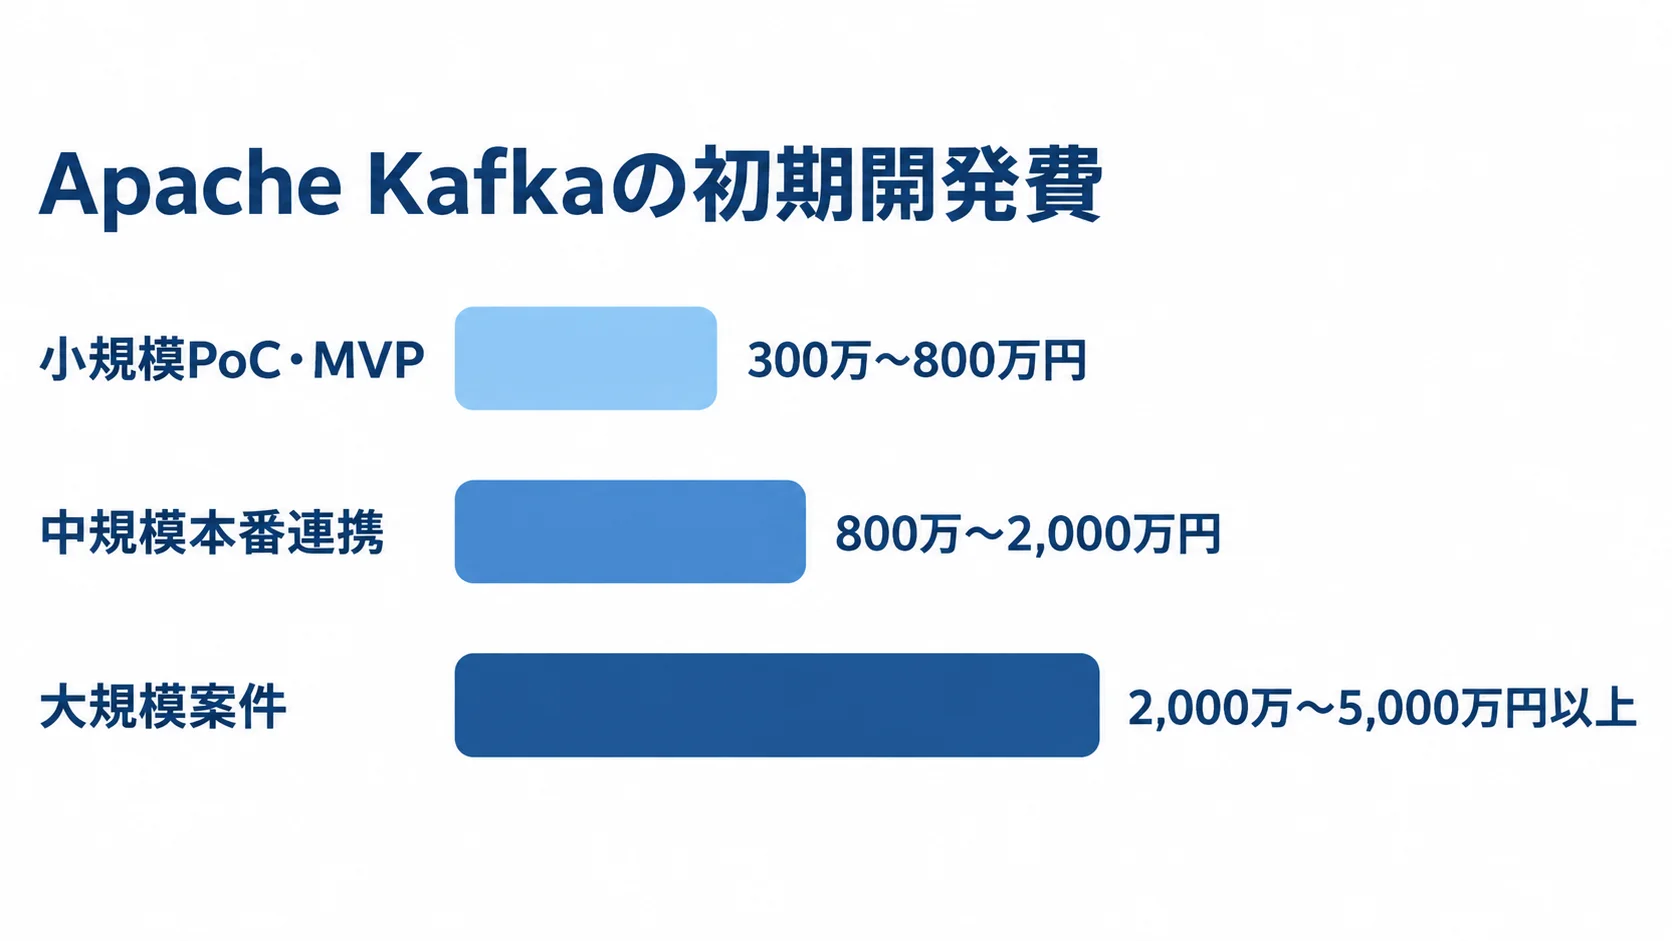
Kafkaの費用は、OSSやマネージドサービスの利用料に加えて、作業全体で決まります。見積もりには、イベント設計、アプリ改修、コネクタが含まれます。テストや監視も対象になります。さらに、セキュリティ、移行、保守も見積もりに入ります。
ここに示す金額は、Kafka専用の公的な受託開発統計から出したものではありません。業務システム開発の一般的な工数と、Kafka特有の非機能要件を組み合わせた、2026年時点の目安です。
Apache Kafkaのシステム開発の見積相場や費用/コスト/値段についてもご覧ください。
初期開発費の目安:小規模PoCで300万〜800万円
初期費用は、連携の範囲と運用条件が広がるほど段階的に上がります。
- 小規模PoC・MVP:1〜3Topic、Producer・Consumer数本、単一環境、基本監視、再送確認までで300万〜800万円程度です。
- 中規模本番連携:800万〜2,000万円程度が目安です。
- 大規模案件:複数リージョン、数十以上の連携、厳格なRPO・RTO、移行、24時間運用、複数チームの統制を含み、2,000万〜5,000万円以上の場合があります。
中規模本番連携には、複数のProducer・Consumer、3ゾーン構成、RDBのCDCが含まれます。スキーマ管理と権限、バックアップも作業に入ります。さらに、段階リリースも見積もりに含めます。
費用は、どこまでを作業範囲に含めるかで変わります。要件整理やイベント設計、クラスタ構築が含まれるかを確かめます。アプリ改修と負荷・障害試験も、含まれるかを見ます。試験や文書が別料金の提案もあるため、作業範囲の確認が欠かせません。
クラウド利用料の内訳:Broker・保存・転送・接続
マネージドKafkaの月額は、次の利用項目の合計です。月間の書き込み量だけでなく、これらも見積もりに含めます。
- 基盤:Brokerまたはコンピュート、ローカル・長期ストレージ、監視。
- データ転送:取り込み・読み出し、ゾーン間転送。
- 接続:コネクタ、プライベート接続。
- 利用量:Consumerの読み取り回数、保持日数、ゾーン間転送量。
公式料金表では、3ゾーン・3レプリカ・24時間保持の条件で試算しています。たとえば、Producer帯域10MiB/秒では、自前構成が月約0.9Kドル、マネージド構成が約1.1Kドルです。
同じ条件で100MiB/秒の場合は、自前構成が月約9.1Kドル、マネージド構成が約11Kドルです。
これは米国リージョンでの試算で、日本円や自社の請求額へそのまま置き換えることはできません(出典:マネージドKafka公式料金表、2026年確認)。
別の公式料金例では、米国東部、3Broker、1TB保存の条件で、Broker約910.66ドル、取り込み10ドル、ストレージ100ドルと試算されています。合計は約1,020.66ドルです。
金額は、リージョンや保持期間によって変わります。加えて、Brokerの種類、レプリカ、転送、接続方式でも変わります(出典:マネージドKafka公式料金ページ、2026年確認)。
初期費用とランニング費用の3〜5年比較
初期費用とランニング費用は、OSS版とマネージドサービスで発生項目が異なります。見積もりでは、次のように分けて比べます。
- OSS版:ライセンス料は無料でも、仮想マシン、ディスク、転送、監視、バックアップ、脆弱性対応、更新、オンコール、人材育成の費用が発生します。
- マネージド:クラスタ管理を減らせますが、利用量課金やサービス固有の制約があります。
- 比較期間:初期はマネージドで始め、3年または5年の転送費、保守費、運用工数を自前運用と比べます。
- 見積項目:設計、構築、アプリ改修、試験、移行、教育、保守と、通常・ピーク時の月額を分けます。
月額には、利用量、レプリカ、保持を含めます。さらに、バックアップや監視も含みます。サポート時間と障害対応も、月額の見積もりに入れます。
「Kafka基盤構築費」だけでなく、既存業務システムの改修費やデータ検証費も確かめてください。
Kafkaのセキュリティ・障害対応・運用設計
Kafkaはイベントを一定期間保持するため、含める情報と、アクセスできる利用者を慎重に設計する必要があります。高可用性であっても、広すぎる権限や個人情報の長期保存は、リスクになります。
運用設計では、予防から再発防止までを一つの流れとして整えます。
Topic ACL・暗号化・監査ログによるアクセス制御
Producerには必要なTopicへの書き込みだけを、Consumerには必要なTopicとConsumer Groupへの読み取りだけを許可します。また、管理者権限とアプリ権限は分けます。
- 権限の更新:退職、異動、委託終了の際に、アカウントを無効にします。
- 暗号化:通信のTLSと、保存データの暗号化。
- 秘密情報:認証情報をコードに埋め込まず、秘密情報管理機能で保管します。
監査ログには、接続Topic、設定変更、Offset操作を記録します。個人情報はイベントへ入れない方法を優先します。そのうえで、識別子への置換や保持期間の短縮、削除対応も検討します。
委託先については、再委託の有無や保管場所を確かめてください。事故時の連絡やログ提出、契約終了時のデータ消去も、確認が必要です。
重複・順序逆転・Consumer停止を前提とした復旧
分散処理では、重複や順序逆転が起きる可能性があります。通信の再送やタイムアウトで、同じイベントが二度届く場合もあります。
- 重複イベント:処理済みIDの記録と、冪等な更新、外部APIの再実行条件の実装。
- 順序逆転:キーとPartition、イベント時刻と処理時刻、遅延イベントの補正の定義。
- Consumer Lag:Consumerを増やしても解決するとは限らず、Partition数、処理時間、DBロック、ネットワーク、下流制限の確認。
Broker障害やディスク逼迫に備えて、Runbookには手順を記載します。アラートへの対応から影響確認、処理停止までを書き、続けて、復旧、再処理、データ照合、報告の手順も加えます。
作成したRunbookは、四半期ごとなど定期的に訓練します。担当者が手順どおりに実行できるかを、そのつど確かめます。
SLOとメトリクスによる運用状態の判断
監視では、BrokerのCPU、メモリ、ディスクを見ます。ネットワークや、Under Replicated Partitions、リクエスト遅延も対象です。
- 処理状況:Consumer Lag、処理失敗、再送、DLQ、Schemaエラーの追跡。
- 業務SLO:「99.9%稼働」だけでなく、注文イベントがP99で30秒以内に在庫Consumerへ届くといった指標の設定。
- 滞留時間:Lagが5分を超えないなど、業務に近い目標の設定。
ダッシュボードを誰が見るか、通知をいつ送るかを決めます。さらに、一次対応者とエスカレーション先、ベンダーへの連絡条件も定めます。
容量予測では、平均値だけでなく、繁忙期やキャンペーン、再処理、レプリカ再構築を見込みます。バージョンアップや証明書更新も、変更管理の対象です。
Apache Kafkaの開発会社・ベンダーの選び方
発注先は、クラスタ構築だけでなく、イベント設計や既存システムの改修まで扱えるかで選びます。負荷試験や障害訓練、監視、保守への対応も確かめます。
マネージドサービスの提供者と、業務要件を整理して実装する開発会社では、担う役割が異なります。そのため、契約範囲と責任分界を先に明確にしておきます。
イベント設計と非機能要件の実績
Kafkaの利用経験の有無だけでは判断せず、開示できる範囲で案件の規模と試験内容を確かめます。
- 処理規模:イベント数、ピーク帯域、Topic・Partition数、保持期間を尋ねます。
- 可用性:レプリカ、許容遅延、RPO・RTO、障害試験の実績。
- 業務との類似性:連携先やデータ量が近い案件を、再現できるかどうかの確認。
提案書には、要件定義、PoC、設計について、誰が担うかを明記してもらいます。そのほかの工程は、次の項目ごとに担当者を書いてもらいます。
- 実装:Producer・Consumerの実装と設定の担当。
- テスト:試験の実施と結果の確認の担当。
- 移行:件数や遅延の照合、切り戻し条件の決定の担当。
- 教育:運用担当者向けの教育資料の作成の担当。
- 運用引き継ぎ:Runbookや引き継ぎ記録の作成の担当。
一次請けか再委託か、Kafka担当者がどの工程から参加するか、交代時の引き継ぎ方法も確かめます。会社名の知名度や価格だけでなく、問題が起きたときに判断する人も見極めます。
見積もりでの成果物・保守・責任分界の比較
見積もりでは、初期開発費とクラウド利用料、ライセンスを分けます。保守や監視、障害対応、追加開発も、項目ごとに分けて示してもらいます。
- 設計・構成:イベントカタログ、Topic台帳、Schema、構成図の確認。
- 実装・試験:IaC、ソースコード、テスト仕様と結果、監視設定の確認。
- 運用引き継ぎ:Runbook、教育資料、引き継ぎ記録までを含めること。
設定値やコードが引き渡されず、特定の担当者に依存する契約では、将来の移管コストが高くなります。
保守契約では、受付・初動・復旧目標と、重大障害の連絡方法を確かめます。脆弱性対応や更新、容量変更、復旧も、契約の範囲に入るかを見ます。再委託の扱いや終了時の支援も確認しておきます。
24時間対応が必要な場合は、夜間・休日の体制と追加料金を具体的に決めておきます。RFPには、イベント量やピーク、保持を書きます。順序や個人情報も記載します。さらに、SLA、予算、既存連携、希望納期も入れます。
▶ 詳細はこちら:Apache Kafkaのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Apache Kafkaのシステム開発の発注/外注/依頼/委託方法について
Apache Kafkaのシステムに関するよくある質問(FAQ)
Kafkaの導入では、技術用語の理解だけでなく、自社の業務要件に当てはめて考えることが大切です。検討時によく出る質問に、直接答えます。
Apache Kafkaはデータベースやメッセージキューと何が違いますか?
Kafkaはイベントを追記型ログとして保持し、複数のConsumerが各自のOffsetから読み直せます。最新状態の検索や複雑なトランザクションを主目的とするデータベースとは、役割が異なります。
処理を一人の担当者へ渡すことを主目的とするキューとも違います。必要に応じて、データベースやキューと組み合わせて使います。
自前運用とマネージドサービスはどちらがよいですか?
運用人数や既存クラウド、可用性で決めます。転送量やセキュリティ要件、3〜5年のTCO(総所有コスト)も、判断材料になります。
自前運用は自由度が高い一方、障害対応やパッチ、容量設計を自社で担います。バックアップとKRaft更新も含まれます。マネージドでは、クラスタ管理を減らせます。
マネージドの利用料や機能差、リージョン、接続方式、固有の制約は、PoCで確かめます。
Kafkaの開発にはどのくらいの費用と期間がかかりますか?
小規模PoCやMVPは、300万〜800万円、2〜4か月程度が一つの目安です。一方、複数の業務システムをつなぐ本番連携は、800万〜2,000万円、5〜9か月程度です。
大規模な基幹連携や災害対策を含むと、2,000万〜5,000万円以上、9〜18か月程度になる場合があります。
費用は、イベント量や既存アプリの改修で変わるほか、データ移行や試験、24時間運用の有無でも変わります。金額だけでなく、作業範囲と成果物も比べます。
個人情報をKafkaへ流しても問題ありませんか?
まず、個人情報を流す必要性と安全管理措置を確かめます。そのうえで、データの最小化、アクセス権限、暗号化を設計します。ほかに、監査や保持期間、削除・匿名化、委託先の管理も決めます。
個人情報を含めずに連携できるなら、識別子や参照キーへの置き換えを優先します。あわせて、法務や情報セキュリティの担当者と、イベントごとの保存期間と利用者を確かめてください。
Apache Kafkaのシステム開発を成功させるためのまとめ
Apache Kafkaはイベントを保存し、複数の業務システムや分析基盤へ配信できます。一方で、要件に合った設計がなければ、複雑さと費用だけが増える可能性があります。
Partitionやキー、保持期間は業務要件に合わせて決めます。レプリカやスキーマ、権限、障害復旧も、業務要件を起点に設計します。
導入前のイベント量と採用理由の数値化
まず、どの業務の遅延やデータ分断を解消するのかを明確にします。平均とピークのイベント量や許容遅延は一覧にして押さえ、順序や保持、再処理、RPO・RTOも同じ一覧に加えます。
個人情報やSLA、予算、既存連携も整理したうえで、Kafka以外の方式と比べます。目的が明確であれば、Partition数やマネージドの範囲も過不足なく決められます。
PoC・試験・運用体制を含めた発注
本番化の前に、重複や順序逆転、Consumer停止、Broker障害を検証します。さらに、スキーマ変更や権限エラー、復旧、再処理も確かめておきます。
発注先は、構築実績に加えて、イベント設計や負荷試験、障害訓練で比べます。成果物や保守SLA、責任分界も比較の対象です。目指す成果は、連携の遅延と分断を解消し、業務を継続できる状態です。
▼関連記事一覧
・Apache Kafkaのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Apache Kafkaのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Apache Kafkaのシステム開発の見積相場や費用/コスト/値段について
・Apache Kafkaのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。