
Apache Kafkaのシステム開発は、6つのフェーズを順に進めます。はじめに要件整理とサービス選定を行い、設計・開発へ進みます。その後、テストと段階稼働を経て、運用定着で締めくくります。
この流れを守ると、業務イベントを安全に流し続ける基盤になります。導入判断から見積もりの確認まで、発注側が押さえる点も含めています。
▼全体ガイドの記事
・Apache Kafkaのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Apache Kafkaのシステム開発の全体像と導入の要否
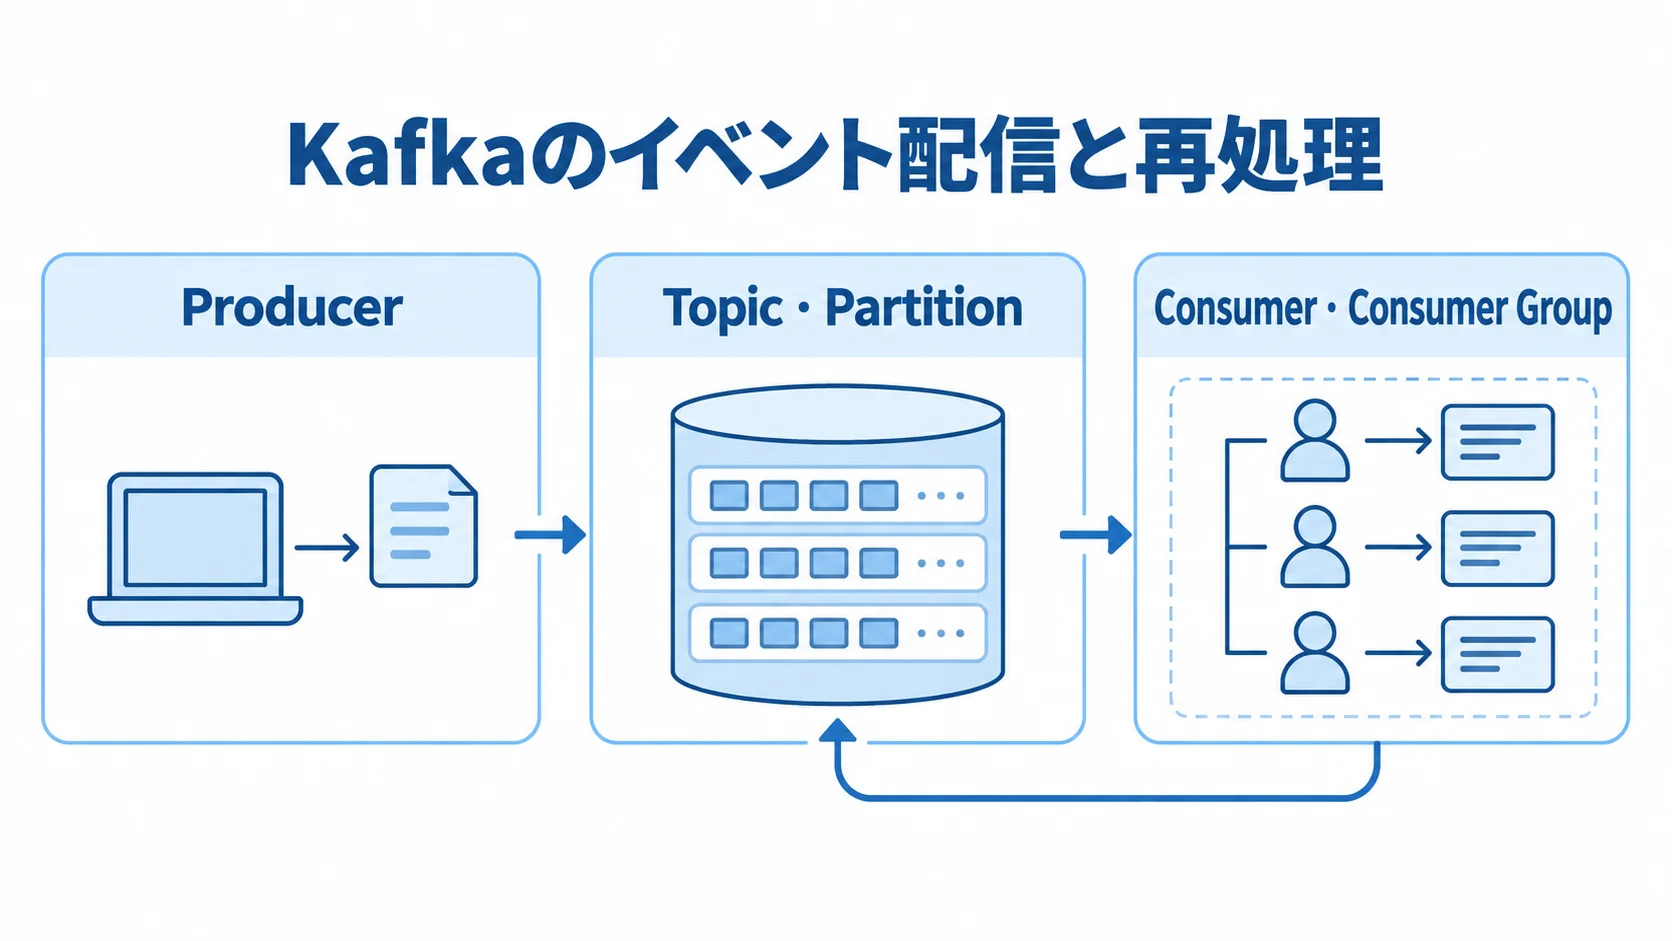
Apache Kafkaは、大量の業務イベントを複数のシステムへ継続して配信し、後から再処理したい企業に向いています。少量データの単発送信や単純な画面間連携であれば、通常のAPI、バッチ、RDB、SQSなどのほうが軽く済みます。ただし、導入の目的は「Kafkaを使うこと」ではなく、連携の遅延と分断の解消に置きます。
Kafkaの特徴:イベントを蓄積して再利用できる基盤
Kafkaでは、注文や決済、在庫変動などをイベントとしてTopicに追記します。IoTセンサーの値やアクセスログも、同じ仕組みで扱えます。Producerがイベントを書き込み、Consumerがそれを読み取り、Consumer Groupで処理を分担します。TopicとPartitionの分割単位は、次の性質を踏まえて決めます。
- 並列処理:TopicをPartitionに分けると、処理を複数に振り分けて進められます。
- 再処理:保持期間を設定しておき、オフセットを戻せば、イベントを読み直せます。
- 順序:注文番号、顧客ID、商品IDなどのキーで同じPartitionに送ると、その中での並び順が保たれます。
一般的なメッセージキューと違って、Kafkaはイベントを保持できます。ただし、Topic全体の完全な順序は自動では保証されません。さらに、Partition数を増やすと、業務上の順序が崩れるおそれもあります。
導入判断の観点:遅延・量・再処理
導入の可否は、次の条件を数値で示して判断します。
- イベント量と遅延:発生数、ピーク倍率、許容遅延を決めておきます。
- 保持と順序:保持期間、再処理の要否、順序を保証する単位を決めます。
- 配信先と再実行:複数先への同時配信や、障害後の読み直しが必要かどうか。
たとえば、受注を在庫・通知・分析へほぼ同時に配信し、障害復旧後に同じ注文イベントを読み直したい場合は、Kafkaの効果が出やすいです。一方、毎晩1回の集計で足りる場合や、送信先が1つだけの場合、失敗時に画面から再実行できる場合は、Kafkaを入れると運用負荷が増えるだけになるおそれがあります。
判断の前に、発生元やイベント名、個人情報の有無などの条件を一覧にしておきます。対象は、1日量やピーク量から、保持期間、再送方針、目標RPO・RTOまでです。
Kafka 4.0は2025年3月に公開され、ZooKeeperを使わないKRaftモードを前提にした節目になりました(出典: Apache Kafka公式「Apache Kafka 4.0.0 Release Announcement」、2025年)。そのため、新規案件ではKafkaのバージョン、Javaの対応範囲、マネージドサービスの機能差も比べます。
Apache Kafkaのシステム開発の進め方
Kafkaの開発は、Brokerを立ち上げてアプリを接続すれば終わりではありません。イベントの意味や失敗時の扱い、データ削除の権限、運用担当が見るメトリクスまで、あらかじめ設計しておく必要があります。
各フェーズで成果物と判断基準を残しながら、順に進めます。
1. 要件整理:業務イベントを数値と責任範囲で定義
まず、業務イベントの発行条件、キー、発生元と利用先を定義します。あわせて、Kafkaでなければ解けない課題かどうかも検討します。
- イベント要件:イベント数とピーク倍率、遅延の条件を定めます。順序、重複、再送の扱いも決めます。
- データと運用条件:保持期間と個人情報の扱い、RPO・RTOを確認し、監査要件の有無も見ておきます。
- 連携範囲:発生元と利用先をつなぎ、必須の業務連携を区別します。
例として、注文確定時にorder-createdを発行する場合、1件あたり最大50KB、平常時は毎秒200件と記載します。キャンペーン時は10倍とし、7日間再処理可能とも書きます。
成果物は、イベントカタログ、連携一覧、非機能要件のほか、責任分界表とPoCで検証する仮説も残します。
2. 選定:OSS・マネージド・互換サービスの比較
候補は、自社で運用するOSS、マネージド方式、専門サービスに分けて比べます。
- 運用方式:OSSとAmazon MSK、Confluent Cloudを比べます。
- マネージド方式:Google Cloud Managed Service for Apache Kafkaも候補に入ります。
- 互換性と機能:Kafkaのバージョン、KRaft、Partition上限を確認し、Schema RegistryとKafka Connectの対応も見ます。
- 運用条件:SLAやログ保管、サポート窓口の条件を比べ、月額の従量項目も見ます。
- 互換サービス:Azure Event HubsはKafkaクラスタそのものではないため、機能差をProducerとConsumerで検証します。
AWSを標準で使う場合は、IAMやKMS、CloudWatchと連携しやすいMSKが候補になります。PrivateLinkとも連携しやすくなっています。また、OpenShiftやオンプレミスを重視するなら、Red Hat AMQ Streamsも検討の対象です。
Azure Event Hubsは、保持期間やトランザクション、APIに差があります。メトリクスや障害時の動作の違いもあるため、ProducerとConsumerを使って実際に確かめます。
3. 設計・開発:イベント契約と障害時の動作の作り込み
設計では、イベントの契約と障害時の動作を、実装の前に決めておきます。
- Topic設計:名前とPartition、キーを決めます。Replication Factorと保持期間、圧縮、サイズも定めます。
- 処理保証:再送と冪等性、コミットを設計します。重複やDLQ、リトライの扱いも決めます。
- スキーマ:必須項目と型変更、旧Consumerとの後方互換性を、CIで検査します。
- 接続:Kafka ConnectでRDBやSaaS、データレイクにつなぎ、不足する部分だけ開発します。
特定の注文にイベントが集中すると、一つのPartitionが混雑します。そこで、ピーク時の偏りを試算し、Partition数を増やしたときの順序やConsumer数との関係も見ておきます。
注文番号をキーにすると、同じ注文の更新順を保ちやすくなります。一方で、Exactly-onceを全体に求めると、構成も費用も重くなります。そのため、決済確定のように厳密さが必要な処理と、通知や分析のように重複を許容できる処理は、分けて設計します。
IaCでクラスタやTopic、ACLを再現します。監視の設定も同じ仕組みで再現し、手作業だけで本番環境を作らないようにします。
納品物には、アプリケーションや設定ファイル、スキーマを含めます。運用手順と障害対応手順も、納品物の一部として受け取ります。
4. テスト:障害系を重点にした検証
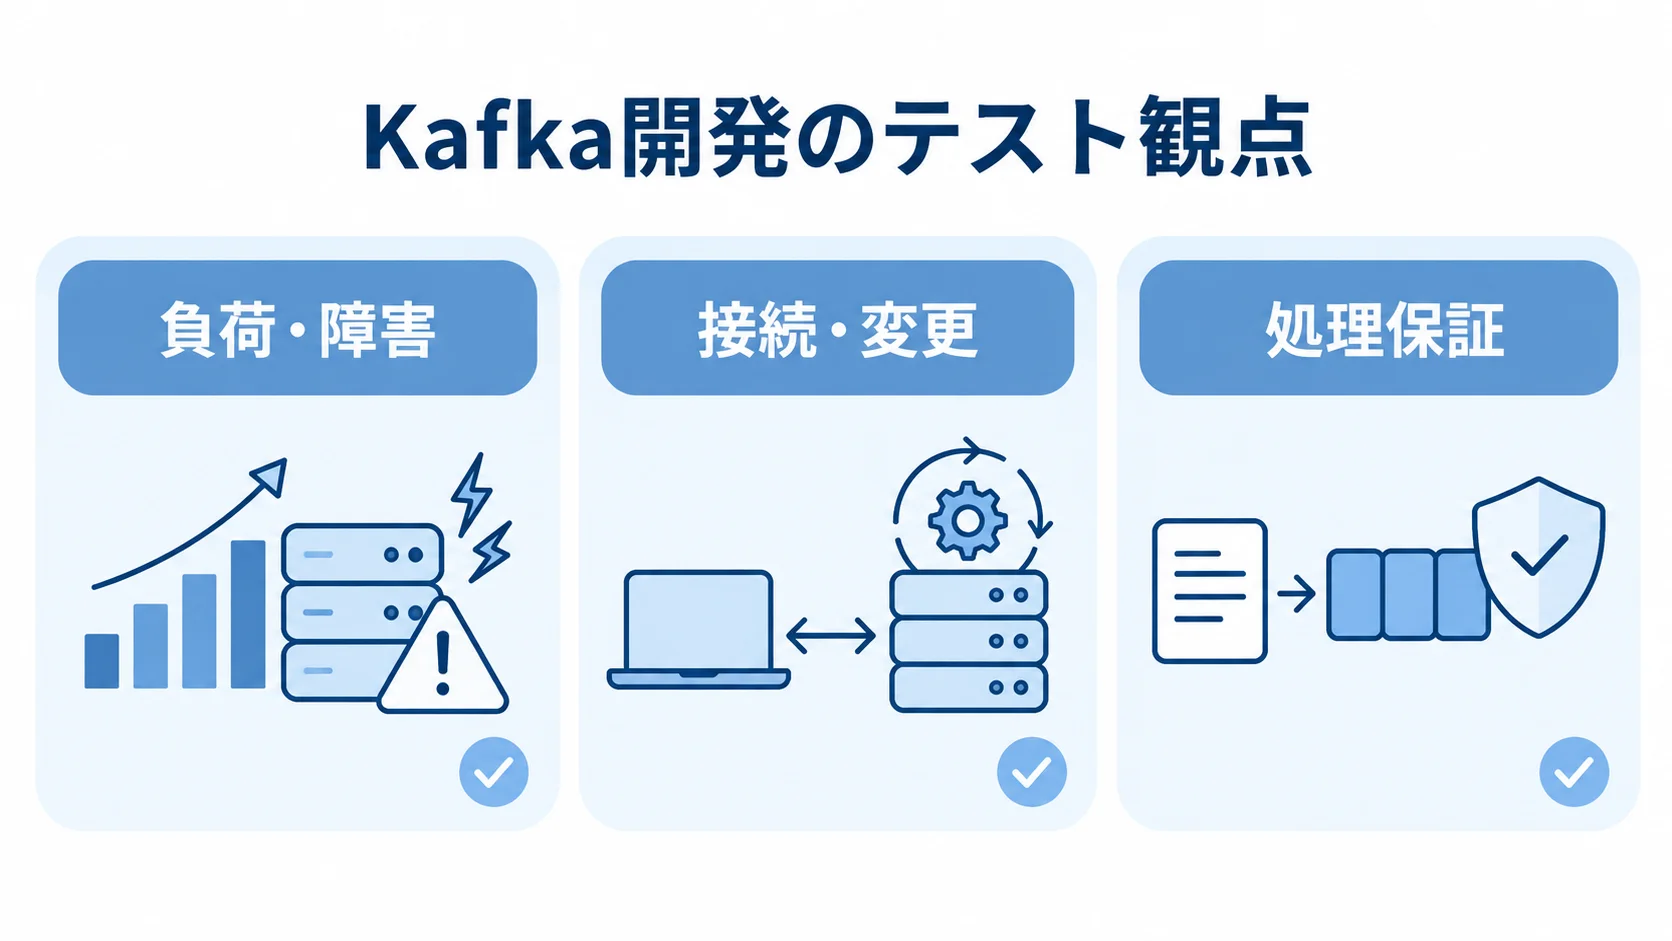
テストでは、到達確認に加えて、負荷や障害時の動作を検証します。
- 負荷・障害:平常時とピーク時の負荷、Consumerの停止、Brokerの障害を試します。
- 接続・変更:ネットワーク遅延やPartitionの再配置を試します。Schemaの変更やDB停止の影響も見ます。
- 処理保証:再送時の二重計上と、再起動後の再開位置を業務データで確認します。
試験項目には、スループットやp95・p99遅延、Consumer Lagを含めます。そのほか、ディスク使用率やレプリカ不足、再処理時間も入り、DLQからの復旧時間も含みます。
たとえば、Consumer停止から10分以内に復旧し、停止中のイベントを欠損なく処理する基準を設けます。決済イベントが重複しても、同じ決済番号を二重に反映しない基準も必要です。
「高可用性」や「リアルタイム」のように数値のない基準では、テストの合否を決められません。
5. 稼働:段階リリースと監視による本番変化の抑制
全業務を一度に切り替えず、影響範囲の小さい1業務から始めます。本番の変化を抑えるための進め方です。
- 並行稼働:旧連携とKafkaを一定期間並行させ、件数や遅延、欠損を照合します。重複の有無と業務結果もあわせて確かめます。
- 切り戻し:Lagが何分続いたら停止するか、欠損1件で戻すかを決めておきます。担当者と連絡先も定めます。
- 監視と復旧:BrokerとConsumerの指標を監視し、復旧先で読み取れるかも確認します。
アラートが多すぎると、重要な障害が埋もれてしまいます。そのため、一次対応や二次対応、ベンダーへの連絡の条件を、運用手順として決めておきます。
バックアップやMirrorMaker 2を使う場合は、設定を確かめるだけでなく、復旧先で読み取りを再開できるかまで確認します。
BrokerのCPUやメモリ、ディスクを監視します。Consumer LagとUnder Replicated Partitionsの状態も見ておきます。リクエストエラーやスキーマ拒否、DLQ件数も監視対象です。
6. 定着:運用指標と教育による継続利用の体制
Kafkaを作ったチームだけが分かる状態では、使い続けるのが難しくなります。そこで、運用ルールを標準化します。
- 標準手順:申請と命名のルール、スキーマ変更のレビュー、個人情報と保持期間の扱いを定めます。
- 定期確認:月次で、イベント量やピーク、遅延を見ます。Lagや失敗、再処理の状況に加え、請求額も確認し、容量不足とコスト増を早めに見つけます。
- 担当者の演習:停止対応やDLQの再送、ACLの変更を練習します。証明書の更新と障害連絡も含みます。
- 個人データ保護:個人データを扱う場合は、Topic ACL、Consumer Group ACL、TLSを運用します。
個人データの保護では、暗号化や秘密情報、監査、削除・匿名化も対象になります。個人情報保護委員会は、個人データの漏えい・滅失・毀損を防ぐため、必要かつ適切な安全管理措置を求めています(出典: 個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン」、2025年確認)。
Apache Kafkaのシステム開発費用相場とコストの内訳
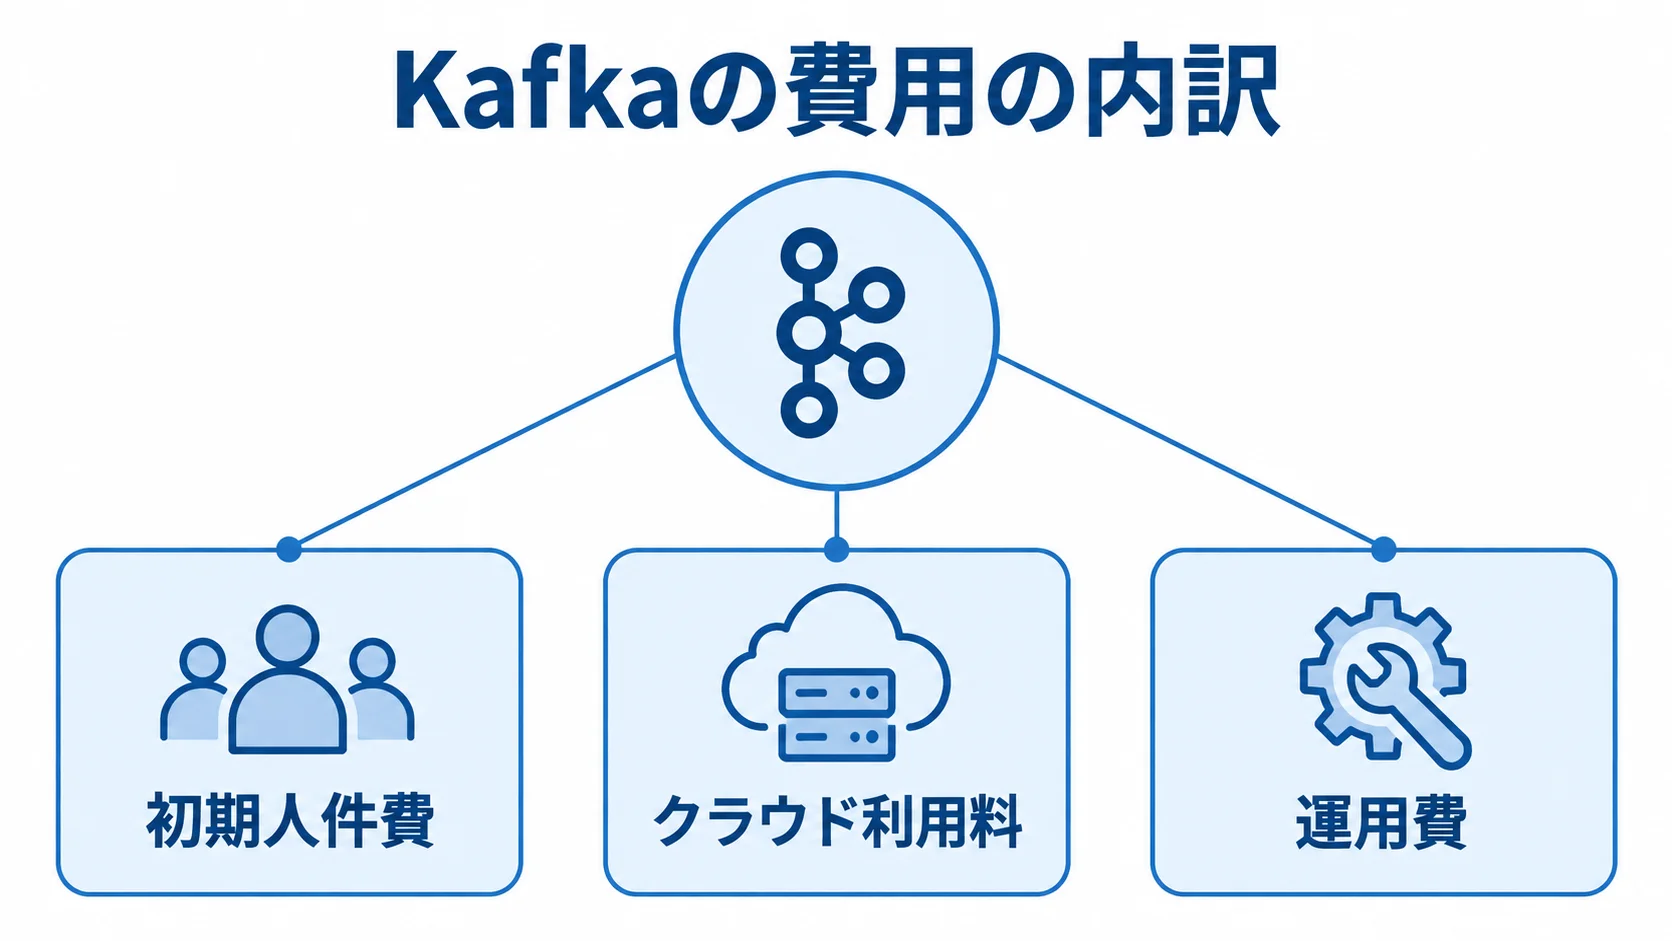
Kafkaの費用は、Broker利用料のほかにも、イベント設計やProducer・Consumerの改修まで含めて考えます。既存DBへの接続も費用の対象です。負荷試験や監視、障害訓練、保守体制も、見積もりに入ります。
Kafka専用の国内受託開発統計は、公開情報が限られています。そのため、以下の初期開発費は、一般的な業務システム開発の相場にKafka特有の非機能要件を加えた目安です。
規模別の初期開発費の目安:300万〜5,000万円以上
見積もりでは、規模を分ける条件を確かめます。Topic数や接続数、クラウド構成などが該当します。
- 小規模PoC・MVP:300万〜800万円、2〜4か月程度。
- 本番の中規模連携:800万〜2,000万円、5〜9か月程度。
- 大規模な基幹連携:2,000万〜5,000万円以上、9〜18か月程度。
小規模は、1〜3Topicや数本のProducer・Consumerを想定します。単一クラウドで、基本監視と再送確認を含む前提です。
中規模は、複数のProducer・Consumerや3ゾーン構成、RDBのCDCを想定します。Kafka ConnectやSchema Registryを含むと工数が増えます。権限や監視、段階リリースが加わる場合も、工数が増えます。
大規模では、数十〜数百の連携と複数リージョンを前提にします。厳格なRPO・RTOやデータ移行も含みます。監査ログや24時間運用、複数ベンダーの統制も対象です。
金額は確定価格ではなく、イベント量や既存アプリの改修範囲、個人情報の有無によって変わる推定のレンジです。試験の深さでも変わります。大規模案件では、5,000万円を超える可能性も提案段階で明記してもらいます。
費用の内訳:人件費・クラウド費・運用費
Kafkaの費用は、初期の人件費、クラウド利用料、運用費に分けて比べます。
- 初期費用の配分:要件整理10〜12%、設計・環境構築22〜24%、実装48〜50%、テスト15〜17%を仮置きします。
- 人件費:PMやSE、PGなどの単価と人月、成果物を確認します。
- クラウド費:Brokerやディスクの規模、保持や転送の条件で変わります。監視やバックアップも費用に入ります。
負荷試験や障害訓練を削ると、本番後の復旧費が大きくなることがあります。なお、人月単価は会社や契約形態によって異なります。
クラウド費は、レプリケーションやPrivateLinkの利用でも変わります。AWSが公開しているMSKの料金例は、米国東部の3Broker構成やストレージなどを前提に、月額を計算しています。
Serverlessの例では、クラスター時間とPartition時間を合算し、データ入出力や保持ストレージも加えています(出典: AWS「Amazon MSK pricing」、2026年確認)。この料金例は、日本リージョンの実額ではありません。そのため、自社のリージョンとトラフィックで計算し直します。
Google Cloudのマネージドサービスは、vCPUやRAM、ローカルと永続のストレージを前提に試算します。データ転送なども条件に含めます。3ゾーン前提のため、単一ゾーンの検証環境と本番の費用を、同じ条件で比べないようにします。
Confluent Cloudは、データ転送や保存、CKUまたはeCKUで請求額が決まります。コネクタやksqlDB、Flink SQLを使うと、その分も請求に加わります。監査ログやサポートも、消費量に含まれます(出典: Confluent公式ドキュメント「Manage Billing in Confluent Cloud」、2026年確認)。
Apache Kafkaのシステム開発で見積もりを取る際のポイント
見積書では、Kafkaクラスタの構築費に加えて、業務側の変更費と運用引き継ぎ費も確認します。
「Kafka基盤一式」「連携開発一式」「テスト一式」では、Topic数やアプリ数、試験ケースが読み取れません。期間や成果物も分からないため、内訳を求めます。
見積依頼に添付するイベント量と非機能要件
RFPには、見積もりの前提となるイベント量と非機能要件を具体的に書きます。
- イベント条件:発生元と送信先、イベント名を記載します。サイズと、平常時・ピーク時の件数も書きます。
- 処理条件:Consumer数や保持期間、再処理の扱いを示します。順序キーと許容遅延も含めます。
- 環境・非機能要件:クラウドやリージョン、可用性、RPO・RTOを伝えます。認証や個人情報、監査、削除方針も記します。
既存システムの言語やDBも伝えます。数値が未確定の場合は、低・標準・ピークの3パターンで仮置きしてもらいます。
成果物には、イベントカタログやTopic・Partition設計書、スキーマ定義を含めます。ACL設計とIaCも、成果物として求めます。
Producer・Consumerの改修、Kafka Connectの設定、監視ダッシュボードも、成果物として記載します。
負荷試験結果や障害訓練結果、運用手順、教育資料も記載します。スキーマとACLを除いたままにすると、後から追加する際に属人化しやすくなります。
開発会社の確認項目:Kafka構築以外の実績
開発会社の技術実績、契約体制、見積もりの内訳は、同じ要件で比べます。
- 技術実績:イベント設計や既存改修、CDCについて尋ねます。Kafka ConnectとSchema Registryの経験も確かめます。
- 試験・運用実績:負荷試験や障害訓練、SREの実績を見ます。個人情報保護の対応も確かめます。
- 契約・体制:一次請けか再委託か、担当が継続するかを確認します。コードとIaCの引き渡しや、24時間一次対応も見ます。
- 費用と範囲:初期とクラウド、保守、追加変更単価を分けて比べます。
Partition設計や監視、障害試験、データ移行が別途になっていると、提案の金額が安くても、本番までの総額は上がります。
マネージドサービスは運用負荷を下げられます。ただし、転送量や保存期間、コネクタ数を見誤ると、月額が膨らみます。
見積もりのリスク管理:前提・除外・変更条件
見積もりの価格前提と、変更時の影響、契約上の責任範囲を確認します。
- 価格前提:件数やサイズ、保持期間を明記します。Partitionとレプリカ、環境と連携数も書きます。
- 変更条件:保持期間を7日から30日にする場合、Consumerを2つから10個にする場合、東京・大阪の二拠点にする場合を確認します。
- 契約責任:障害の分界やアカウントの所有者、証明書を決めます。消去や脆弱性、更新の扱いと、サポートや再委託の範囲も定めます。
未確定の項目は、決まるまで価格が変わりうる条件として扱います。変更があった場合は、ストレージや転送への影響を確認します。設計や試験、保守への影響も見ておきます。
KRaftへの対応やJavaのバージョン、マネージドサービス固有の設定制限も、将来の追加費用に関わります。PoCを別契約にする場合は、本番移行の際に成果物を再利用できるかを確認します。
Apache Kafkaのシステム開発でよくある質問
構成の正解は、イベント量や業務の重要度によって変わります。そのため、一般論だけで決めず、自社の要件表とPoC結果に照らして判断します。
Apache Kafkaはどのようなシステムに向いていますか?
大量のイベントを複数の利用先へ低遅延で配信し、後から再処理したいシステムに向いています。注文や決済、在庫、IoT、アクセスログなどが例です。
送信先が少なく処理量も少ない場合や、失敗時に簡単に再実行できる業務では、API、バッチ、通常のキューが適切な場合があります。
OSS版Kafkaとマネージドサービスはどちらがよいですか?
運用人材が限られていて、早く本番での検証を進めたい場合は、Broker障害やパッチ適用の負担を減らせるマネージドサービスが候補になります。
細かな設定やオンプレミスを重視する場合は、OSSの自社運用も比べます。既存コンテナ標準に合わせる場合や、長期の転送費の最適化を図る場合も、OSSの自社運用が候補に入ります。
判断の基準は利用料だけではなく、総保有コストです。24時間運用や障害対応、アップグレード、教育も含めて考えます。
Apache Kafkaのシステム開発にはどのくらいの期間がかかりますか?
小規模なPoCやMVPは2〜4か月、本番の中規模連携は5〜9か月、大規模な基幹連携は9〜18か月程度が目安です。
要件整理や既存アプリの改修、データ移行が増えるほど、期間は長くなります。障害試験やセキュリティ審査、社内承認も、期間を延ばす要因になります。短縮する場合も、負荷試験や切り戻し試験は省かず、対象業務を絞って段階リリースします。
Kafkaで二重処理やデータ欠損を防げますか?
再送や冪等性、適切なオフセット管理を組み合わせ、レプリケーションやDLQ、障害試験も加えると、二重処理や欠損のリスクを大きく下げられます。
Kafkaだけで、業務システム全体のExactly-onceが自動で実現するわけではありません。そのため、決済番号などの業務キーで重複を排除し、処理ごとの保証レベルを要件として決めます。
まとめ
6フェーズを通した判断基準と成果物の記録
Apache Kafkaの開発は、クラスタ構築ではなく、業務イベントを安全に流し続ける仕組みを作るプロジェクトです。
要件整理では、イベント量やピーク、遅延を定義します。順序や保持、再処理の扱いも決めます。RPO・RTOと個人情報の扱いは、この段階で固めます。
選定では、OSS、マネージド、Kafka互換サービスを総保有コストで比べます。
発注前の総額と運用責任の確認
設計・開発では、キーやPartition、レプリカを決めます。スキーマや再送、冪等性、DLQ、ACLの扱いも決めます。テストでは、Consumer停止やBroker障害、重複を検証します。順序逆転やスキーマ変更、負荷も検証します。
稼働後も、監視や障害訓練、費用の確認、教育を続けます。見積もりでは、基盤費に加えて既存アプリの改修やクラウド従量費を比べます。試験や保守、引き継ぎも含めて見ます。
▼全体ガイドの記事
・Apache Kafkaのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。