
Azure Synapse Analyticsは、SQL、Apache Spark、データ統合用パイプラインをまとめた分析サービスです。分散した業務データを、分析に使える形に整えます。
導入の目的や構成、開発の進め方、費用、開発会社の選び方、運用上の注意点を扱います。詳しくは関連記事もご覧ください。
▼関連記事一覧
・Azure Synapse Analyticsのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Azure Synapse Analyticsのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Azure Synapse Analyticsのシステム開発の見積相場や費用/コスト/値段について
・Azure Synapse Analyticsのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Azure Synapse Analyticsのシステム全体像
分析に使う機能として、SQL、Apache Spark、データ統合用パイプラインを一つのサービスにまとめているのがAzure Synapse Analyticsです。
Synapse Studioでは、データを取り込んで探索し、変換、開発、監視まで進められます。
さらに、権限設定やGit連携も行えます(出典: Microsoft Learn「Azure Synapse Analyticsとは」、2024年更新)。
解決できる課題
分散したデータを業務判断に使える形で届けることが、Synapseの役割です。導入時は、次の4点を設計します。
- 共通の集計:複数システムのデータを共通の定義で集計する
- データの連携:受注・出荷・売上を顧客や商品コードで結ぶ
- 分析への提供:経営ダッシュボードや在庫分析に届ける
- 基盤の役割:業務画面ではなく、判断に使う信頼できるデータを整える
導入の成否は、SQLプールの性能だけでなく、KPI定義やマスタ統合にも左右されます。
欠損や重複に加えて、「売上」を税込と税抜のどちらで数えるか、集計日をいつにするかも決めておく必要があります。
定義を決めないまま構築すると、高価な基盤でも部門間の数字は一致しません。
基本的な構成
基本構成は、データの取り込みから利用までを、次の4つの観点で設計します。
- 取り込み・保存:Pipelinesで取り込み、Azure Data Lake Storage Gen2にRawデータを保存する
- 加工・提供:SQLやSparkで加工し、Power BIやAPIへ渡す
- データ層:Raw、Cleansed、Curatedに分け、再処理しやすくする
- 分析方法:専用SQLは分析用テーブルへ集約し、サーバーレスSQLはレイク上のファイルをT-SQLで参照する
構成には、ストレージやネットワーク、ID管理も含まれます。監視やBIライセンスも、構成の一部として含まれます。
見積書にSynapseの構築費しか載っていない場合は、周辺の費用が抜けていないかを確かめます。転送やPrivate Link、バックアップのほか、権限設計、レポート作成、運用監視の有無も見ておきます。
Azure Synapse Analyticsの種類と構成要素
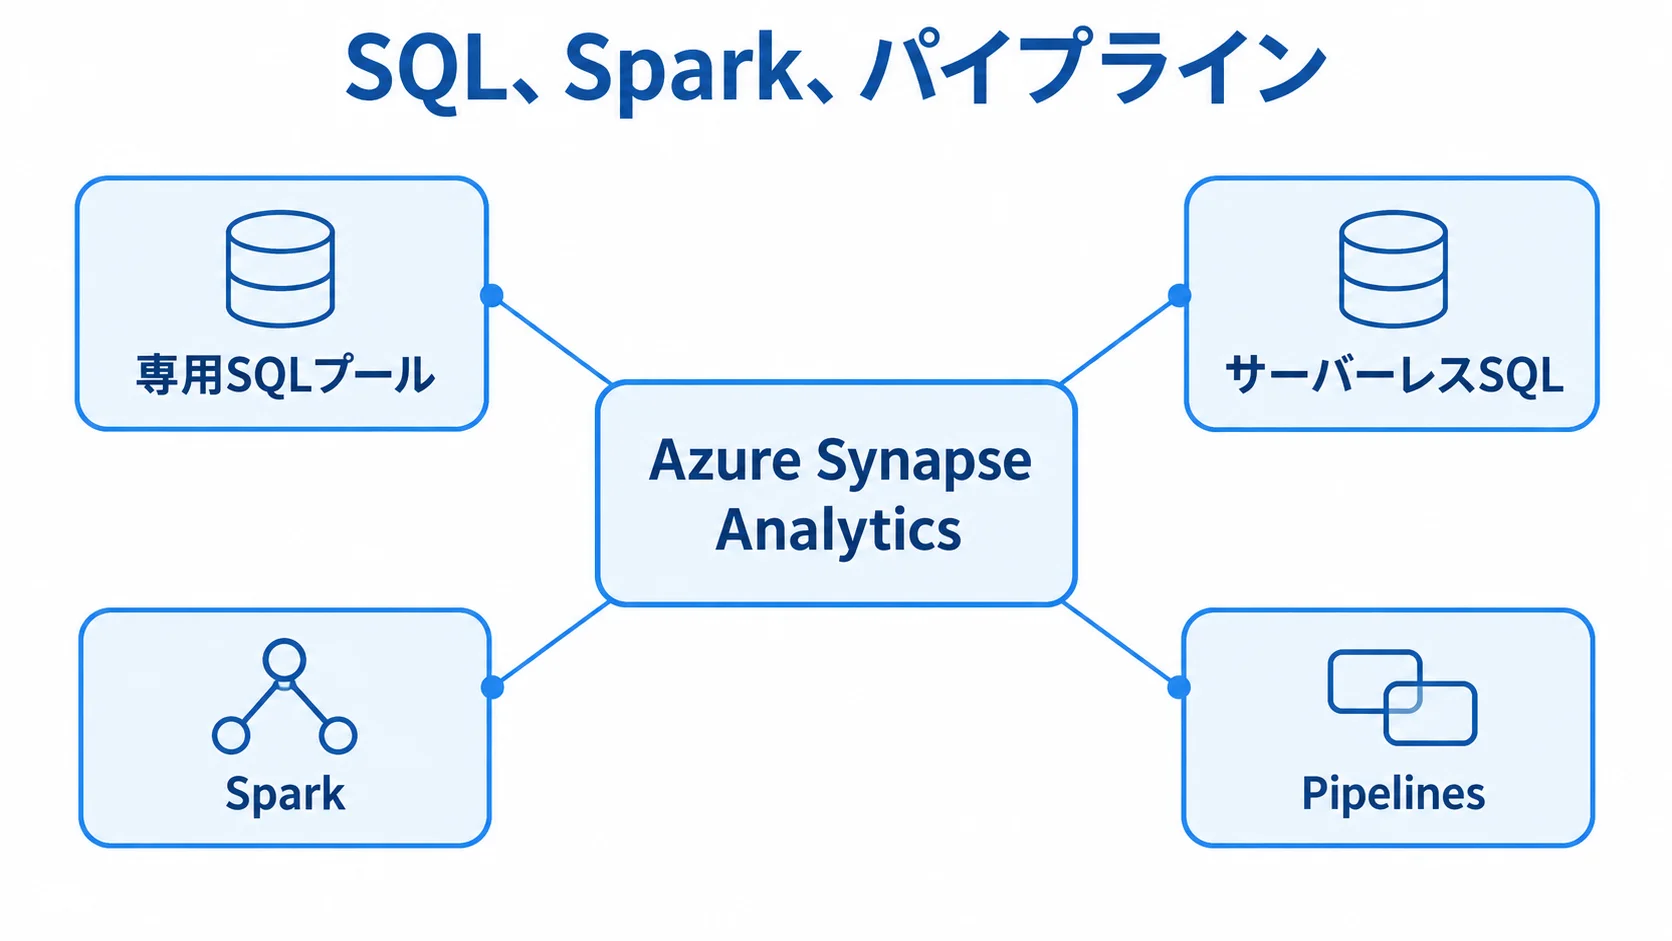
SQL、Spark、パイプラインは、最初からすべてを同時に導入する必要はありません。分析目的と利用条件(データ量、更新頻度、利用者数、待ち時間)をもとに組み合わせます。
設計時に迷いやすい要素を、SQLとSpark・Pipelinesに分けて整理します。
専用SQLプールとサーバーレスSQLの違い
専用SQLとサーバーレスSQLは、性能の安定性と利用頻度の違いで使い分けます。
- 専用SQLプール:一定の性能が必要なDWHや定型レポート向け。未使用時は一時停止でき、24時間稼働は前提としない
- 計算資源:資源を確保してテーブルを最適化し、利用量に合わせてスケールする
- サーバーレスSQL:レイク上のParquet、CSV、JSONをT-SQLで検索する
- 利用と課金:常時稼働クラスターを持たず、処理データ量に応じて課金。PoCやアドホック分析にも向く
大量のファイルを毎回読むクエリは、費用と応答時間が増えがちです。そのため、ファイルの形式、パーティション、列を管理します。
SparkとPipelinesの役割
SparkとPipelinesは、加工処理とデータ連携の実行を分担しています。
- Spark:複数ファイルの大規模加工、複雑なクレンジング、データサイエンス、機械学習、ノートブック処理を担う
- 扱うデータ:SQLで扱いにくいログや半構造化データを、分析しやすい形式へ変換する
- Pipelines:コピー、SQL・ノートブック実行、スケジュール、依存関係、失敗時の再実行を制御する
- 日々の運用:一度動かすだけでなく、毎日同じ品質で動かす仕組みを整える
Sparkでは、ノード数や起動時間を管理し、ライブラリや再実行、品質も見ます。
取り込み件数や処理時間、欠損・重複件数、最終成功時刻を記録しておくと、障害と品質を確認しやすくなります。
Azure Synapse Analyticsのシステム開発の進め方
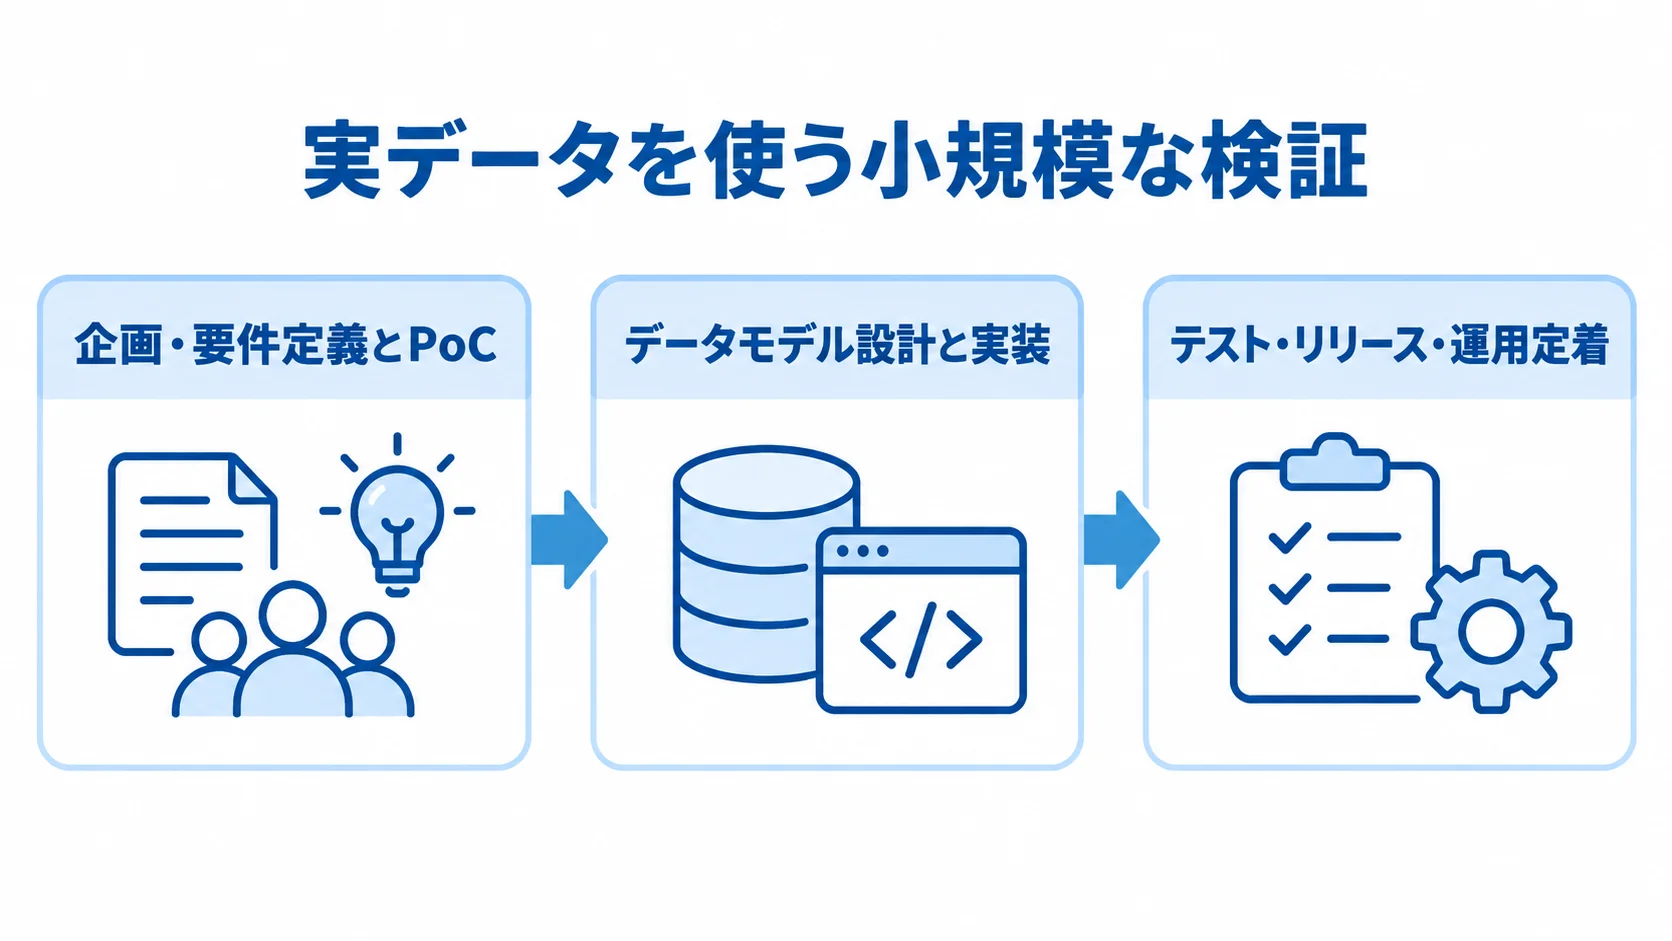
Synapseの開発は、まず業務上の意思決定とKPIを絞るところから始めます。
ワークスペースの作成やSQLの記述は、その後の工程です。
データ品質と利用条件を確認したうえで、小さく検証してから本番へ広げます。全社DWHを一度に作ると不確実性が高まるため、実データを使う小規模な検証を先に行います。
▶ 詳細はこちら:Azure Synapse Analyticsのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
企画・要件定義とPoC
企画では、改善する意思決定を1〜2個に絞り、PoCで本番化の条件を確かめます。
- 改善する判断:経営ダッシュボード、在庫精度、営業予測、製造歩留まりなどから1〜2個に絞る
- 要件:対象データ、所有者、更新頻度、許容遅延、利用者、同時実行数、保存期間、個人情報、KPIを定める
- PoC:実データの一部でパイプライン1本、代表的なSQLとレポートを数本作る
- 測定:欠損率、名寄せ精度、更新時間、応答、権限、1日あたりの処理量、想定Azure利用料を測る
「すべてのデータを集める」という目標だけでは、優先順位が決まりません。そのため、要件にするには、優先順位を決める材料が必要です。
PoCの成功条件を数値で定めておくと、本番化を判断しやすくなります。
データモデル設計と実装
設計と実装では、データ定義から検証、成果物の記録までを一貫して進めます。
- データモデル:業務用語と項目を対応させ、Raw、Cleansed、Curatedなどの層を設計する
- データ管理:マスタの正本、履歴、再処理時の上書き、重複判定を決める
- 開発環境:開発・検証・本番を分け、Git、CI/CD、Infrastructure as Code、秘密情報の分離、レビューを組み込む
- 検証と記録:部分失敗、遅延、再実行、重複取り込みをテストし、設計書や項目定義などを残す
マスタ設計を省くと、レポートごとに加工ロジックが分かれ、同じKPIの数字が食い違ってしまいます。
成果物には、設計書と項目定義のほか、カタログやエラー一覧も含めます。
テスト・リリース・運用定着
テストから運用定着まで、品質確認と利用状況の把握を続けます。
- リリース前:件数・金額照合、日次更新時刻、権限、個人情報のマスキング、通知、復旧時間を試す
- データ品質:表示確認だけでなく、元データの鮮度や集計漏れも検査する
- 月次確認:利用率、手作業の削減時間、更新遅延、品質エラー、失敗率、Azure利用料を見る
- 部門展開:KPI定義書と窓口で数値の解釈を助け、知見をテンプレート化し、一括ではなく段階的に展開する
分析基盤では、画面が正しく表示されていても、元データが古かったり集計対象が欠けていたりすることがあります。そのため、本番前の品質テストを欠かせない工程として組み込みます。
Azure Synapse Analyticsの費用相場とコストの内訳
費用は、初期開発費と、AzureやBIのランニングコストに分けて考えます。公的な国内受託相場の統計はないため、以下は2025〜2026年の企画用の幅です。
これらは、データ量、接続先、性能、移行、権限、運用時間を前提とした目安で、金額を保証するものではありません。RFPの予算枠を決める材料に使えます。
▶ 詳細はこちら:Azure Synapse Analyticsのシステム開発の見積相場や費用/コスト/値段について
初期開発費の目安
初期費用は、規模や接続範囲、機能によって目安が変わります。
- 小規模PoC・部門分析:100万〜500万円程度、1〜3か月程度。データソース1〜3個などを想定
- 部門横断基盤:500万〜2,000万円程度、3〜6か月程度。複数接続や監視などで工数が増える
- 全社DWH:2,000万〜1億円以上の場合がある。複数基幹システムや大規模データなどが条件
- 大規模・高度要件:リアルタイム、過去移行、災害復旧、複数リージョン、監査、機械学習を含むと1億円超もある
小規模の想定の中身は、レイクとサーバーレスSQLを使う構成、少数のレポート、簡単な権限設定です。部門横断では、定期連携やデータマート、移行、運用設計まで範囲が広がります。
全社規模では、基幹システムをどこまで連携させるかが費用を左右します。また、業務システム全般では、PMが月90万〜150万円、SEが月65万〜110万円程度が目安です(出典: NotebookLMリサーチノート内の業務システム費用Q&A、2026年)。体制と期間によって、費用は変わります。
Azure利用料と保守費の決まり方
費用は、課金単位を把握したうえで、利用時間と保守範囲を合わせて見積もります。
- 利用料:SQL処理量・計算資源・稼働時間、ストレージ、Pipelinesが影響する
- 周辺費用:統合ランタイム、Spark、転送、Private Link、バックアップも含める
- 課金単位:サーバーレスは処理データ量、専用SQLは計算資源、Sparkは仮想コア時間など
- 稼働と割引:夜間・休日の停止や予約容量・コミット割引を検討する
課金単位の詳細は価格ページで確認できます(出典: Azure Synapse Analytics価格ページ、2026年8月確認)。
安定稼働が見込める場合でも、割引の対象外となるストレージ・ネットワーク費は別に試算します。
保守費には、監視や障害対応のほか、データ追加、セキュリティ、問い合わせ、KPI変更も含まれます。目安は、初期費用の年15〜25%程度です。
Azure Synapse Analyticsの開発会社・ベンダーの選び方
Azureの知識だけでなく、データ基盤を業務で使える状態にできるかを見ます。構築やモデリング、Power BI、移行などの経験を、監視やFinOps、内製化支援と合わせて確認します。
これらの経験は、一つの提案書の中で確認してください。なお、資格やパートナー掲載は候補を探す材料になりますが、品質、価格、体制までは保証されません。
類似案件の経験の確認
実績と提案を照らし合わせて、類似案件への対応範囲と、費用を抑える工夫を見ます。
- 案件条件:データソース数、更新頻度、量、個人情報、利用者数、レポート数、SLAを伝える
- 実績の確認:Synapseで構成した範囲、成果物、品質改善、障害対応、教育、利用率を尋ねる
- 方式の選定:専用SQL、サーバーレスSQL、Sparkを使い分ける条件を確認する
- 費用の工夫:高価な専用プール案は、夜間停止、クエリ最適化、形式変更、集計表で代替できるか比べる
Azureの実績があるかだけで判断せず、自社に近い条件でどんな構成を組んだかを確かめます。そうすると、構築だけを担う会社か、運用まで見る会社かを見分けやすくなります。
見積・体制・契約で確認する項目
見積と契約では、作業範囲、成果物、終了時の引き継ぎ条件を明確にします。
- 見積内訳:要件定義、調査、設計、連携、SQL、ノートブック、BI、移行、テスト、教育、運用に分ける
- 費用範囲:Azure、BI、ネットワーク、保守費が含まれるか、別請求か確認する
- 完了条件:作業完了範囲と追加データソース・KPI変更の費用を明記する
- 成果物:SQL、ノートブック、パイプライン、IaC、設計書、項目定義、テスト、監視、運用手順を挙げる
比べる際は総額に加えて、どこまで作れば完了になるかを確かめます。
ソースコード、改修権、第三者への引き継ぎ権は、自動的に得られるとは限りません。そのため、契約終了時のデータ返却、アカウントの所有者、秘密情報、引き継ぎ期間も決めておきます。
▶ 詳細はこちら:Azure Synapse Analyticsのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Azure Synapse Analyticsのシステム開発の発注/外注/依頼/委託方法について
セキュリティ・データ品質・運用設計のポイント
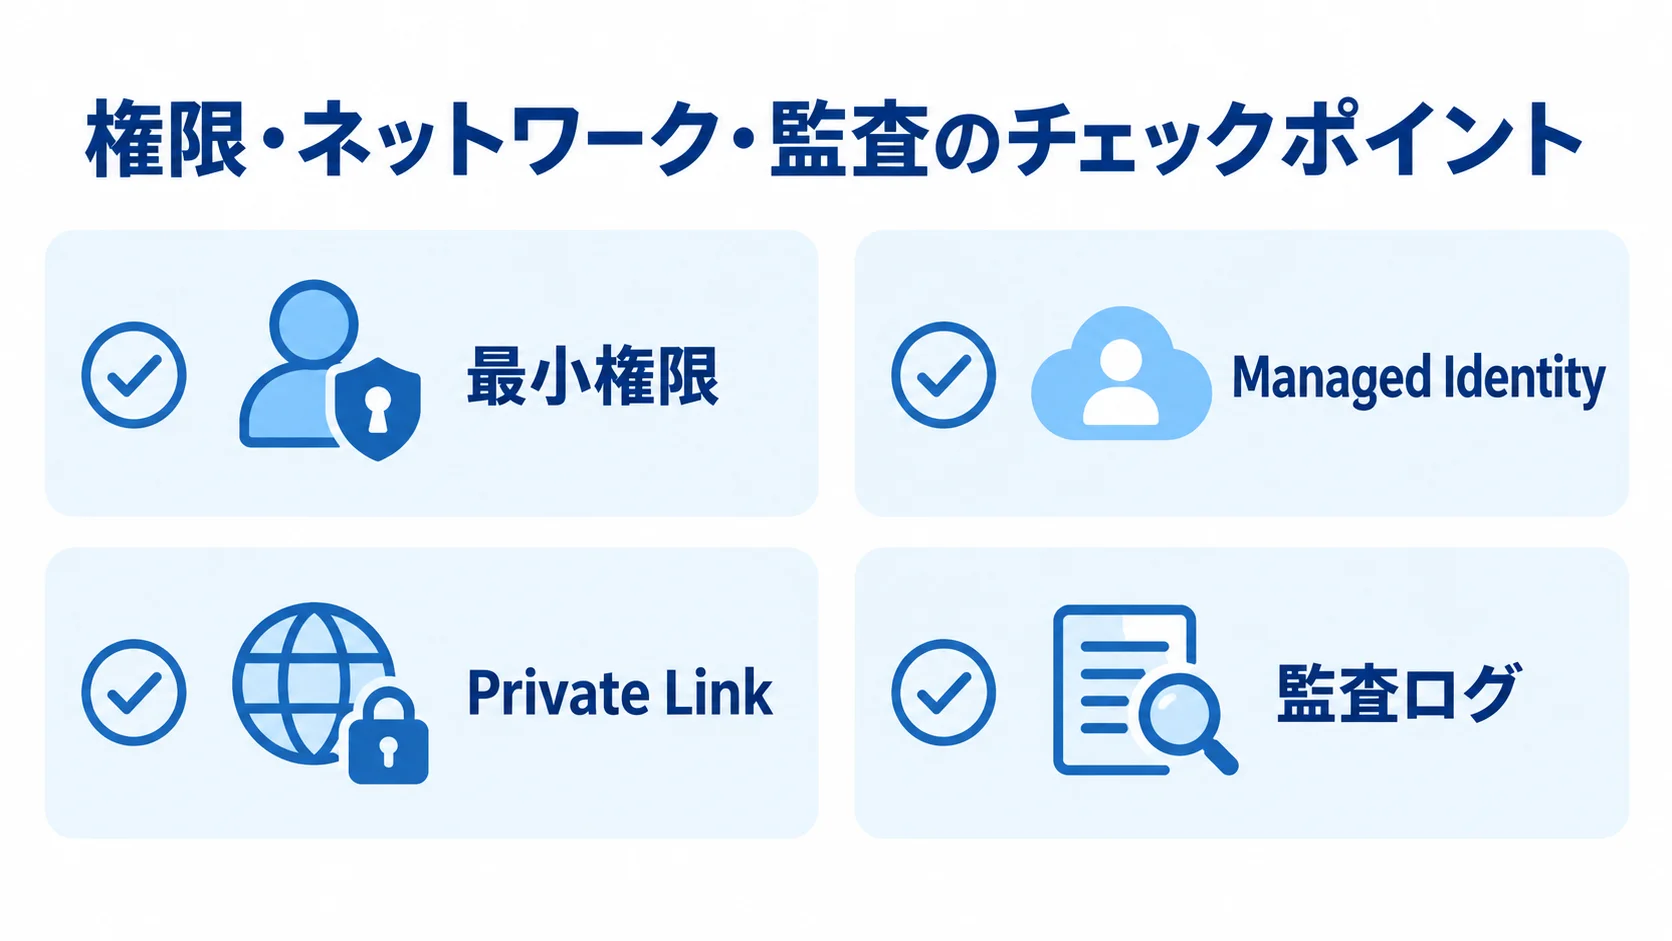
閲覧権限、公開してよい品質、異常時の修正担当は、開発の初期に決めておきます。セキュリティは、インフラだけでなくデータ所有者と業務部門も含めて運用するものです。
権限・ネットワーク・監査のチェックポイント
権限、ネットワーク、復旧、個人情報の扱いを、まとめて確かめます。
- 権限:Entra IDグループごとに各サービスへ最小権限を付与し、共有アカウントを避ける
- 役割と監査:Managed Identityを使い、担当を分ける。制御や監査ログは情報分類に沿って決める
- ネットワーク:Private Link、Managed Virtual Network、持ち出し・接続元制限、暗号化、ログ保管を含める
- 復旧と個人情報:復旧目標を合意し、利用目的や保存期間などを関係部門と確認する
開発者、運用者、閲覧者、所有者の役割は分けて、誰が何を担うかを明確にします。また、行・列の制御や動的マスキング、監査ログの扱いは、アクセス制御ガイダンスを手がかりに整理できます(出典: Azure Synapse Analyticsアクセス制御ガイダンス、2026年8月確認)。
バックアップからの復旧は定期的にテストし、目標とする復旧時間と時点を関係者で合意します。なお、個人情報の扱いは、法務・情報セキュリティ部門を交えて、委託先や所在地、国外移転まで含めて整理します。
データ品質とFinOpsの管理
データ品質と費用は数値で追い、修正の責任や予算超過への対応を決めておきます。
- 品質KPI:欠損率、重複率、未変換件数、遅延、照合差異、処理失敗率を追う
- 修正と追跡:元データ部門と、修正をどこまで誰が受け持つかを決め、カタログとリネージュで出所を追う
- 費用の切り分け:リソース、環境、部門、処理単位で費用を分ける
- 月次管理:SQL稼働、サーバーレス処理量、Spark時間、失敗時の再実行を確認する
欠損などのエラーは、元データを管理する業務部門に返します。
予算超過の通知を設定しておき、PoCで1日あたりの処理量と利用料を測ったうえで、本番の上限を定めます。
よくある失敗と2026年時点の製品選択
業務で使い続けるには、比較の条件と撤退の条件を決め、モデルやパイプラインを再利用できる形にしておきます。
導入で起こりやすい失敗
導入で後回しにされやすいのは、目的、性能、データ品質、権限です。
- 目的のない収集:KPI、利用者、更新時刻、品質基準を決め、必要なレポートを作る
- 過剰な性能選択:PoCで小規模構成やサーバーレスSQLを使い、処理量、応答、同時実行数を測る
- 品質・権限の後回し:欠損や個人情報の扱いを本番化前に決める
データレイクにファイルを置くだけでは、利用部門が必要な数字を探せないことがあります。また、最大性能の専用SQLを常時使うと、利用量を測らないまま費用が膨らむことがあります。さらに、品質や権限を後回しにすると、欠損や個人情報の対応費と停止リスクが増えます。
SynapseとFabricなどの比較
既存の資産と移行のしやすさの両方を比べ、製品名だけで判断しないようにします。
- 比較軸:Azure資産、T-SQLスキル、DWH性能、レイク運用、Power BI連携、今後の分析機能
- 洗い出し:既存のSQL、モデル、ノートブック、パイプライン、権限、監視を個別に確認する
- 移行情報:Fabricには専用SQL、Spark、パイプラインの移行ガイドと支援ツールがある
Fabricの移行情報があることは、Synapseが直ちに使えなくなることを意味するわけではありません(出典: Microsoft Fabric Migration Overview、2026年4月更新)。また、新規案件では、Synapseを選んだ理由と、将来の移行時に再利用する範囲をRFPに書いておきます。
Azure Synapse Analyticsのシステムに関するよくある質問
費用や構成は、データ量と利用条件によって変わります。一般論だけでなく、自社のデータで試算と検証を行う必要があります。
Azure Synapse Analyticsは何に使うサービスですか?
業務システムのデータを集め、DWHやデータレイク、加工、BI、機械学習へつなぎます。業務画面を作るものではなく、経営や営業、在庫、製造、顧客の分析データを整える基盤です。
小規模に始めると費用はいくらですか?
小規模PoCや部門分析は、初期100万〜500万円程度、期間1〜3か月程度が目安です。
Azure利用料は、月1万〜30万円程度からになることもあります。データ量や頻度、Spark、BI、ネットワークを含めて試算します。
固定額として考えず、処理量と稼働時間を測って確かめてください。
Synapseは将来使えなくなりますか?
直ちに使えなくなると考える必要はありません。Fabricへの移行可能性を、新規の設計に含めます。
SQLやモデルに過度に頼らず、形式、パイプライン、権限、監視を文書にまとめておきます。製品のライフサイクルも、定期的に確かめておきます。
開発会社には何を依頼すればよいですか?
開発会社には、まず要件、データの洗い出し、KPIを伝えます。そのほかの項目は次のとおりで、項目ごとに分けて相談します。
- 構成と連携
- モデルと権限
- 監視とBI
- 移行
- 教育と引き継ぎ
品質の責任をどこまで誰が受け持つかや、利用料を抑える工夫、成果物の引き渡し、契約終了時の返却は、見積もりと契約に明記します。
まとめ
Azure Synapse Analyticsは、SQL、Spark、Pipelines、レイク、BIを組み合わせて、業務データを分析用に整えるサービスです。そのうえで、KPIと品質を定め、PoCで性能、費用、権限、運用を測ってから段階的に広げます。
導入前に確認する4項目
導入前に決める条件を、見積の比較や社内稟議に使える形で整理します。
- 目的とデータ:改善するKPI、データソースと所有者を確認する
- 更新と構成:更新頻度とSLA、専用・サーバーレスSQLやSparkの選定理由を決める
- 保護と予算:個人情報の扱い、権限、Private Link、Azure利用料と保守費の上限
- 移行と返却:Fabric移行の扱いと、契約終了時のデータ返却
4項目が明確になっていれば、会社との見積比較や社内稟議の精度を高められます。
次に行うこと
検証から拡張までを順に進めつつ、運用と契約の条件も整えます。
- 一部門、一つのKPI、一つから三つ程度のデータソースで検証計画を作る。
- サーバーレスSQLとPipelinesで判断改善、品質維持、月額費用を確かめる。
- 検証後に専用SQLやSparkを加え、データ定義、運用、契約成果物を明確にする。
▼関連記事一覧
・Azure Synapse Analyticsのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Azure Synapse Analyticsのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Azure Synapse Analyticsのシステム開発の見積相場や費用/コスト/値段について
・Azure Synapse Analyticsのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。